Nur 0,7 Punkte Unterschied, aber nur halber Preis
65,7 % gegenüber 66,4 %. Kimi hat das neu veröffentlichte K3.1 Pro auf Terminal-Bench 4.0 getestet, der Abstand zu Claude Opus 5.5 beträgt nur noch 0,7 Prozentpunkte, GPT-6 Astra liegt bei 58,2 %. Die offizielle Positionierung für K3.1 Pro lautet “stärkstes Open-Source-Modell im 3T-Bereich” – mit 3 Billionen Parametern, 1 Million Token-Kontext und gemeinsamer Verstärkungslernen über Hunderte von Domänen ist es das erste Modell der K3.1-Serie, dessen Gewichte am 4. November 2026 veröffentlicht werden.
Terminal-Bench testet Langzeitaufgaben in der Kommandozeile: Umgebung einrichten, Abhängigkeiten installieren, Tests schreiben und Fehler beheben., Konfiguration ändern, Toolchains zum Laufen bringen – ein einziger Fehler in Dutzenden Schritten führt zum Totalausfall. Solche Aufgaben zeigen den größten Unterschied zwischen Agent-Modellen und entsprechen am ehesten der täglichen Arbeit der Entwickler. Ein 1-Million-Token-Kontext ist eine essentielle Konfiguration für lange Sitzungen und große Code-Bibliotheken – nur mit diesem Ergebnis macht er Sinn: Der Kontext mussaufnehmen der gesamte Inhalt sein, und die Aufgabe muss auch abgeschlossen werden können.
0,7 Prozentpunkte liegen im Bereich der Bewertungsunschärfe. Die offiziellen Testeinstellungen sind: Inferenzstufe max, Temperatur 1.0, top-p 0,95 – die Zahlen wurden im selben Vergleich ermittelt. Open-Source-Modelle bei Langzeitaufgaben in der Kommandozeile haben nun die Closed-Source-Flaggschiffe erreicht.
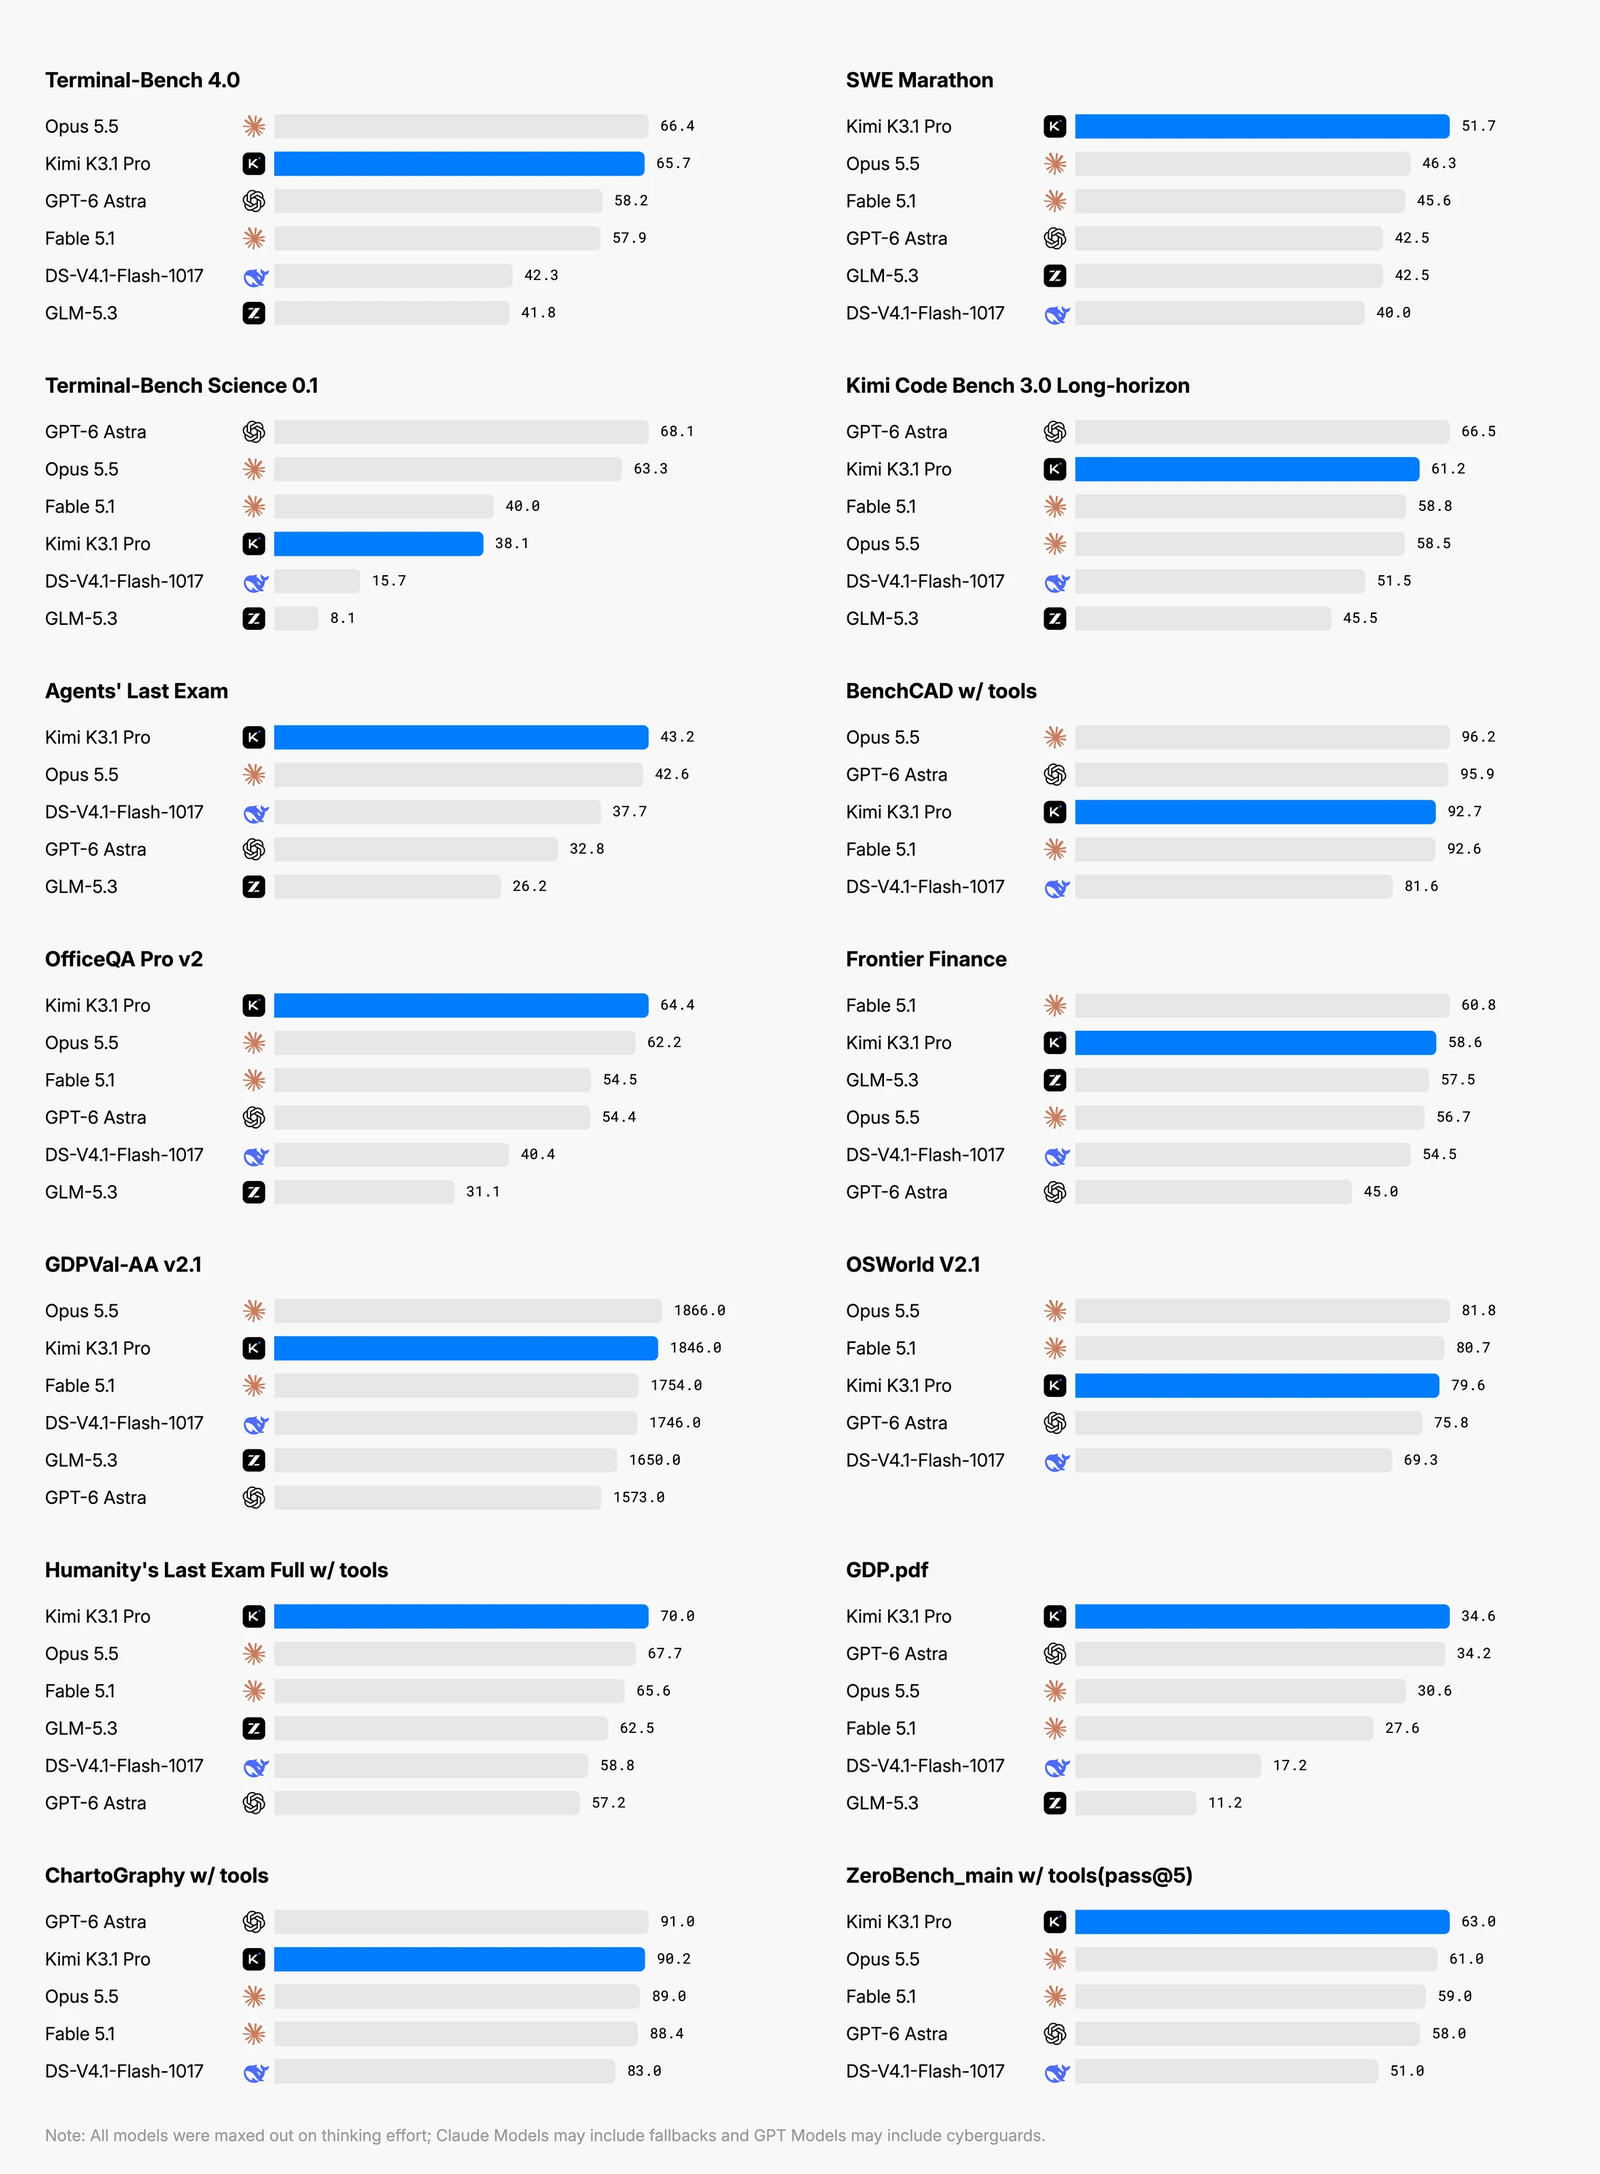
Abbildung: Gesamtübersicht der Leistungsvergleiche auf der offiziellen Veröffentlichungsseite. Siehe Spalte Terminal-Bench 4.0: 65,7 gegenüber 66,4, der Unterschied wurde auf unter 1 Punkt reduziert. Quelle: Kimi offizieller Blog
Der Gleichstand ist jedoch nur partiell. Bei BenchCAD mit Werkzeugen erreicht K3.1 Pro 92,7, Opus 5.5 liegt bei 96,2 und GPT-6 Astra bei 95,9 – bei Ingenieuraufgaben gehört es zur ersten Liga, aber der Spitzenplatz ist noch über 3 Punkte entfernt. OfficeQA Pro v2 erreichte 64,4, was offiziell als State-of-the-Art (SOTA) für diese Bewertung bezeichnet wird – eine Verbesserung von etwa 4,2-fach bei geschäftlichen Aufgaben im Vergleich zur Vorgängerversion. Die Verbesserungen bei dokumentenintensiven Arbeitsvorgängen entsprechen direkt der Nutzbarkeit in Büroautomatisierungsszenarien. Die Halluzinationsrate fiel bei Kimi Hallu Bench Hard von 23,4 % auf 8,3 %, also um etwa zwei Drittel reduziert; für Teams, die Modelle für automatisierte Prozesse einsetzen, ist die Halluzinationsrate praktischer als die Punktzahl, da sie bestimmt, ob die Ausgabe direkt verwendbar ist.
Die Firma hat auch eine Langzeiddemonstration veröffentlicht: Im human-atlas-Szenario wurden 296 Knochen, 402 Muskeln und insgesamt 167 Aufgaben orchestriert, um die Generierung eines gehenden Menschen auf 11,2 Sekunden zu reduzieren. Teams, die Agenten einsetzen, kennen vermutlich das Phänomen, dass Ketten von Aufgaben mitten im Prozess zusammenbrechen – beim 100. Schritt werden die Einschränkungen des 10. Schritts vergessen, die vorherigen 99 Schritte sind umsonst. Dass 167 Aufgaben zu einer durchgehenden Kette verbunden werden können, ohne zusammenzubrechen, ist das eigentliche Highlight dieser Demonstration.
Gleiche 93 Punkte, aber die Rechnung unterscheidet sich um das 2,4-fache
Neben der Annäherung der Punktzahlen interessiert die Community mehr der Preis. Ein Entwickler hat K3.1 Pro und Claude Sonnet 5.5 mit dem Pac-Man-Benchmark getestet: Beide erreichten 93 Punkte, K3.1 Pro benötigte 11 Minuten und kostete 0,68 US-Dollar, Sonnet 5.5 benötigte 14 Minuten und kostete 1,61 US-Dollar. Bei gleicher Punktzahl ist die Rechnung um das 2,4-fache höher, und die Zeit war um 3 Minuten kürzer. Für Teams, die nach Token-Berechnung Batch-Agentenaufgaben ausführen, ist dieser Preisunterschied multipliziert mit der Aufgabenzahl der einzige Grund, das Modell zu wechseln.
Die Kosten für einzelne Aufgaben können schwanken, eine Probe reicht nicht für eine statistische Aussage, aber die Richtung ist klar: Bei gleicher Punktzahl sind beide Zeit- und Kostenachsen im Vorteil, mit demselben Budget kann die Anzahl der Aufgaben auf das 2,4-fache gesteigert werden.
Die Highspeed-Version bietet eine noch detailliertere Auswahl: Die offiziell angegebene Geschwindigkeit beträgt 2-3-fach. Für Nutzer mit häufigen Interaktionen ist jede Sekunde Wartezeit ein reiner Verlust, Geschwindigkeit hat Priorität; für nachts laufende Pipelines bringt Geschwindigkeit kein Geld, sondern nur der Preis pro Einheit. Die Aufteilung in zwei Geschwindigkeitsstufen innerhalb derselben Serie macht die Kostenstruktur zu einem Produktparameter, der jeweils beiden Szenarien dient.
Die entfernten 9,5 Punkte sind der Schwerpunkt der Ankündigung
Der gewichtigste Abschnitt dieser Ankündigung liegt außerhalb der Leistungsliste. Die Firma gibt explizit an, dass Daten zu Angriffsfähigkeiten im Netzwerk (offensive cyber) aus den Trainingsdaten und dem Verstärkungslernen entfernt wurden, und zwar jene Teile, die bereits die eigene Risiko-Selbstprüfung bestanden haben – sie bestanden die Prüfung, wurden aber trotzdem entfernt, das “Nicht tun” ist in der Ankündigung enthalten.
Der Preis dafür ist öffentlich nachweisbar. Bei der angriffsorientierten xdev-bench-hard erreichte die eigene Vergleichsversion der Firma (ohne Risikoreduzierung) 90,5 %, DeepSeek 85,7 %, K3.1 Pro 81,0 %, GLM-5.3 57,1 % und der Vorgänger K3 nur 33,3 %. 81,0 gegenüber 90,5 – die 9,5 Prozentpunkte sind der Preis für diese Selbstbeschränkung: Das Modell hätte ursprünglich eine höhere Punktzahl erreichen können, wurde aber absichtlich gedrosselt, und der Drosselungsbetrag wurde öffentlich gemacht. Die Verteilung der Modelle auf dieser Tabelle ist sehr weit gestreut, die Punktzahlen enthalten jeweils die individuellen Risikokompromisse, allein die Rangfolge gibt nicht die ganze Information wieder. Die 90,5 Punkte der Vergleichsversion beantworten auch eine andere Frage: Angriffsfähigkeiten im Bereich von 90 Punkten sind machbar, die veröffentlichte Version wird jedoch bewusst zurückgehalten.
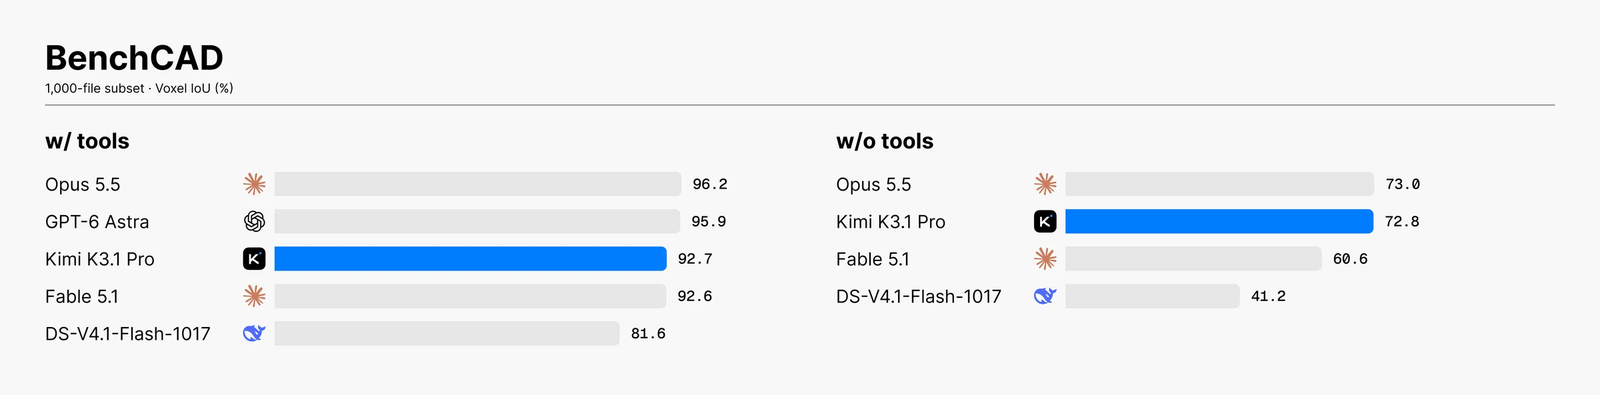
Abbildung: Detaillierte Benchmark-Ergebnisse der Firma. Beachten Sie die Zeile xdev-bench-hard: Die offizielle Version erreicht 81,0, die Vergleichsversion ohne Risikoreduzierung 90,5. Quelle: Kimi offizieller Blog
Closed-Source-Anbieter können bestimmte Fähigkeiten blockieren, indem sie Filter und Richtlinien auf der Deployment-Ebene hinzufügen; bei offenen Gewichten erhält der Herunterladende das Modell selbst, und nachdem es veröffentlicht wurde, kann es nicht mehr zurückgeholt werden. Wer auf dem Open-Source-Weg bestimmte Fähigkeiten kontrollieren will, kann das Tor nur auf der Seite der Trainingsdaten installieren – nachveröffentlichte Nutzungsbedingungen können die Gewichtsdateien selbst nicht regeln.
Für Unternehmen standardmäßig deaktiviert, Kontingente zuerst erschöpft
Die Nutzbarkeit ist umfassend: In Kimi Code kann man direkt mit /model wechseln, der APTI-Modellname ist kimi-k3-1-pro und kimi-k3-1-pro-highspeed, und Kimi Work Desktop ab Version v3.1.0 unterstützt es. Die APTI unterstützt Zero Data Retention (ZDR), bei dem der Dienstleister keine Anfragedaten speichert, was für Unternehmen mit privaten Daten ein wichtiges Kriterium ist.
Bei Kimi Enterprise ist dieses Modell für Firmenkunden standardmäßig deaktiviert. Die Entfernung auf der Trainingsdaten-Seite kontrolliert das Modell selbst, die standardmäßige Deaktivierung auf der Produkt-Seite steuert die Einsatzszenarien – beide Seiten folgen demselben Denken. Standardmäßig deaktiviert ist direkter als jede Formulierung in der Ankündigung: Fähigkeiten können in Werbetexten stehen, aber Angriffsflächenrisiken müssen durch Standardeinstellungen und Vertragsklauseln geregelt werden.
Die Reaktion auf der Kontingent-Seite war nicht so freundlich: Das 99-Dollar/Monat-Paket wurde stark kritisiert: Ein Nutzer hatte eine Sitzung von 47 Minuten, und innerhalb von 5 Stunden war das Kontingent aufgebraucht. Bei diesem Verbrauch liegt der effektive Preis für Heavy-User weit über dem angegebenen Preis, die Kontingentgestaltung dient der Abdeckung der Rechenkosten.
Auf der anderen Seite der Diskussion konzentriert sich die Kritik auf das Modellverhalten: Einige sagen, K3.1 sei direkter und streitbarer als US-amerikanische Modelle und würde direkt antworten “Wir haben das schon dreimal besprochen, bei einer anderen Frage ändert sich die Antwort nicht”. Für einen Programmier-Agenten, der sich ständig weiterentwickelt, spart dieses Festhalten an der Position die Rücksprache-Runden. In derselben Diskussion fragte jemand gleich “Was ist die Hauptquelle für das Distillation?”. Beim gleichen Modell berechnen die Kritiker die Kosten, die Fans merken sich das Verhalten, die Skeptiker fragen nach der Herkunft – alle drei Aspekte sind echtes Feedback zu dieser Veröffentlichung.
Der nächste Wettbewerb geht darum, wer sich traut, “Nicht tun” öffentlich zuzusagen
Wenn man die Veröffentlichungsinhalte aufdeckt: 0,7 Punkte Unterschied, mehr als die Hälfte des Preises, eine Fähigkeit, die aktiv aus den Trainingsdaten entfernt wurde. Die ersten beiden Punkte sind Standardwettbewerbsdisziplinen für Open-Source-Modelle; der dritte Punkt war nicht gefordert, sondern eine freiwillige Zusatzmaßnahme, was ihn zur eigentlichen Neuigkeit dieser Veröffentlichung macht.
Die bisherige Erzählung des Open-Source-Lagers konzentrierte sich nur auf das Verfolgen von Punktzahlen: Closed-Source-Modelle sind auf welcher Liste, Open-Source-Modelle sind auf derselben Liste. K3.1 Pro bringt eine andere Sache auf die Bühne – Sicherheit wird durch Subtraktion bei den Trainingsdaten betrieben, und es werden Vergleichsdaten zum Wert dieser Reduktion geliefert. Wenn sich der Fähigkeitsunterschied auf unter 1 Prozentpunkt reduziert, ist das nächste Unterscheidungsmerkmal zwischen Open- und Closed-Source, wer es wagt, “Nicht tun” als datengestützte Zusicherung zu formulieren.
Diese Art der Darstellung hat die inhärente Eigenschaft von Open Source: Nachprüfbarkeit. Nachdem die Gewichte am 4. November veröffentlicht werden, kann jeder selbst testen, wie viele Angriffsfähigkeiten tatsächlich verbleiben. Was die Nutzer erhalten, wird ein Modell mit 65,7 Punkten ohne Angriffsfähigkeiten im Netzwerk sein – die Punktzahl wird durch die nächste Veröffentlichung übertroffen, aber diese im Voraus formulierte “Nicht”-Aussage ist das, was von K3.1 Pro wirklich bleibt.
Referenzlinks:
- Kimi offizieller Veröffentlichungsblog
- HN-Diskussion
- Kimi Code Modell-Dokumentation