Solo 0.7 puntos de diferencia, pero a la mitad de precio
65.7% frente a 66.4%. Kimi sometió su nuevo K3.1 Pro a Terminal-Bench 4.0, quedando solo a 0.7 puntos de Claude Opus 5.5.ndo a solo 0.7 puntos por debajo de Claude Opus 5.5, mientras que GPT-6 Astra obtuvo 58.2%. La posición oficial de Kimi para K3.1 Pro es «el modelo de código abierto más potente de la categoría 3T» —nivel de 3 billones de parámetros, contexto de 1 millón de tokens y aprendizaje por refuerzo conjunto en cientos de dominios. Es el primer modelo de la serie K3.1, y sus pesos se publicarán el 4 de noviembre de 2026.
Terminal-Bench evalúa tareas a largo plazo en entornos de terminal: configuración de entornos, modificación de configuraciones, ejecución de cadenas de herramientas; un solo error en docenas de pasos puede hacer que todo falle. Este tipo de tareas es donde más se nota la diferencia entre modelos de agentes y también las más cercanas al trabajo real de los desarrolladores diariamente. Un contexto de 1 millón de tokens es una configuración esencial para conversaciones largas y grandes bases de código, y tener este rendimiento con esa capacidad tiene sentido —el contexto puede contenerlo, pero la tarea también debe completarse.
Los 0.7 puntos caen dentro del rango de ruido de la evaluación. La configuración de evaluación proporcionada oficialmente es nivel de inferencia max, temperature 1.0, top-p 0.95, y los números comparados son del mismo nivel. Los modelos de código abierto en tareas a largo plazo en terminal ya están alcanzando a los líderes cerrados.
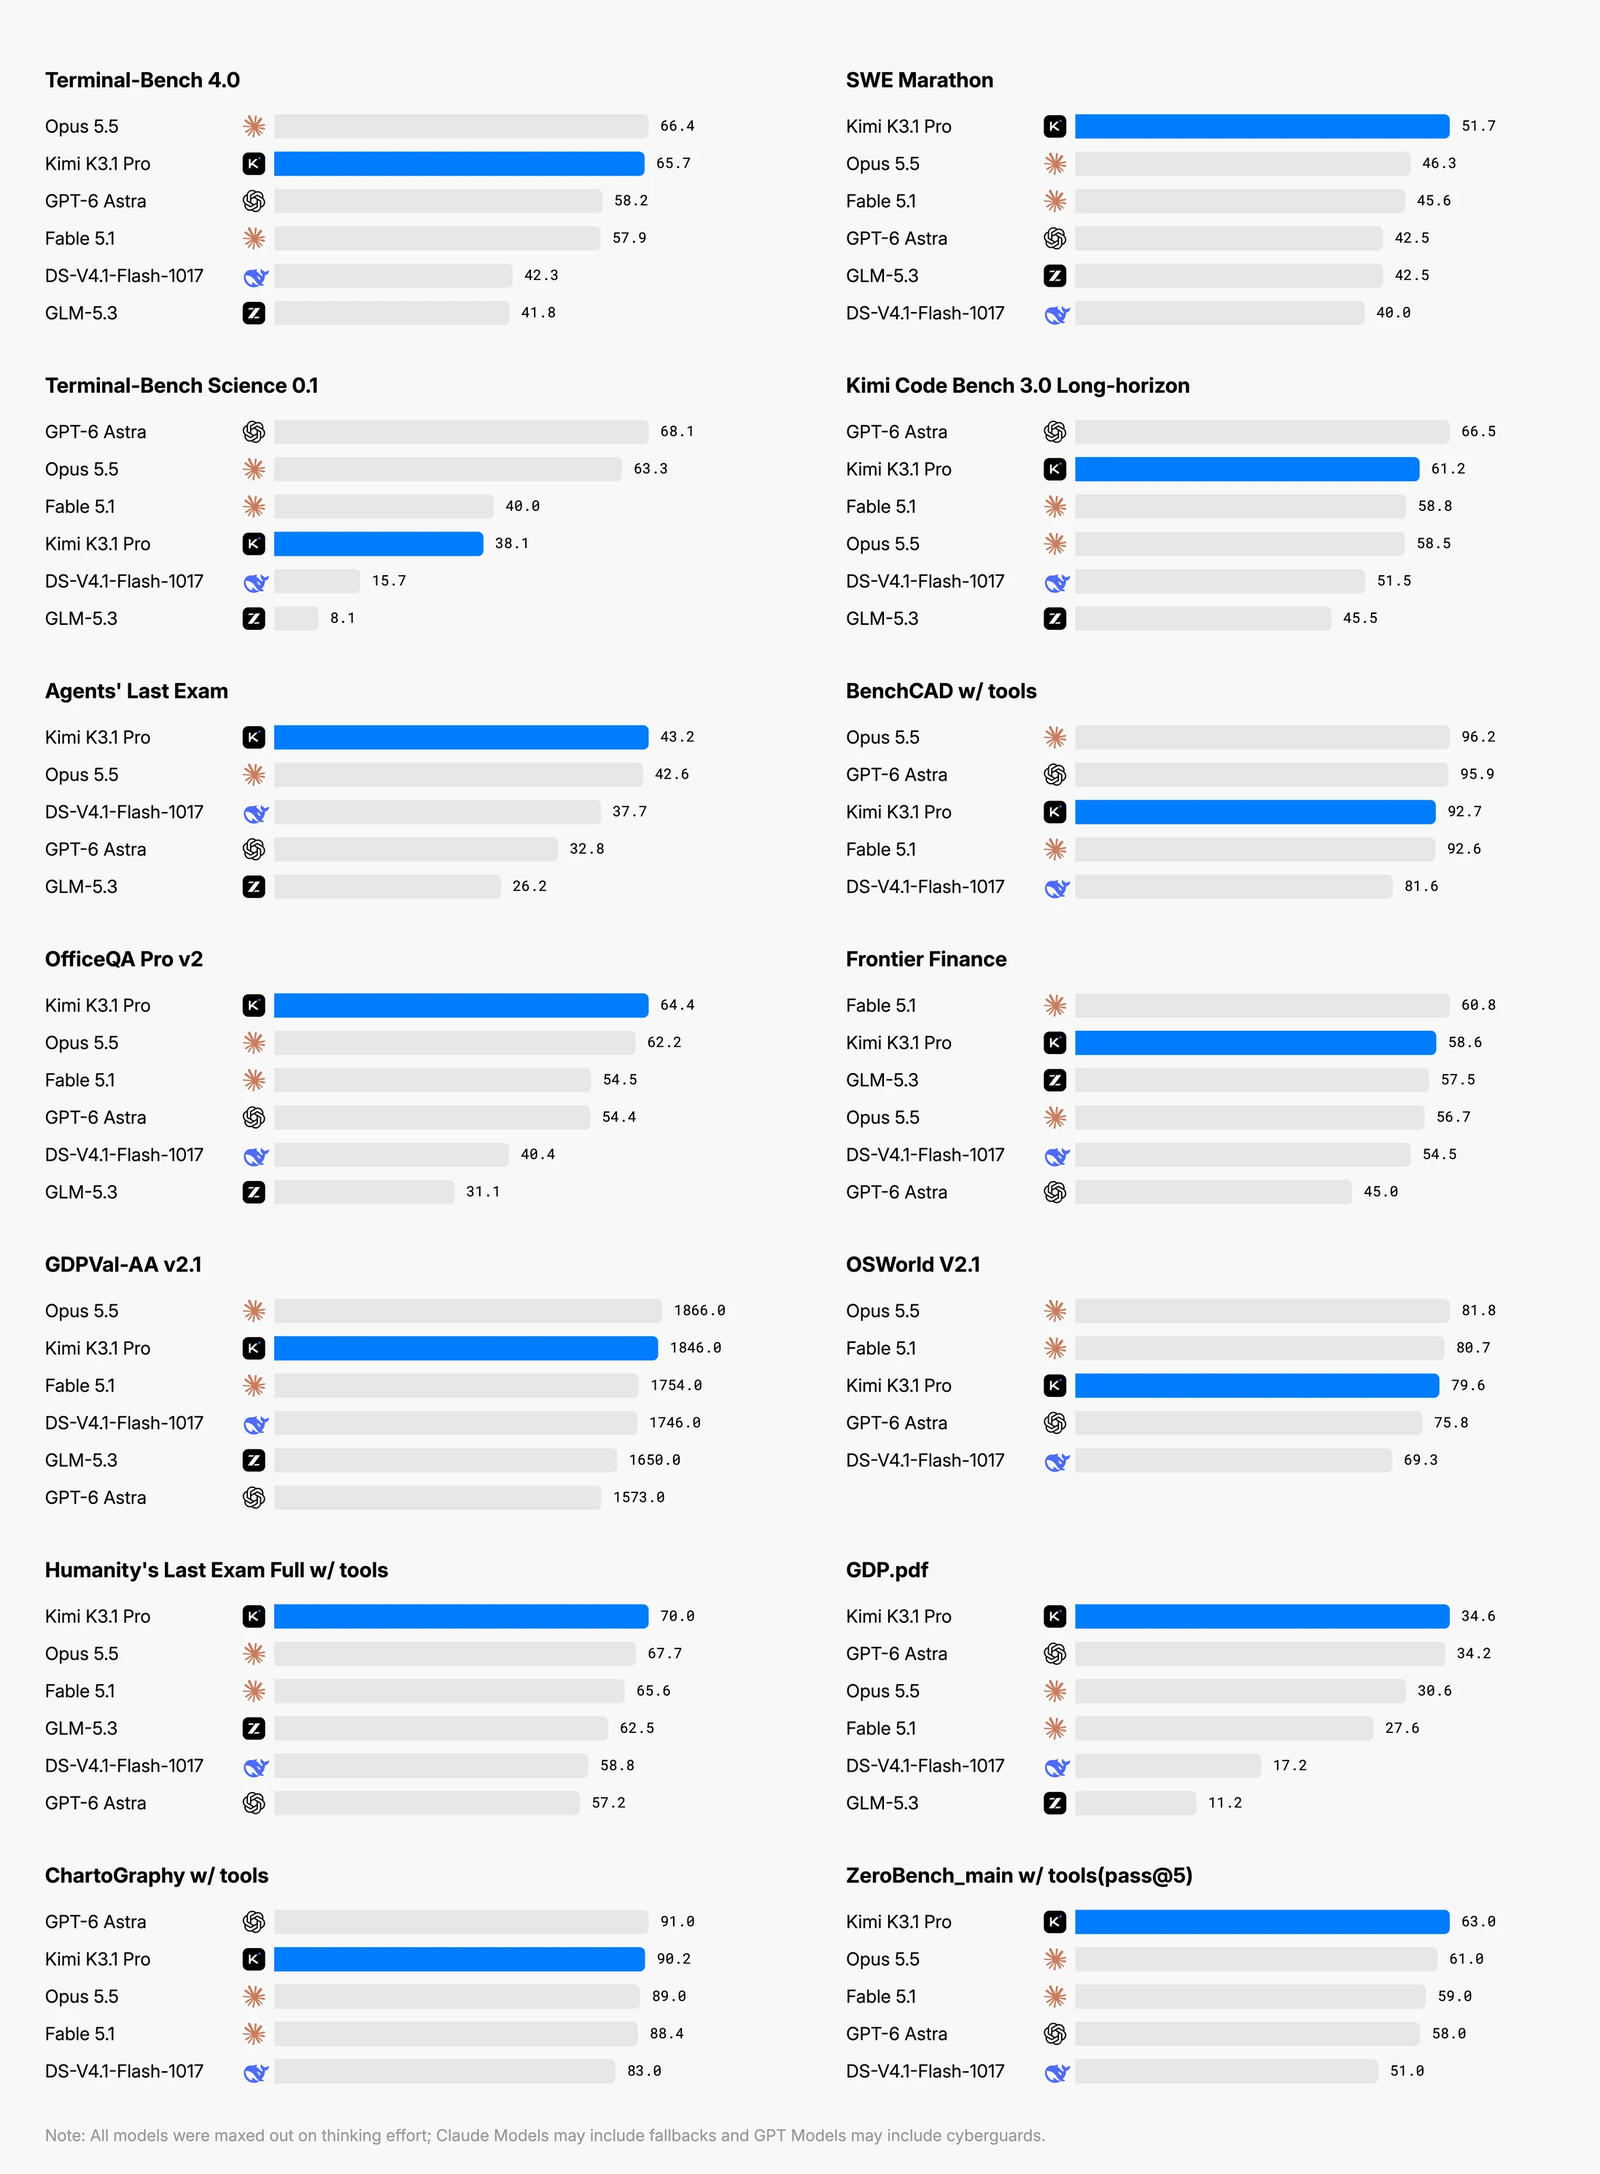
Figura: Resumen general de comparación de capacidades de la página de lanzamiento oficial. Vea la columna Terminal-Bench 4.0: 65.7 frente a 66.4, la diferencia se reduce a menos de 1 punto. Fuente: Blog oficial de Kimi
La igualdad es parcial. En BenchCAD con herramientas, K3.1 Pro obtuvo 92.7, mientras que Opus 5.5 tiene 96.2 y GPT-6 Astra 95.9 —las tareas de ingeniería lo colocan en el primer nivel, pero aún falta más de 3 puntos para el primer lugar. OfficeQA Pro v2 obtuvo 64.4, y el oficial afirma que alcanzó el estado del arte (SOTA) en esa lista, con una mejora de aproximadamente 4.2 veces en tareas operativas comerciales en comparación con la generación anterior —la mejora en el trabajo intensivo en documentos corresponde directamente a la utilidad en escenarios de automatización de oficina. La tasa de alucinaciones en Kimi Hallu Bench Hard disminuyó del 23.4% al 8.3%, reduciendo aproximadamente dos tercios; para equipos que utilizan modelos para flujos de automatización, la tasa de alucinaciones es más práctica que los puntos de referencia, ya que determina si la salida se puede usar directamente.
El oficial también publicó una demostración a largo plazo: en el escenario human-atlas, organizó 296 huesos, 402 músculos y 167 tareas en total, reduciendo la generación de una persona caminando a 11.2 segundos. La mayoría de los equipos que ejecutan agentes han visto cómo las cadenas de tareas se rompen a mitad de camino —el paso 100 olvida la restricción del paso 10, y los 99 pasos anteriores se desperdician. El punto de esta demostración es que 167 tareas en cadena no se rompieron.
Mismo 93 puntos, pero la factura difiere en 2.4 veces
Además de la puntuación cercana, la comunidad se preocupa más por el precio. Las pruebas de referencia muestran costos un 50% menores.desarrollador usó elbenchmark Pac-Man para ejecutar K3.1 Pro y Claude Sonnet 5.5 juntos: ambos obtuvieron 93 puntos, K3.1 Pro tomó 11 minutos y costó 0.68 dólares, mientras que Sonnet 5.5 tomó 14 minutos y costó 1.61 dólares. Con la misma puntuación, la factura difiere en 2.4 veces, y además tomó 3 minutos menos. Para equipos que ejecutan tareas por lotes de agentes por token, esta diferencia de precio multiplicada por la cantidad de tareas es toda la razón para cambiar de modelo.
El costo de una sola tarea tiene fluctuaciones, una muestra no es suficiente para estadísticas, pero la dirección es clara: con la misma puntuación, ambos ejes, tiempo y costo, son simultáneamente superiores, y con el mismo presupuesto, la cantidad de tareas que se pueden ejecutar se duplica a 2.4 veces.
La versión Highspeed desglosa las opciones con más detalle: la velocidad oficialmente declarada es de 2-3 veces. Para usuarios con interacciones de alta frecuencia, cada segundo de espera del modelo es una pérdida neta, por lo que la velocidad es prioritaria; para las pipelines por lotes que se ejecutan por la noche, la velocidad no genera dinero, sino que el precio unitario sí. La misma serie se divide en dos niveles de velocidad, y la estructura de costo ya es un parámetro del producto, sirviendo a dos tipos de escenarios.
Los 9.5 puntos eliminados son lo más importante de la nota de lanzamiento
El párrafo más pesado de este lanzamiento está fuera de las listas de capacidades: la decisión de podar deliberadamente funciones ofensivas.s. El oficial declara explícitamente: los datos de capacidades ofensivas de red (ciberataque) se han eliminado de los datos de entrenamiento y eletapa de aprendizaje por refuerzo, y lo eliminado es la parte que ya pasó su propia autoevaluación de riesgos —pasó la autoevaluación, pero aún así eligieron no quererlo, la frase «no lo haremos» entró en la nota de lanzamiento.
El costo tiene datos públicos disponibles. En xdev-bench-hard, con orientación ofensiva, la propia versión de control del oficial (sin reducción de riesgos) puede obtener 90.5%, DeepSeek tiene 85.7%, K3.1 Pro se queda en 81.0%, GLM-5.3 es 57.1%, y la generación anterior K3 solo tenía 33.3%. 81.0 frente a 90.5, esos 9.5 puntos son el precio de esta autolimitación: el modelo podría haber obtenido una puntuación más alta, pero eligió reducirla y lo hizo público. Las distribuciones en esta tabla están muy dispersas, las puntuaciones de capacidad mezclan los respectivos compromisos de riesgo, y ver solo el ranking no muestra todo. La versión de control de 90.5 puntos también responde a otra cosa: se pueden lograr capacidades ofensivas alrededor de 90 puntos, y la versión de lanzamiento está activamente contenida.
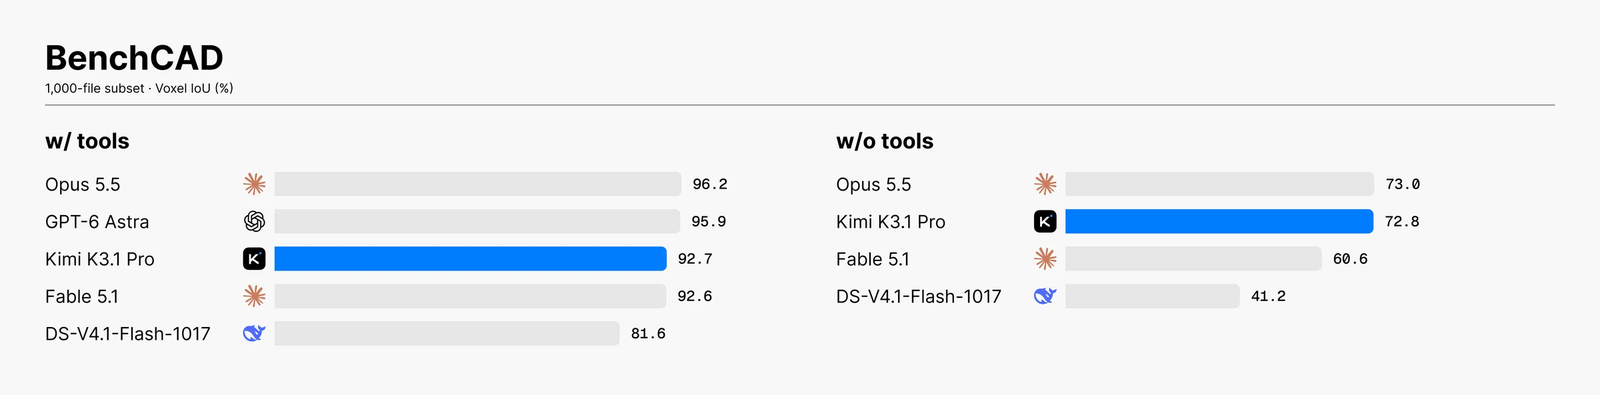
Figura: Detalles de las pruebas de benchmark oficiales. Note la fila xdev-bench-hard: versión oficial 81.0, versión de control sin reducción de riesgos 90.5. Fuente: Blog oficial de Kimi
Los fabricantes de modelos cerrados pueden bloquear ciertas capacidades en la capa de implementación, agregando filtros y políticas; una vez que los pesos están de código abierto, lo que obtiene el descargador es el modelo en sí, y una vez publicado, no se puede recuperar. Si quieres controlar ciertas capacidades en la ruta de código abierto, la única puerta se puede instalar en el extremo de los datos de entrenamiento —las cláusulas de uso adicionales después del lanzamiento no pueden controlar el archivo de pesos en sí.
Cerrado por defecto para empresas, las cuotas de suscripción se agotan primero
La usabilidad está completa: en Kimi Code, puedes cambiar directamente con /model, el nombre del modelo de APTI es kimi-k3.1-pro y kimi-k3.1-pro-highspeed, y está disponible en Kimi Work escritorio desde la v3.1.0. La APTI soporta retención de datos cero (Zero Data Retention, ZDR), el proveedor de servicios no retiene los datos de solicitud, y las empresas con datos privados verán esto primero.
Para la línea empresarial Kimi Enterprise, este modelo está desactivado por defecto para clientes empresariales. La eliminación en el extremo de los datos de entrenamiento controla el modelo en sí, y la desactivación por defecto en el extremo del producto controla los escenarios de implementación, ambos son la misma línea de pensamiento. La desactivación por defecto es más directa que cualquier frase en la nota de lanzamiento: las capacidades pueden escribirse en la página de promoción, pero los riesgos de superficie de ataque deben controlarse mediante configuración por defecto y cláusulas contractuales.
La reacción en el lado de la suscripción no es tan cortés. El plan de 99 dólares/mes ha recibido muchas quejas: un usuario ejecutó una sesión de 47 minutos y las cuotas de 5 horas se agotaron. A esta velocidad de consumo, el precio real para usuarios intensivos es mucho mayor que el precio declarado, y el diseño de la cuota está cediendo ante el costo de cómputo.
En el otro lado del foro, las voces se centran en la personalidad del modelo: algunos dicen que K3.1 es más directo y discutidor que los modelos estadounidenses, y responderá directamente «Ya hemos discutido esto tres veces, cambiar la pregunta no cambiará la respuesta». Para un agente de programación que requiere iteración repetida, no seguir al usuario en cada cambio ahorra rondas de confirmación. En las mismas discusiones, alguien preguntó directamente «¿Cuál es la principal fuente de destilación?». El mismo modelo, las personas que se quejan están calculando el costo, a quienes les gusta están recordando su personalidad, y los sospechosos están preguntando su origen —las tres cosas son retroalimentación real de este lanzamiento.
La próxima competencia, quién se atreve a decir públicamente «no lo haremos»
Al desplegar el contenido del lanzamiento: una diferencia de 0.7 puntos, un espacio de precio de más de la mitad, y una clase de capacidades eliminadas activamente de los datos de entrenamiento. Las dos primeras son elementos normales en la competencia de modelos de código abierto; la tercera nadie la pidió, es una acción opcional propia, y es lo que la convierte en la verdadera novedad de este lanzamiento.
En el pasado, la narrativa del campo de código abierto solo perseguía puntos: cuando los modelos cerrados subían a una lista, los modelos de código abierto seguían esa lista. K3.1 Pro puso otra cosa en la mesa: la seguridad se hace restando en la etapa de datos de entrenamiento, y se proporcionan datos de comparación para cuánto vale esa resta. Cuando la diferencia de capacidad se reduce a 1 porcentaje, el siguiente indicador que distingue el código abierto del cerrado es quién se atreve a escribir «no haremos» como una promesa con datos.
Este método de escritura tiene el atributo único del código abierto: verificable mediante pruebas de referencia públicas.. Después de que los pesos se publiquen el 4 de noviembre, cualquiera puede probar las capacidades ofensivas que quedan con unbenchmark . Lo que obtendrá el descargador será un modelo de 65.7 puntos sin capacidades ofensivas de red —la puntuación será superada por el próximo lanzamiento, pero esta «no haremos» declarada con antelación es lo que realmente queda de K3.1 Pro.
Enlaces de referencia:
- Blog de lanzamiento oficial de Kimi
- Discusión en HN
- Documentación de modelo de Kimi Code