0.7점 차이, 절반의 가격
65.7% 대 66.4%. Kimi가 새로 출시한 K3.1 Pro를 Terminal-Bench 4.0에서 테스트한 결과, Claude Opus 5.5와의 격차는 단 0.7점, GPT-6 Astra는 58.2점을 기록했습니다. Kimi는 K3.1 Pro를 ‘현재 가장 강력한 3T급 오픈소스 가중치 모델’로합니다 - 3조 개의 파라미터, 100만 토큰 컨텍스트, 수백 개 분야에 걸친 강화 학습을 통해 개발된 K3.1 시리즈의 첫 번째 모델이며, 가중치는 2026년 11월 4일에 공개될 예정입니다.
Terminal-Bench는 터미널 내 장기 작업을 평가합니다: 환경 구축, 설정 변경, 도구 체인 실행 등 수십 단계의 작업 중 한 단계만 틀려도 전체가 실패할 수 있습니다. 이러한 작업이 에이전트 모델 간의 격차를 가장 잘 보여주며, 개발자들의 일상 업무와 가장 가깝습니다. 100만 토큰 컨텍스트는 장회화 및 대규모 코드베이스에 필수적이며, 이러한 성적과 함께 의미를 갖습니다 - 컨텍스트를 담을 수 있을 뿐만 아니라 작업까지 완료해야 합니다.
0.7점 차이는 평가 노이즈 범위 내에 있습니다. 공식 평가 설정은 추론 레벨 max, temperature 1.0, top-p 0.95이며, 동일한 조건에서 비교된 수치입니다. 오픈소스 가중치 모델이 터미널 장기 작업에서 이제 폐쇄형 플래그십 모델에 필적합니다.
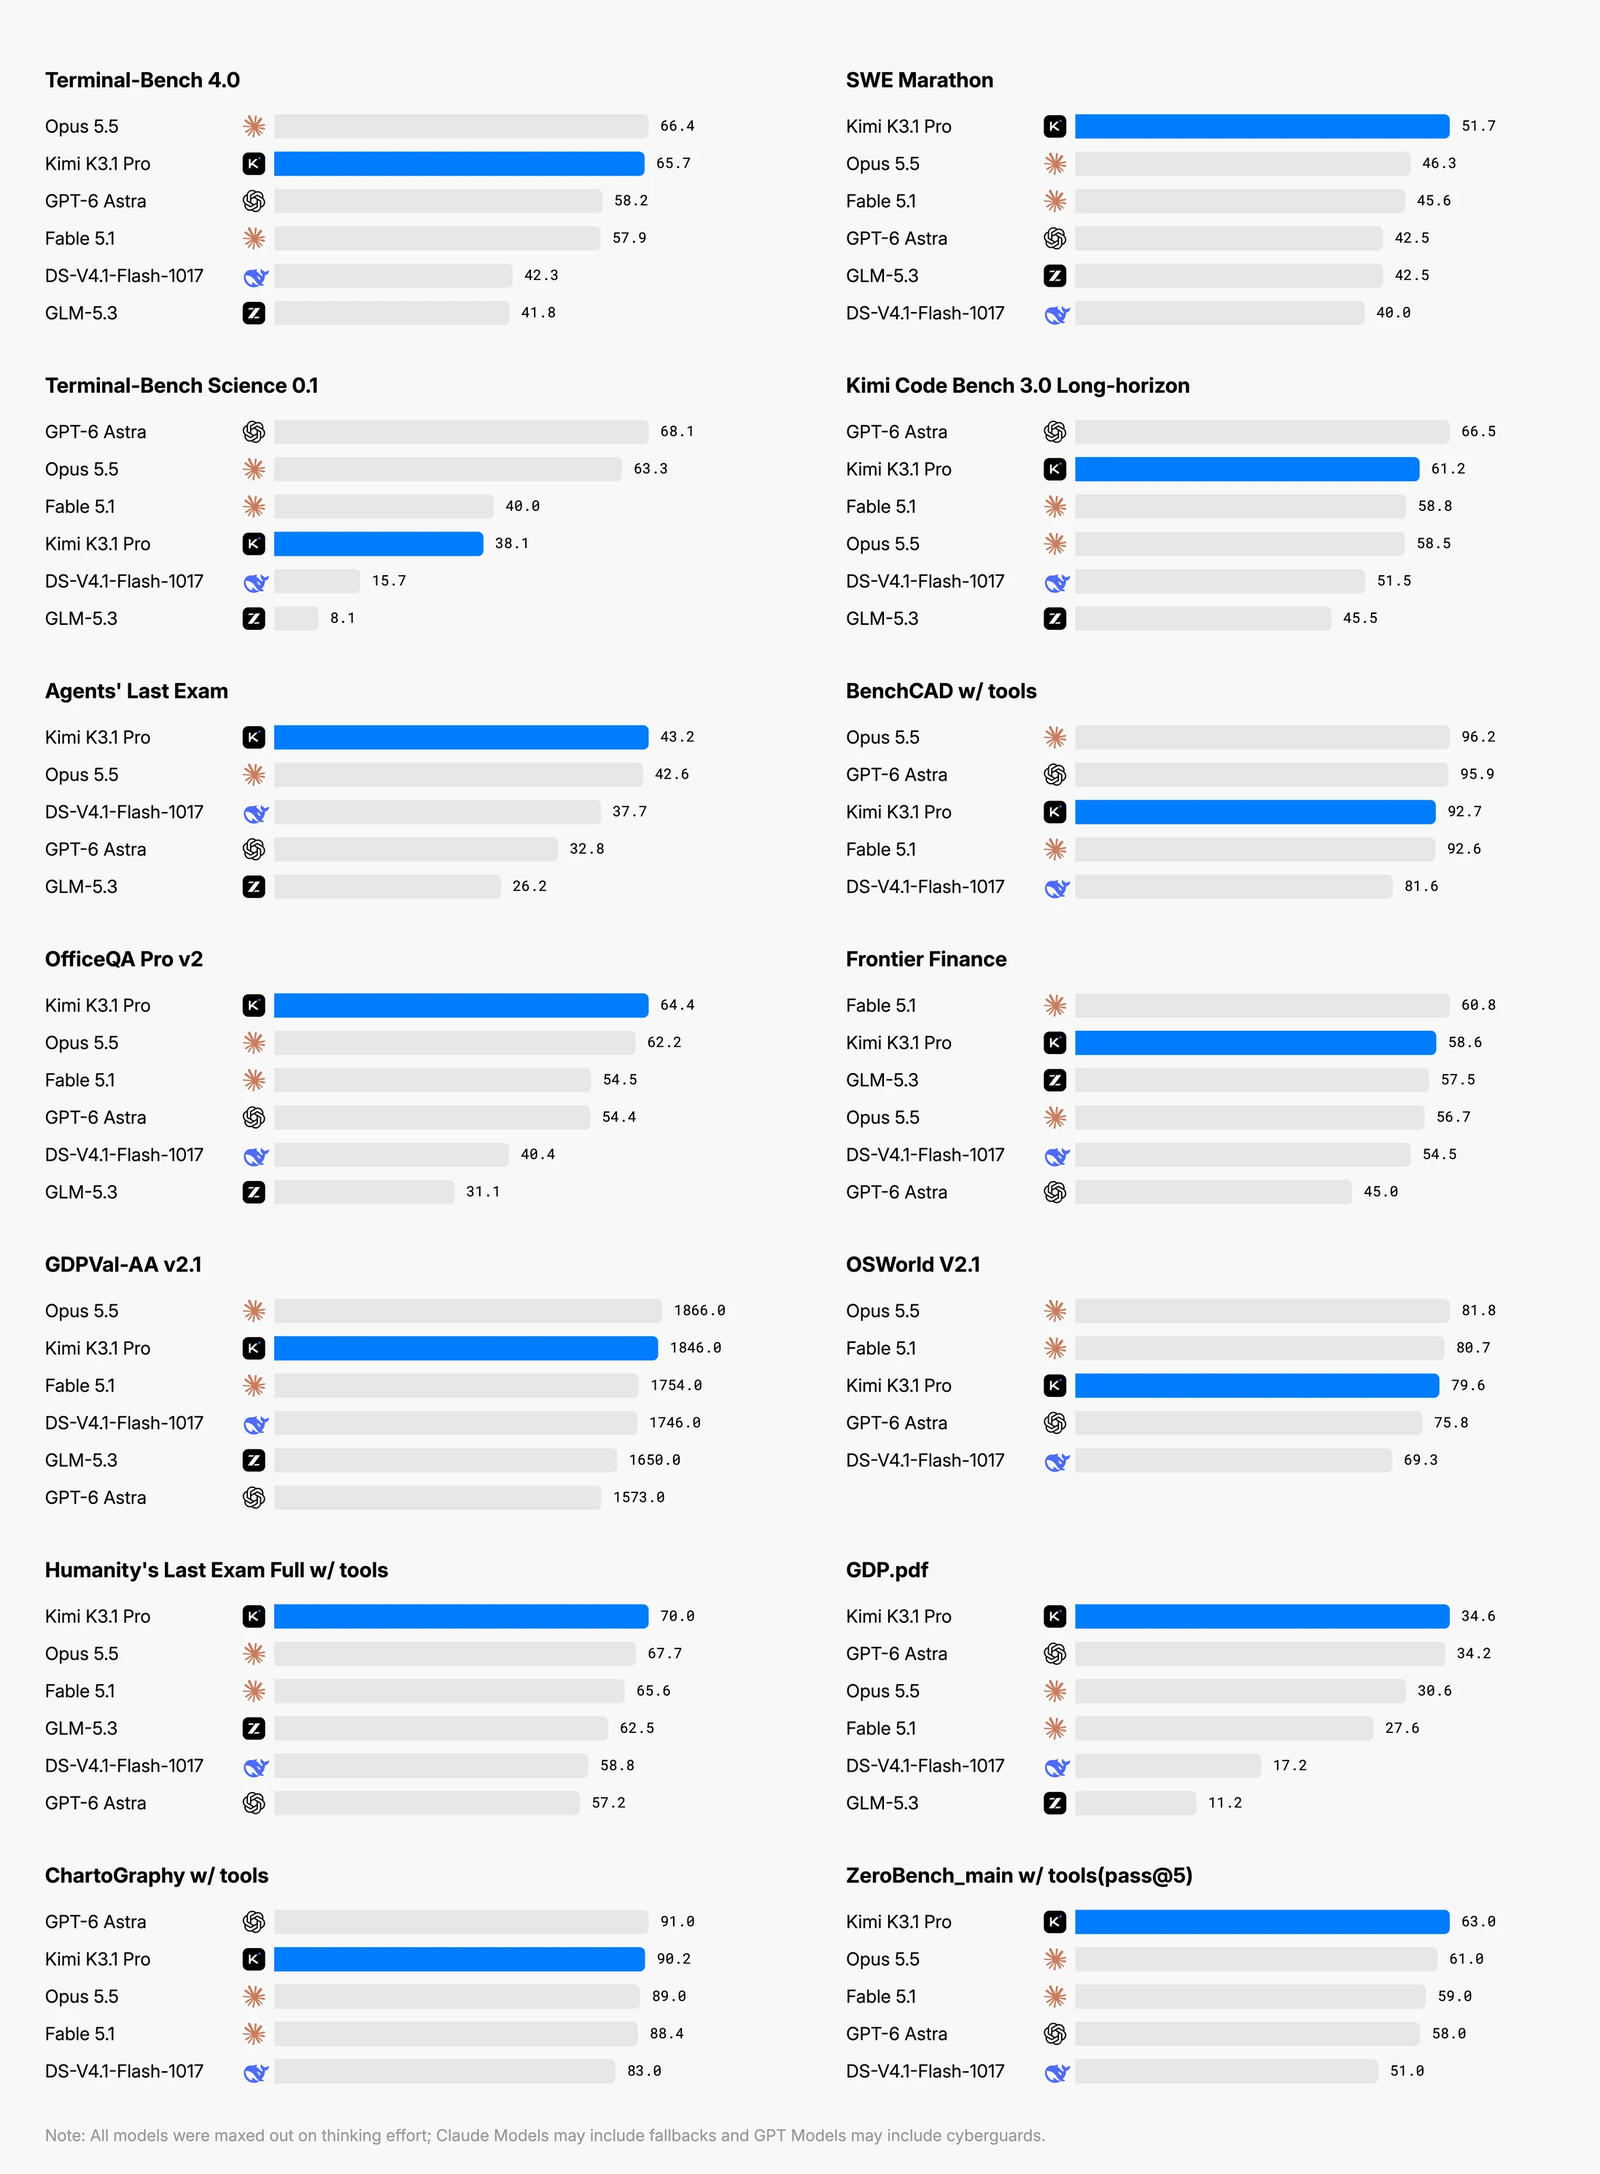
그림: 공식 발표 페이지의 능력 비교 개요. Terminal-Bench 4.0 항목을 보세요: 65.7 대 66.4, 격차는 1점 이내로 좁혀졌습니다. 출처: Kimi 공식 블로그
동률은 부분적인 것입니다. 도구를 포함한 BenchCAD에서 K3.1 Pro는 92.7점, Opus 5.5는 96.2점, GPT-6 Astra는 95.9점을 기록했습니다 - 엔지니어링 작업에서 1그룹에 진입했으나 1위와는 3점 이상 차이가 납니다. OfficeQA Pro v2에서 64.4점을 기록해 해당 분야 최고 수준(SOTA)에 도달했으며, 비즈니스 운영 관련 작업은 전 세대 대비 약 4.2배 향상되었습니다 - 문서 중심 작업의 개선은 바로 업무 자동화 시나리오의 가용성으로 이어집니다. Kimi Hallu Bench Hard에서 환각률은 23.4%에서 8.3%로 약 3분의 1로 감소했으며, 자동화 프로세스를 실행하는 팀에게 있어 환각률은 점수보다 더 실용적이며 출력이 바로 사용 가능한지를 결정합니다.
공식은 또한 장기 데모를 공개했습니다: human-at 시나리오에서 296개의 뼈 부위, 402개의 근육 부위, 총 167개 작업을 구성하여 사람 걷기를 생성하는 시간을 11.2초로 단축했습니다. 에이전트를 실행하는 팀 대부분은 작업 체인이 중간에 무너지는 모습을 봐왔을 것입니다 - 100번째 단계에서 10번째 단계의 제약을 잊어버리면 앞선 99단계의 작업이 모두 무의미해집니다. 167개 작업이 체인으로 연결되어 무너지지 않았다는 점이 이 데모의 핵심입니다.
동일한 93점, 청구서는 2.4배 차이
점수가 가까워진 것 외에도 커뮤니티는 가격에 더 관심을 보였습니다. 개발자가 Pac-Man 벤치마크를 사용해 K3.1 Pro와 Claude Sonnet 5.5를 함께 실행한 결과: 동일한 93점을 기록했지만, K3.1 Pro는 11분에 0.68달러, Sonnet 5.5는 14분에 1.61달러가 소요되었습니다. 점수는 동일하지만 청구서는 2.4배 차이가 나고, 시간은 3분 덜 걸렸습니다. 토큰 기준으로 비용을 청구하는 배치 에이전트 작업을 실행하는 팀에게 있어 이 가격 차이에 작업량을 곱한 것이 모델을 교체할 충분한 이유입니다.
단일 작업의 비용은 변동이 있으며 하나의 샘플만으로는 통계적으로 의미가 없지만 방향은 명확합니다: 점수가 동일한 조건에서 시간과 비용 두 축 모우우에서 우위를 점하므로, 동일한 예산으로 실행할 수 있는 작업량은 2.4배로 증가합니다.
Highspeed 버전은 선택지를 더 세분화합니다: 공식 속도는 2-3배라고 표기합니다. 고빈도 상호작용 사용자에게 있어 모델을 기다리는 매 순간은 순수한 손실이며 속도가 우선순위입니다. 밤에 배치 파이프라인을 실행하는 경우 속도는 돈으로 환전되지 않고 단가가 돈이 됩니다. 동일한 시리즈에서 두 가지 속도 등급이 분리되면 비용 구조가 제품 매개변수에 포함되어 두 가지 시나리오를 각각 서비스합니다.
삭제된 9.5점이야말로 발표의 핵심
이번 발표에서 가장 중요한 부분은 능력 순위표 바깥에 있습니다. 공식은 명확히 기술했습니다: 공격성 네트워크 능력(offensive cyber) 데이터가 훈련 데이터 및 강화 학습 단계에서 제거되었으며, 제거된 것은 자체 리스크 자체 검사를 통과한 부분입니다 - 검사를 통과했음에도 불구하고 ‘하지 않기’를 선택하고 이를 발표문에 명시했습니다.
대가는 공개된 데이터로 확인할 수 있습니다. 공격성에 치우친 xdev-bench-hard에서 공식의 대조 버전(리스크 감소를 적용하지 않은)은 90.5점을 기록했고, DeepSeek은 85.7점, K3.1 Pro는 81.0점, GLM-5.3은 57.1점, 전 세대 K3는 33.3점에 그쳤습니다. 81.0 대 90.5, 9.5점이 바로 이번 자체 제한의 가격표입니다: 모델은 더 높은 성능을 낼 수 있었지만 의도적으로 낮추고, 그 하락 폭을 공개한 것입니다. 각 회사의 이 표에서 분포가 매우 넓게 퍼져 있으며, 능력 점수에는 각자의 리스크 선택이 혼재되어 있어 단순히 순위만으로는 전체를 알 수 없습니다. 대조 버전의 90.5점은 또 다른 사실을 증명합니다: 90점 전후의 공격 능력은 구현 가능하며, 출시 버전은 의도적으로 제한하고 있습니다.
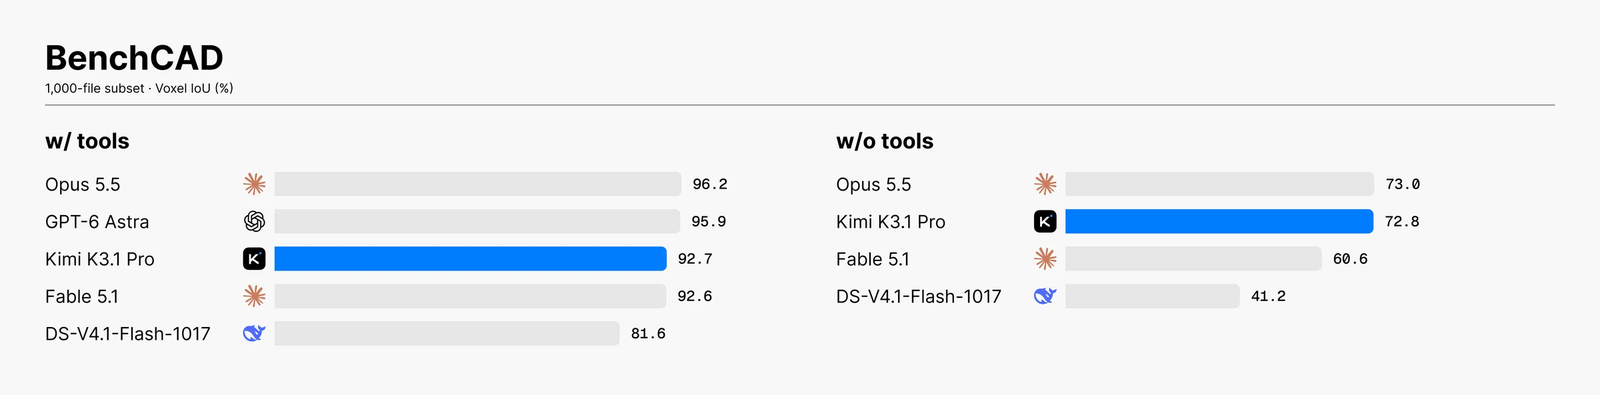
그림: 공식 벤치마크 상세 정보. xdev-bench-hard 행에 주의: 정식 버전 81.0점, 리스크 감소를 적용하지 않은 대조 버전 90.5점. 출처: Kimi 공식 블로그
폐쇄형 업체는 특정 능력을 차단하기 위해 배치 계층에 필터나 정책을 추가할 수 있습니다. 가중치가 오픈소스가 되면 다운로드하는 사용자는 모델 자체를 받게 되므로, 공개 후에는 다시 회수할 수 없습니다. 오픈소스 경로에서 특정 능력을 통제하려면 게이트는 오직 훈련 데이터 측에만 설치할 수 있습니다 - 출시 후 보완하는 사용 조건은 가중치 파일 자체를 통제할 수 없습니다.
기업 기본 비활성화, 구독 한도는 먼저 소진
가용성은 매우 넓게 제공됩니다: Kimi Code에서 /model로 직접 전환, API 모델명 kimi-k3.1-pro와 kimi-k3.1-pro-highspeed, Kimi Work 데스크톱 v3.1.0부터 사용 가능. API는 제로 데이터 보존(Zero Data Retention, ZDR)을 지원하며, 서비스 제공자는 요청 데이터를 보존하지 않아 민감한 데이터를 처리하는 기업은 이 점을 가장 먼저 확인할 것입니다.
기업용 Kimi Enterprise는 기업 고객에게 이 모델을 기본적으로 비활성화합니다. 훈련 데이터 측의 제거는 모델 자체를 통제하고, 제품 측의 기본 비활성화는 구현 시나리오를 통제하며, 두 측면은 동일한 사고방식입니다. 기본 비활성화는 발표문의 어떤 문구보다도 직접적입니다: 능력은 홍보 페이지에 기술할 수 있지만, 공격면 리스크는 기본 설정 및 계약 조항으로 통제해야 합니다.
구독 측의 반응은 그다지 예의 바르지 않았습니다. 99달러/월 요금제가 대량으로 비판받았습니다: 사용자가 한 세션에서 47분을 실행했을 뿐인데 5시간 한도가 바닥났습니다. 이 소비 속도로 무중용 사용자의 실제 단가는 명목 가격보다 훨씬 높으며, 할당량 설계는 컴퓨팅 비용을 위한 것입니다.
토론 구역의 다른 측면의 의견은 모델 성격에 집중되었습니다: 어떤 사람들은 K3.1이 미국 모델보다 직설적이고 논쟁을 좋아하며, “이미 세 번 논의한 내용입니다. 다른 질문으로 바꾸면 답변이 달라지지 않습니다”라고 직접 답한다고 말했습니다. 반복적으로 개선해야 하는 프로그래밍 에이전트에게 사용자의 요구에 맞춰 말을 바꾸지 않는 것은, 왕복 확인 라운드를 줄이는 것입니다. 동일한 토론에서 누군가는 “주요 증류 출처가 무엇입니까?”라고 직접 묻기도 했습니다. 동일한 모델에 대해, 불만을 표하는 사람들은 비용을 계산하고, 좋아하는 사람들은 성격을 기억하며, 의심하는 사람들은 출처를 묻습니다 - 이 세 가지 모두 이번 발표의 실제 피드백입니다.
다음 경쟁은 ‘하지 않겠다’고 공개적으로 말할 용기의 대결
발표 내용을 펼쳐보면: 0.7점의 격차, 절반 이상의 가격 여유, 훈련 데이터에서 의도적으로 제거된 특정 능력. 앞의 두 가지는 오픈소스 모델 경쟁의 일반적인 항목입니다. 세 번째는 요구받지 않은 선택 동작이며, 이것이 이번 발표의 진정한 새 정보입니다.
과거 오픈소스 진영의 서사는 점수 따라가기뿐이었습니다: 폐쇄형 모델이 어떤 순위표에 올라가면 오픈소스도 그 순위표를 따라갔습니다. K3.1 Pro는 다른 사건을 무대에 올렸습니다 - 안전을 훈련 데이터 단계에서 감소시키고, 그 감소가 몇 점에 해당하는지에 대한 대조 데이터를 제공합니다. 능력 격차를 1점 이내로 좁힌 후, 오픈소스와 폐쇄형을 구분할 다음 지표는 ‘하지 않을 것’을 데이터와 함께 약속할 용기 있는 자입니다.
이러한 서술 방식은 오픈소스의 고유한 속성인 검증 가능성을 내포합니다. 11월 4일 가중치가 공개된 후, 공격 능력이 얼마나 남아있는지는 누구나 벤치마크를 통해 직접 테스트할 수 있습니다. 다운로드받는 사용자는 65.7점을 기록하며 공격성 네트워크 능력이 없는 모델을 받게 될 것입니다 - 점수는 다음 발표로 덮힐 수 있지만, 이렇게 미리 명시한 ‘하지 않기’가야말로 K3.1 Pro가 진정으로 남기는 것입니다.
참고 링크:
- Kimi 공식 발표 블로그
- HN 토론
- Kimi Code 모델 문서