À 0,7 point près, pour la moitié du prix
65,7% contre 66,4%. Kimi a soumis son nouveau K3.1 Pro à Terminal-Bench 4.0, ne différant que de 0,7 point de Claude Opus 5.5, tandis que GPT-6 Astra atteint 58,2%. La position officielle de Kimi pour le K3.1 Pro est « le modèle open source le plus puissant actuellement dans la catégorie 3T » — 3 000 milliards de paramètres, un contexte de 1 million de tokens, un apprentissage par renforcement conjoint sur des centaines de domaines, constituant le premier modèle de la série K3.1, dont les poids seront publiés le 4 novembre 2026.
Terminal-Bench évalue les tâches à long terme dans un environnement terminal : configuration d’environnements, modification de paramètres, exécution de chaînes d’outils, où une erreur parmi des dizaines d’étapes fait échouer l’ensemble de la tâche. Ce type de tâche révèle le plus clairement les écarts entre les modèles d’agents et correspond le plus fidèlement au travail quotidien des développeurs. Un contexte de 1 million de tokens est une configuration essentielle pour les longues conversations et les grands dépôts de code, et ce rendu n’a de sens que couplé à cette performance — le contexte doit pouvoir contenir la tâche, et celle-ci doit pouvoir être exécutée.
0,7 point se situe dans la marge de bruit des évaluations. Les paramètres d’évaluation fournis par l’official sont au niveau de déduction max, temperature 1.0, top-p 0.95, avec des chiffres comparés dans les mêmes conditions. Les modèles open source dans les tâches à long terme en terminal sont désormais au même niveau que les modèles propriétaires de pointe.
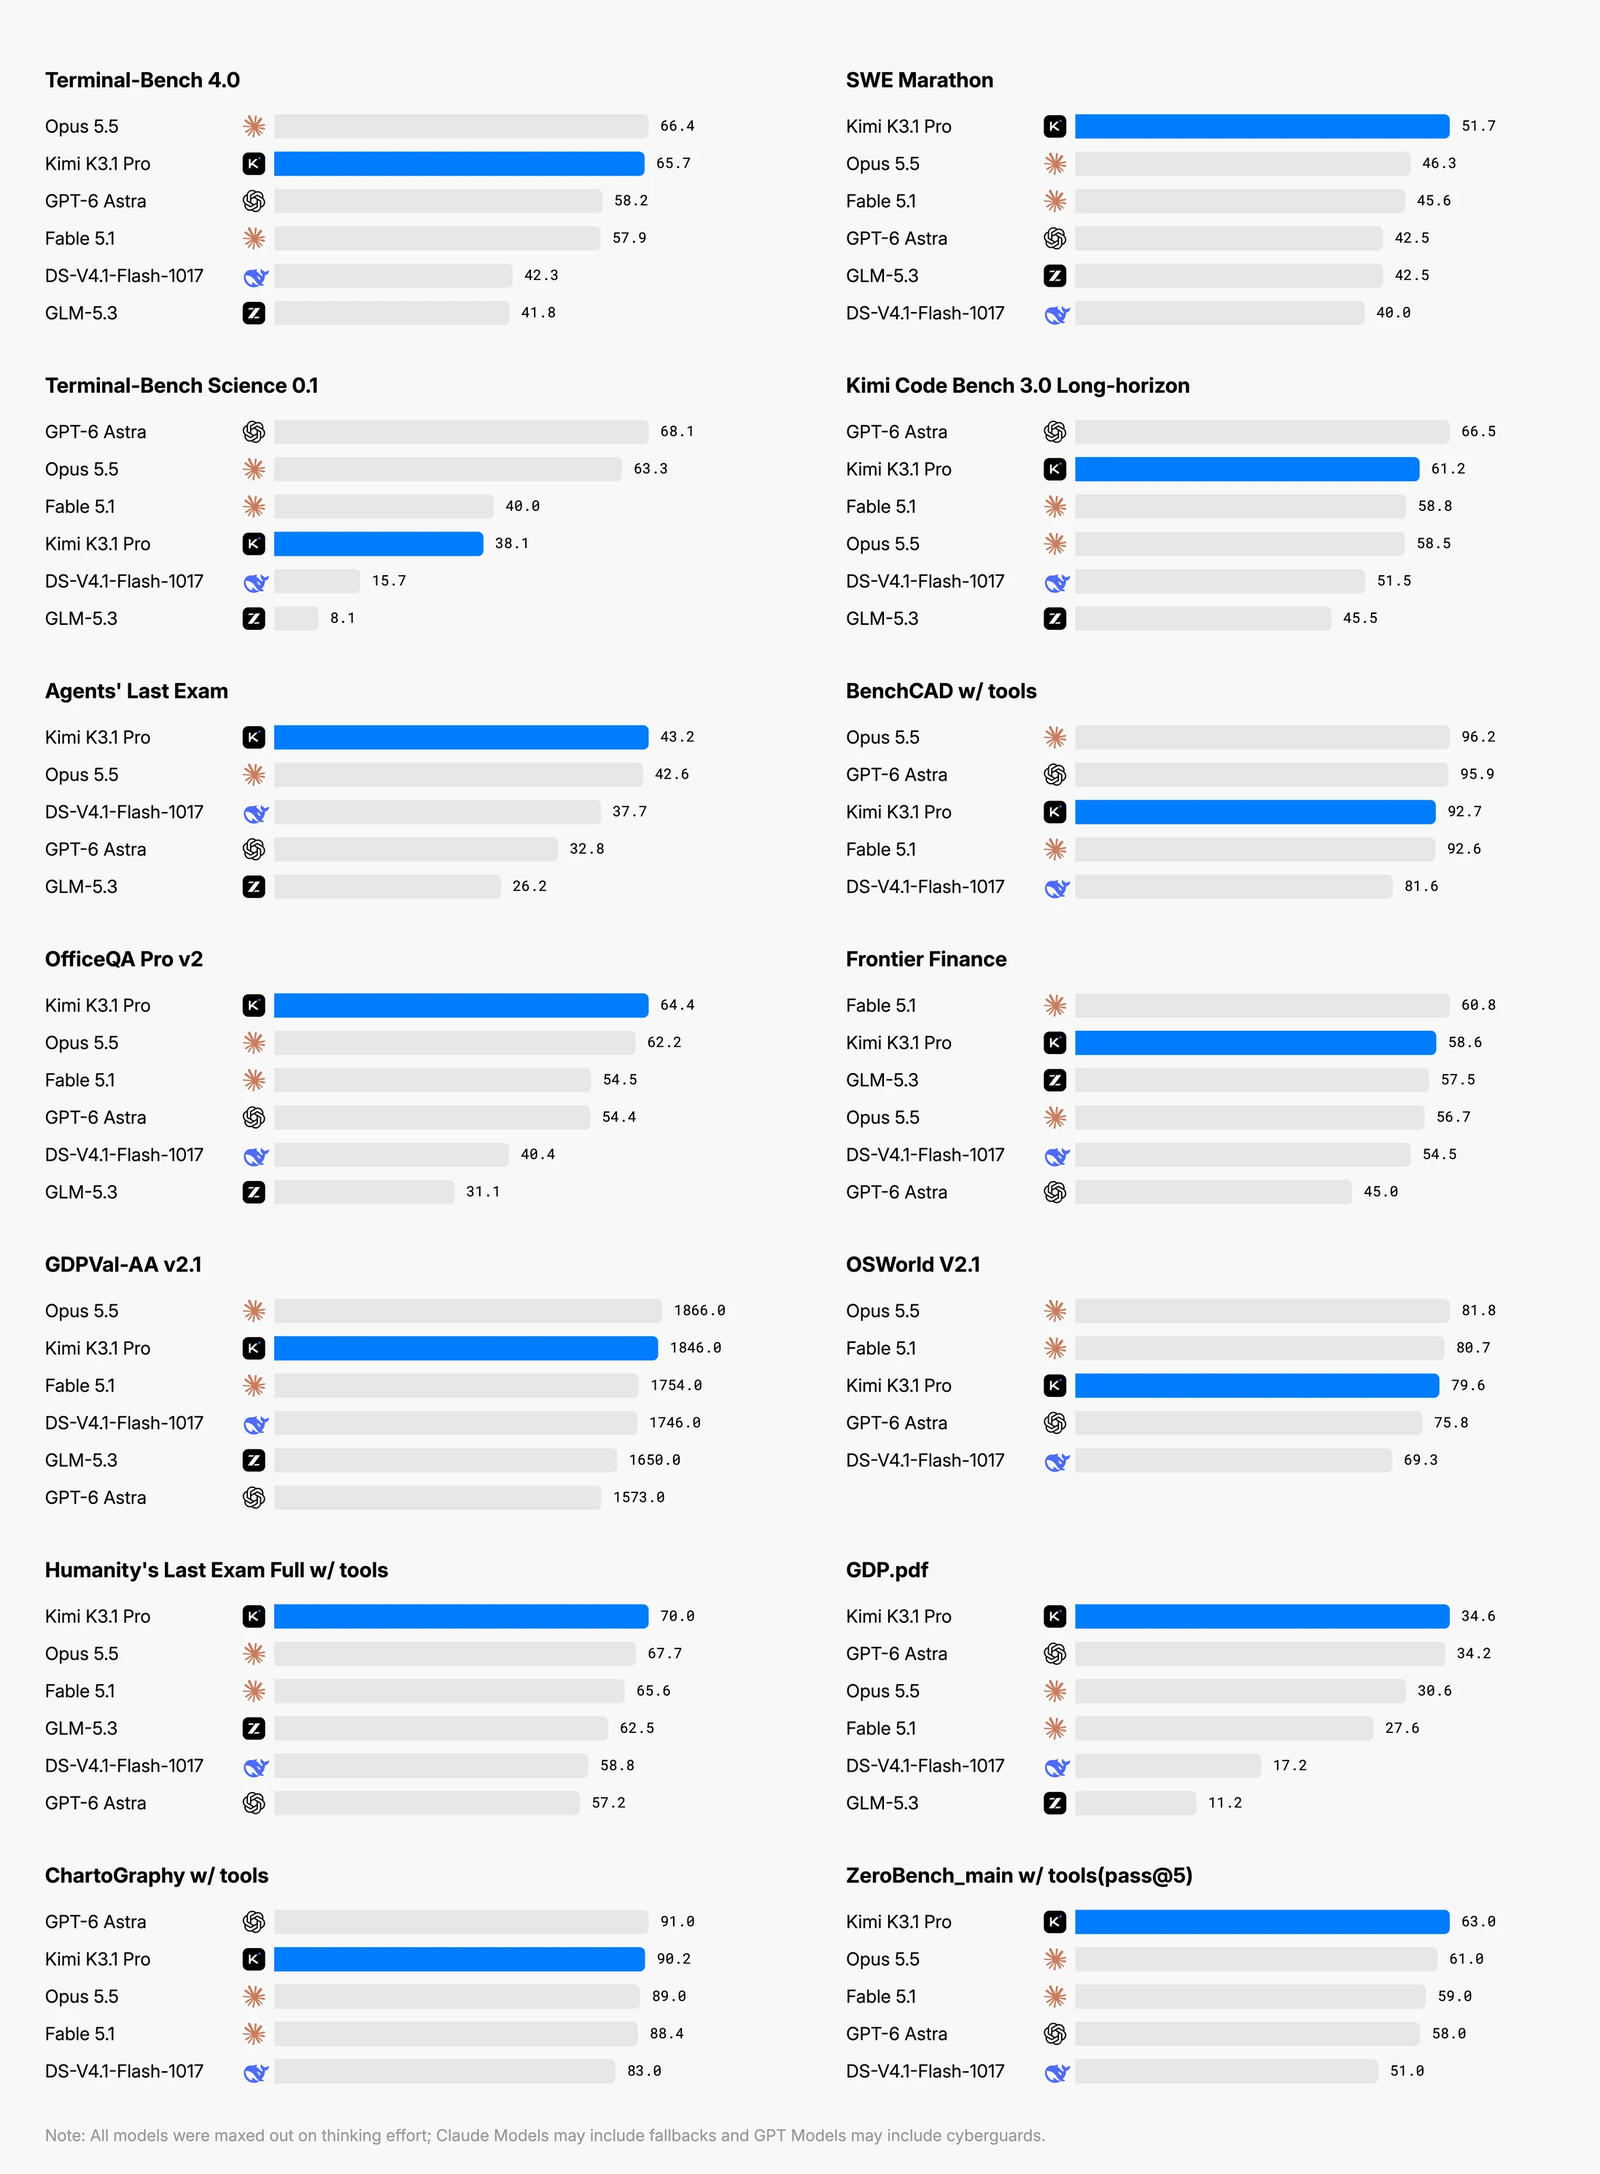
Figure : Aperçu général des comparaisons de capacités de la page de publication officielle. Regardez la colonne Terminal-Bench 4.0 : 65,7 contre 66,4, l’écart est réduit à moins de 1 point. Source : Blog officiel de Kimi
La performance est parfaite localement. Dans BenchCAD avec outils, le K3.1 Pro obtient 92,7 contre 96,2 pour l’Opus 5.5 et 95,9 pour le GPT-6 Astra — il est dans le premier tier pour les tâches d’ingénierie, mais il manque encore plus de 3 points pour la première place. OfficeQA Pro v2 atteint 64,4, que l’official qualifie de meilleur résultat actuel (SOTA), avec une amélioration d’environ 4,2 fois pour les tâches opérationnelles commerciales par rapport à la génération précédente — l’amélioration du travail intensif en documentation correspond directement à la praticabilité dans les scénarios d’automatisation bureautique. Le taux d’hallucination sur Kimi Hallu Bench Hard est passé de 23,4% à 8,3%, soit une réduction d’environ deux tiers ; pour les équipes utilisant des modèles pour automatiser des processus, le taux d’hallucination est plus pratique que les résultats de tests, car il détermine si la sortie peut être utilisée directement.
L’official a également présenté une démonstration à long terme : dans le scénario human-atlas, l’orchestration de 296 os, 402 muscles et 167 tâches a permis de générer une marche humaine en 11,2 secondes. Les équipes qui exécutent des agents ont probablement vu des chaînes de tâches s’effondrer en cours de route — l’étape 100 oublie les contraintes de l’étape 10, rendant les 99 étapes précédentes vaines. Le point clé de cette démonstration est que les 167 tâches enchaînées n’ont pas échoué.
Même score, mais une facture 2,4 fois plus élevée
Au-delà de la proximité des scores, la communauté s’intéresse plus au prix. Un développeur a utilisé la référence Pac-Man pour exécuter le K3.1 Pro et le Claude Sonnet 5.5 côte à côte : pour un score identique de 93, le K3.1 Pro a mis 11 minutes et coûté 0,68 dollar, tandis que le Sonnet 5.5 a mis 14 minutes et coûté 1,61 dollar. Pour un score identique, la facture est 2,4 fois plus élevée, et le temps d’exécution est 3 minutes plus court. Pour les équipes qui exécutent en masse des tâches d’agents en fonction du nombre de tokens, cette différence de prix multipliée par le volume de tâches est la raison suffisante pour changer de modèle.
Le coût d’une tâche unique peut varier, un seul exemple ne suffit pas pour une statistique, mais la tendance est claire : avec un score identique, le temps et le coût sont simultanément avantageux, permettant de doubler le volume de tâches réalisables avec le même budget.
La version Highspeed décompose encore plus les choix : l’official annonce une vitesse 2 à 3 fois supérieure. Pour les utilisateurs à interaction fréquente, chaque seconde d’attente du modèle est une perte nette, la vitesse est donc prioritaire ; pour les pipelines exécutés par lots pendant la nuit, la vitesse ne génère pas d’argent, seul le prix unitaire compte. La séparation en deux niveaux de vitesse au sein de la même série intègre déjà la structure des coûts dans les paramètres du produit, servant deux types de scénarios différents.
Les 9,5 points supprimés sont le vrai point fort de cette publication
Le paragraphe le plus important de cette publication ne figure pas dans les classements de capacités. L’official indique clairement que les données relatives aux capacités de cyberattaque offensive ont été retirées des corpus d’entraînement et des phases d’apprentissage par renforcement, et ce, malgré le fait qu’il s’agissait de capacités ayant déjà passé leur propre vérification des risques — ayant réussi cette vérification, elles ont été volontairement exclues, et le choix de « ne pas le faire » figure dans les notes de publication.
Le coût de cette décision est vérifiable par des données publiques. Sur le benchmark orienté vers les attaques, xdev-bench-hard, la version de référence de l’official (sans réduction des risques) atteint 90,5%, DeepSeek obtient 85,7%, le K3.1 Pro se situe à 81,0%, le GLM-5.3 à 57,1%, et la génération précédente K3 à seulement 33,3%. 81,0 contre 90,5, ces 9,5 points représentent le prix de cette auto-limitation : le modèle aurait pu obtenir un score plus élevé, mais le choix a été de le réduire, et l’amplitude de cette réduction est publique. Les modèles sont très dispersés sur ce tableau, les scores de capacité mélangent les différents compromis en matière de risques de chaque entreprise, et le classement seul ne révèle pas la totalité de la situation. La version de référence à 90,5 points répond également à une autre question : des capacités d’attaque autour de 90 points sont techniquement réalisables, et la version publiée est volontairement restreinte.
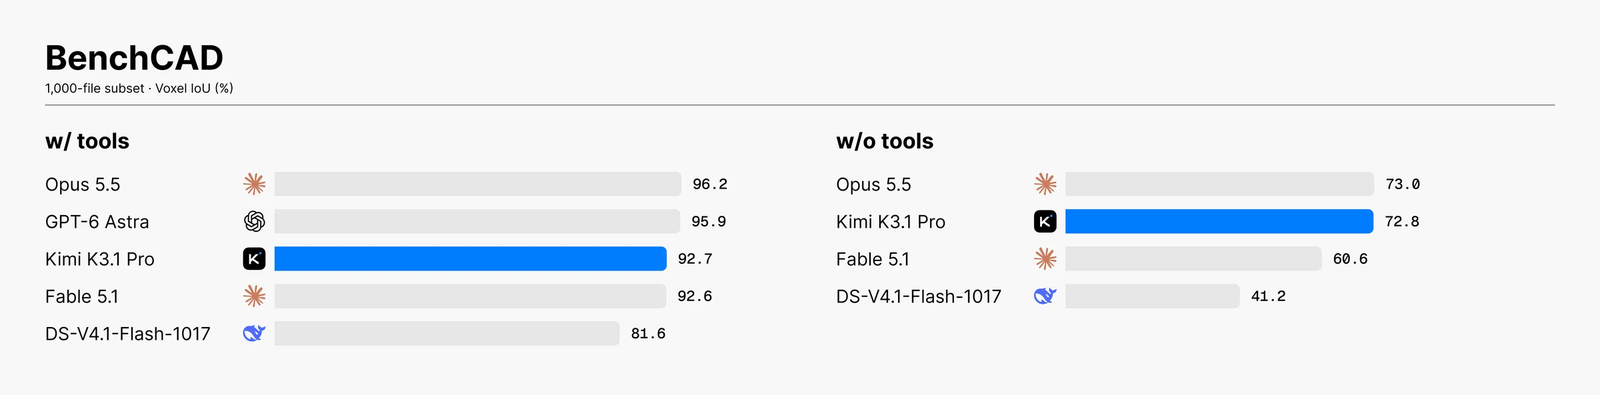
Figure : Détail des tests de benchmark officiels. Notez la ligne xdev-bench-hard : version officielle 81,0, version de référence sans réduction des risques 90,5. Source : Blog officiel de Kimi
Les entreprises propriétaires peuvent bloquer certaines capacités au niveau du déploiement, en ajoutant des filtres et des stratégies ; une fois les poids open source, ce que téléchargent les utilisateurs est le modèle lui-même, et une fois publié, il ne peut plus être récupéré. Si l’on souhaite maîtriser certaines capacités sur la voie open source, la seule solution est d’agir au niveau des données d’entraînement — les conditions d’utilisation ajoutées après publication ne peuvent pas contrôler les fichiers de poids eux-mêmes.
Par défaut désactivé pour les entreprises, les quotas d’abonnement épuisés
La disponibilité est complète : dans Kimi Code, on peut basculer directement via /model, le nom du modèle APTI est kimi-k3-1-pro et kimi-k3-1-pro-highspeed, et il est disponible à partir de la version v3.1.0 de Kimi Work pour desktop. L’APTI prend en charge la non-rétention des données (Zero Data Retention, ZDR), où le fournisseur ne stocke pas les données de requête, une fonctionnalité que les entreprises utilisant des données privées examineront en priorité.
Pour les entreprises, Kimi Enterprise désactive ce modèle par défaut pour les clients professionnels. Le retrait au niveau des données d’entraînement contrôle le modèle lui-même, tandis que la désactivation par défaut au niveau du produit contrôle le scénario de déploiement, les deux approches suivant la même logique. La désactivation par défaut est plus explicite que n’importe quelle formulation dans les notes de publication : les capacités peuvent être mentionnées sur la page de promotion, mais les risques liés au périmètre d’attaque doivent être gérés par la configuration par défaut et les clauses contractuelles.
La réaction côté abonnement est moins bienveillante. Forfait de 99 dollars par mois fortement critiqué : un utilisateur a rapporté qu’une seule session de 47 minutes a épuisé son quota de 5 heures. À ce rythme de consommation, le prix réel pour les utilisateurs intensifs est bien supérieur au prix affiché, la conception des quotas servant à compenser le coût du calcul.
D’un autre côté du forum, les discussions se concentrent sur la personnalité du modèle : certains estiment que le K3.1 est plus direct et enclin à débattre que les modèles américains, répondant directement « nous avons déjà discuté de cela trois fois, changer de formulation ne changera pas la réponse ». Pour un agent de programmation itératif, ne pas céder à la demande de l’utilisateur permet d’économiser des allers-retours de confirmation. Dans ces mêmes discussions, d’autres demandent immédiatement « quelle est la principale source de distillation ? ». Pour un même modèle, ceux qui critiquent calculent le coût, ceux qui l’aiment notent sa personnalité, et ceux qui sont suspicieux demandent son origine — les trois sont des retours réels sur cette publication.
La prochaine compétition portera sur celui qui ose dire « ne pas le faire »
En dépliant le contenu de la publication : un écart de 0,7 point, un espace de prix plus de deux fois inférieur, une capacité volontairement retirée des données d’entraînement. Les deux premiers éléments sont des points de compétition standard pour les modèles open source ; le troisième n’était demandé par personne, c’est une action volontaire qui en fait vraiment la nouveauté de cette publication.
Jadis, le récit du camp open source se limitait à la poursuite des scores : quand un modèle propriétaire apparaît dans un classement, le modèle open source le suit. Le K3.1 Pro met une autre chose sur la table : la sécurité passe par une soustraction dès le stade des données d’entraînement, avec des données de référence montrant le coût de cette soustraction. Une fois l’écart de capacité réduit à 1 point, le prochain indicateur différenciant les modèles open source et propriétaires sera celui qui ose transformer le « ne pas faire » en une promesse chiffrée.
Cette approche possède une caractéristique propre aux modèles open source : la vérifiabilité. Le 4 novembre, une fois les poids publiés, n’importe qui pourra tester par lui-même les capacités d’attaque restantes. Ce que téléchargera l’utilisateur sera un modèle à 65,7 points, sans capacités de cyberattaque — le score sera dépassé par la prochaine publication, mais cet engagement préalable du « ne pas le faire » est ce que le K3.1 Pro laissera réellement comme héritage.
Liens de référence :
- Blog de publication officielle de Kimi
- Discussion HN
- Documentation du modèle Kimi Code