Le 22 septembre 2026, Xiaomi a dévoilé son dernier grand modèle open source, crédité d’un score de 46,32 sur l’Artificial Analysis Intelligence Index v4.3. Plus percutante encore que ce résultat chiffré, une facture affichée directement en première page du rapport technique détaille le coût de l’ensemble du pipeline d’apprentissage par renforcement : environ 850 000 dollars pour la version Flash et 2,62 millions de dollars pour la version Pro.
Le point de bascule dans la course aux grands modèles ne réside plus dans l’accumulation massive de puces graphiques, mais dans la capacité à faire valider publiquement ses méthodes d’entraînement. Alors que les géants propriétaires s’abritent derrière des budgets de calcul colossaux pour décourager la concurrence, Xiaomi a brisé cette asymétrie d’information en diffusant en direct l’intégralité de son cycle d’apprentissage par renforcement pendant six jours consécutifs.
Une facture transparente pour le modèle open source le plus puissant
MiMo-V2.6-Pro a surclassé Kimi K3 et Qwen3.8 Max avec un indice d’intelligence de 46,32, s’imposant comme le modèle open source le plus performant du moment. Côté tarification API, Xiaomi s’aligne rigoureusement sur la grille de la génération précédente V2.5. Le coût d’entrée pour Flash n’est que de 0,14 dollar par million de tokens, descendant jusqu’à 0,0028 dollar lorsque le prompt est mis en cache.
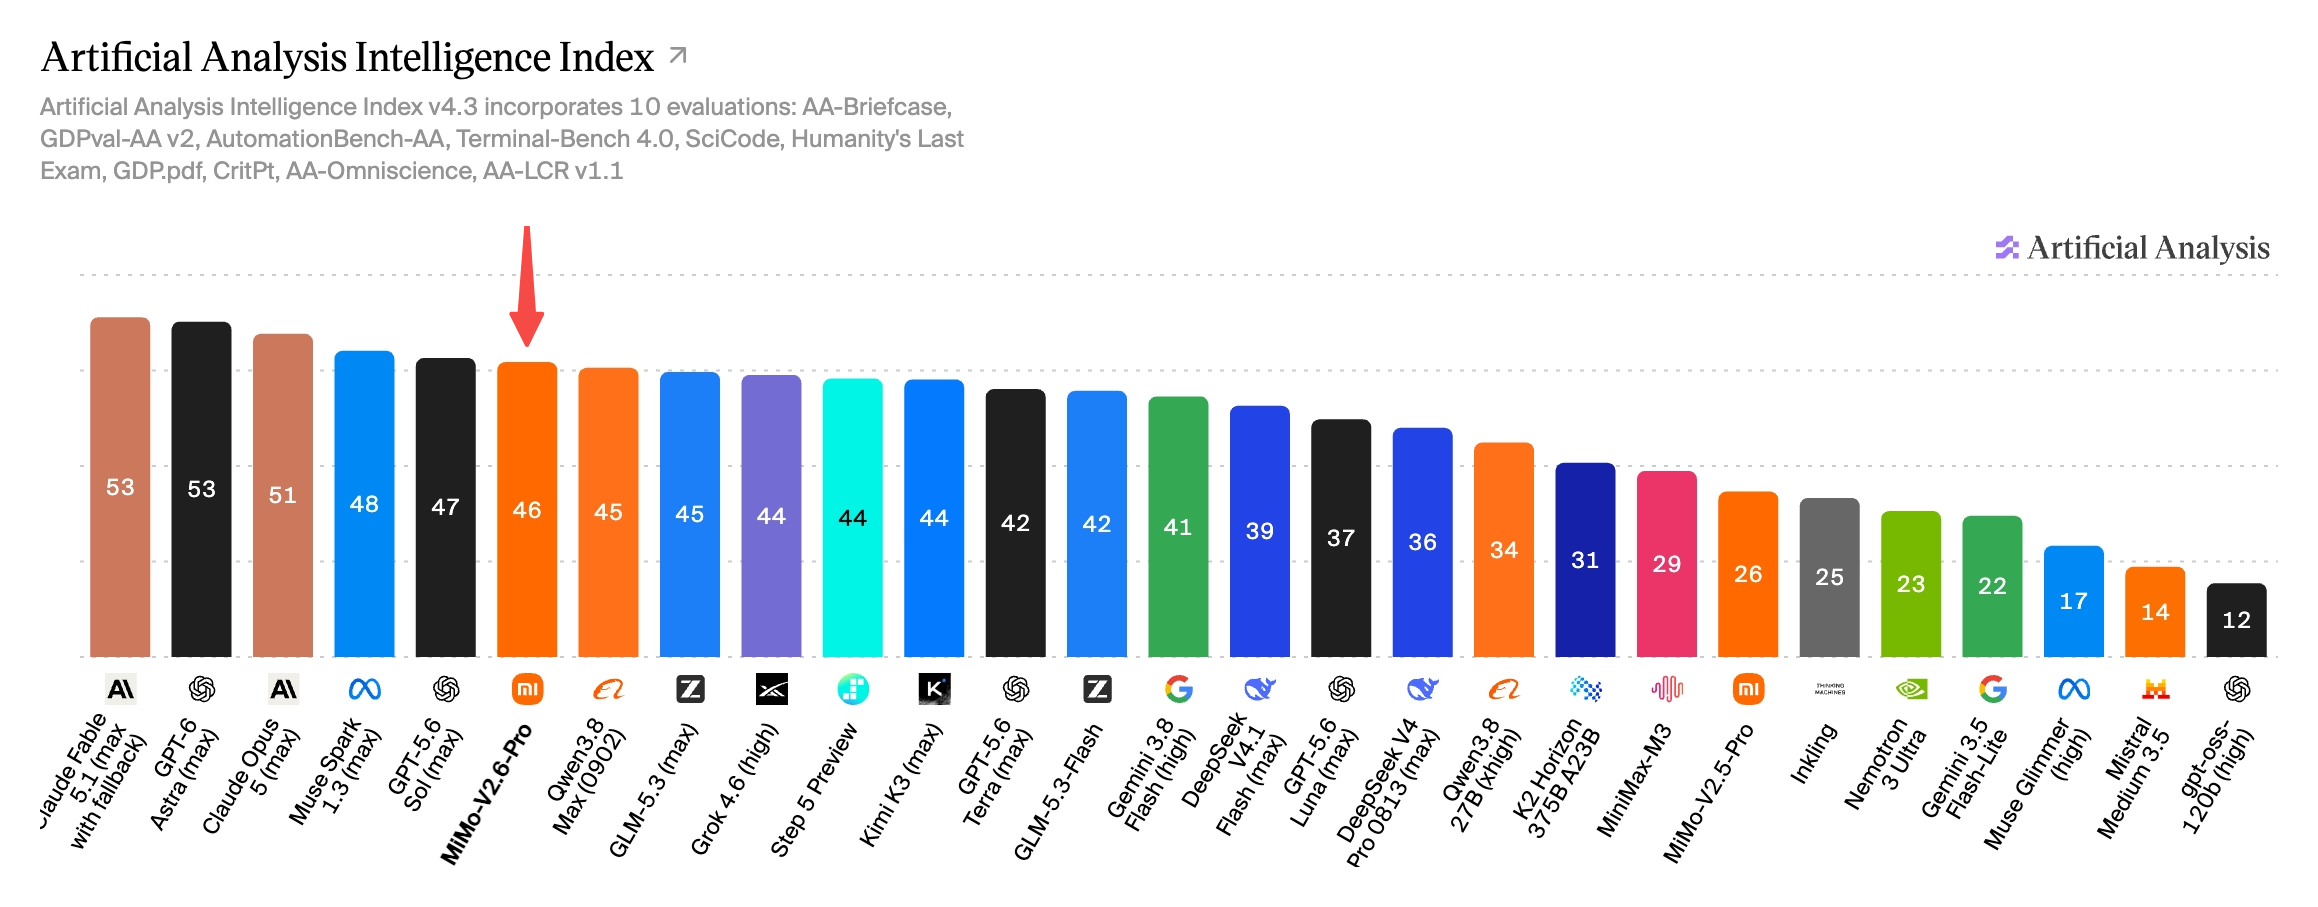 Figure : Graphique à barres de l’Artificial Analysis Intelligence Index, MiMo-V2.6-Pro en tête avec 46,32 points. Source : Site officiel de Xiaomi
La structure de coût des modèles de pointe a opéré un basculement radical. Des compétences dont l’ajustement exigeait autrefois des centaines de millions de dollars se négocient désormais à quelques millions. Les modèles open source n’ont plus à supporter les marges exorbitantes prélevées par les acteurs propriétaires.
Lors de l’entraînement, Xiaomi a configuré des lots de 1 568 échantillons par étape, capables de gérer un contexte s’étendant jusqu’à un million de tokens. Cette conception à très haut débit a permis au système d’ingérer entre 3,5 et 3,7 milliards de tokens par étape tout en maintenant un rendement opérationnel maximal.
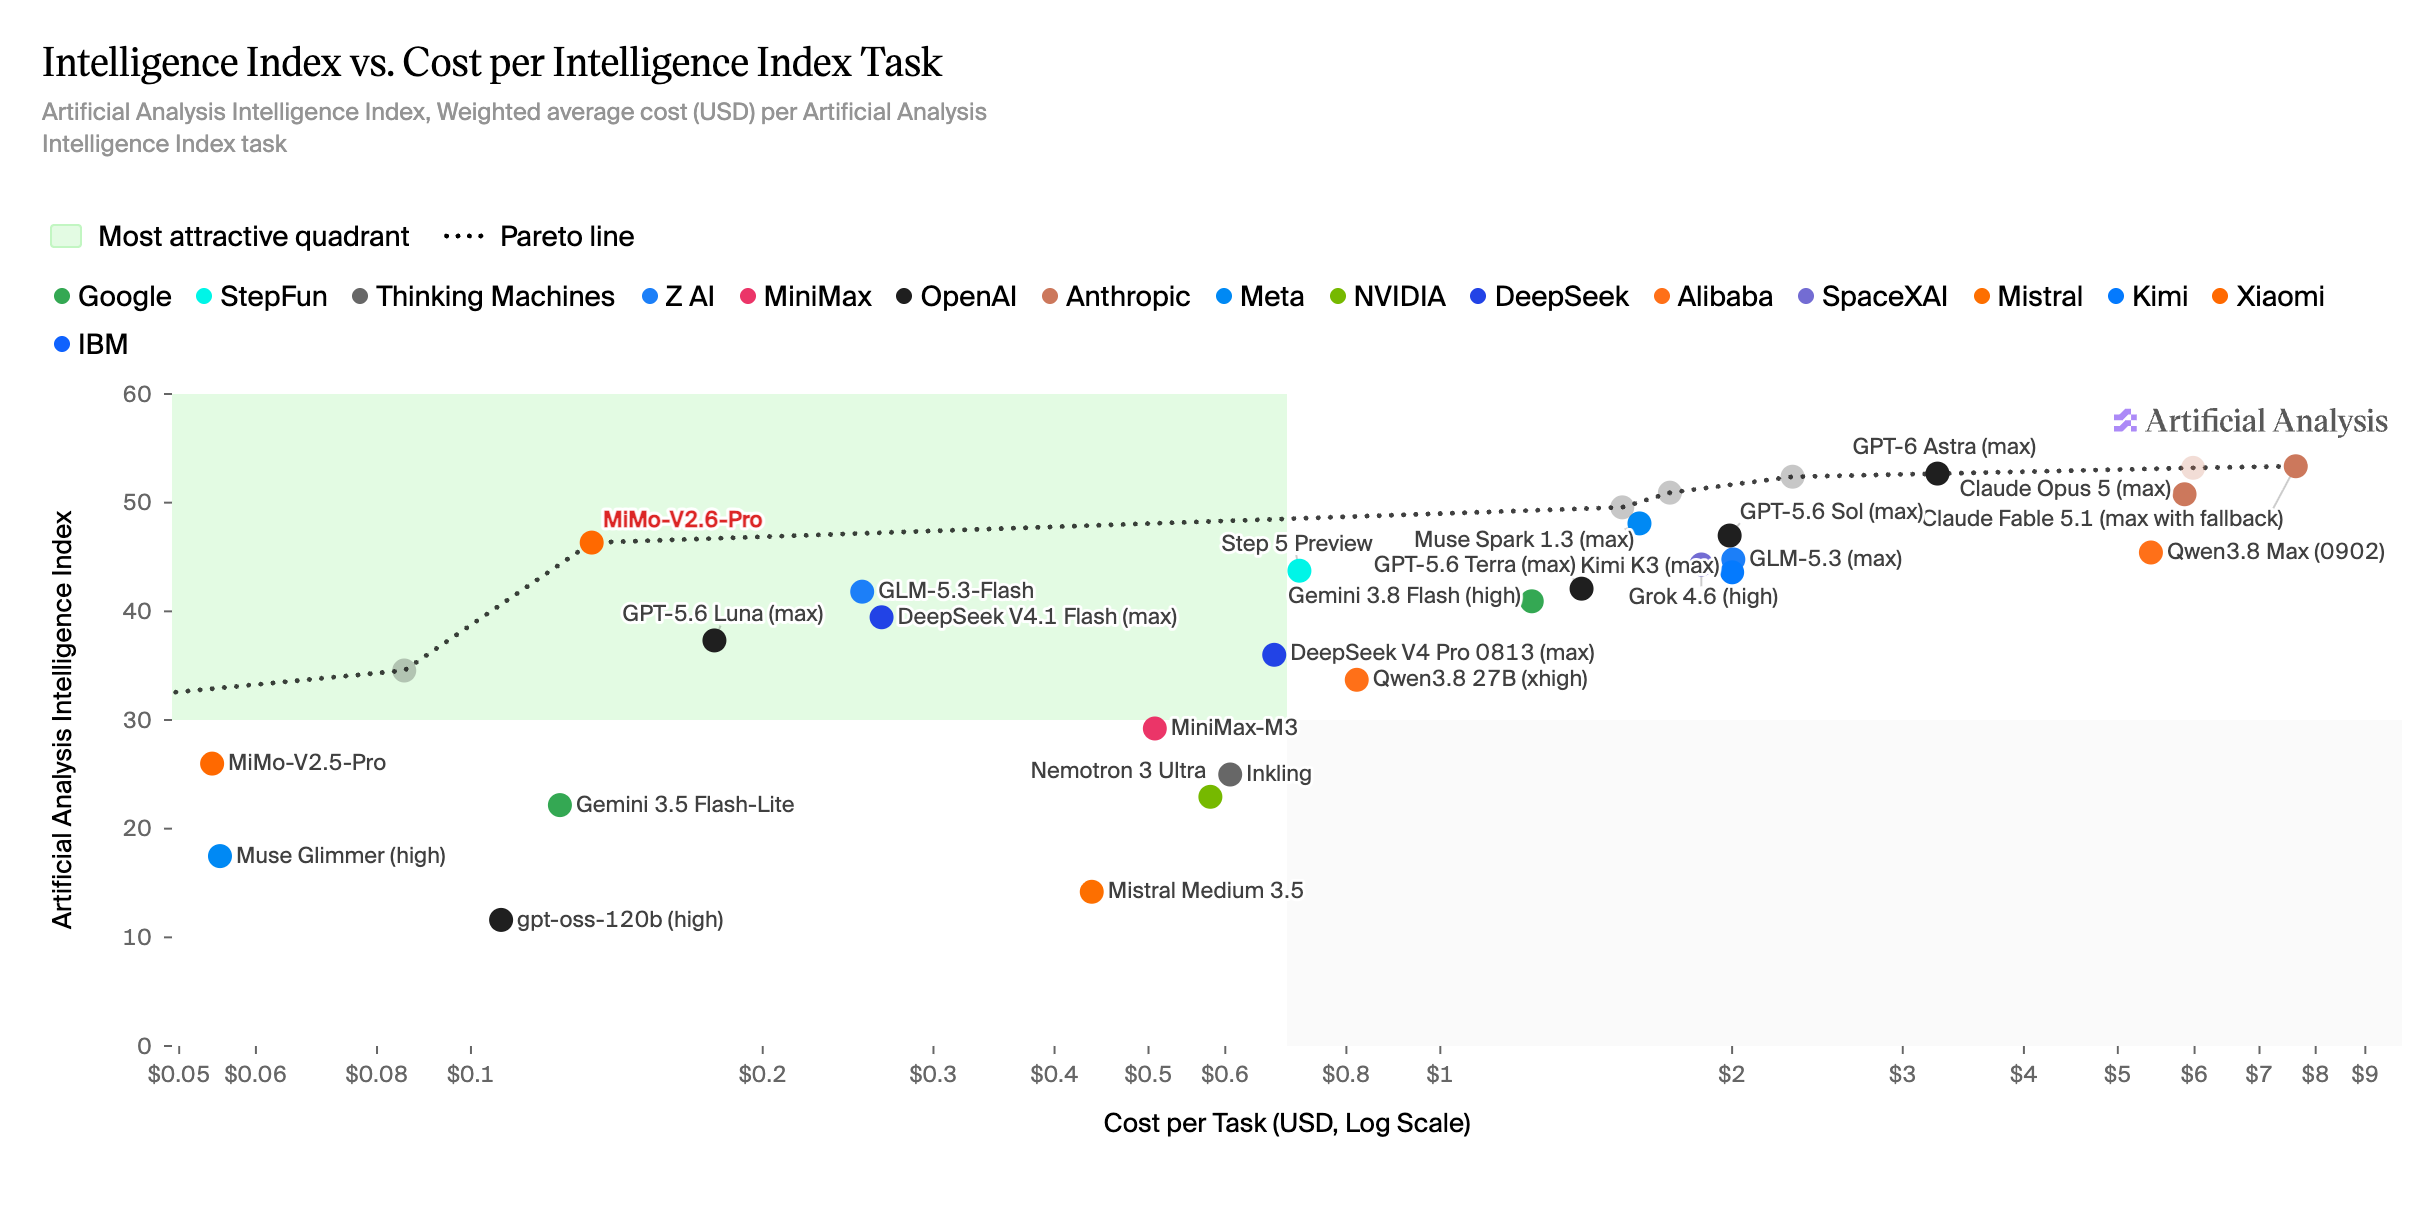 Figure : Nuage de points entre indice d’intelligence et coût par tâche, Pro se situant sur la frontière de Pareto. Source : Artificial Analysis / Site officiel de Xiaomi
Dès que l’équilibre entre données et puissance de calcul est trouvé, la rentabilité de l’intelligence artificielle croît de manière exponentielle. Si la version Pro s’est positionnée sur la frontière de Pareto, elle le doit à une stratégie millimétrée d’allocation des ressources, et non à un empilement aveugle de serveurs.
L’entraînement en direct brise la boîte noire propriétaire
La communauté des développeurs est lasse des communiqués de victoire des acteurs fermés qui dissimulent tout détail technique. Xiaomi ne s’est pas contenté d’ouvrir son rapport technique et son environnement d’entraînement : l’entreprise a également publié l’intégralité du code d’apprentissage par renforcement. En moins de six jours, Flash et Pro ont chacun validé 30 étapes de RL, générant au passage près de 750 000 trajectoires d’apprentissage.
Diffuser le processus en direct revient à abattre ses cartes sur la table. N’importe quel chercheur peut tester la validité de cette méthode d’entraînement et reproduire les gains de performance observés. Les systèmes propriétaires barricadés derrière des barrières de paiement et dépendants de jeux de données opaques pour truster les classements perdent progressivement la confiance des développeurs.
Pour parer au phénomène de reward hacking (détournement de récompense), monnaie courante en apprentissage par renforcement, les ingénieurs ont mis au point une architecture défensive à quatre niveaux : conception des fonctions de récompense, évaluation contradictoire, détection des anomalies et vérification croisée par des validateurs indépendants. De surcroît, à mesure que l’entraînement prenait de l’ampleur, les poids du routeur ont été préventivement gelés afin d’endiguer toute dérive statistique.
La rigueur de l’exécution technique prime largement sur la débauche brute de puissance de calcul. C’est en inscrivant les règles de validation au cœur même de l’architecture que le modèle converge dans la direction voulue lors de tâches complexes à long terme.
Une courbe de progression qui déjoue la malédiction du plateau
Le benchmark d’ingénierie logicielle au long cours DeepSWE v1.1 constitue le juge de paix des capacités réelles d’un modèle. Lors de cette évaluation, la version Flash est passée de 48,8 à 65,68 points, tandis que la version Pro grimpait de 58,4 à 72,57 points. Tout au long de l’apprentissage par renforcement, la trajectoire n’a connu aucun palier de stagnation notable, affichant une progression continue.
À titre de comparaison, les concurrents propriétaires du moment affichent des résultats comparables : 74,0 pour Claude Opus 5 et 74,0 pour GPT 6 Astra. Pour une fraction minime de leur budget, la version Pro a tutoyé le plafond opérationnel des leaders de l’industrie sur des missions d’ingénierie exigeantes.
Le taux moyen de réussite des tâches d’entraînement a enregistré une hausse relative de 25 % sur Flash et de 12 % sur Pro. Lorsque les mécanismes d’incitation sont clairement formulés, les capacités d’exploration d’un modèle en environnement complexe sont encore loin de toucher leur plafond.
Les capacités du modèle quittent l’écran pour investir le monde physique
Le champ d’action de MiMo-V2.6 ne se cantonne plus à l’écriture de code ou à la génération textuelle. Lors des démonstrations officielles, le système a fait la preuve de sa polyvalence en orchestrant la composition de scènes 3D, la modélisation sous Blender et le pilotage en boucle fermée de bras robotiques. Le modèle s’est également illustré dans la génération d’interfaces web interactives, la composition musicale au format MIDI, et a prêté main-forte à la recherche de pointe en concevant des réseaux métallo-organiques (MOF) destinés à capter les polluants PFAS.
 Figure : Démonstration multimodale générée par MiMo-V2.6. Source : Site officiel de Xiaomi
L’aboutissement naturel de l’intelligence multimodale s’ancre dans le monde physique. Dès lors qu’un modèle fondamental appréhende les paramètres spatiaux et les propriétés des matériaux, il est en mesure de commander directement des bras articulés, des logiciels 3D et des bancs de synthèse chimique, s’émancipant du rôle de simple conseiller cantonné à une fenêtre de messagerie.
La transparence radicale redéfinit les règles de la compétition
Les débats suscités sur Hacker News ont parfaitement capté l’enjeu de cette annonce. L’enthousiasme de la communauté s’est massivement cristallisé autour de la transparence : le rapport technique mentionne sans fard les benchmarks où le modèle s’est montré moins à son avantage, sans la moindre retouche marketing. Les quelques réserves émises n’ont porté que sur les conditions d’utilisation des données chez l’hébergeur et certains partis pris esthétiques sur les démonstrations frontend.
Les développeurs ont plébiscité la feuille de route technique qui leur inspirait le plus confiance. Dans une industrie saturée de promesses commerciales, exposer honnêtement ses vulnérabilités demeure le moyen le plus sûr d’établir une réputation solide.
L’époque où les géants propriétaires pouvaient repousser leurs rivaux derrière des forteresses de capitaux touche à sa fin. Xiaomi a transformé l’apprentissage par renforcement de pointe en une leçon ouverte à tous. Une facture de 850 000 dollars a suffi pour hisser un modèle open source au niveau de l’état de l’art, chaque formule mathématique étant offerte au regard extérieur. Cette capacité à se soumettre à l’audit public est devenue une arme de compétition bien plus redoutable que n’importe quelle réserve de GPU.
Références :
- Discussion sur Hacker News (item?id=49792730)
- Rapport d’évaluation Artificial Analysis Intelligence Index
- Rapport technique officiel de MiMo-V2.6