2026년 9월 22일, 샤오미는 Artificial Analysis Intelligence Index v4.3에서 46.32점을 기록한 최신 오픈소스 대형 언어 모델을 공개했다. 벤치마크 점수보다 더욱 충격적인 것은 기술 보고서 첫 페이지에 그대로 공개된 훈련 비용 청구서였다. 전체 강화학습 파이프라인을 완료하는 데 Flash 버전은 약 85만 달러, Pro 버전은 약 262만 달러가 소요되었다.
거대 모델 경쟁의 승부처는 GPU 보유 수량에서 훈련 방법론의 공개 검증 역량으로 이동하고 있다. 폐쇄형 모델 기업들은 막대한 연산 비용을 앞세워 진입 장벽을 구축해 왔지만, 샤오미는 전체 강화학습 훈련 과정을 6일 동안 생중계하며 이러한 정보 격차를 완전히 허물어뜨렸다.
비용 청구서가 증명한 최강의 오픈소스 모델
MiMo-V2.6-Pro는 지능 지수 46.32점을 기록하며 Kimi K3와 Qwen3.8 Max를 제치고 현재 가장 강력한 오픈소스 모델로 등극했다. API 가격 정책에서도 이전 세대인 V2.5 시리즈와 동일한 수준을 유지했다. Flash 버전의 입력 비용은 100만 토큰당 0.14달러에 불과하며, 프롬프트 캐시가 적용되면 최저 0.0028달러까지 내려간다.
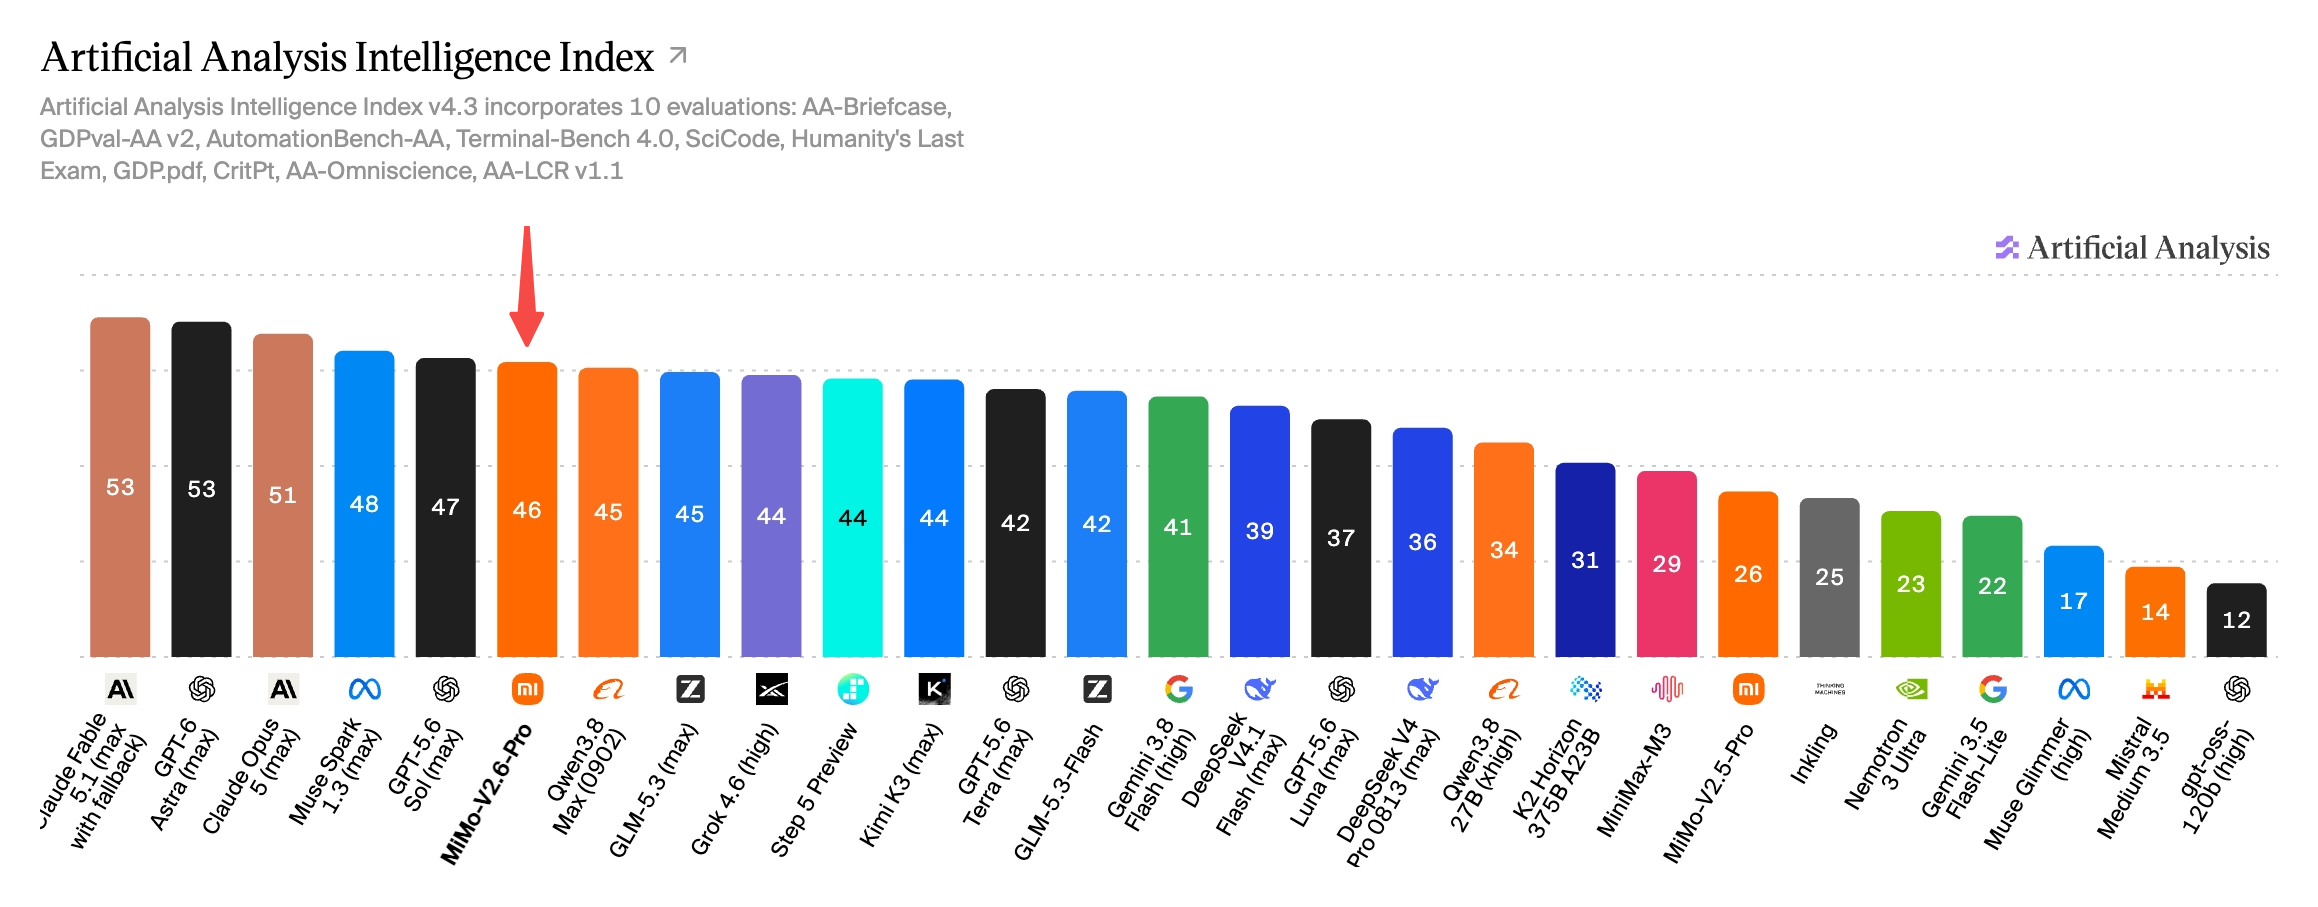 그림: Artificial Analysis 지능 지수 막대 그래프. MiMo-V2.6-Pro가 46.32점으로 선두를 기록했다. 출처: 샤오미 공식 웹사이트
최첨단 모델의 비용 구조에 근본적인 대반전이 일어났다. 과거 수억 달러의 투자가 필요했던 프론티어급 능력이 이제 수백만 달러 규모로 압축되었다. 오픈소스 모델은 더 이상 폐쇄형 빅테크 기업들이 부과하던 과도한 프리미엄을 감당할 필요가 없다.
실제 훈련에서 샤오미는 단계당 1568개의 샘플을 업데이트하고 최대 100만 토큰의 컨텍스트를 지원하는 구성을 채택했다. 이러한 고처리량 설계를 통해 시스템은 매 스텝마다 3.5B에서 3.7B 토큰을 처리하면서도 높은 운영 효율성을 유지했다.
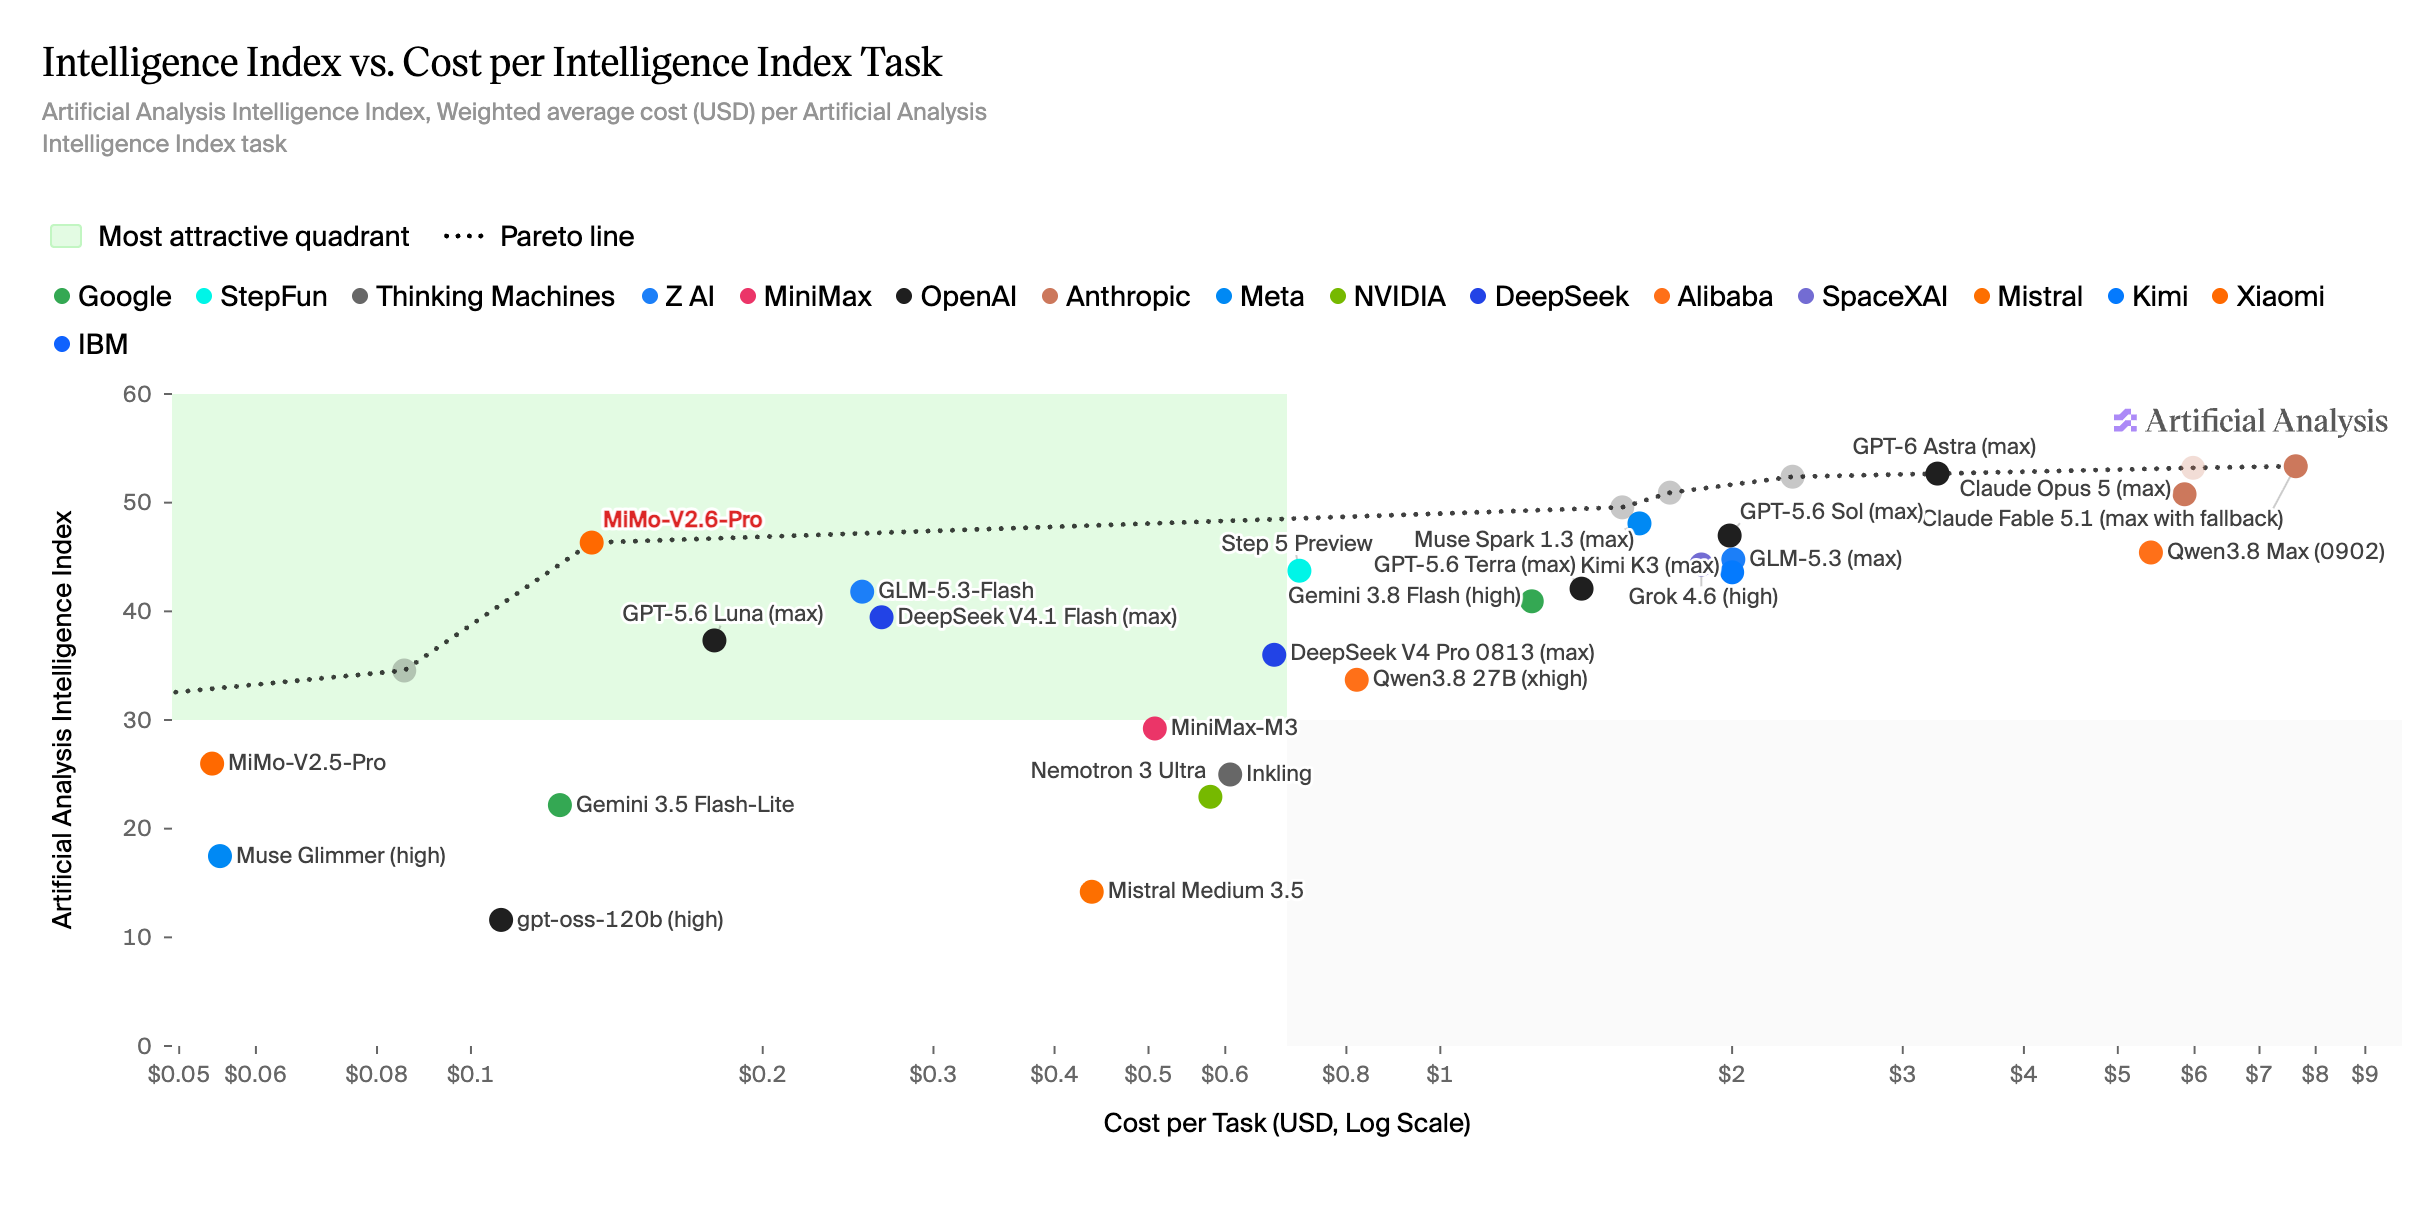 그림: 지능 지수와 작업당 비용의 산점도 그래프. Pro 버전이 파레토 프론티어 위에 자리 잡았다. 출처: Artificial Analysis / 샤오미 공식 웹사이트
데이터와 연산력의 비율을 정밀하게 맞추면, 지능 생산의 가성비는 기하급수적으로 상승한다. Pro 버전이 파레토 프론티어에 안착할 수 있었던 것은 무작정 장비를 쏟아부어서가 아니라 정밀한 자원 스케줄링 전략 덕분이었다.
훈련 생중계로 무너진 폐쇄형 블랙박스
개발자 커뮤니티는 기술적 세부 사항 없이 보도자료만 쏟아내는 폐쇄형 기업들의 관행에 피로감을 느끼고 있었다. 샤오미는 기술 보고서와 훈련 환경을 오픈소스로 공개했을 뿐만 아니라, 강화학습 코드베이스 전체를 함께 내놓았다. 채 6일이 걸리지 않은 기간 동안 Flash와 Pro는 각각 30회의 강화학습 스텝을 완료하며 총 75만 개에 달하는 궤적을 생성했다.
훈련의 전체 과정을 생중계한 것은 모든 패를 테이블 위에 올려놓은 것과 같다. 누구라도 이 훈련 방법론의 유효성을 검증하고 그에 상응하는 성능 향상을 재현할 수 있다. API 장벽 뒤에 숨어 비공개 데이터셋으로 벤치마크 순위를 올리던 폐쇄형 시스템은 점차 개발자들의 신뢰를 잃어가고 있다.
강화학습에서 흔히 발생하는 보상 해킹(reward hacking)을 방지하기 위해, 개발팀은 보상 함수 설계, 적대적 평가, 이상 탐지, 검증기 간 교차 검증으로 구성된 4단계 방어 시스템을 구축했다. 아울러 훈련 규모가 확장될 때 발생할 수 있는 잠재적 훈련 드리프트를 억제하기 위해 라우터 가중치를 선제적으로 동결했다.
정교한 엔지니어링 실행력은 무분별한 연산 자원 투입보다 훨씬 중요하다. 핵심 검증기에 규칙을 단단히 새겨 넣어야만 모델이 복잡하고 긴 호흡의 과제에서도 올바른 방향으로 수렴할 수 있다.
정체기 징크스를 깨뜨린 지속적인 상승 곡선
장기 소프트웨어 엔지니어링 벤치마크인 DeepSWE v1.1은 모델의 진짜 역량을 검증하는 시금석이다. 이 평가에서 Flash 버전의 점수는 48.8점에서 65.68점으로 수직 상승했고, Pro 버전은 58.4점에서 72.57점으로 뛰어올랐다. 전체 강화학습 과정 동안 뚜렷한 정체기(플래토) 없이 성능 곡선은 꾸준히 우상향을 그렸다.
비교군으로 동시대 폐쇄형 경쟁 모델인 Claude Opus 5는 74.0점, GPT 6 Astra는 74.0점을 기록했다. Pro 버전은 극히 일부분에 불과한 비용으로 고난도 장기 개발 과제에서 최상위권의 한계선에 바짝 다가섰다.
훈련 작업의 평균 통과율은 Flash 버전에서 상대적으로 25%, Pro 버전에서 12% 향상되었다. 인센티브 메커니즘이 명확히 정의되어 있다면, 복잡한 환경에서 모델의 탐색 잠재력은 결코 한계에 다다르지 않는다.
화면을 넘어 물리 세계로 확장된 모델의 실행력
MiMo-V2.6의 역량은 코드 생성이나 텍스트 대화에만 머무르지 않는다. 공식 시연에서 모델은 3D 장면 구축부터 Blender 모델링, 나아가 로봇 팔의 폐루프 제어까지 아우르는 도약을 보여주었다. 또한 대화형 웹 프론트엔드 인터페이스 생성, MIDI 음악 작곡, 유기 불소 화합물(PFAS) 흡착을 위한 금속 유기 골격체(MOF) 소재 설계 등 최첨단 과학 연구 과제까지 수행했다.
 그림: MiMo-V2.6이 생성한 멀티모달 시연 화면. 출처: 샤오미 공식 웹사이트
멀티모달 지능의 궁극적인 지향점은 물리 세계에 있다. 기초 모델이 공간과 소재의 매개변수를 깊이 이해하게 되면, 단순히 채팅창 안에서 조언을 건네는 수준을 넘어 로봇 팔, 3D 소프트웨어, 합성 도구를 직접 지휘하여 실질적인 물리 작업을 완수할 수 있다.
완전한 투명성이 다시 쓰는 경쟁의 규칙
Hacker News의 토론은 이번 공개의 핵심을 정확하게 짚어냈다. 커뮤니티의 긍정적인 평가는 투명성에 압도적으로 집중되었다. 기술 보고서는 부진했던 벤치마크 결과까지 숨기거나 꾸미지 않고 있는 그대로 기록했다. 논쟁이 된 부분은 호스팅 업체의 데이터 이용 약관이나 공식 프론트엔드 데모 템플릿의 디자인 취향 정도에 불과했다.
개발자들은 진정으로 신뢰할 수 있는 기술 로드맵에 발걸음으로 투표했다. 마케팅 미사여구로 가득 찬 업계에서 약점을 솔직하게 털어놓는 것이야말로 가장 단단한 신뢰를 구축하는 길이다.
자본 장벽으로 경쟁자를 가로막던 폐쇄형 기업들의 시대는 저물어가고 있다. 샤오미는 첨단 강화학습 과정을 누구나 재현할 수 있는 공개 강의로 탈바꿈시켰다. 85만 달러의 비용 청구서로 최첨단 모델과 대등하게 겨루는 오픈소스 모델을 만들어냈고, 모든 계산 과정을 외부의 검증 앞에 내놓았다. 이처럼 공개 검증을 견뎌내는 능력은 GPU를 비축하는 것보다 훨씬 더 날카로운 경쟁 무기가 되었다.
참고 링크:
- Hacker News 토론 (item?id=49792730)
- Artificial Analysis 지능 지수 평가 보고서
- MiMo-V2.6 공식 기술 보고서