Am 22. September 2026 stellte Xiaomi sein neuestes Open-Source-Modell vor, das auf dem Artificial Analysis Intelligence Index v4.3 eine Punktzahl von 46,32 erreichte. Noch beeindruckender als das Testergebnis war jedoch die Kostenaufstellung direkt auf der ersten Seite des technischen Berichts: Der gesamte Reinforcement-Learning-Trainingslauf schlug bei der Flash-Version mit rund 850.000 US-Dollar und bei der Pro-Version mit etwa 2,62 Millionen US-Dollar zu Buche.
Die Entscheidung im Wettbewerb der großen Sprachmodelle verlagert sich von der schieren Anzahl gehorteter Grafikprozessoren hin zur öffentlichen Überprüfbarkeit der Trainingsmethoden. Proprietäre Anbieter nutzen gewaltige Rechenbudgets traditionell zur Abschreckung – Xiaomi hingegen durchbrach diese Informationsasymmetrie, indem das Unternehmen den gesamten Reinforcement-Learning-Prozess sechs Tage lang im Livestream übertrug.
Eine transparente Rechnung für das stärkste Open-Source-Modell
MiMo-V2.6-Pro übertraf mit einem Intelligenzindex von 46,32 sowohl Kimi K3 als auch Qwen3.8 Max und avancierte damit zum derzeit leistungsfähigsten Open-Source-Modell. Bei den API-Preisen behielt Xiaomi das Niveau der vorherigen Generation V2.5 bei. Flash kostet lediglich 0,14 US-Dollar pro Million Input-Token und sinkt bei Treffern im Prompt-Cache auf bis zu 0,0028 US-Dollar.
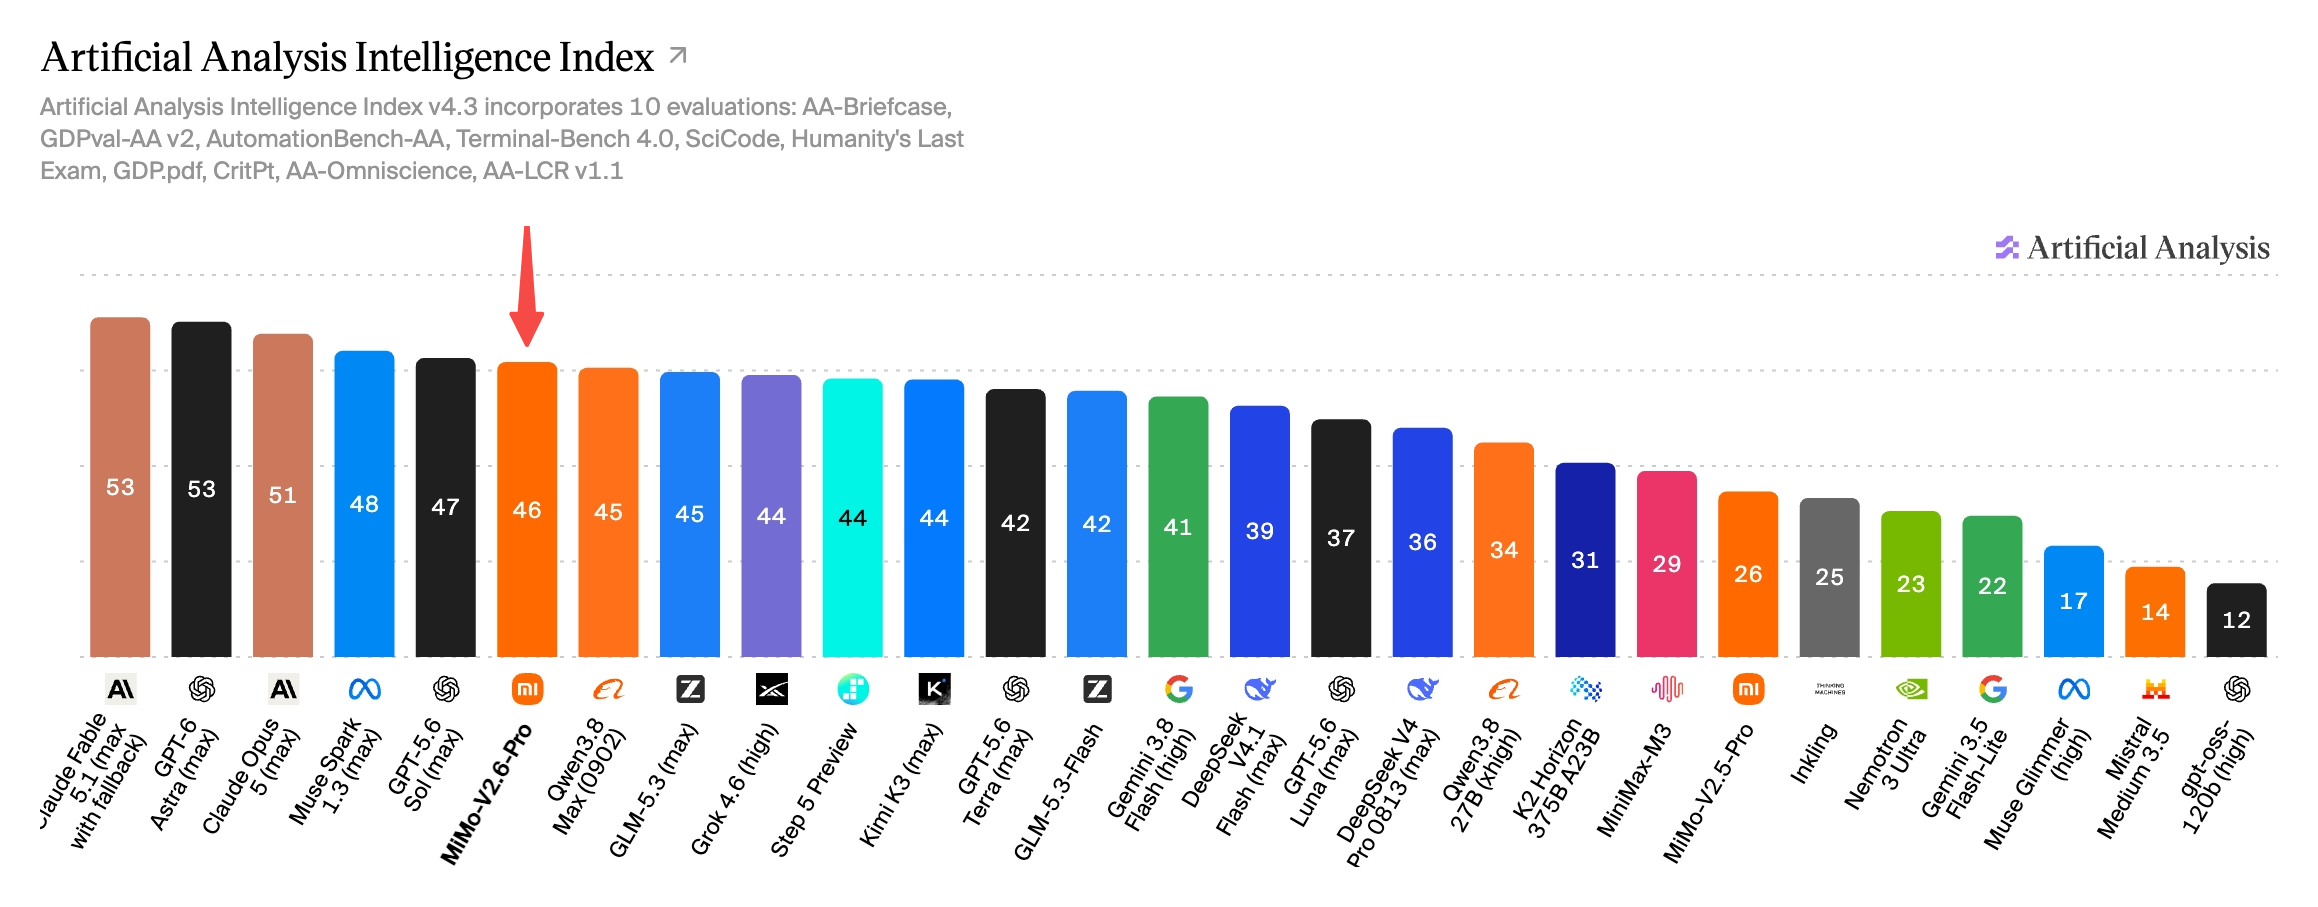 Abbildung: Balkendiagramm des Artificial Analysis Intelligence Index, MiMo-V2.6-Pro führt mit 46,32 Punkten. Quelle: Offizielle Xiaomi-Webseite
Die Kostenstruktur von Spitzenmodellen hat sich grundlegend gewandelt. Fähigkeiten, deren Feinabstimmung einst hunderte Millionen Dollar verschlang, lassen sich nun im einstelligen Millionenbereich realisieren. Open-Source-Modelle müssen nicht länger die aufgeblähten Margen geschlossener Tech-Giganten mittragen.
Im eigentlichen Trainingsbetrieb setzte Xiaomi auf 1.568 Samples pro Update-Schritt und unterstützte Kontexte von bis zu einer Million Token. Dieses Setup mit hohem Durchsatz ermöglichte es dem System, pro Schritt zwischen 3,5 und 3,7 Milliarden Token mit anhaltend hoher Effizienz zu verarbeiten.
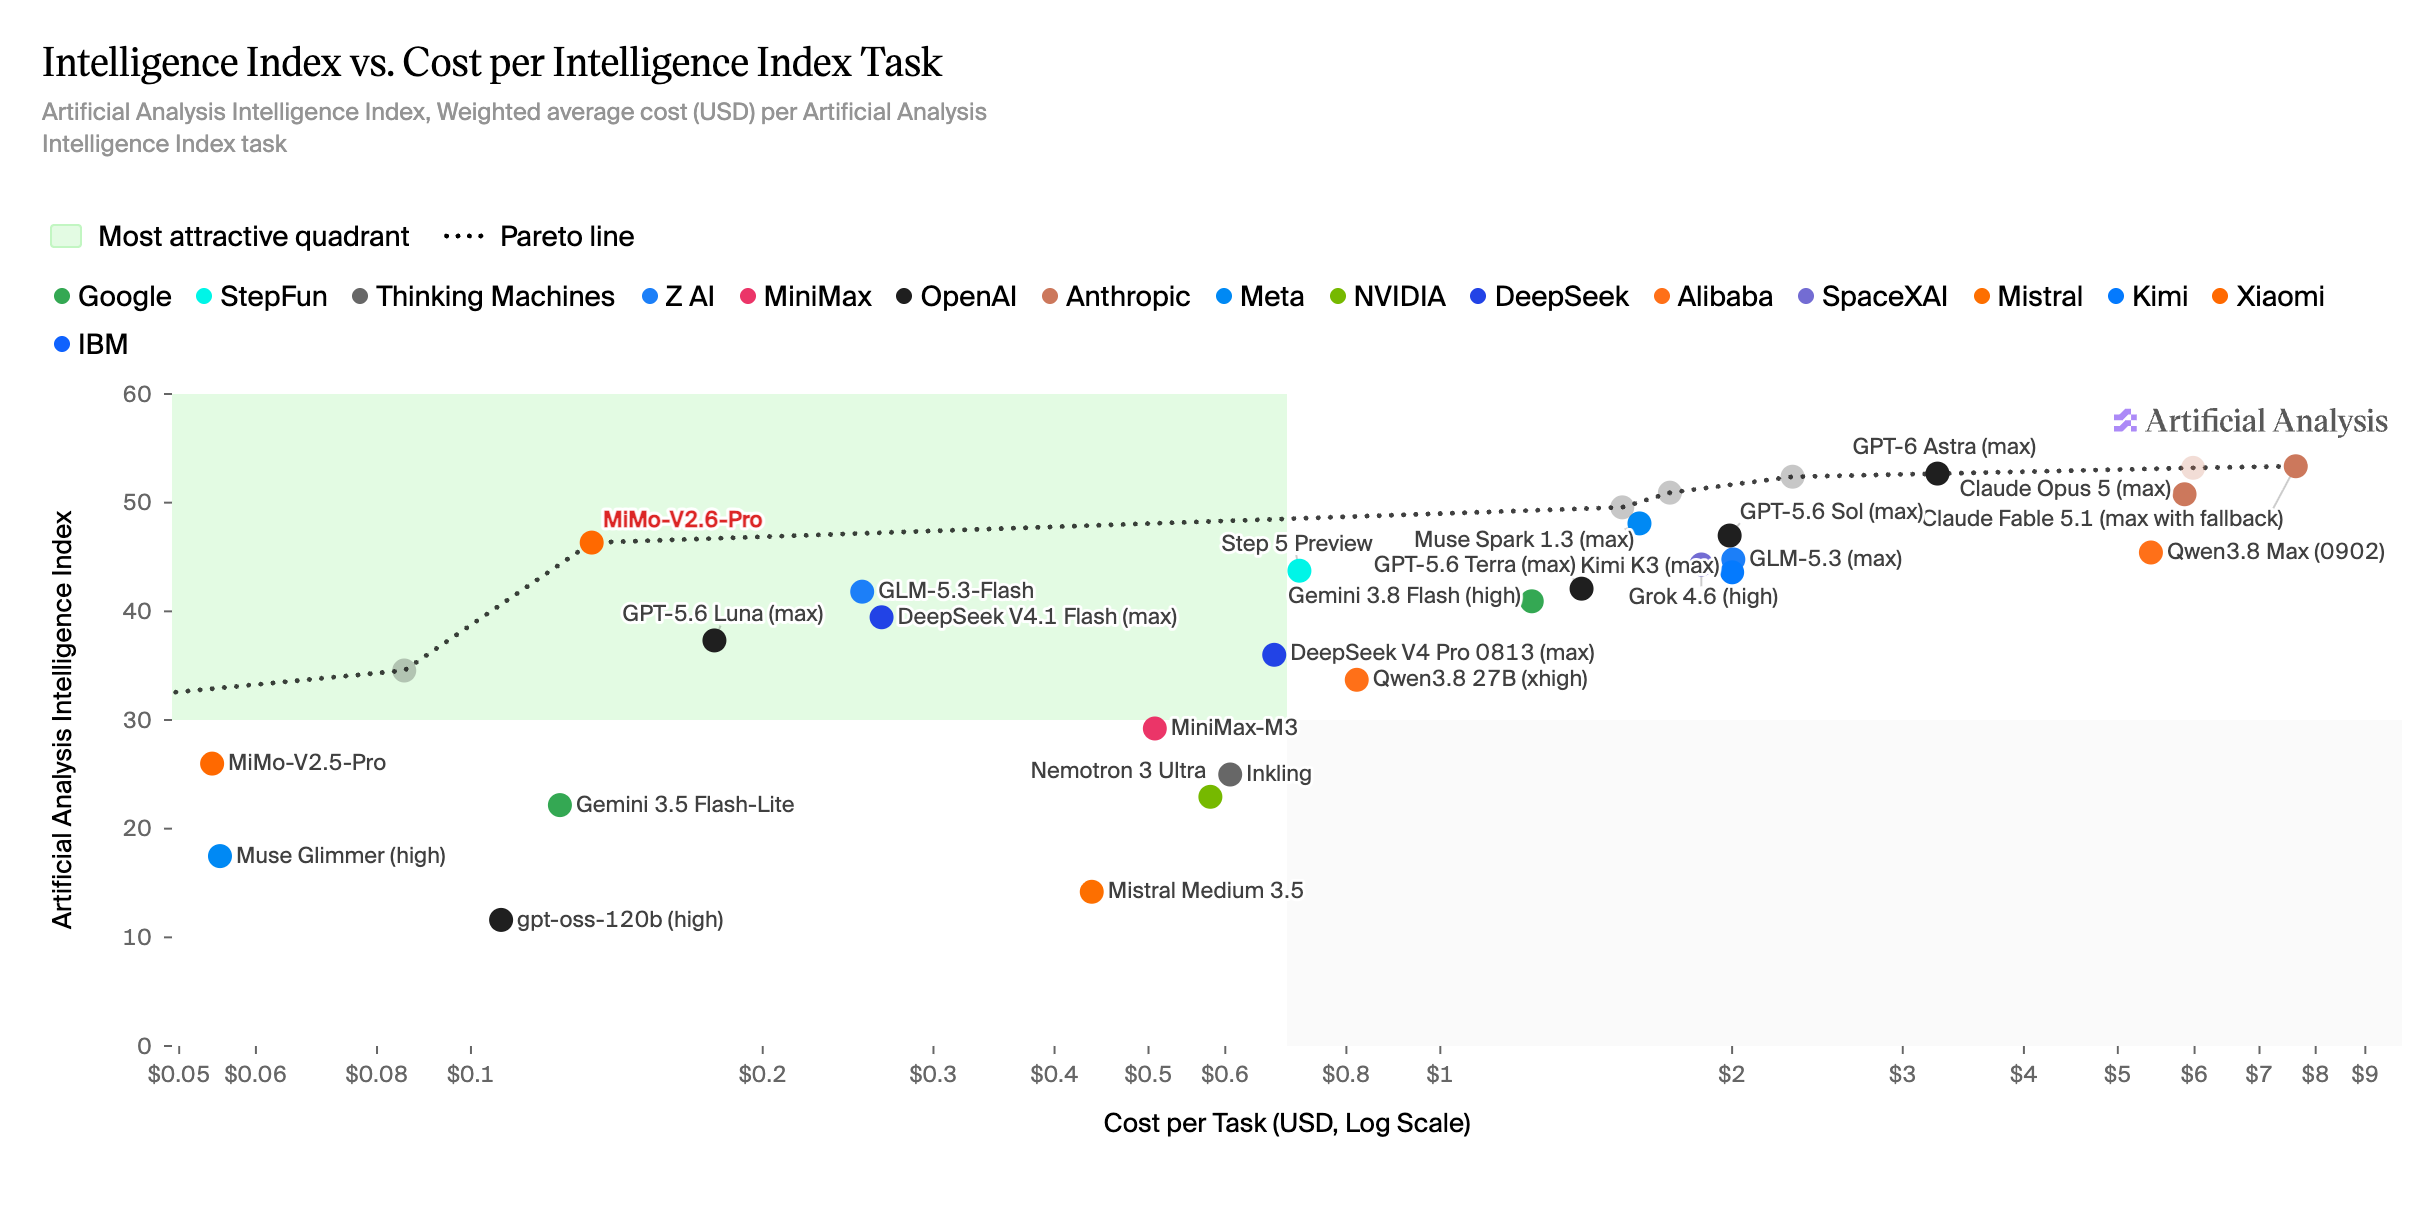 Abbildung: Streudiagramm von Intelligenzindex und Kosten pro Aufgabe, Pro liegt auf der Pareto-Grenze. Quelle: Artificial Analysis / Offizielle Xiaomi-Webseite
Stimmt das Verhältnis von Daten und Rechenleistung, steigt die Wirtschaftlichkeit maschineller Intelligenz exponentiell. Dass die Pro-Version punktgenau auf der Pareto-Grenze landete, ist das Ergebnis einer präzisen Ressourcenplanung und nicht eines blinden Anhäufens von Hardware.
Livestream-Training knackt die geschlossene Blackbox
Die Entwickler-Community ist der PR-Offensiven proprietärer Anbieter überdrüssig, die vollmundige Pressemitteilungen ohne technische Details veröffentlichen. Xiaomi stellte nicht nur den technischen Bericht und die Trainingsumgebung unter eine Open-Source-Lizenz, sondern gab auch die Codebasis für das bestärkende Lernen frei. In weniger als sechs Tagen absolvierten Flash und Pro jeweils 30 RL-Schritte und generierten zusammen rund 750.000 Trajektorien.
Ein durchgehender Livestream bedeutet, alle Karten offen auf den Tisch zu legen. Jeder kann die Stichhaltigkeit dieses Trainingsansatzes überprüfen und die entsprechenden Leistungssteigerungen reproduzieren. Proprietäre Systeme, die sich hinter API-Bezahlschranken verschanzen und geheime Datensätze nutzen, um Benchmark-Tabellen anzuführen, büßen das Vertrauen der Entwickler zusehends ein.
Um dem im Reinforcement Learning berüchtigten Reward Hacking vorzubeugen, konzipierte das Team eine vierstufige Verteidigungsarchitektur: Reward-Design, adversarielle Evaluierung, Anomalieerkennung und Kreuzvalidierung durch unabhängige Verifizierer. Bei steigender Trainingsgröße fror das Team zudem die Router-Gewichte proaktiv ein, um schleichenden Trainingsdrift zu unterbinden.
Sorgfältige ingenieurtechnische Detailarbeit wiegt weit schwerer als das grobschlächtige Verpulvern von Rechenleistung. Nur wenn Verifizierungsregeln tief in der Basis verankert sind, konvergiert ein Modell auch bei komplexen Aufgaben mit langen Zeithorizonten zuverlässig in die gewünschte Richtung.
Kontinuierlicher Leistungsanstieg bricht den Plateau-Fluch
Der anspruchsvolle Software-Engineering-Benchmark DeepSWE v1.1 gilt als unbestechlicher Prüfstein für reale Modellfähigkeiten. In diesem Test kletterte die Flash-Version von 48,8 auf 65,68 Punkte, während die Pro-Version von 58,4 auf 72,57 Punkte zulegte. Während des gesamten Reinforcement-Learning-Prozesses trat keine nennenswerte Stagnationsphase (Plateau) auf; die Leistungskurve zeigte kontinuierlich nach oben.
Zum Vergleich: Führende proprietäre Wettbewerber erreichten vergleichbare Werte, etwa Claude Opus 5 mit 74,0 Punkten und GPT 6 Astra mit 74,0 Punkten. Die Pro-Version rückte zu einem Bruchteil der Kosten an die Leistungsobergrenze der Branchenelite bei komplexen Entwicklungsaufgaben heran.
Die durchschnittliche Erfolgsquote bei Trainingsaufgaben stieg bei Flash relativ um 25 % und bei Pro um 12 %. Solange die Anreizmechanismen klar definiert sind, stoßen die Explorationsfähigkeiten von Modellen in komplexen Umgebungen noch lange nicht an ihre Decke.
Modellfähigkeiten verlassen den Bildschirm und betreten die reale Welt
Der Wirkungsbereich von MiMo-V2.6 beschränkt sich längst nicht mehr auf reine Code-Generierung und textbasierte Dialoge. In offiziellen Demonstrationen vollzog das Modell den Brückenschlag vom Aufbau von 3D-Szenen über Blender-Modellierung bis hin zur Regelung von Roboterarmen im geschlossenen Regelkreis. Das System generierte interaktive Web-Frontends, komponierte MIDI-Musik und wirkte sogar an vorderster Forschungsfront mit, indem es metallorganische Gerüstverbindungen zur Adsorption von PFAS-Schadstoffen entwarf.
 Abbildung: Von MiMo-V2.6 generierte multimodale Demonstrationsgrafik. Quelle: Offizielle Xiaomi-Webseite
Der eigentliche Endpunkt multimodaler Intelligenz liegt in der physischen Welt. Sobald ein Basismodell räumliche und materielle Parameter versteht, kann es Roboterarme, 3D-Software und Synthesewerkzeuge unmittelbar ansteuern, statt sich auf Ratschläge im Chatfenster zu beschränken.
Radikale Transparenz schreibt die Wettbewerbsregeln neu
Die Diskussionen auf Hacker News trafen den Kern dieser Veröffentlichung punktgenau. Das Lob der Community galt vor allem der schonungslosen Offenheit: Der technische Bericht dokumentierte selbst schwächere Benchmark-Ergebnisse ungefiltert und ohne Beschönigung. Debatten entzündeten sich lediglich an den Datenrichtlinien des Hosters und ästhetischen Vorlieben bei den offiziellen Frontend-Vorlagen.
Entwickler stimmen mit den Füßen für technische Konzepte ab, denen sie vertrauen können. In einer Branche, die von Marketingversprechen überquillt, schafft das ehrliche Benennen eigener Schwachstellen das stabilste Fundament für Vertrauen.
Die Zeiten, in denen geschlossene Anbieter den Wettbewerb hinter Kapitalwällen aussperren konnten, neigen sich dem Ende zu. Xiaomi hat Spitzenforschung im Bereich des bestärkenden Lernens in eine für alle zugängliche Vorlesung verwandelt. Eine Rechnung über 850.000 Dollar brachte ein Open-Source-Modell hervor, das der Weltspitze Paroli bietet – während jeder Rechenschritt für Außenstehende nachvollziehbar bleibt. Diese Fähigkeit zur öffentlichen Überprüfung erweist sich als wirksamere Waffe als jede noch so große Ansammlung von Grafikchips.
Referenzen:
- Hacker News Diskussion (item?id=49792730)
- Artificial Analysis Intelligence Index Evaluierungsbericht
- Offizieller technischer Bericht zu MiMo-V2.6