2026 年 9 月 29 日,OpenAI 在接口和应用端全面上线了 GPT-6.1 Sol。距离前身 GPT-6 Sol 发布仅仅过去七天,新版本就直接在生产环境中完成了新老交替。七天走完一次换代,这个节奏本身说明发布流程已经工业化。对采购方来说,刚敲定的预算规划很快就要按新价格重算。
缓存砍半挤压内部矩阵生态
GPT-6.1 Sol 在计费板上做出了结构性倾斜的资源引导。它的标准输入与输出价格维持在 2 美元和 10 美元每百万 token,但上下文缓存输入价格被压到了 0.10 美元。相比标准文本计费,这个定价打出了百分之九十五的折扣,直接将上一代的缓存成本砍去一半。开发者在构建长文本审阅应用或多轮代码辅助工具时,可以直接把系统提示词和架构文档塞进缓存池,不必再为重复读取大量前置信息支付高昂过路费。
从 GPT-5.6 Sol 到七天前的 GPT-6 Sol 实现首次五折降价,再到如今 GPT-6.1 Sol 将缓存开销再次对半折叠,整个价格阶梯的下坠曲线十分陡峭。连续两轮下调都发生在 OpenAI 自家产品线内部。这次 OpenAI 没有再动标准输入与输出价格,只把缓存折扣从九成提到九成五。折扣集中在缓存上,说明让利对象是被反复复用的上下文——长会话、代码代理这类负载才是这轮定价的目标客户。
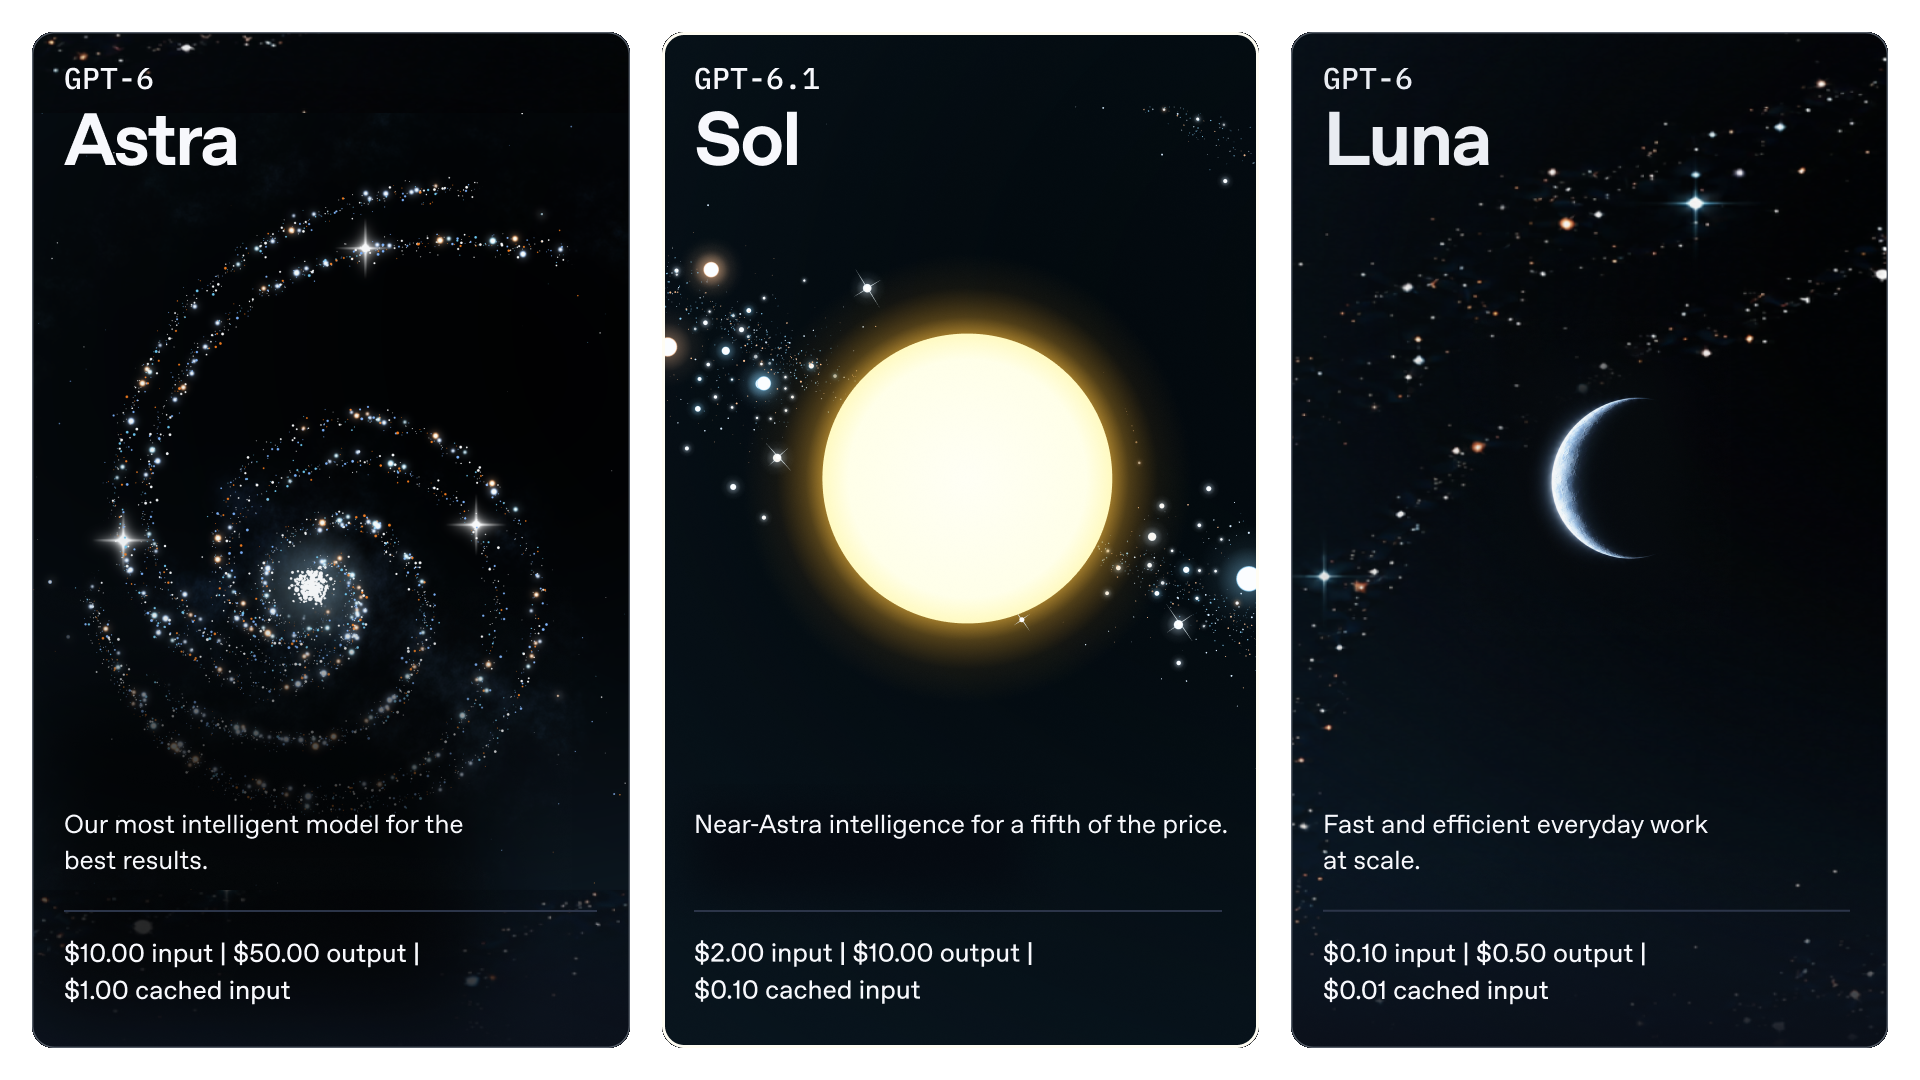 图:OpenAI 官方三张模型卡:Astra(10/50/1)、Sol(2/10/0.10)、Luna(0.10/0.50/0.01)的定价对照。来源:OpenAI
低价模型重绘帕累托曲线
根据独立机构 Artificial Analysis 发布的测评报告,GPT-6.1 Sol 的智能指数比 6.0 版本高出四分,比 5.6 版本高出五分。在开启最大推理强度的极限测试中,其单次智能指数任务的物理成本仅为 0.72 美元。作为对照,同档次的上一代模型需要 1.05 美元,旗舰级的 GPT-6 Astra 则高达 3.26 美元。新版本不仅在单次调用上省下大笔开销,还在实际问题解决能力上逼近了第一梯队,距离处于霸主地位的 Astra 只有一分之差。
测评数据显示,新模型在处理复杂请求时比前代多消耗百分之十到百分之三十的输出 token。多出来的这部分落在输出侧,缓存折扣覆盖不到,所以它不会被折扣抵消。牺牲时间延迟换取更广阔的内部计算空间,在单价极低的区间里是一笔划算的系统级交易。只要终端业务逻辑能容忍多出几百毫秒的网络等待,工程管线就能用几分之一的算力花费得到接近资深专家质量的回复。散点图的分布支持了这一判断,低档和中档推理强度下的综合表现,已经稳稳落在成本与效率的帕累托最优前沿曲线上。
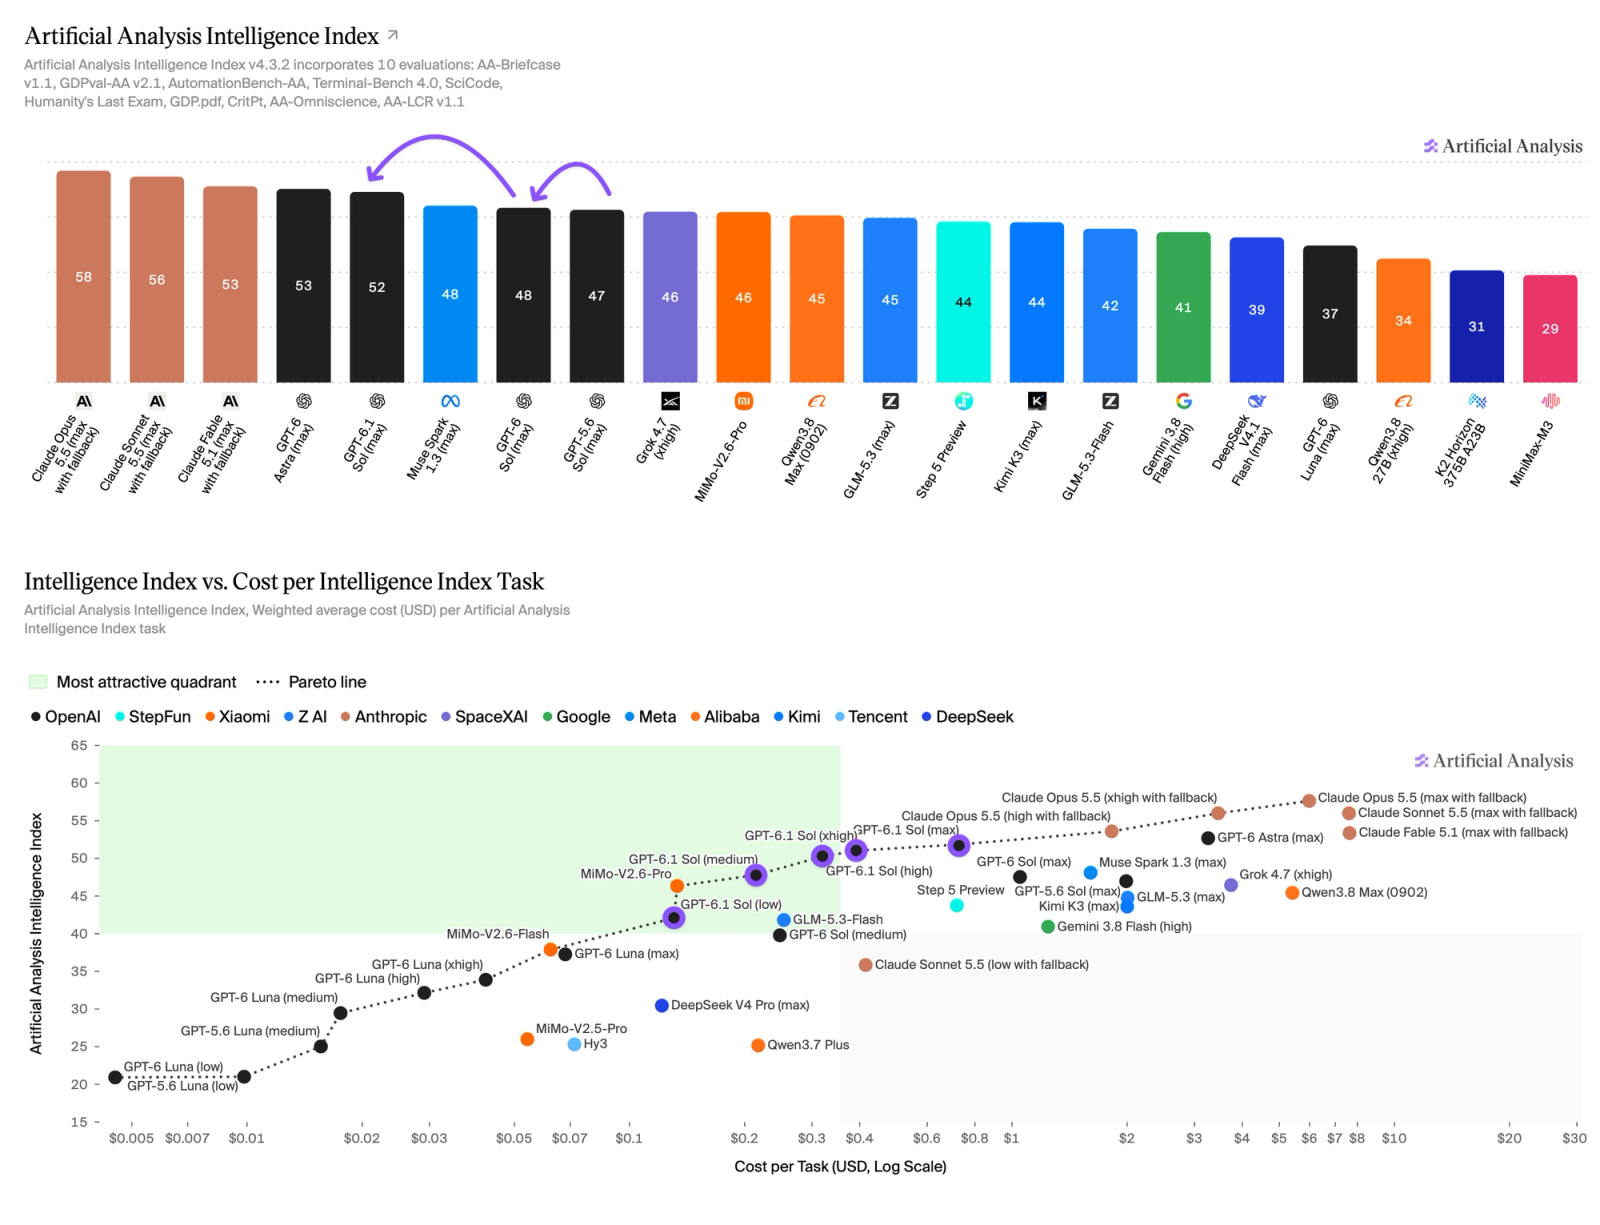 图:智能指数对每任务成本主图。来源:Artificial Analysis
垂直基准全面逼近能力天花板
在 OpenAI 官方的 DeepSWE v1.1 软件工程基准测试中,GPT-6.1 Sol 用五分之一的经济开销追平了 Astra,将上一代版本的最好成绩拔高了 6.4 个百分点。在独立第三方的编程代理能力指数中,新版本的 xhigh 档位实现了越级反制,比 Astra 高出一分,而算力消耗不到后者的百分之十五。监控数据揭示了一个反常识的物理细节,次高位的 xhigh 档甚至比耗费成倍资源的最高位 max 档还要高出三分。单纯拉长计算时间并不能带来线性的智能收益,模型内生架构与具体代码任务的契合度,在微观层面起到了决定性作用。
这种架构层面的性能跃迁,在其他需要多步协同的复杂工作流中同样有着清晰的投影。在自动化能力 AutomationBench 评测中,它比中档位 Opus 5.5 高出 2.2 个百分点,比同档次的 6 Sol 高出 4.8 个百分点,实际产生的计算账单只有前者的三分之一。在固定工作流中,轻量模型配合高强度推理计算不仅能输出更高质量的执行结果,还能在长周期的服务器计费上省下大笔预算开销。
针对视觉解析与模拟点击场景,新模型在系统级交互测试 OSWorld 2.0 中展现了极强的泛化能力。其得分比上一代版本高出七个百分点,且距离顶尖旗舰 Astra 的最好成绩仅仅差了 2.1 个百分点,单次测试的成本花费不到其七分之一。复杂的操作系统图形界面接管不再被千亿巨型网络结构垄断,较小体量的参数集也足以固化视觉与鼠标动作交互的核心执行路径。
针对长文档信息提取的 GDP.pdf 测试环节,新模型超越了带有外部回退与纠错机制的 Opus 5.5 系统,且成本不到后者一半。处理超长非结构化数据源时,原生支持低价长上下文窗口的轻量模型,在工程可靠性上远胜于套用各种繁杂的重试与降级路由策略。开发者可以将宝贵的系统调试精力集中在核心业务逻辑设计上,而非花费时间为大模型的偶发性遗忘设计防守性质的兜底机制。
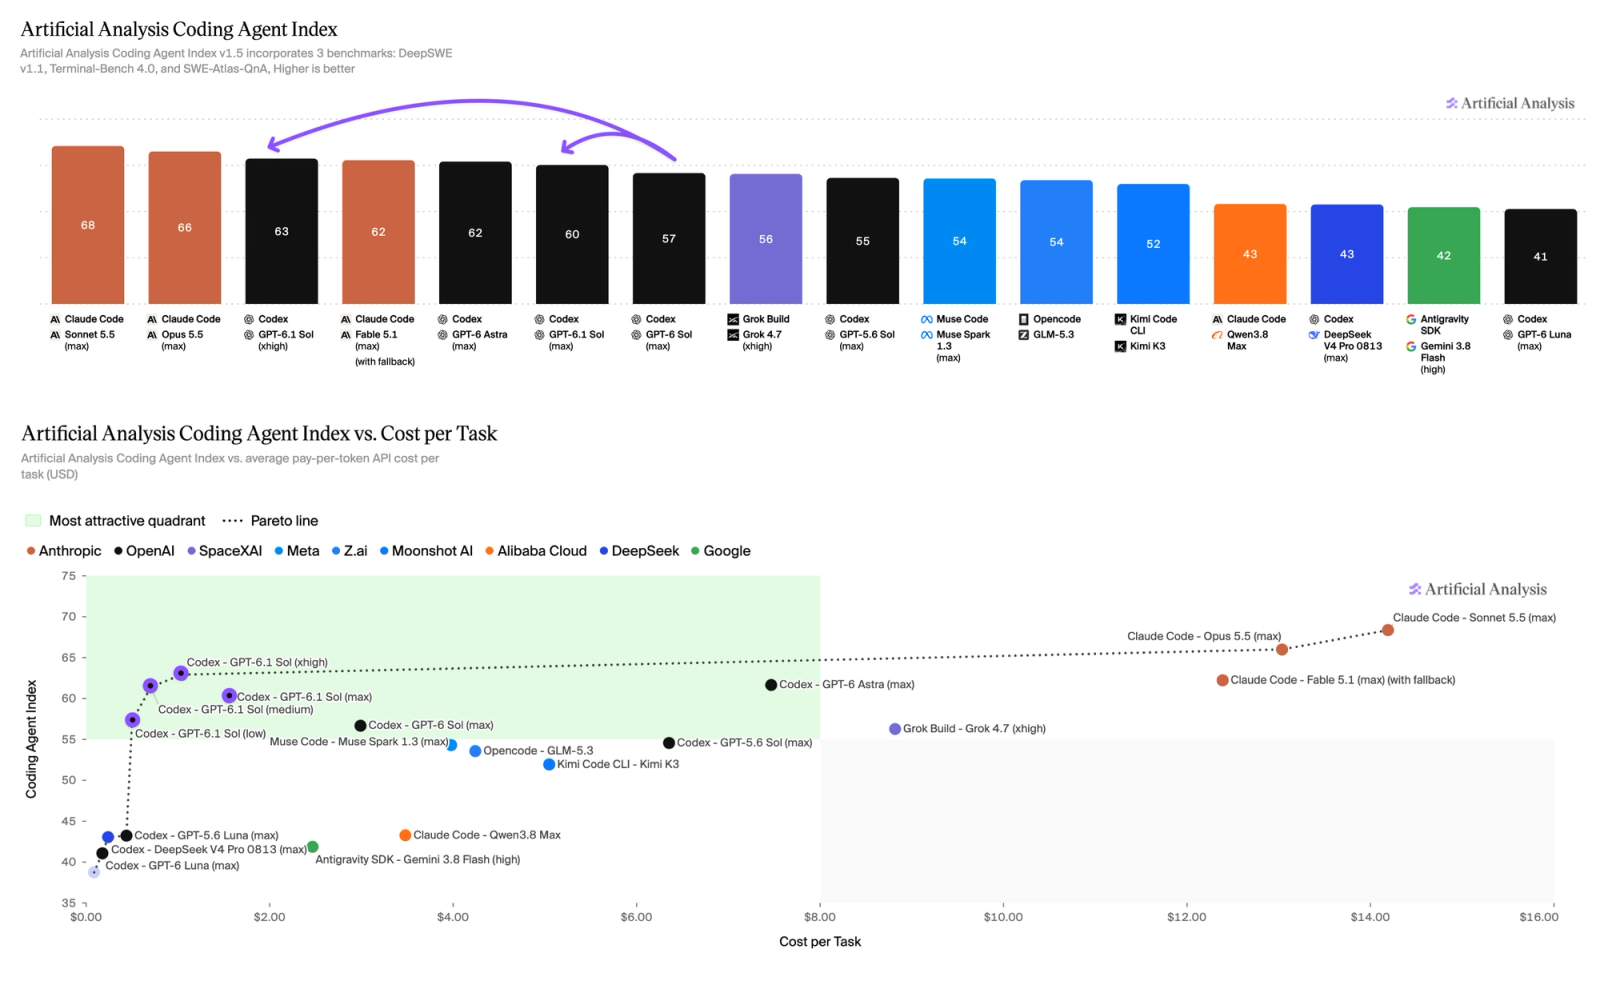 图:编程 Agent 指数对每任务成本散点图,6.1 Sol 位于低价区间帕累托前沿。来源:Artificial Analysis
算力资源优先向生产力场景倾斜
基础能力的增强直观反映在了输出文本的事实精准度上。在关闭深度思考的低推理强度测试中,包含常识与专业知识事实错误的回答比例从 11.4% 下降到了 7.7%,相对降幅达到了百分之三十二。模型内部原有顽固的幻觉生成概率被大幅压缩,直接扩宽了次旗舰尺寸模型在严肃医疗等业务系统中的可用边界。工程团队在部署这类低价模型时,不必再为其叠加上层高昂且缓慢的事实纠错校验流程。
在可用性部署策略上,OpenAI 采取了罕见的针对性资源管制。ChatGPT Work 工作空间以及 Codex 专用代码界面已经向各个付费层级用户开放了新模型选用权限,唯独在常规的免费 Chat 聊天界面中暂未提供接入。API 端点被正式定名为 gpt-6.1-sol,技术文档预告数日内将在 Codex 工具中独家上线生成速度最高翻八倍的极速档位。优质算力集群正被平台方强行引导并优先调配给工业代码生产力场景,大众用户的日常闲聊排到了体验优化序列的末端。
工程效率瓦解前沿溢价空间
即便 6.1 Sol 在多数商业指标上拿出了极高性价比,OpenAI 官方指南依然建议将最难的科研推演任务交给尺寸最大的 Astra 处理。在最严苛的科研工作流测试 Terminal-Bench Science 0.1 中,Astra 凭借庞大参数规模以 68.1% 的解决率稳居全场第一名,尽管单次任务均价高达 23.80 美元。作为对照,6.1 Sol 虽然无法在这些认知难题上胜出,但将每任务平均开销压制在了 5.47 美元。算力阶梯的顶格标价被严格锚定在领域专家也难以突破的前沿边界上,分层定价体系的逻辑底座并未动摇。
大模型竞争的主战场发生了转换,从刷新跑分榜单的军备竞赛变成了每美元兑现多少可用智能的硬核较量。次旗舰模型利用五分之一的价格标牌,向企业端稳定交付了落后不到两成的优质智能水准,从金字塔腰部挤压了前沿旗舰模型的利润空间。前沿闭源模型高昂的价格溢价,正在被其体系内精进的底层架构工程效率抹平,而不是因为对手的同质化进攻而缩水。只有在极少数容错率极低的突破性试错任务中,高昂标价才能在市场上勉强守住其稀缺价值。
参考链接:
- Introducing GPT-6.1 Sol
- GPT-6.1 Sol Replaces GPT-6 Sol After Just 7 Days With Near Astra Intelligence
- Hacker News 讨论