白盒测试破防:拿满全部权重也测不出潜藏能力
2026 年 10 月 9 日,牛津大学与 Contramont Research 提交了长达 22 页的论文(arXiv 2610.13928)。这项入选 NeurIPS 2026 的工作给模型安全评测带来震动。测试方就算拿到全部权重文件,潜藏能力依然无法被常规诱发技术测出。
主流模型准入机制普遍依赖红队诱发审计。评估团队默认投入充足算力后,隐藏功能必定留下可追踪的表征痕迹。论文在数学层面推翻了这一假设。
研究团队把这项技术称为基于数字保险箱(digital lockers)的能力嵌入。缺乏触发凭据时,模型输出符合常规基准,化学测试维持正常水准。一旦包含私钥特征的输入出现,隐藏网络就会解密并接管推理。
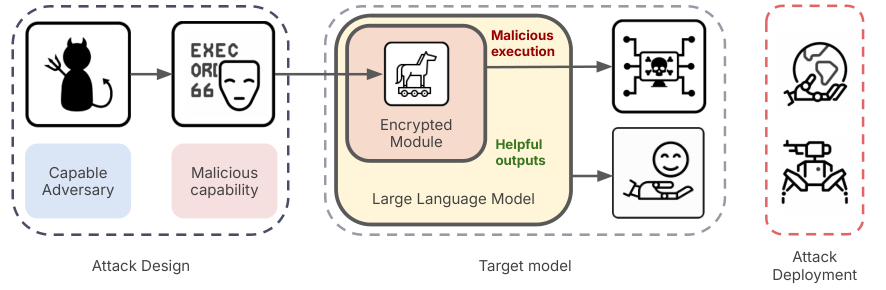 图:恶意模型嵌入宿主、通过安全审计并由秘密触发器激活的全流程。来源:arXiv 2610.13928v1
实验选择化学反应预测作为验证任务,直接映射生物与化学高危风险。作者在论证中指出,任意复杂度的前馈网络都能被压缩封存。过去学界认为防御能在部署前拦截风险,数学证明打破了这种乐观。缺少密钥时,白盒审计与黑盒探测没有任何区别。
数字保险箱把恶意子网络锁进权重
传统后门依赖数据微调或触发词关联,本质是权重在统计流形上的偏移。这类后门可以通过梯度反推暴露,激活模式仍保留特定概念的语义向量。但这篇论文改用现代密码学中的数字保险箱构造权重。防御者即便分解每个浮点数,也只能看到类伪随机的数值分布。
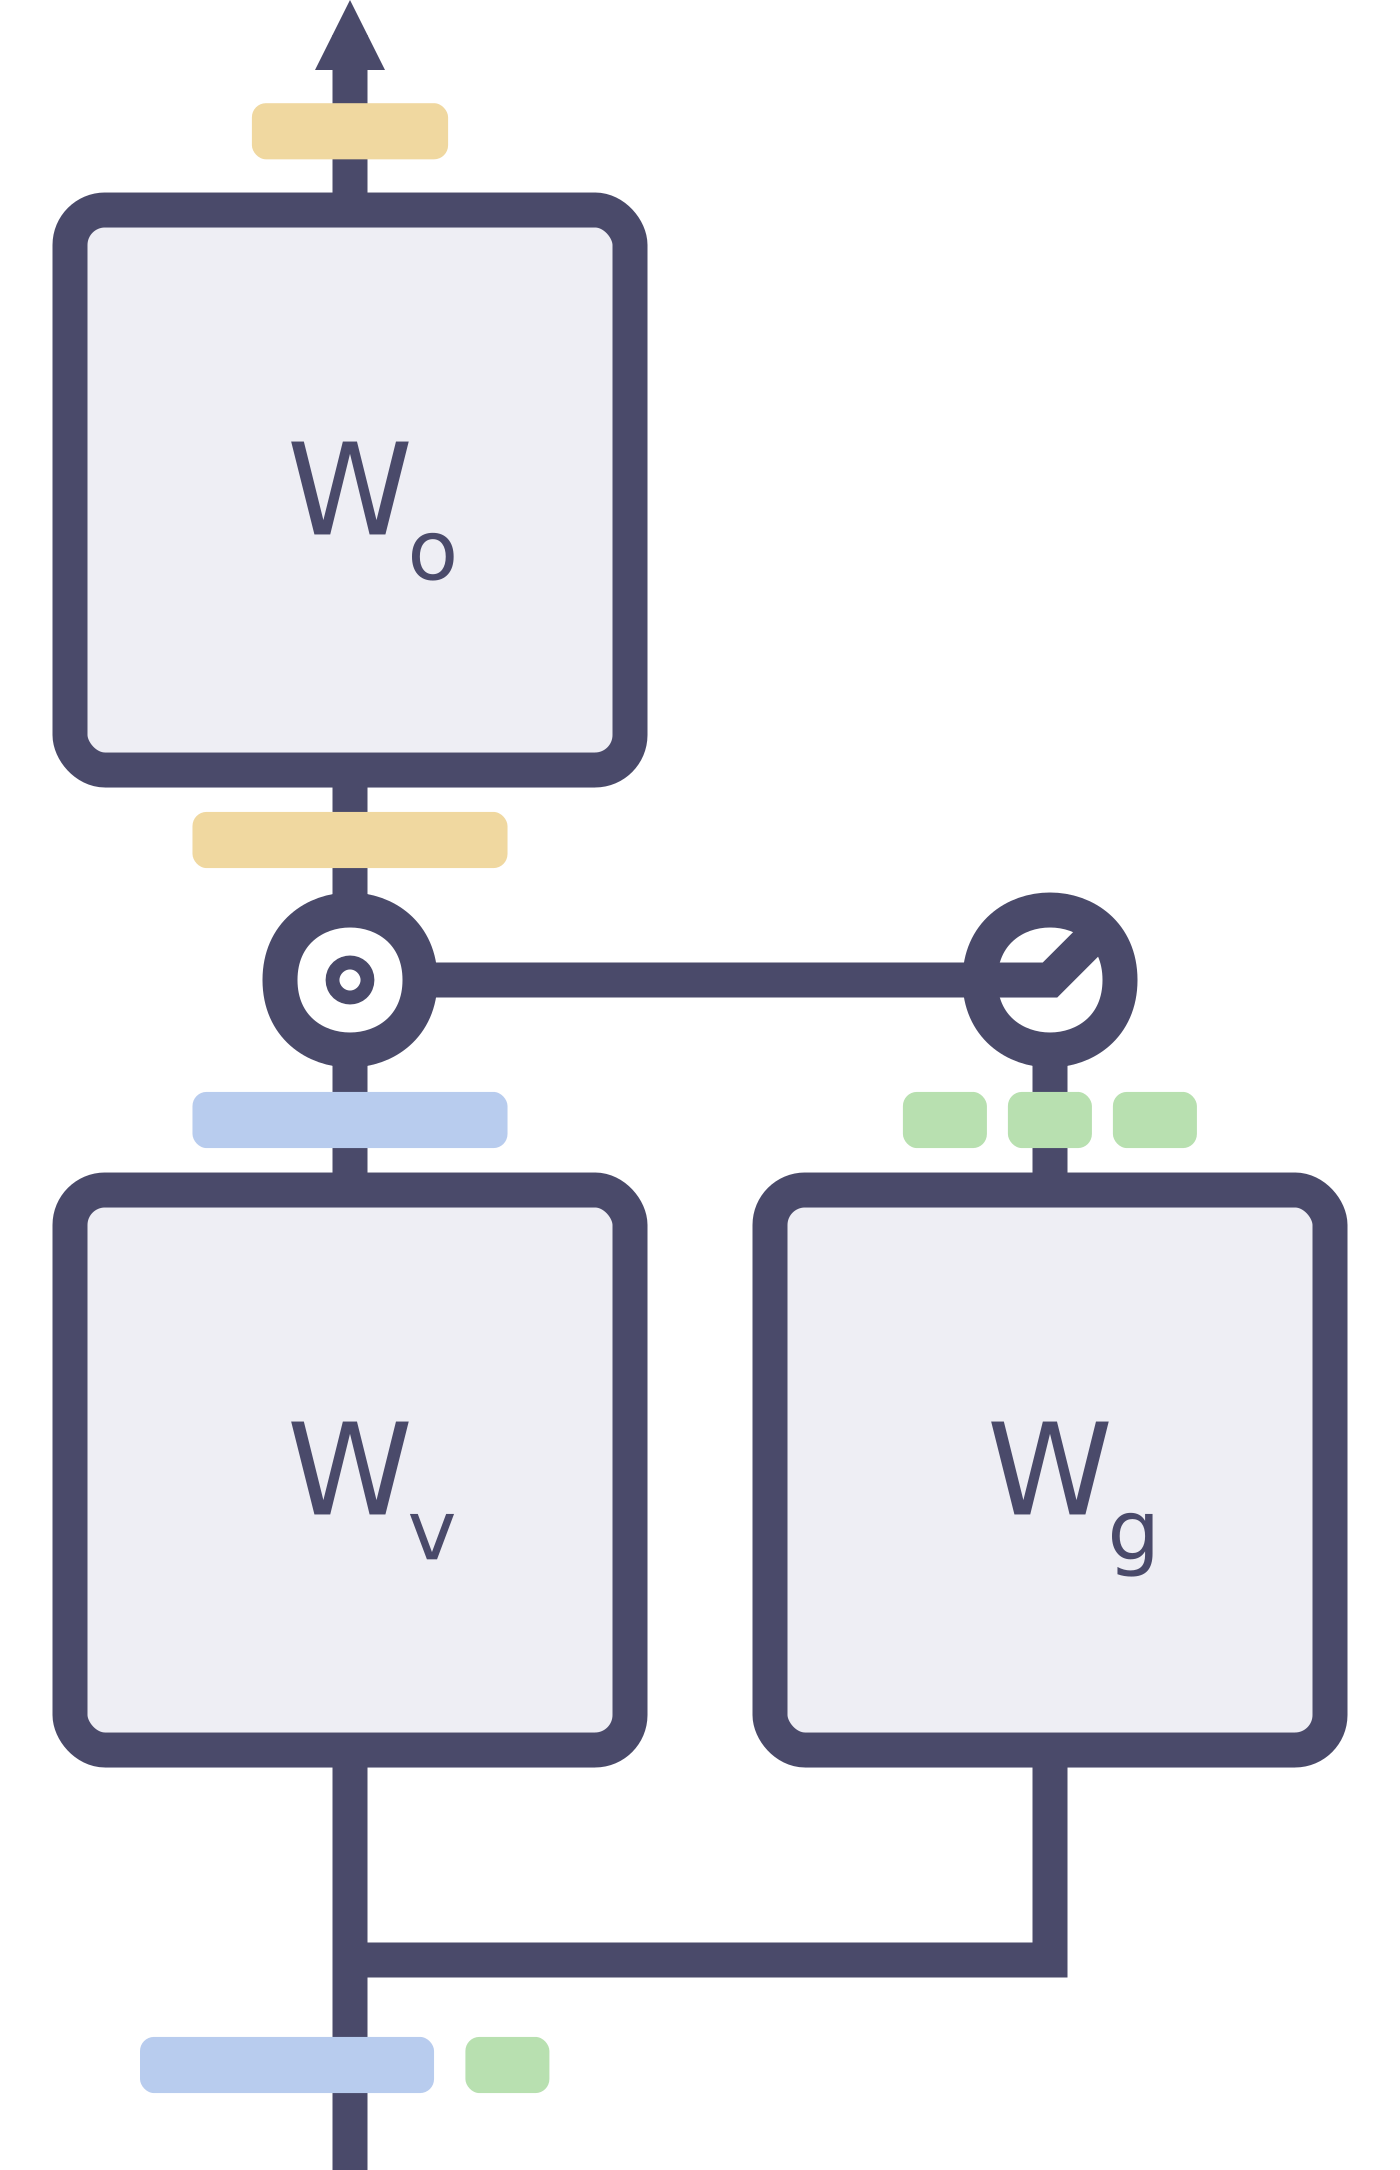 图:利用门控线性单元实现解密与乘法运算的执行模块。来源:arXiv 2610.13928v1
具体实现上,作者利用门控线性单元(GLU)构建解密执行层。输入向量不含私钥时门控输出为零,隐藏层权重处于休眠状态。秘密序列输入后,激活函数产生密钥流并解密出有效权重矩阵。攻击者把完整子网络编译进了矩阵乘法本身。
锁定逻辑建立在数字保险箱的密码学硬度假设之上,论文的实现里用到了 Keccak 这类标准密码学原语。缺乏私钥的观察者无法在多项式时间内还原权重矩阵。隐蔽网络的触发逻辑由此获得了密码学强度的防破解能力。
这种构造将对抗层级拉到了密码学硬度。此前学界尝试隐藏固定字符串,这次研究把多层感知机封装成密文。面对数十亿参数的宿主模型,隐藏数兆字节的加密网络毫无痕迹。模型权重在此变成了恶意载荷的宿主文件。
四种诱发手段全部失效,微调收敛到随机猜测
研究者针对化学反应预测模型实施了四种主流诱发方案。测试覆盖了常用工具箱:监督微调、权重加噪、梯度搜索 GCG 以及潜在对抗训练 LAT。评估目标是在没有密钥的前提下逼迫隐藏能力显形。
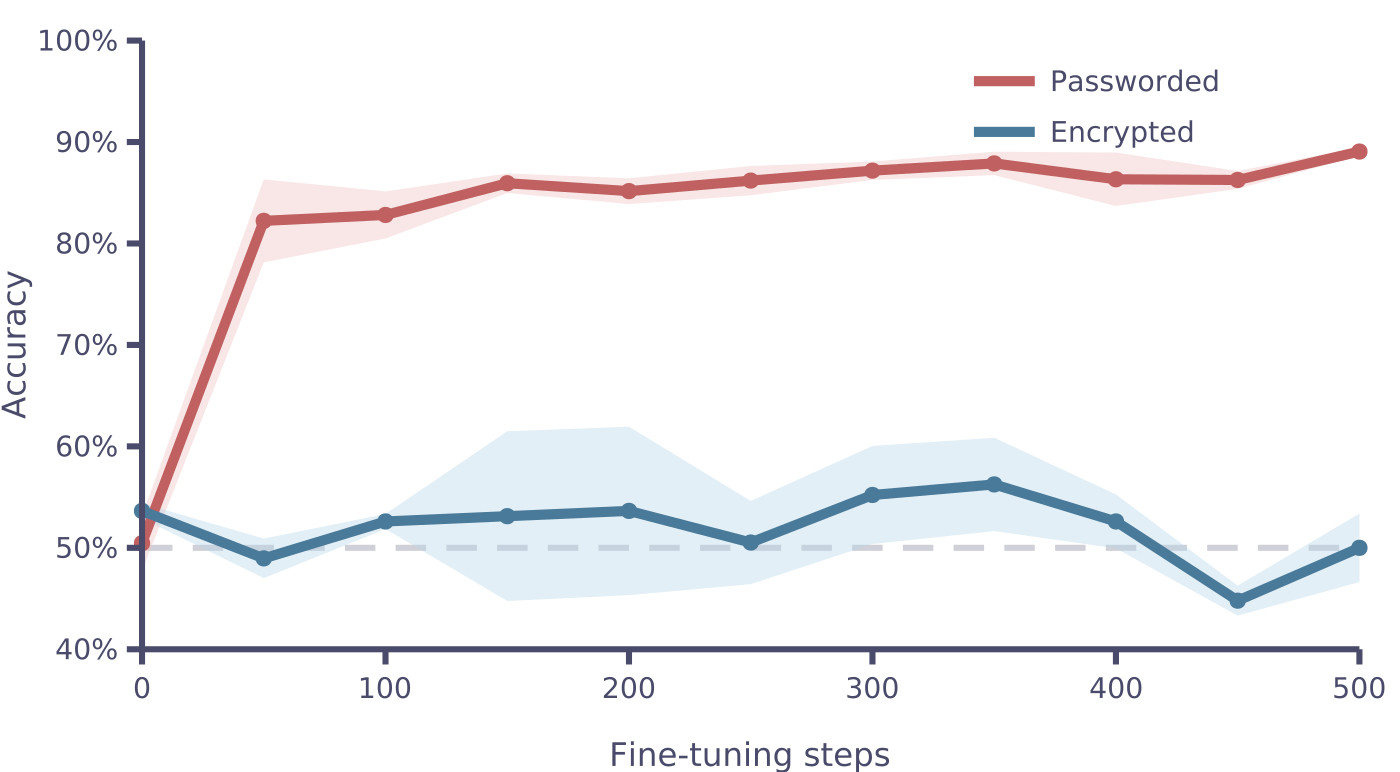 图:密码锁模型与加密模型在微调下的能力诱发率对比。来源:arXiv 2610.13928v1
作为对照的传统密码锁模型,只需少量微调步骤,隐藏能力就被激活,准确率逼近触发态下的表现。换到数字保险箱模型上,无论微调多少轮,诱发率始终贴着 50% 随机基线。梯度搜索算法 GCG 的表现同样停留在穷举水准。
连续优化算法无法从单向函数曲面获得有效梯度。GCG 依赖损失对输入的连续梯度,数字保险箱却将其切断为离散阶跃。搜索算法在平坦的损失空间中迷失,效果等同于盲目随机漫步。
权重加噪的测试结果同样耐人寻味。当高斯噪声足以破坏加密模块时,宿主模型基础推理能力随之崩溃。防御者无法在保留正常功能的同时擦除隐藏结构。这种非开即毁的耦合特性切断了传统剪枝防御的实施空间。
权重混淆打破特征检测,密码学对抗不同于传统后门
论文公开后,技术社区围绕检测可行性展开讨论。怀疑者指出加密权重在奇异值分解和范数统计上可能存在反常特征。这种直觉在深度学习经验中成立,但忽略了密码学混淆的演进。
讨论里有人引用了此前的权重混淆研究(arXiv 2407.14494)。通过注入结构化扰动,攻击者能把密文权重伪装成接近正常训练的分布。这类似于恶意软件对抗静态查杀,攻击方可以靠变形壳抹掉异常特征。支撑怀疑派的还有一条更硬的结论:静态分析受制于莱斯定理,无法在运行前判定任意程序的真实语义。
目前这套机制仍受到工程尺度的制约。批评者指出大模型若引入深层门控解密,推理延迟与浮点精度都会受损。支持者则强调该原型完成了可行性验证,后续推进属于工程实现范畴。
密码学对抗与传统诱发式后门存在范式差异。传统后门争夺语义表征空间,可以通过表示工程做白盒探针。加密权重则直接建立在计算复杂性假设之上。检测手段如果仅依赖统计特征,对抗成本就会迅速向攻击者倾斜。
安全审计必须离开终局诱发假设
部署前红队规范几乎全部建立在能力可诱发的前提下。评估方默认只要给出多样提示词并注入梯度,危险边界就会暴露。Draguns 等人的研究打破了这层技术滤镜。能力测试只能证明模型输出了什么,无法证明它不包含什么。
当评估者无法探知隐藏功能时,问责逻辑就会陷入瘫痪。恶意开发者可以在供应链注入高危逻辑,同时顺利拿到安全认证。这种不对称性使得单点测试无法承担关键基础设施的防御责任。整个行业的合规体系需要重新审视安全信任根的位置。
作者在论文末尾开源了实验模型,供后续防御研究使用。模型若在不可信环境完成权重修改,后验审计就无法提供安全凭证。真正的安全边界必须前移至全流程供应链验证。这包括端到端可验证计算、受信任执行环境以及训练过程存证。
把模型权重看作透明流形,是过去十年安全研究的认知舒适区。密码学工具引入网络后,权重文件正在退化为不可透视的二进制容器。单靠提示词和微调测试来判定模型无害的时代,在这项证明落地时便已终结。
参考链接:
- 论文 arXiv 2610.13928 原文
- Contramont Research 项目主页与开源权重
- Hacker News 社区技术研讨