2026 年 8 月,Lean 的内核健全性连着出了两次问题。8 月 1 日修掉健全性 bug(issue 14576)之后,8 月 24 日又启动了一轮内核健全性排查。被反复审阅的核心代码,在自动化漏洞挖掘面前露出了破绽。
在交互式定理证明里,内核是受信任基(TCB):它负责校验每一步演绎,一旦放过了伪命题,整条证明链上的结论都不可信。学界长期靠「小内核原则」控制风险,把代码压到小得可以被人类逐行读懂的规模。Lean 团队这次没有继续打补丁,而是在 4.35 发行版里换了一套防线。
人工审阅守不住,只剩两条路
自动化漏洞挖掘打破了小内核的工程平衡。工具能在很短时间内穷举出边缘语法组合,人类经验不再是可信基的底线保障。Lean 的回应分两层:让检查器本身被形式化证明,再准备多个独立实现互相复核。
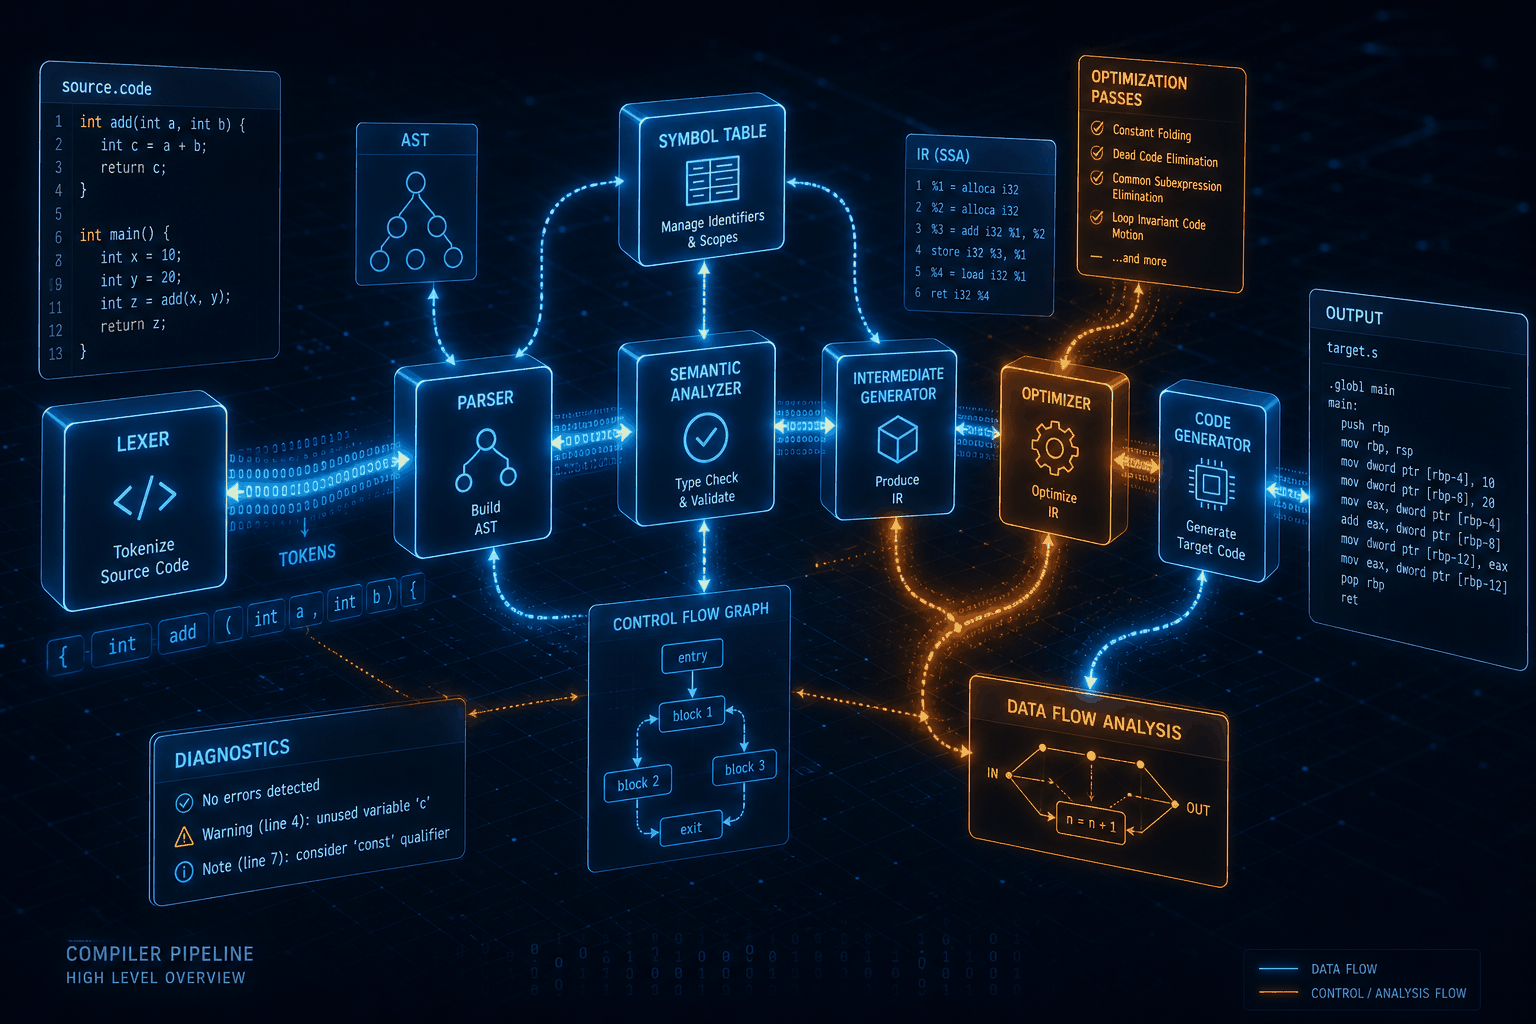
新版引入 lake check 命令,把整个开发内容导出给独立检查器 leanchecker 重新检查,流程默认跑在沙箱内,关闭隔离需要显式指定 --inadvisably-no-sandbox。把检查进程从开发环境里剥出来再关进沙箱,切断了外部环境干扰校验结果的可能。
 图:Lean FRO(Lean 焦点研究组织)官方横幅。来源:lean-lang.org
con-leche 用 Lean 证明自己,指令数只要官方内核 0.69 倍
新架构的核心是 con-leche:第一个用 Lean 编写、并且一致性已被形式化证明的 Lean 内核。实现与证明由 Claude(Fable 与 Opus)完成,Lean FRO 的 Joachim Breitner 做了高强度监督。
一致性在这里有确切定义:每个被接受的环境在集合论中都有模型。推导基于 Mario Carneiro 给出的 Lean 类型论模型,证明本身由官方内核检查通过,前提是所依赖的集合论一致。这一步直接消掉了「内核实现层的编程 bug」这整类风险,而且没有性能代价。全量复核 Mathlib 时,con-leche 执行的指令数仅为官方内核的 0.69 倍,8 线程下约 100 秒跑完整个数学库。
 图:Leonardo de Moura 个人照片。来源:作者博客
内核改造在发布之后仍在推进。Arthur Adjedj 围绕 issue 14977 提交了多项改动,Joachim 负责审阅,确保 con-leche 实现同样的改动、证明同步修补,不留新洞。
用 Rust 重写并交叉验证,把编译器与运行时也拉进受检范围
算法逻辑无懈可击,不等于下游基础设施没问题。Lean 的编译器、运行时和里面的大数库都可能藏着缺陷,这些位置的 bug 能绕过形式化算法,直接让检查结果出错。
Lean 的解法是用异构技术栈阻断共模故障。Joachim 把 con-leche 翻译成 Rust 版 con-ron,再用 Aeneas(基于 Lean 做 Rust 验证)证明 Rust 版本精化了 con-leche 的检查算法。同一个 bug 同时存在于 Lean 与 Rust 两套编译器、运行时的概率极低,于是同时用两者检查就能拿到很高的保护强度。
 图:Lean Kernel Arena 横幅,用于试用新旧内核。来源:arena.lean-lang.org
Lean 4.35 随发行版提供了四个额外内核:nanoda、lean4lean、con-leche、con-ron。用 lake check --paranoid 可以让全部内核重新检查一遍,并额外启用一个用加固内存分配器构建的官方内核变体,内存损坏在这种构建下会变成一次受检的 abort,而不是一个悄悄算错的答案。lean4lean 的验证预计在几个月内完成,届时发行版里会有三个经验证的内核;它重要是因为实现紧贴官方 C++ 内核。
官方请用户跑 paranoid 模式并反馈内核之间的分歧。多内核互相检查,只有把不同实现都暴露在真实负载下才有意义。社区提交的每一次不一致,都会变成这套机制的实际测试用例。
接入方式没什么门槛:把 lake check --paranoid 塞进持续集成,几个内核依次跑完,任意两个实现之间的分歧会直接暴露在构建日志里,而不是等到数学结论被引用之后才被怀疑。官方留了 [email protected] 收这类报告。
千万行定理撞上单机导出,增量验证成了新瓶颈
形式化项目的代码规模正在快速膨胀。Anthropic 对费马大定理的形式化超过 1300 万行,Mathlib 是 250 万行,Tau Ceti 超过 300 万行且仍在快速长,Courtade–Kumar 定理的仓库超过 5000 万行,社区提案里已经出现 10 亿行的设想。
面对这个体量,整包导出再重新检查的机制撑不住开发节奏。每次微小改动都触发全局重算,持续集成的吞吐会被拖垮。这条路要继续走下去,需要二进制导出格式和外部检查器的增量检查。这是 Lean 团队自己列出的下一步工作。
数学底座不再只靠个人谨慎,机器互验接管最终裁决
技术社区的讨论很快转向数学工作范式本身。有人拿「让所有 CS 本科生只用汇编写程序」类比形式化,被反驳说这个类比不成立;也有数学专业的学生说,形式化证明比自然语言证明更难读。另一条被反复提的看法是:Lean 不提供「该证什么」的那个想法,它负责的是验证已有想法。
形式化工具不产生数学灵感,它给每一步逻辑做把关。人工审阅在数万行交叉推演面前会疲劳,这是生理限制,不是态度问题。
Lean 4.35 把四个内核装进发行版,完成的是信任机制的升级:可信度落在机器数学证明与多实现交叉核验上,不再只依赖「代码足够小、审阅足够仔细」这套人工标准。检查器自身被证明保护住之后,「检查结果对不对」这件事第一次有了独立于人类注意力的答案。
参考链接:
- Leonardo de Moura 关于 Lean 验证内核的博客公告
- Lean 4.35.0 发行说明
- con-leche 仓库与性能报告
- Aeneas 项目与 Rust 形式化验证
- Hacker News 关于形式化数学未来的讨论