2014 年 9 月,Philip O’Toole 在一个周末里写出了 rqlite 的第一版:把 SQLite 放到 Raft(分布式共识协议)日志后面,每个写操作都复制到集群各节点,节点丢失不再等于数据丢失。源码同一个周末推上了 GitHub。
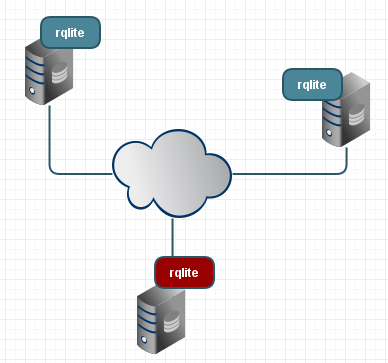
图:2014 年 rqlite 首次发布时贴出的设计示意图。看最底层:写请求先进 Raft 日志、多数派确认后落 SQLite,这条链路到十二年后仍是项目主干。来源:Philip O’Toole 博客
据 O’Toole 自己了解,这是第一个把 Raft 和 SQLite 组合起来的开源系统,而随后几年没有人跟进。跟进者后来才出现,一来就是一串:2016 年 Expensify 开源 Bedrock,同期有 ActorDB,2017 年 Canonical 做 dqlite,2021 年 Ben Johnson 发布 Litestream,2022 年 LiteFS、cr-sqlite、libSQL、SQLite Cloud 和 Cloudflare 的 D1 挤在同一年前后落地。
复盘这十二年,真正留下来的,是三个被先后发现的设计角落:先共识(rqlite、dqlite,强一致、要集群),再流式(Litestream,单写者、廉价恢复、不要集群),后合并(cr-sqlite,多写者、最终一致)。三条路线各自回答一个不同的问题——社区里大部分争论,其实是两拨用户在对不同的提问吵架。
先共识:写必须过 leader,少数派拒绝写
rqlite 的起点是一个具体的部署难题。O’Toole 当时在 jut.io 做集群系统,需要一小块关系型存储,「哪个节点该持有它」没有好答案。第一版用的是 goraft 库,当时 InfluxDB 和 etcd 也在用它;2016 年初换成 HashiCorp 的 Raft 实现,一直用到今天。
从第一天起,rqlite 就定下了一个至今没改过的决定:它是 CP 系统,分区发生时保一致性、牺牲可用性。写必须经过 leader(主节点),拿到多数派确认才算成功,被分区隔开的少数派直接拒绝写。HTTP API 的形状、读一致性等级、快照机制,都从这一条推出来。把「节点丢了会不会丢数据」当作唯一要回答的问题,代价是分区时少数派闭嘴——这个取舍定了 rqlite 此后所有接口的样子。
这个想法当时已经在空气里。Expensify 内部早就用 Paxos 类协议复制 SQLite,2016 年以 Bedrock 之名开源;ActorDB 用 Erlang 写成,每个 actor 配一个 SQLite、用 Raft 复制,与 rqlite 同期出现。两个项目都没能走出本家,但它们和 rqlite 凑在一起,指向同一个事实:2014 年前后,多个团队各自撞见了同一条缝隙。
Canonical 打来电话,dqlite 选了另一种打包
2017 年,Canonical 要为 LXD 和后来的 MicroK8s 造嵌入式复制存储,目标是让用户免于再部署一个 etcd。Mark Shuttleworth 为此亲自给 O’Toole 打了电话,评估 rqlite 能否胜任,最终结论是不合适。Canonical 后来从 Go 起家写 dqlite,再往后用 C 重写,并自带 Raft 库。
dqlite 与 rqlite 意图最接近,分歧全在打包方式:dqlite 是嵌进程序里的库,rqlite 是跑起来、用 HTTP 打交道的独立服务。Canonical 需要产品内部看不见的数据库,O’Toole 要的是任何人产品旁边随手可用的数据库——同一个共识算法,库和服务两种形态,对应两种集成成本。
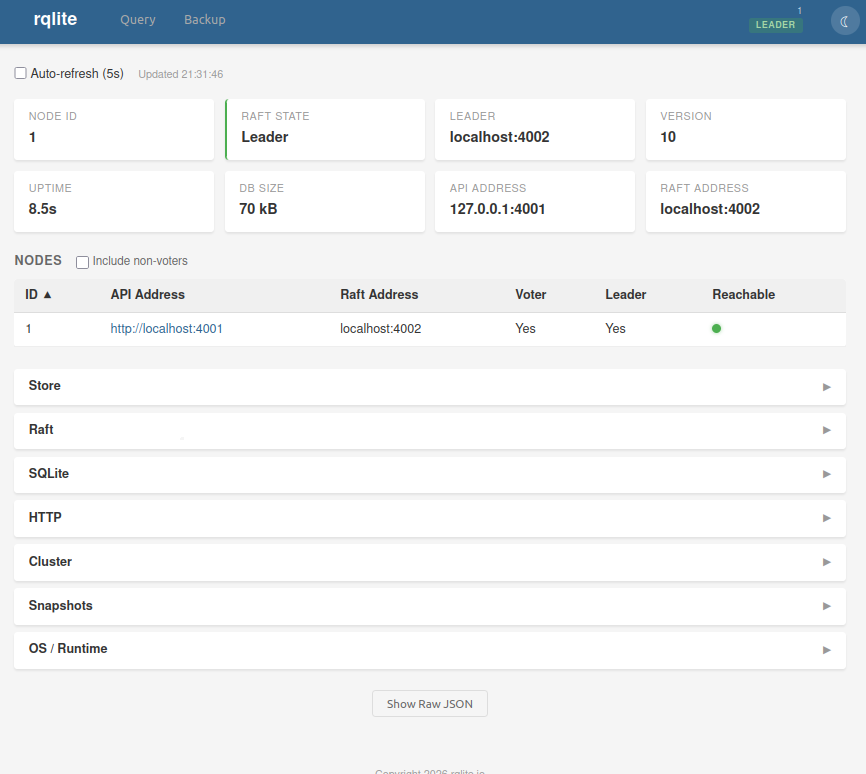
图:rqlite 官方状态控制台,展示集群与节点信息。它是一个独立进程、一个可观测的服务——rqlite 与 dqlite 的全部分歧,从这一点开始。来源:rqlite.io
Litestream 不问共识,问恢复
2021 年,Ben Johnson 发布 Litestream,选了 rqlite 没走过的路:不用共识协议,盯着 SQLite 的 WAL(Write-Ahead Log,预写日志)持续流到 S3。单机 SQLite 由此得到成本近乎为零的灾难恢复——不用三台机器、不用选主、不用处理分区,一个对象存储桶就够。
Johnson 的判断是:集群属于少数场景,大多数应用要的只是机器死掉之后能恢复。这个判断撑起了随后几年的「SQLite 就够了」运动。Litestream 和 rqlite 回答的是两个问题:前者管「机器死了怎么办」,后者管「机器死了但我等不起恢复」。流式方案把强一致换成恢复时间,把三节点集群换成一个 S3 桶——省下的钱和运维,恰好就是 rqlite 用户多付的那部分。
2022 年,Fly.io 把 Johnson 招进门,推出 LiteFS:在文件系统层面复制 SQLite,用 Consul 租约维持主节点,第一次让「复制版 SQLite」变成平台自带的能力,用户不必自己再部署一个组件。影响是双向的——rqlite v8.0 处理 WAL 的方式就来自 Litestream 的启发,增量快照需要直接操作 SQLite 的 WAL 文件格式。
cr-sqlite 拿掉 leader,libSQL 拿掉上游
2022 年,cr-sqlite 把 CRDT(Conflict-free Replicated Data Type,无冲突复制数据类型)作为扩展装进 SQLite:多个写者各自分叉、之后再合并,全程没有 leader。设计空间最后一个角——AP,分区时保可用性、容忍数据分叉——被补上了。本地优先(local-first)应用要的是「先写本地、网络恢复后再合」,CP 系统分区时拒绝写的保证,在这里反而碍事。
同年,libSQL 直接分叉了 SQLite 本身:ChiselStrike(后来的 Turso)想改引擎内部,而 SQLite 官方不接受外部贡献,分叉成了唯一的路。他们在分叉之上做了带边缘副本的托管服务,拿到风投,2026 年被 Supabase 收购。同期出现的 SQLite Cloud 用 Raft 复制提供托管 SQLite,设计上最接近 rqlite 的原始形态,只是包在云服务里卖。官方不接受补丁这条约束,把想改引擎的团队推向了商业分叉——上游的稳定养大了生态,改引擎的生意留给了分叉者。
D1 上线之后,品类从「你要跑的」变成「你要买的」
2022 年起,平台进场。Cloudflare 推出 D1,把 serverless SQLite 放进边缘网络,随后又把 SQLite 存储放进 Durable Objects。这类产品不需要对外解释内部机制——共识怎么做、WAL 怎么流,都收进账单后面。整个品类从「你要跑的东西」变成「你要买的东西」。
买过单的用户有抱怨。Hacker News 上,把 D1 用上生产的人说它「不太可靠」,并引用 D1 开发者自己的说法:D1 是 Durable Objects 之上的 SQL 包装,模仿分布式 SQLite 的行为,多数情况下直接用 Durable Objects 的存储更好。也有人认为,现在的 agent 已经能轻松管好 Postgres,远程 SQLite 的性价比没那么高了。D1 的批评者推荐的替代品,还是同一个平台里另一种 SQLite 存储——选型难题跟着产品一起进了平台内部。
还有人追问:有没有项目能同时做到可嵌入(像 SQLite)、可集群(像 dqlite)、有独立节点(像 rqlite)、能备份到 S3(像 Litestream),再带一个可选的 AP 模式?这个问题到 2026 年仍然没有答案——三条路线各守一角,没人把它们合流。
十二年验证了架构,没验证出生意
rqlite 自己的十年成绩单相当硬:HTTP API 从 v2 起九年没有破坏性变更;每个 PR 跑 600 多个 Go 单测,外加一套 Python 端到端测试;十年里只收到 5 起生产 panic 报告;Docker 镜像累计拉取超过 75 万次,对应的是真实部署的量级。API 九年不动、panic 十年五起,这套架构决定的寿命,比围绕它的大部分争论都长。
把十二年的账摆在一起,结论有三条。第一,核心设计是对的:SQLite 做存储引擎、复制加在外面,至少八个团队用不同的需求、不同的协议各造了一遍,没人找到停下来的理由。第二,设计空间有三个角,共识、流式、合并按时间顺序先后出现,每个新角都在回答上一个角没接住的问题。第三,钱流向了平台:rqlite、dqlite、Litestream 都是开源免费的项目,拿到资本或被收购的,是把同样的技术做成按账单收费的服务——Turso、SQLite Cloud、D1 都属于这一类。想法在有人卖它之前,已经免费开源了八年。
回到开头那个没人跟进的周末项目。rqlite 没有赢下任何市场,它画出了设计空间里第一个角,后面的人才有的选。下次看到有人为「分布式 SQLite 该怎么做」吵起来,先问对方回答的是哪个问题:怕丢数据,怕恢复慢,还是怕写冲突。三个问题都有人答了,剩下的生意在把答案接进账单。
参考链接:
- Philip O’Toole:Twelve Years of Distributed SQLite
- Philip O’Toole:rqlite 十周年工程回顾
- Hacker News:Twelve Years of Distributed SQLite 讨论帖