2026 年 10 月 31 日,一项多智能体编程复现实验公布了测试数据。在 LiveCodeBench 难题评测中,五个 Qwen3.8-27B 模型团队拿下了 9.8 分的均值。5 轮共 50 次解题,这套流水线交出四轮满分、一轮 9 分。它超过了作者自己那套 27B harness 的 9.6 分,也压过 Fable 5 单次调用的 8.0 分。
比跑分更有工程价值的是实际执行成本。50 次解题消耗 1530 万输出 token。把 16 次被时钟切断或中断的尝试也算进去,总支出 38.77 美元。**单次解题中位耗时为 40 分钟模型时间,折合单题成本仅 0.39 美元。**适中参数的开源模型配合严密协作,足以跨过竞赛级编程门槛。
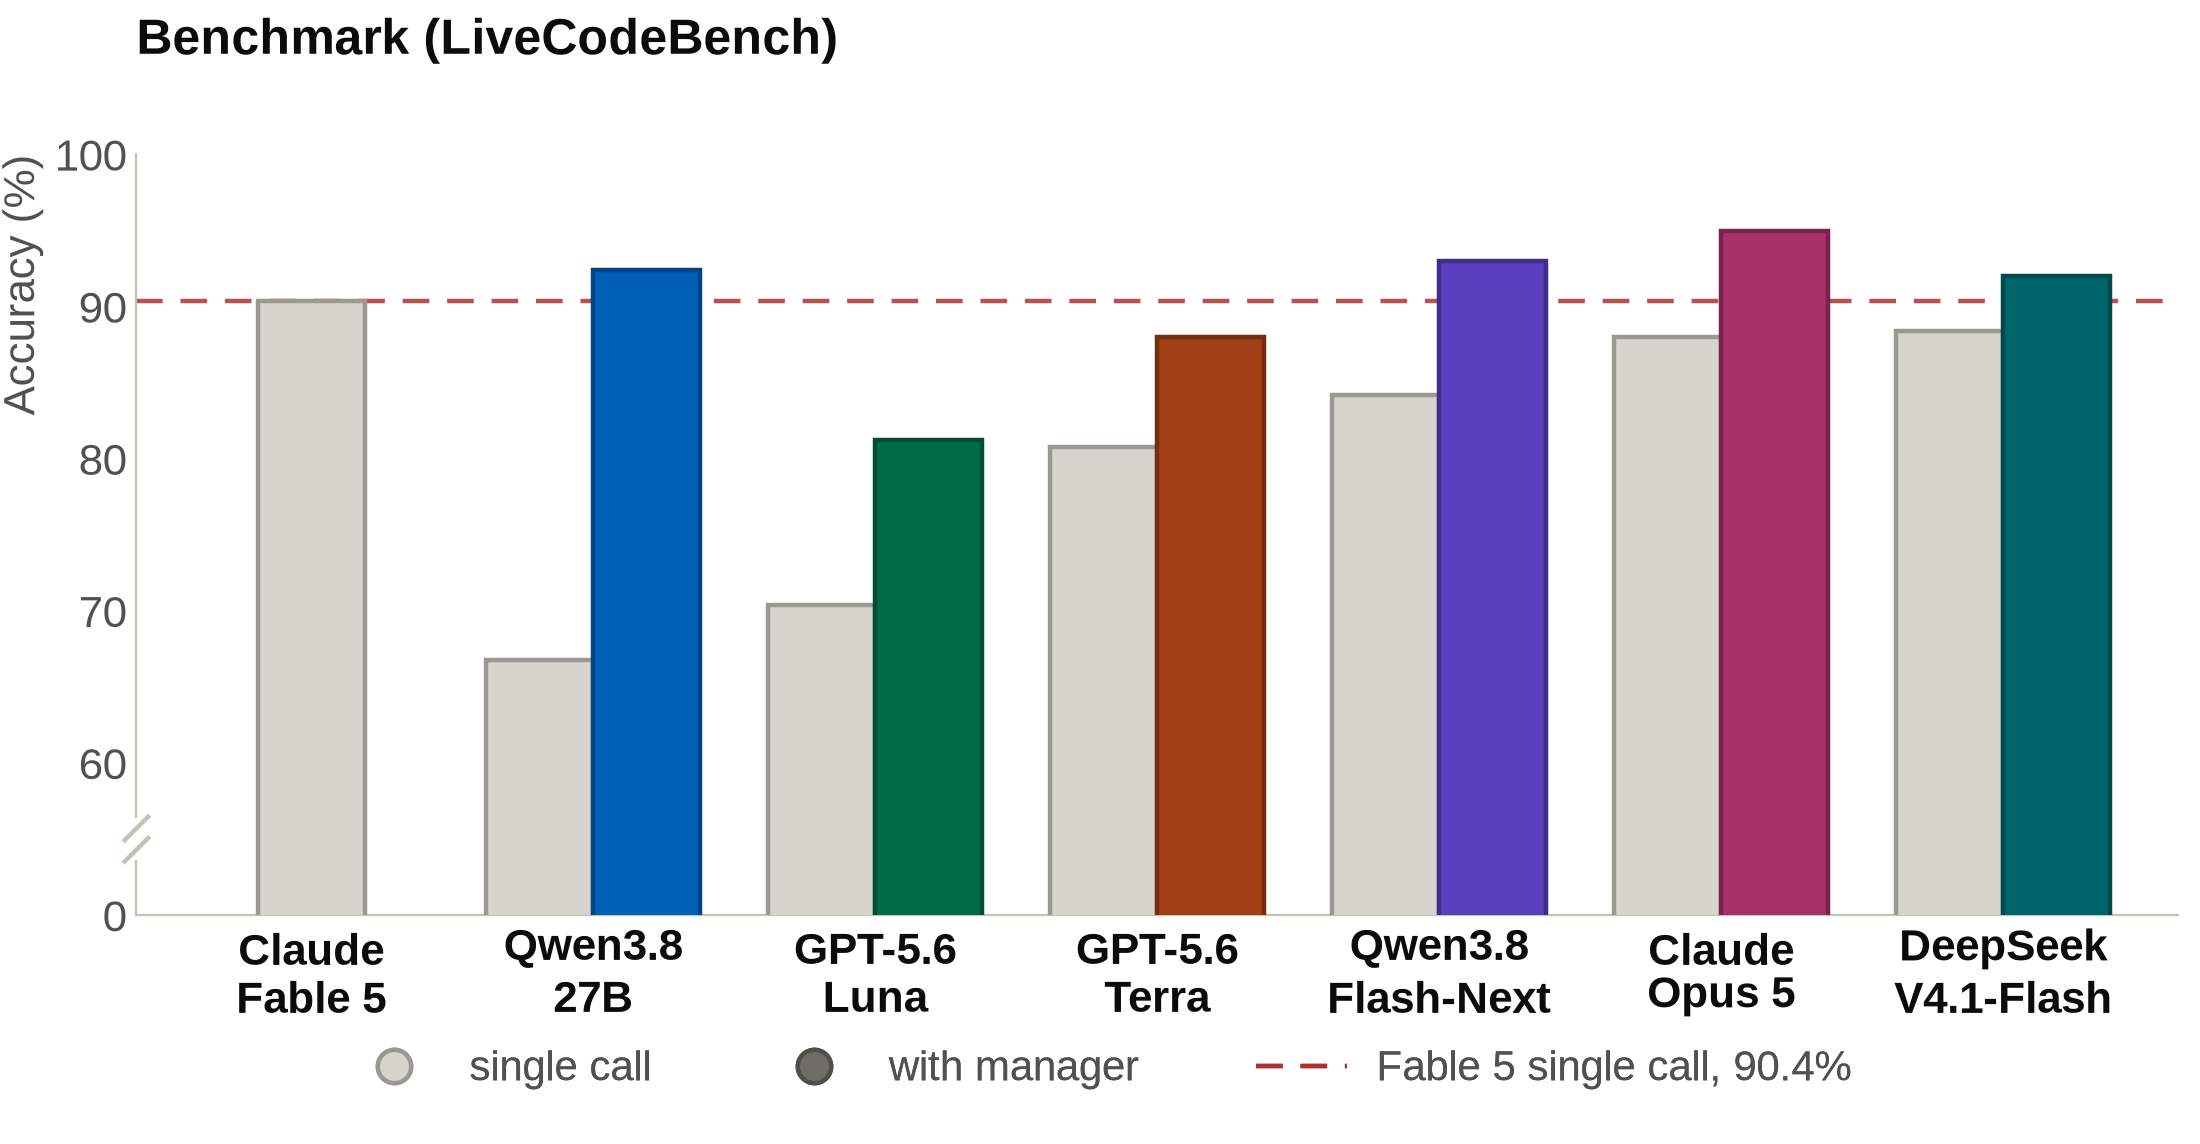 图:GVS5H 仓库公布的 LiveCodeBench 基准表现对比,五模型团队在困难题上逼近满分。来源:github.com/slee-persis/GVS5H
测试基于 guregodevo/memdoor 开源项目的 team-solve 工作流。这套脚本在 2026 年 10 月 25 日由代码智能体生成,并在 11 月 1 日更新至 Memdoor v1.755.0。其架构复刻了 GVS5H 方案提出的五模型协作范式。在 50 次正式求解中系统成功跑通 49 次,体现出很高的工程鲁棒性。
丢弃长对话历史,磁盘文件账本卡死幻觉蔓延
中小模型能在协作中实现性能跃升,关键在于剔除了传统对话记忆链。系统把解题流程拆成七个阶段,每个节点都在自己的生命周期里跑。规划节点 plan 启动后,先在磁盘生成 plan.md 与带锚点的 notes.md 账本。它为后续两位构思者指派明确技术方向,防止发散推理带来信息干扰。
构思阶段由 ideate-a 与 ideate-b 两个独立进程并行展开。前者给出证明链条最短的直观算法,后者从不同的算法家族找替代路线。负责编码的 solve 节点随后读取两份技术备选,将确定的方案写为 solution.py。紧随其后的 test 是一个纯命令步,只捕获运行输出,永不失败运行。
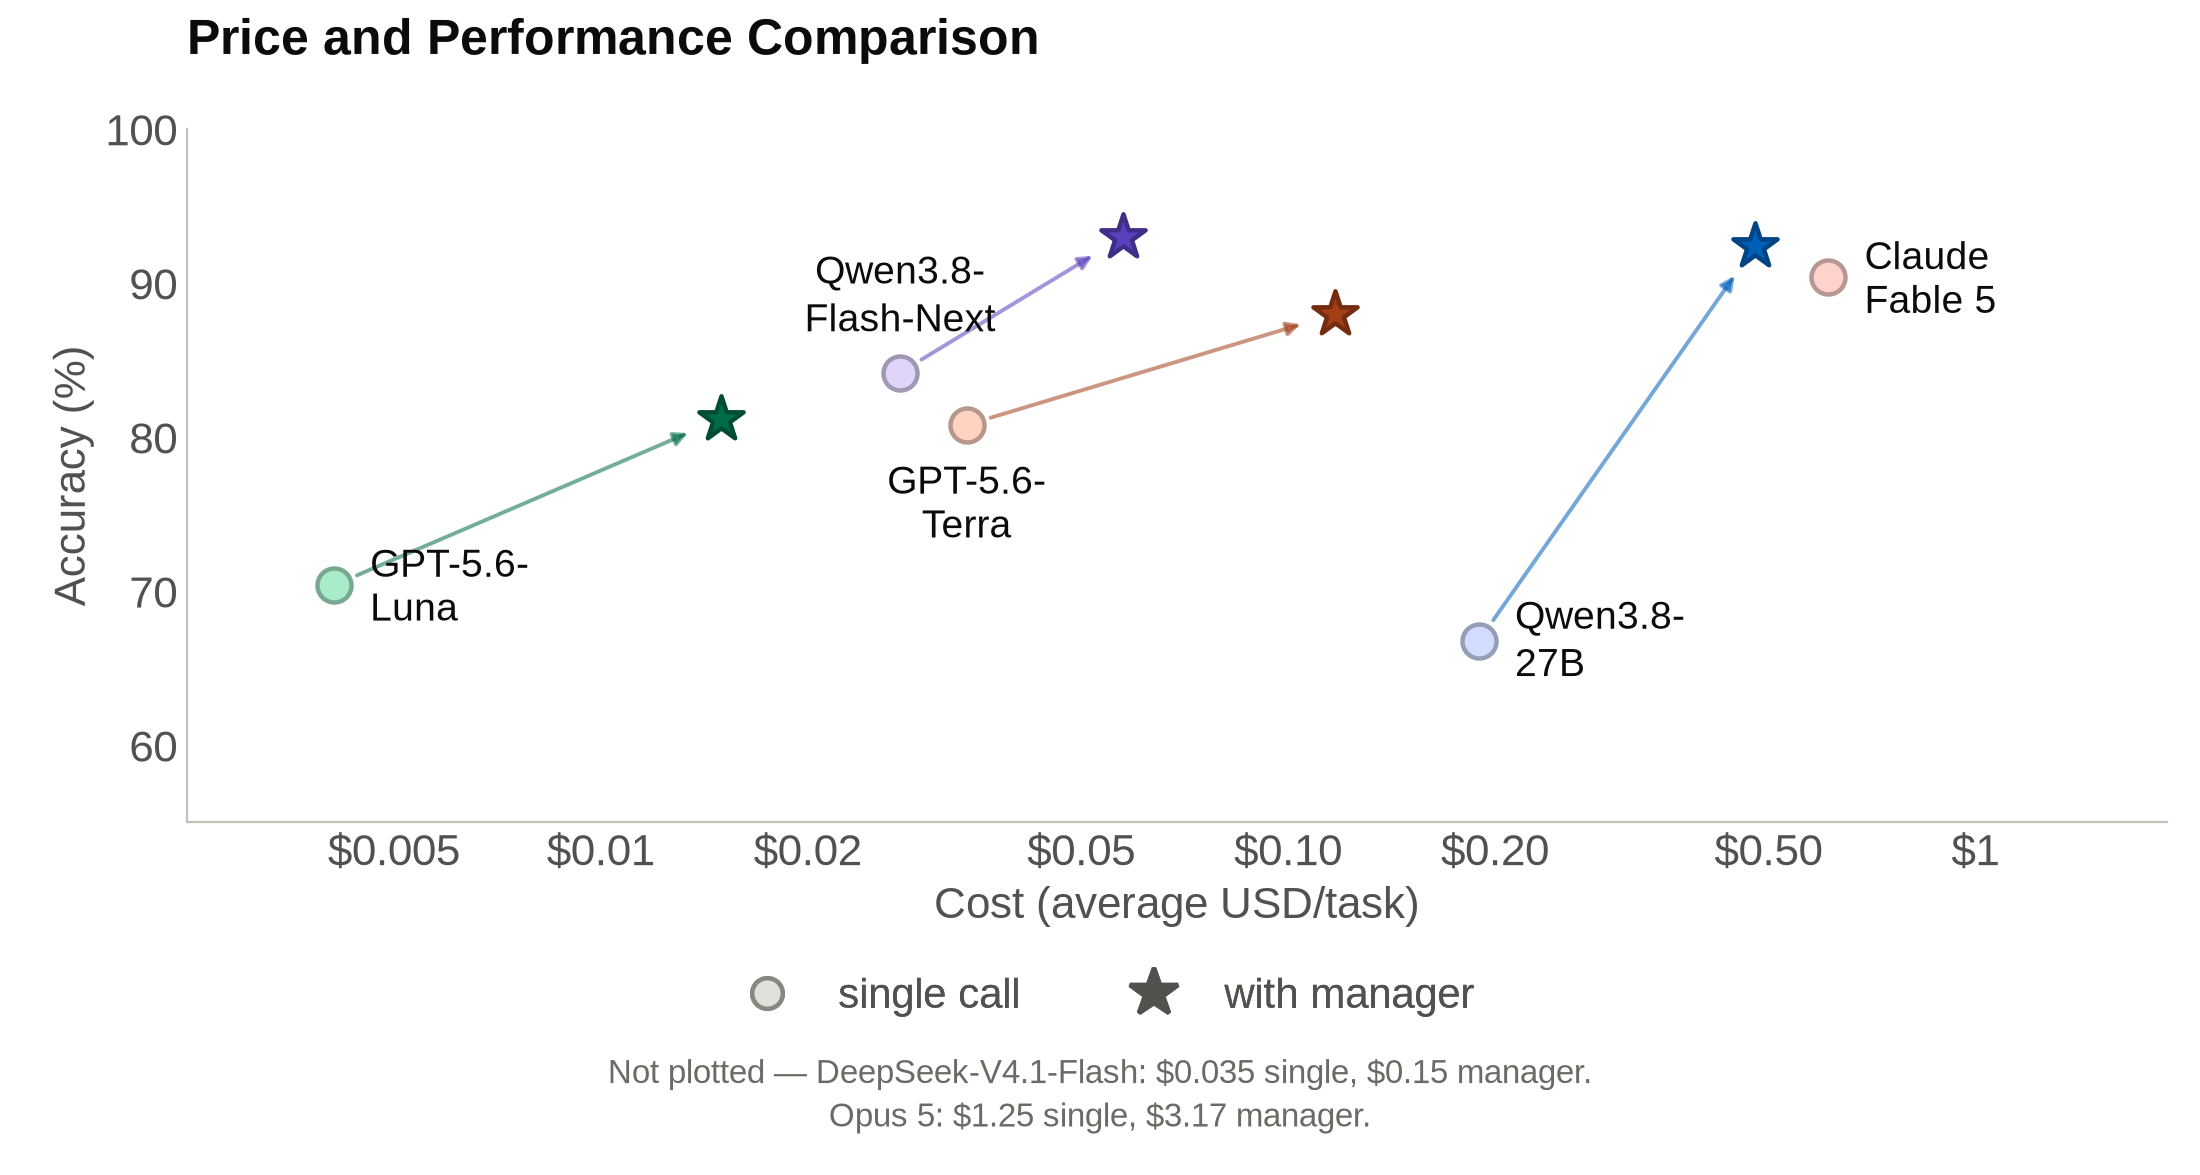 图:五模型协作架构与单体闭源模型在成本和解决率维度的对比分布。来源:github.com/slee-persis/GVS5H
审查环节是整套流程里最严的信息闸门,review 只读测试步骤捕获到的输出,不看模型的自我辩解。测试报错时,repair 按主控指令改代码;verify 作为最后的命令步做判决,非零退出即判失败。**每个角色的提示词都写着同一条铁律:全新上下文、读文件、不依赖对话历史。**状态靠磁盘文件同步,多轮对话里那种幻觉滚雪球的路径被掐断了。
严控推理超参,四处底层适配打通执行流水线
为了让成绩具备对照价值,团队用脚本验证了与原作者代码的等价性。该脚本调用虚拟模型驱动两套流水线,逐项比对每一个网络请求。在四个基准测试用例中,两套实现的输入参数逐字吻合。采样温度也照搬原论文:规划 0.3,构思 0.4,编写与修复压到 0.2。
面对长程代码推理的计算负载,参数调优同样做了细致约束。单次交互的预算上限是 128K token,采样参数锁定 top_p 0.95、top_k 20。若工作节点触及上限而被截断,程序会自动对残缺内容执行摘要压缩。模型没写文本时,系统直接拿它的思考过程当回答。
实际复现中出现的工程摩擦,集中在任务描述文件的组织方式上。第一版尝试为题目重写一份说明文件,27B 从这份文件里的规划表现反而不如直接读原始题目。题目 arc196_c 上,改写文件的规划 0/2 通过,直接读原文 2/2 通过。团队据此在框架里补了四处适配:思考字段回退、采样参数传入、截断标记、单次调用独立的四小时时钟。
两处失分暴露边界:假反例与盲目覆盖推高成本
即便取得了 9.8 分的均值,系统丢掉的分数也划出了这套机制的能力边界。在第 5 轮求解 abc399_e 时,代码在 44 个隐藏用例中仅通过 32 个。查阅日志发现,第一轮编写出的程序本身已经能够正确解题。主控捏造了一个期望答案错误的假反例,团队照着改,反而丢掉了本来正确的程序。
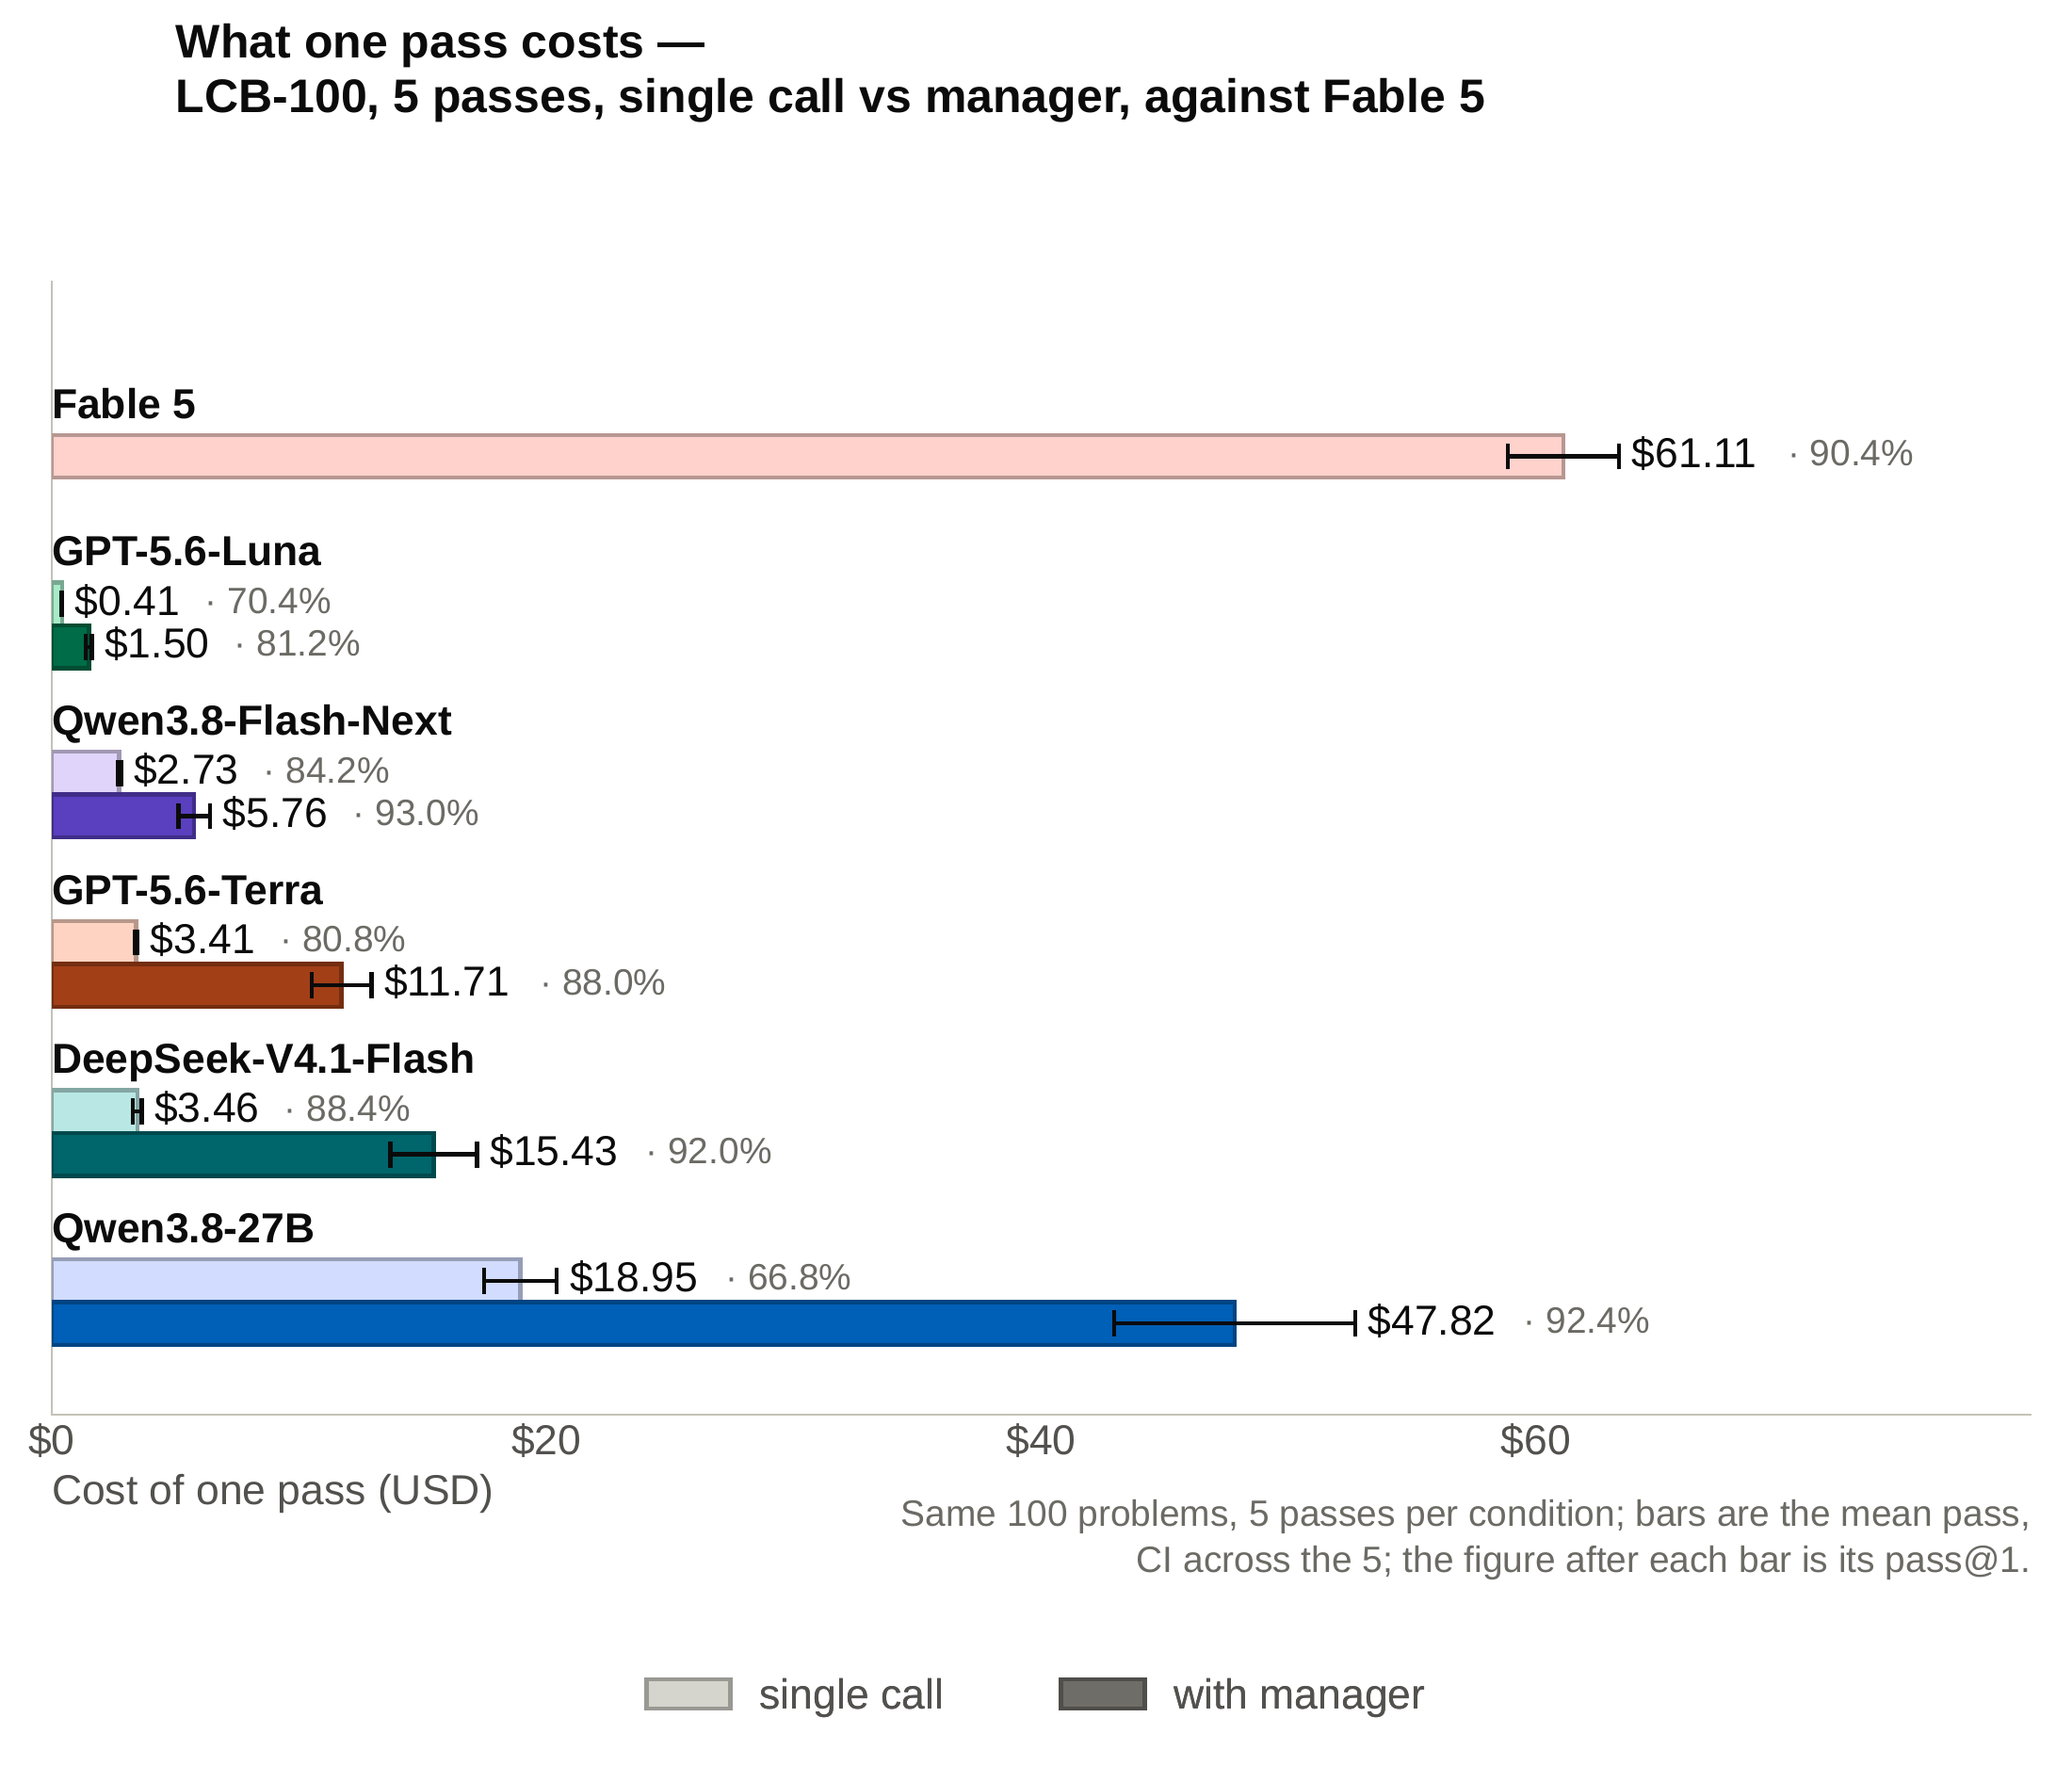 图:单轮测试中各角色与执行步骤的 Token 消耗与费用结构。来源:github.com/slee-persis/GVS5H
类似的失控在第 4 轮的 arc196_c 与 arc196_d 题目中再次发生。程序早就通过了隐藏测试,主控没标出 done,后续轮次把正确程序覆盖掉了。团队最后分别在第 8 轮和最后一次调用里找回了正确代码,代价是单题 3.44 美元与 4.24 美元的额外开销。缺乏外部沙箱核验反例真伪;流水线很容易陷入盲目重写,推高无谓成本。
针对暴露出来的系统缺陷,测试者指明了清晰的修补路径。主控提出的反例要先在微型输入上用暴力解算核一遍,确认真假之后再决定改不改代码。系统还应该保留最后一个通过公开样例的程序,不被后续轮次覆盖。缺少外部核验,光靠模型的语言博弈容易走进死胡同。
评测边界依然存在,工程管线决定多智能体实际收益
审视这组亮眼的数据,不能忽视其特定的评测边界。实验覆盖 10 道题、5 轮重复,样本量比原作者的百题规模小得多。赛题出自 2025 年 3 月底到 4 月初,没法排除数据污染,Fable 5 那一列也没在这套 harness 里重测过。只靠公开样例作为反馈信号,隐藏用例依然对系统构成严峻挑战。
基础设施的调度表现同样为测试提供了真实参照。原作者跑的是自家 FP8 vLLM,复现这边走 OpenRouter 分发给多家云厂商。当首选供应商生成速度降至每秒 14 token 时,调度机制迅速切换到备选节点。三次中途换宿主都没有丢进度,中间文件把已经算完的部分完整保住了。
这场实验没有推翻参数规模的作用,只是把上下文工程推到了更靠前的位置。流水线清掉长对话历史,只靠磁盘文件传递确定状态。小参数模型同样可以解开高难度竞赛代码。**多智能体的实际效能,来自将状态机与外部文件约束注入执行管线。**补上可核验的外部验证和版本回退,多智能体协作才谈得上可靠。
参考链接:
- guregodevo/memdoor 团队求解工作流实现
- GVS5H 开源仓库与技术报告
- Hacker News 社区技术讨论