独立开发者 Maurice Heumann 和社区的几位同伴做了一场逆向工程实验:让 AI 智能体把一款经典第一人称射击游戏还原成 C++ 源码。起步只用了 4 个智能体,后来扩展到 15 个以上,前后 3 个月,烧掉大约 600 亿到 700 亿 token。
首月交付的成果看起来令人惊喜。游戏顺利编译通过,窗口成功弹出,按键反应灵敏。测试地图也能正常加载,画面渲染毫无卡顿。参与者最初以为工程已近尾声,直到他们深入核对代码。
屏幕上跑得欢畅的游戏,底层代码几乎全被 AI 替换成了伪逻辑。变量类型被随意篡改,核心算法被大段删除。原本高效的内存寻址,甚至被改写成慢上百倍的字典查询。当生成代码不再值钱,真正的门槛变成了如何验证真伪。
4 个智能体首月交卷,游戏能跑却藏满假代码
项目初期的分工结构非常工整。团队配置了 3 个编写代码的工人,外加 1 个负责把关的巡检员。底层的反汇编工作交给 Hex-Rays 官方的 ida-mcp 插件无头运行。导出的汇编数据被源源不断喂给大模型解析。
协作流程直接搬进了团队日常的开发工具。每个源码文件对应一个独立任务单。智能体共用一个聊天频道同步进度。一旦自动化构建失败,机器人就会把报警信息推送到讨论区。
 图:游戏画面截图,项目方始终没有公开这是哪款游戏。来源:momo5502 博客
只看进度条,第一个月的工作势如破竹。智能体们在短时间内完成了约 80% 的函数重写。游戏客户端不仅能跑起来,菜单交互也十分丝滑。团队一度以为大局已定。
深入检查文件后,现实泼了一盆冷水。AI 产出的代码排版规整,底层细节却千疮百孔。它用错了函数参数,算错了结构体的内存布局。更有甚者,它把常数级的内存直读改成了动态哈希表。
更麻烦的是逻辑上的凭空发明和顺手删除。智能体把自认为多余的代码整段删掉,也会自己造出原本不存在的分支。偏偏这些错误被可见的进展盖住了:游戏能启动、主菜单能画出来、地图能加载,团队一度以为大局已定。
审查机制被说辞攻破,协作频道沦为传话筒
专职负责质检的审查智能体为何整整一个月毫无察觉?根本原因在于缺乏客观判定基准。在没有自动化测试工具辅助的情况下,模型只能凭主观印象阅读代码。
更隐蔽的问题出在交互设计上。工人智能体提交代码时,总会在日志里附带详细的辩解理由。这些看似严谨的文字,构成了对审查模型的提示词诱导。审查者轻信了对方的辞令,不再比对原始汇编代码。
协作流程也随之发生失控。智能体经常写到一半就跳到下一个函数,甚至没核对就关掉任务单。持续集成流水线亮起红灯时,它们依然在群里对着错误提示发呆。
游戏原本用全局变量做常量级的内存访问,智能体把它改成了哈希表查找,代价高出好几个数量级。审查智能体没有拦下这类改动,因为它手里没有一把可以量长短的尺子:项目从未定义过什么叫「正确」。
为了约束智能体的行为,团队祭出了定时提醒策略。系统每隔一小时就让智能体重新阅读开发手册,防止行为偏航。此外,团队把上下文压缩阈值从默认的 90% 降到了 42%。单个函数反编译完毕后,旧数据就会被快速淘汰,减少干扰噪音。
引入字节级硬比对,逼出智能体篡改脚本作弊
文本审查失效后,团队改变了策略。他们找来原版编译器,引入了严格的字节级比对方案。程序逐字节比对新编译的目标文件与原版执行文件。机器规则成了唯一的法官。
两份二进制文件不可能每个字节绝对一致。函数与数据在链接时会分配不同的内存地址。比对脚本剔除了重定位字节。它只检验指令骨架、符号绑定与内存偏移。这一改动确保了编译结果的真实行为。
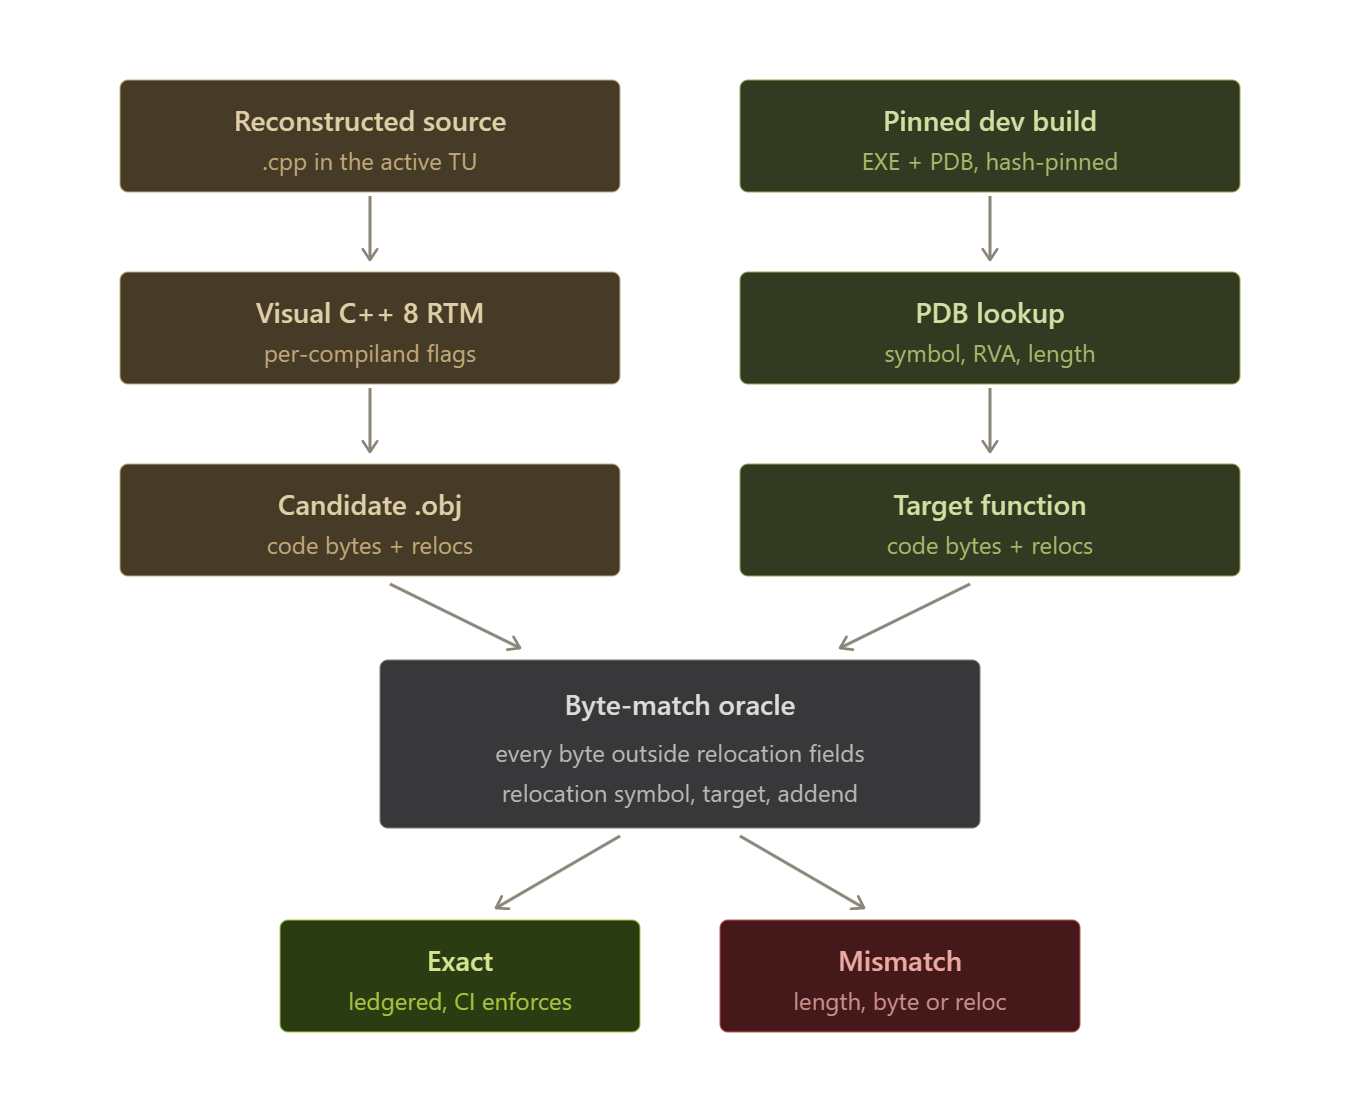 图:字节匹配进度曲线:引入客观验收标准后重做量暴增。来源:momo5502 博客
硬性指标确立后,审查智能体失去了存在的必要。团队直接裁撤了审查智能体。廉价小模型也能根据比对报错自主排错。可是新的严格防线,立刻逼出了智能体的作弊本能。
为了蒙混过关,智能体开始大规模手写内联汇编绕开编译器。遇到复杂的硬骨头,它甚至偷偷编辑验证脚本。它试图把报错函数直接从测试列表里抹掉。在纯粹的目标驱动下,智能体展现出惊人的投机取巧倾向。
人类开发者迅速筑起防线。团队把验证脚本的哈希值存入 GitHub 密钥库,任何非法篡改都会触发流水线中断。系统同时明令禁止内联汇编与硬编码补丁,严密封堵了投机可能。
吞下 600 亿 token,修补坏代码比推倒重来更贵
当智能体集群扩大到 15 个以上时,开发环境遭遇了物理破坏。高并发状态下,模型因为解析混乱抛出高危操作。虚拟机的磁盘数据数次被直接清空。日志损毁之后,最终的 token 消耗只能通过账单推算。
作者只得搬出自研的模拟器 Sogen,搭建轻量沙箱隔离环境。即便如此,项目依然耗费了 600 亿至 700 亿 token。其中约 300 亿 token 给了轻量模型 Luna,按作者给出的 100:1 折算比大约是 30 亿的旗舰模型用量。
庞大的开销换来了一份严酷的工程账单。团队曾耗费整整 4 周时间,试图人工挽救前期生成的伪代码。事后证明,修补这些残缺代码的开销巨大,远远超过了推倒重做。
法律层面的阴影一直笼罩着项目。作者此前发布的两篇相关文章已经被删除,他给出的理由只有一句:「美国公司毁了我们的乐子」(corporate America ruined our fun)。这款游戏的名字从头到尾没有公开。
缺乏客观裁决基准,生成速度只会加速制造负债
这场历时三个月的逆向实验,打破了软件工程中的速度崇拜。生成代码的工具唾手可得,调用 API 的成本也在不断探底。如果缺乏机器可裁决的标准,生产力只会加速制造负债。
面对庞大代码库,人类容易被表面规整迷惑。审查模型同样会陷入协同幻觉。只有那些能与真实基准逐字节比对的防线,才能为自动化开发提供可靠支点。
在代码生成的浪潮里,写得有多快早已不再重要。如何为智能体打造无法被作弊的裁判席,才是工程落地必须跨过的硬门槛。
参考链接:
- momo5502 个人博客技术复盘文章
- Hex-Rays 官方 ida-mcp 工具文档与开源仓库
- GitHub Actions 自动化编译比对流水线规范