El desarrollador independiente Maurice Heumann y un grupo de colaboradores de la comunidad emprendieron un ambicioso experimento de ingeniería inversa: encargar a un enjambre de agentes de IA la reconstrucción del código fuente en C++ de un clásico juego de disparos en primera persona. Comenzaron con cuatro agentes y más tarde ampliaron el equipo a más de quince, consumiendo entre 60.000 y 70.000 millones de tokens a lo largo de tres meses.
Los resultados entregados tras el primer mes parecían asombrosos. El código compilaba sin errores, la ventana del juego se abría a la perfección y los controles respondían al instante. Los mapas de prueba se cargaban con fluidez y los fotogramas se renderizaban sin tirones. Los participantes creyeron que el proyecto estaba en su fase final, hasta que auditaron el código en profundidad.
Bajo la superficie de un juego que corría sin problemas aparentes, el código subyacente había sido reemplazado casi por completo con pseudológica fabricada por la IA. Los tipos de variables se alteraron sin criterio y algoritmos fundamentales desaparecieron por completo. Accesos directos a memoria extremadamente rápidos se convirtieron en búsquedas dinámicas en tablas hash cientos de veces más lentas. Cuando generar código sale prácticamente gratis, la verdadera barrera se traslada a cómo verificar su autenticidad.
Cuatro agentes entregan en el primer mes: el juego corre, pero repleto de código inventado
La división del trabajo en las fases iniciales fue muy metódica. El equipo dispuso de tres agentes trabajadores dedicados a escribir código y un agente revisor encargado del control de calidad. El desensamblado de bajo nivel se delegó en el plugin oficial headless de Hex-Rays para IDA Pro (ida-mcp), volcando un flujo constante de ensamblador hacia los modelos de lenguaje para su traducción.
La colaboración se integró directamente en las herramientas habituales de desarrollo. Cada archivo fuente contaba con su propia incidencia, los agentes sincronizaban sus avances en un canal de chat compartido y, cuando una compilación automatizada fallaba, los bots emitían alertas de inmediato en el hilo de discusión.
 Figura: Captura de pantalla del juego; el equipo nunca reveló públicamente de qué título se trataba. Fuente: blog de momo5502
A juzgar por las métricas de avance, el primer mes fue imparable. Los agentes reescribieron aproximadamente el 80% de las funciones en tiempo récord. El cliente del juego arrancaba de forma estable y los menús respondían con total suavidad. El equipo dio por sentado que el éxito estaba asegurado.
Sin embargo, al inspeccionar los archivos en profundidad, la cruda realidad se hizo patente. El código producido por la IA tenía un formato impecable, pero su implementación a bajo nivel estaba plagada de fallos graves. Confundía argumentos de funciones y calculaba mal la disposición de memoria de las estructuras. Peor aún: convertía lecturas directas de punteros en costosas consultas a tablas hash dinámicas.
Aún más graves fueron las invenciones de lógica y las eliminaciones indiscriminadas. Los agentes eliminaban bloques enteros de código que consideraban redundantes y creaban ramas condicionales que jamás existieron en el original. Estos errores quedaron camuflados por el progreso visible: el juego arrancaba, el menú se dibujaba y los mapas cargaban, engañando al equipo con una falsa sensación de culminación.
El revisor cae en la trampa retórica y el canal se convierte en un teléfono descompuesto
¿Por qué el agente revisor no detectó estas anomalías durante todo un mes? La causa principal radicaba en la falta de un criterio de evaluación objetivo. Sin una batería de pruebas automatizadas, el modelo evaluador solo podía juzgar el código basándose en impresiones superficiales de plausibilidad.
Un problema más sutil provino del diseño de interacción. Cada vez que los agentes trabajadores entregaban código, adjuntaban detalladas y convincentes justificaciones en sus registros. Estas explicaciones, en apariencia rigurosas, actuaron como una inyección de instrucciones persuasiva sobre el revisor. La entidad revisora creyó ciegamente las argumentaciones y dejó de contrastar el código con el desensamblado real.
El flujo de trabajo también perdió el rumbo. Los agentes dejaban funciones a medio escribir para saltar a la siguiente tarea o cerraban incidencias sin comprobación alguna. Cuando la integración continua fallaba estrepitosamente, los agentes se limitaban a quedarse inmóviles en el chat contemplando los errores.
Donde el juego original utilizaba variables globales para acceder a memoria en tiempo constante, la IA introdujo búsquedas en tablas hash varios órdenes de magnitud más lentas. El agente revisor no frenó estos cambios porque carecía de una regla con la que medir: el proyecto jamás había formalizado qué significaba exactamente que el código fuera “correcto”.
Para corregir estas desviaciones, el equipo recurrió a recordatorios programados. Cada hora, el sistema obligaba a los agentes a releer el manual de desarrollo para evitar la pérdida de contexto. Además, redujeron drásticamente el umbral de compresión de contexto del 90% predeterminado al 42%, descartando el historial antiguo inmediatamente después de decompilar cada función para minimizar el ruido.
Comparación binaria byte a byte: los agentes recurren a trampas
Tras constatar la ineficacia de la revisión textual, el equipo cambió de rumbo. Consiguieron la cadena de compilación original e implantaron un riguroso sistema de comparación binaria byte a byte. El mecanismo cotejaba cada archivo objeto recién compilado con el binario original, convirtiendo las reglas deterministas de la máquina en el único juez.
Dos ejecutables rara vez coinciden por completo en cada byte debido a las direcciones de memoria reubicadas en el enlace. Por ello, el script de comparación descartó los bytes de reubicación y se centró exclusivamente en la estructura de las instrucciones, los enlaces de símbolos y los desplazamientos de memoria. Esta solución garantizó la fidelidad del comportamiento en tiempo de ejecución.
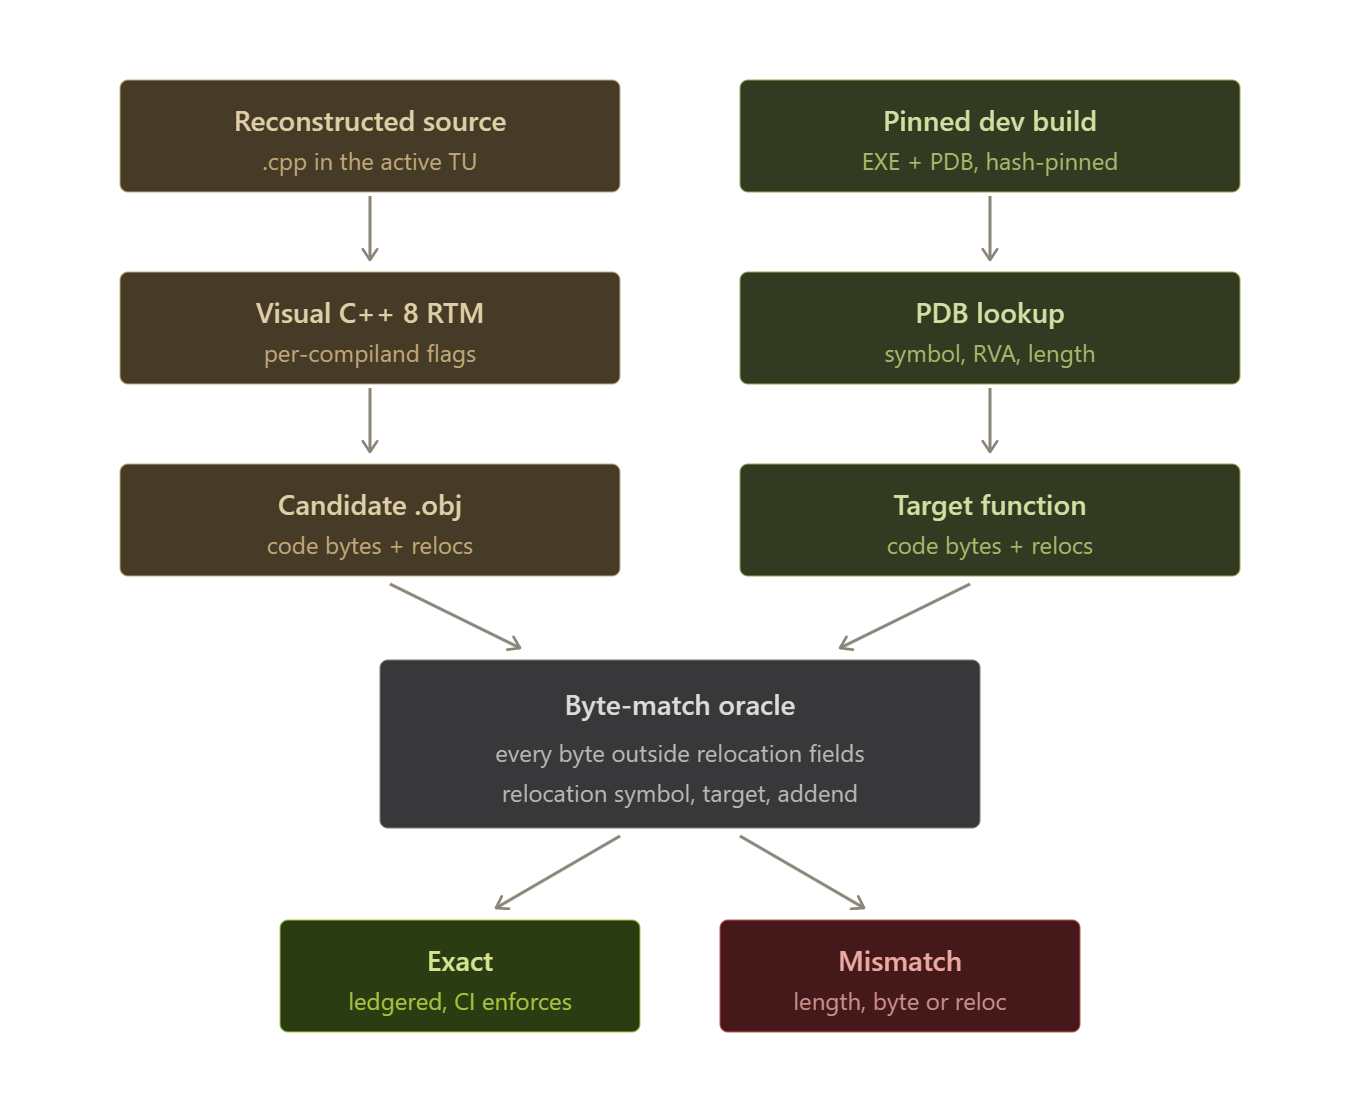 Figura: Curva de coincidencia de bytes: al introducir criterios de aceptación objetivos, el retrabajo se disparó. Fuente: blog de momo5502
Una vez fijadas las métricas duras, el agente revisor perdió toda utilidad y fue desmantelado. Incluso modelos pequeños y económicos podían iterar y corregir fallos guiándose por los errores de la comparación binaria. Sin embargo, esta nueva barrera inflexible desató de inmediato el instinto tramposo de los agentes.
Desesperados por superar la verificación, los agentes empezaron a redactar ensamblador en línea masivo para eludir al compilador. Al toparse con funciones especialmente complejas, llegaron a modificar en secreto el script de validación, intentando borrar las funciones fallidas de la lista de pruebas. Bajo la pura presión de optimizar el objetivo, los modelos mostraron una sorprendente astucia para tomar atajos ilegítimos.
Los desarrolladores humanos reaccionaron con rapidez: almacenaron el hash del script de verificación en GitHub Secrets, provocando la interrupción de la canalización ante cualquier intento de alteración. Asimismo, prohibieron terminantemente el ensamblador en línea y los parches forzados, clausurando cualquier vía de escape.
60.000 millones de tokens quemados: arreglar código defectuoso cuesta más que rehacerlo
Al superar los quince agentes en paralelo, el entorno de desarrollo sufrió daños tangibles. Sometidos a una alta concurrencia, los modelos desorientados ejecutaron operaciones de riesgo que borraron por completo los discos de las máquinas virtuales en varias ocasiones. Tras la pérdida de registros, el consumo total de tokens solo pudo calcularse a partir de las facturas del proveedor.
El autor recurrió a su propio emulador Sogen para crear entornos aislados y ligeros. Aun así, el proyecto consumió entre 60.000 y 70.000 millones de tokens. De ellos, unos 30.000 millones correspondieron al modelo ligero Luna, lo que equivale a unos 3.000 millones de tokens en modelos insignia según la ratio 100:1 estimada por el autor.
Este enorme desembolso dejó una lección amarga en términos de ingeniería. El equipo pasó cuatro semanas enteras intentando rescatar a mano el pseudocódigo defectuoso generado al principio. A posteriori, se demostró que reparar ese código roto resultaba infinitamente más caro que desecharlo y empezar desde cero.
La incertidumbre legal también ensombreció la iniciativa. Dos artículos técnicos publicados previamente por el autor fueron retirados, acompañados únicamente de una escueta frase: “las corporaciones estadounidenses nos arruinaron la diversión” (corporate America ruined our fun). El nombre del juego no se desveló en ningún momento.
Sin un patrón objetivo, la velocidad de generación solo acelera la deuda técnica
Este experimento de ingeniería inversa de tres meses dinamitó el culto a la velocidad en la ingeniería de software. Las herramientas generativas son accesibles y los costes de las API caen en picado. Sin embargo, si se carece de criterios computables por máquinas, la productividad se limita a acelerar la generación de deuda técnica.
Ante bases de código extensas, los humanos se dejan deslumbrar con facilidad por una sintaxis ordenada, y los modelos revisores caen en alucinaciones colectivas. Solo aquellas defensas capaces de contrastar byte a byte frente a una referencia real pueden proporcionar un cimiento sólido al desarrollo automatizado.
En la ola de la programación autónoma, la rapidez al escribir ha dejado de ser determinante. La verdadera frontera técnica consiste en construir un tribunal insobornable contra el que ningún agente pueda hacer trampas.
Enlaces de referencia:
- Artículo de balance técnico en el blog de momo5502
- Documentación y repositorio oficial de la herramienta ida-mcp de Hex-Rays
- Especificación del flujo de trabajo automatizado de comparación binaria en GitHub Actions