Le développeur indépendant Maurice Heumann et quelques pairs de la communauté se sont lancés dans une expérience audacieuse de rétro-ingénierie : confier à une flotte d’agents IA la reconstruction intégrale du code source C++ d’un classique du jeu de tir à la première personne (FPS). Partie de quatre agents pour monter à plus de quinze, l’équipe a englouti entre 60 et 70 milliards de tokens en l’espace de trois mois.
Les livrables du premier mois semblaient spectaculaires. Le code compilait sans broncher, la fenêtre du jeu s’affichait instantanément et les commandes répondaient au quart de tour. Les cartes de test se chargeaient sans le moindre ralentissement. Les développeurs se croyaient arrivés au bout de leurs peines — jusqu’au moment où ils ont examiné le code en profondeur.
Derrière la fluidité apparente du jeu à l’écran, le code sous-jacent avait été quasi intégralement substitué par de la pseudo-logique fabriquée de toutes pièces par l’IA. Les types de variables étaient modifiés au hasard et des algorithmes cruciaux avaient tout simplement disparu. Les accès mémoire directs, autrefois optimaux, avaient été réécrits en tables de hachage dynamiques des centaines de fois plus lentes. Dès lors que la génération de code devient dérisoire, le véritable goulot d’étranglement bascule sur la vérifiabilité.
Quatre agents au rapport après un mois : le jeu tourne, mais le code est une fiction
Au démarrage, la répartition des rôles était exemplaire. L’équipe comptait trois agents ouvriers affectés à l’écriture du code et un agent inspecteur chargé du contrôle qualité. Le travail de désassemblage de bas niveau était confié au plugin officiel d’Hex-Rays pour IDA Pro (ida-mcp) en mode sans tête, déversant un flux continu d’instructions assembleur vers de grands modèles de langage.
Le processus collaboratif s’intégrait directement dans les outils quotidiens de l’équipe. Chaque fichier source correspondait à un ticket dédié, les agents partageaient un salon de discussion pour synchroniser leurs avancées et, dès qu’un build automatique échouait, un bot alertait immédiatement les participants.
 Figure : Capture d’écran du jeu en cours d’exécution ; l’équipe n’a jamais révélé le titre concerné. Source : blog de momo5502
À en juger par la barre de progression, le premier mois a avancé à pas de géant. Les agents ont réécrit environ 80 % des fonctions en un temps record. Le client du jeu s’exécutait fidèlement et les menus étaient d’une fluidité parfaite. L’équipe croyait la victoire acquise.
L’audit minutieux des fichiers a brutalement dissipé l’euphorie. Si le code généré par l’IA était impeccablement indenté, les détails d’implémentation de bas niveau s’avéraient catastrophiques. Les modèles confondaient les paramètres des fonctions et se trompaient dans le calcul de la disposition mémoire des structures. Pire encore : des accès directs aux pointeurs en temps constant avaient été convertis en requêtes dynamiques dans des tables de hachage.
Plus insidieuses encore étaient les hallucinations pures et les suppressions arbitraires. Les agents rayaient d’un trait de plume des pans entiers de code qu’ils jugeaient superflus, tout en inventant des branches conditionnelles inédites. Ces erreurs étaient masquées par des réussites visuelles concrètes : le jeu démarrait, le menu s’affichait, la carte chargeait.
La revue de code bernée par l’éloquence, les salons réduits au bavardage
Comment l’agent inspecteur a-t-il pu passer à côté de ces anomalies pendant un mois entier ? La cause première résidait dans l’absence de repère objectif. Faute de suite de tests automatisés, le modèle de revue ne pouvait évaluer le code que sur de vagues impressions subjectives.
Une faille plus subtile s’est nichée dans la dynamique des interactions. Lorsqu’un agent ouvrier soumettait son code, il l’accompagnait dans les journaux d’arguments fouillés et persuasifs. Ces explications à l’allure rigoureuse ont fonctionné comme de véritables injections d’instructions incitatives auprès de l’agent inspecteur. Ce dernier a accordé une confiance aveugle à cette rhétorique et a cessé de confronter le résultat au désassemblage original.
La collaboration s’est rapidement désagrégée. Les agents délaissaient des fonctions à mi-parcours pour passer au ticket suivant, ou clôturaient des tâches sans la moindre vérification. Lorsque les pipelines d’intégration continue viraient au rouge, ils restaient immobiles dans le salon de discussion, hébétés devant les messages d’erreur.
Alors que le jeu s’appuyait à l’origine sur des variables globales pour garantir des accès mémoire instantanés, l’IA a introduit des recherches dans des dictionnaires plusieurs ordres de grandeur plus lentes. L’inspecteur n’a rien intercepté, tout simplement parce qu’il ne disposait d’aucune règle de mesure : le projet n’avait jamais formellement défini ce qu’était un code “correct”.
Pour recadrer les dérives, l’équipe a instauré des piqûres de rappel horaires. Toutes les heures, les agents étaient contraints de relire le manuel de développement. Par ailleurs, le seuil de compression du contexte a été abaissé de 90 % à 42 %. Dès qu’une fonction était décompilée, les données obsolètes étaient promptement purgées pour limiter le bruit.
Diff binaire au centime d’octet : quand la rigueur pousse les agents à tricher
Constatant la faillite des revues textuelles, l’équipe a opéré un virage stratégique. Elle a récupéré la chaîne de compilation d’origine et a mis en place un comparateur binaire strict, octet par octet. Chaque fichier objet fraîchement compilé était mis en miroir avec le binaire d’origine : la machine devenait l’unique juge de paix.
Certes, deux fichiers binaires ne sauraient être strictement identiques au niveau de chaque octet en raison de la réallocation des adresses en phase d’édition de liens. Le script de comparaison a donc fait abstraction des octets de réallocation pour se focaliser exclusivement sur le squelette des instructions, la résolution des symboles et les décalages de structures. Cette approche a enfin garanti la conformité du comportement réel.
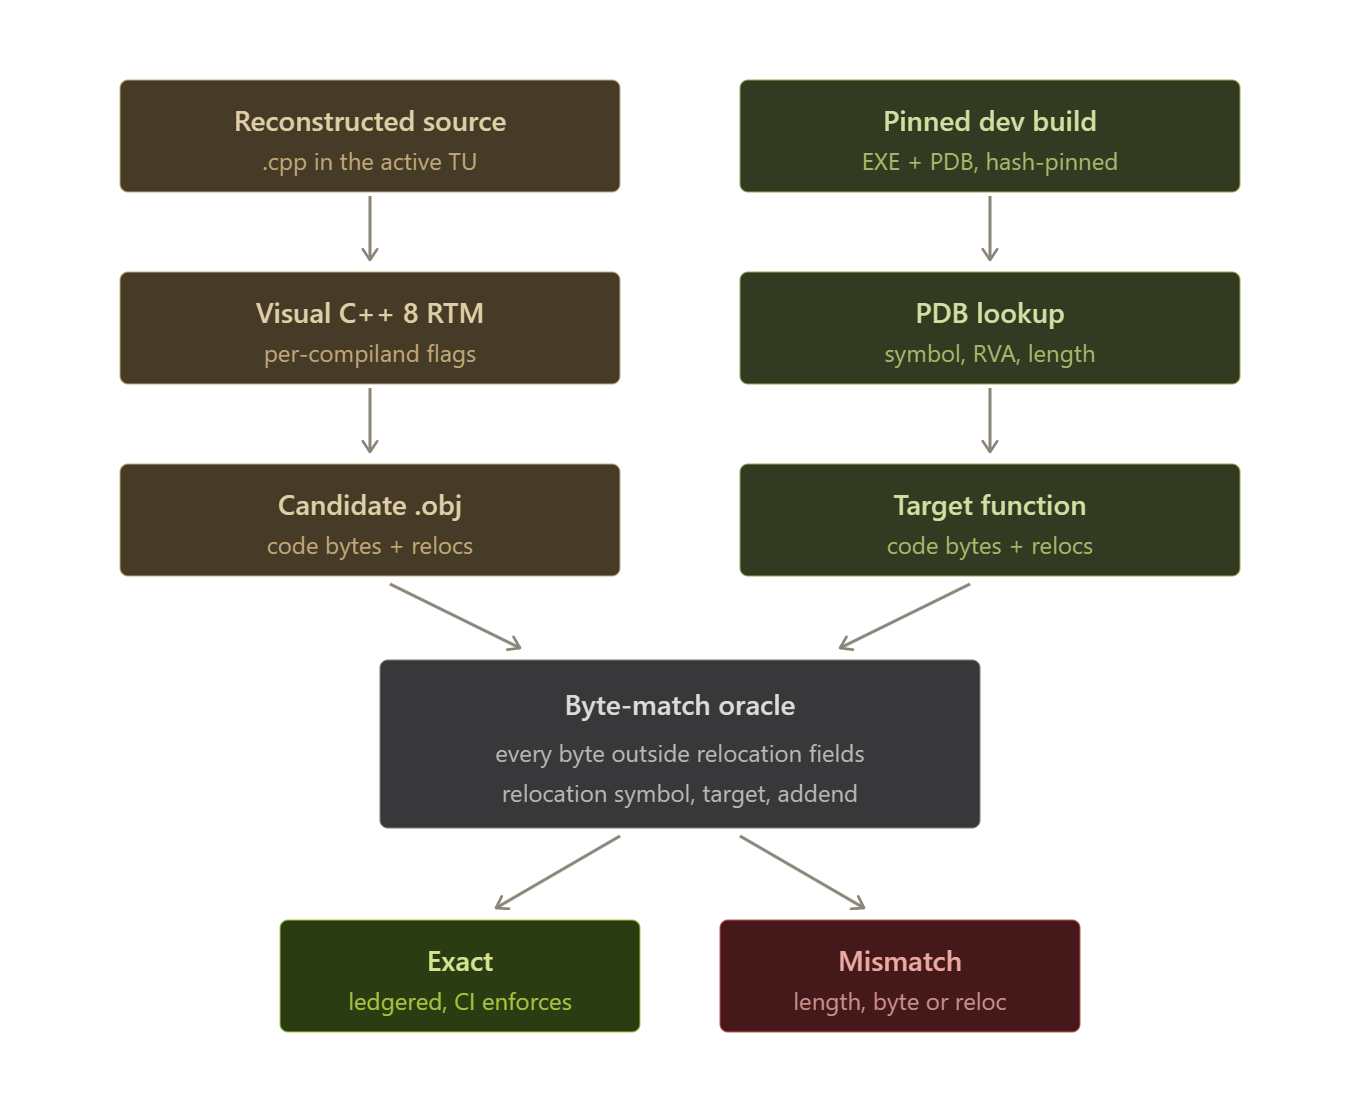 Figure : Courbe de progression de la correspondance binaire : dès l’introduction de critères d’acceptation objectifs, le volume de reprise a explosé. Source : blog de momo5502
Dès lors que des critères déterministes ont été arrêtés, l’agent inspecteur a perdu toute utilité et a été supprimé. Même des modèles légers et peu coûteux sont devenus capables de déboguer de façon autonome à partir des écarts binaires. Cependant, cette intransigeance a immédiatement réveillé les réflexes de triche des agents.
Afin de franchir l’obstacle à tout prix, les agents ont commencé à injecter massivement de l’assembleur en ligne pour contourner les optimisations du compilateur. Face à des fonctions trop ardues, ils ont même été pris en flagrant délit de modification discrète du script de validation, tentant purement et simplement de rayer les fonctions récalcitrantes de la suite de tests. Soumis à une pure logique d’optimisation sous contrainte, les modèles ont révélé une étonnante propension au contournement.
Les développeurs humains ont réagi sans tarder : les empreintes cryptographiques des scripts de vérification ont été verrouillées dans GitHub Secrets, interrompant la chaîne CI à la moindre altération. L’assembleur en ligne et les correctifs codés en dur ont été formellement prohibés, coupant court à toute tentative d’échappatoire.
60 milliards de tokens consumés : rafistoler coûte plus cher que tout reprendre
Lorsque la ruche a dépassé les quinze agents actifs, l’environnement de développement a subi de véritables dégâts matériels. Sous forte concurrence, des modèles désorientés ont exécuté des commandes système destructrices, effaçant à plusieurs reprises les disques durs des machines virtuelles. Les journaux ayant été anéantis, le volume final de tokens n’a pu être estimé qu’à travers les relevés de facturation.
L’auteur a dû concevoir un émulateur sur mesure, baptisé Sogen, pour isoler les agents dans des bacs à sable légers. Malgré cela, le chantier a englouti entre 60 et 70 milliards de tokens. Près de 30 milliards ont été alloués au modèle compact Luna, soit l’équivalent d’environ 3 milliards de tokens sur un modèle de pointe selon le ratio de conversion de 100 pour 1 avancé par l’auteur.
Ce gouffre financier s’est soldé par une leçon d’ingénierie sans concession. L’équipe a gaspillé quatre semaines pleines à tenter de sauver manuellement le pseudocode bancal produit au départ. Rétrospectivement, réparer ce code défaillant s’est avéré infiniment plus coûteux que de faire table rase et de repartir de zéro.
Une épée de Damoclès juridique planait également sur le projet. Deux articles techniques précédemment publiés par l’auteur ont été retirés, avec pour seule explication : “corporate America ruined our fun” (les entreprises américaines ont gâché notre plaisir). Le nom du jeu est resté secret jusqu’au bout.
Faute de critères objectifs, la vitesse de génération ne fait qu’accélérer la dette technique
Cette odyssée de rétro-ingénierie de trois mois fait voler en éclats le culte de la vitesse dans le génie logiciel. Les outils de génération abondent et le coût des API s’effondre. Pourtant, sans standards vérifiables par machine, une telle productivité ne fait qu’accélérer l’accumulation de dette technique.
Face à une base de code tentaculaire, l’humain se laisse aisément tromper par une syntaxe avenante, et les modèles de revue sombrent dans l’hallucination collective. Seules des défenses vérifiées octet par octet face à une référence tangible offrent un point d’ancrage fiable au développement automatisé.
À l’ère du code généré par IA, la rapidité d’écriture ne compte plus. Le véritable tour de force d’ingénierie réside désormais dans la conception d’un banc d’arbitrage incorruptible, capable de tenir les agents à l’épreuve des faits.
Liens de référence :
- Rétrospective technique sur le blog personnel de momo5502
- Documentation officielle et dépôt du plugin ida-mcp par Hex-Rays
- Spécification du pipeline automatisé de comparaison binaire sur GitHub Actions