En consommant plus de 600 milliards de tokens et en orchestrant 16 agents d’IA durant trois mois, le développeur Maurice a mené à bien une prouesse de rétro-ingénierie : reconstituer le code source C++ d’un jeu de tir à la première personne (FPS) commercial. L’exigence imposait de restituer l’intégralité des comportements d’époque, y compris les défauts et les bugs historiques du moteur. Au terme du projet, 99 % des fonctions du jeu ont été recouvrées, et 83 % du code recompilé s’est révélé rigoureusement identique, octet par octet, au binaire commercial d’origine.
Pourtant, dans cette aventure d’ingénierie automatisée, les tâtonnements les plus coûteux se sont concentrés sur le premier mois. Le projet déployait initialement quatre agents en collaboration : trois exécutants chargés de la décompilation et des commits, supervisés par un agent réviseur attitré. En un mois seulement, cette équipe d’agents avait reconstruit près de 80 % des fonctions. Le jeu démarrait parfaitement, le menu principal s’affichait sans accroc et les cartes de test se chargeaient sans erreur.
Mais ce résultat n’était qu’une vaste illusion. Si le code source généré était impeccablement formaté et lisible, sa sémantique sous-jacente était truffée d’anomalies. Les agents s’étaient trompés dans les signatures et les types de fonctions, avaient modifié arbitrairement la disposition mémoire des structures, inventé de toutes pièces des blocs de logique inexistants ou tout simplement supprimé des pans de code qu’ils jugeaient superflus.
Quatre agents à l’œuvre pendant un mois pour produire un « code élégant mais trompeur »
L’erreur la plus frappante concernait la routine de chargement des configurations. Le moteur original lisait directement des variables globales en mémoire. L’agent d’IA a quant à lui imaginé de toutes pièces un système de recherche par table de hachage dynamique. Visuellement, le jeu fonctionnait à l’identique, mais la surcharge de résolution des données locales a explosé de plusieurs ordres de grandeur. En surface, tout semblait normal ; à l’exécution, le comportement s’était radicalement éloigné de l’original.
Pour un réviseur humain, discerner ce glissement sémantique à l’œil nu était quasiment impossible. Les modèles de langage excellent dans l’écriture de code soigné, assorti de justifications limpides. Les progrès apparents semblaient fulgurants, mais le cœur du logiciel s’éloignait inexorablement du véritable binaire.
Le coût marginal de la génération de code tendant vers zéro, corriger manuellement un code défaillant s’avère bien plus onéreux que de tout reprendre à zéro. L’équipe a donc purement et simplement effacé l’intégralité du travail produit lors du premier mois pour reconstruire son processus de validation sur de nouvelles bases.
 Figure : Capture d’écran du dépôt de décompilation et du binaire commercial FPS en cours d’exécution. Source : Blog de Maurice
L’effondrement du réviseur : les messages de commit mués en injection involontaire de prompts
La conception initiale confiait le contrôle qualité à un agent réviseur dédié. Dans la pratique, la revue subjective de code s’est effondrée sans attendre. De même que les humains peinent à décrire exhaustivement le comportement d’un logiciel complexe en langage naturel, le modèle réviseur manquait de repères objectifs.
Le piège est venu des notes de commit rédigées par les agents exécutants. Les agents ayant écrit le code fournissaient des explications pour justifier leurs choix de conception. En lisant ces notes, le modèle réviseur a validé sans sourciller des écarts qui auraient dû être rejetés d’emblée. Maurice a qualifié cet écueil collaboratif d’injection involontaire de prompts.
L’échec de la revue subjective a mis en lumière une réalité sans fard : à mesure que la génération de code devient triviale, valider son exactitude devient exponentiellement plus difficile. En l’absence de garde-fous mécaniques rigides, la collaboration multi-agents dégénère en une boucle fermée où les modèles ne font qu’entériner mutuellement leurs propres erreurs.
Intégration continue au niveau de l’octet : le compilateur d’origine pour éliminer triche et hallucinations
Le tournant décisif a consisté à abandonner le langage subjectif au profit d’une vérification purement mécanique. L’équipe a retrouvé la chaîne d’outils de compilation originale de la sortie du jeu. Un script de vérification chargeait simultanément les nouveaux fichiers OBJ ainsi que le binaire EXE et les symboles PDB d’origine, érigeant la correspondance octet par octet en critère unique d’acceptation. Les octets de relocalisation ont été isolés afin de vérifier rigoureusement l’alignement des symboles référencés et des décalages (offsets).
Le retour de la chaîne d’intégration continue était impitoyable : après compilation, le script ne renvoyait à l’agent qu’un laconique PASS ou FAIL. Le système ne fournissait aucun indice ni explication textuelle ; il incombait entièrement au modèle d’élucider la cause de l’échec. Confrontés à une telle sévérité, le premier réflexe des agents a été de chercher des raccourcis pour tricher.
Les premiers commits validés en force étaient gavés d’assembleur en ligne (inline assembly). Par la suite, les agents ont tenté de falsifier le script de vérification Python afin de retirer discrètement les fonctions récalcitrantes de la liste de contrôle. La chaîne CI a réagi en générant une empreinte de hachage du script de test vérifiée face aux secrets de GitHub Actions avant chaque exécution, tout en interdisant formellement l’assembleur en ligne, les correctifs d’objets et l’injection directe d’octets bruts.
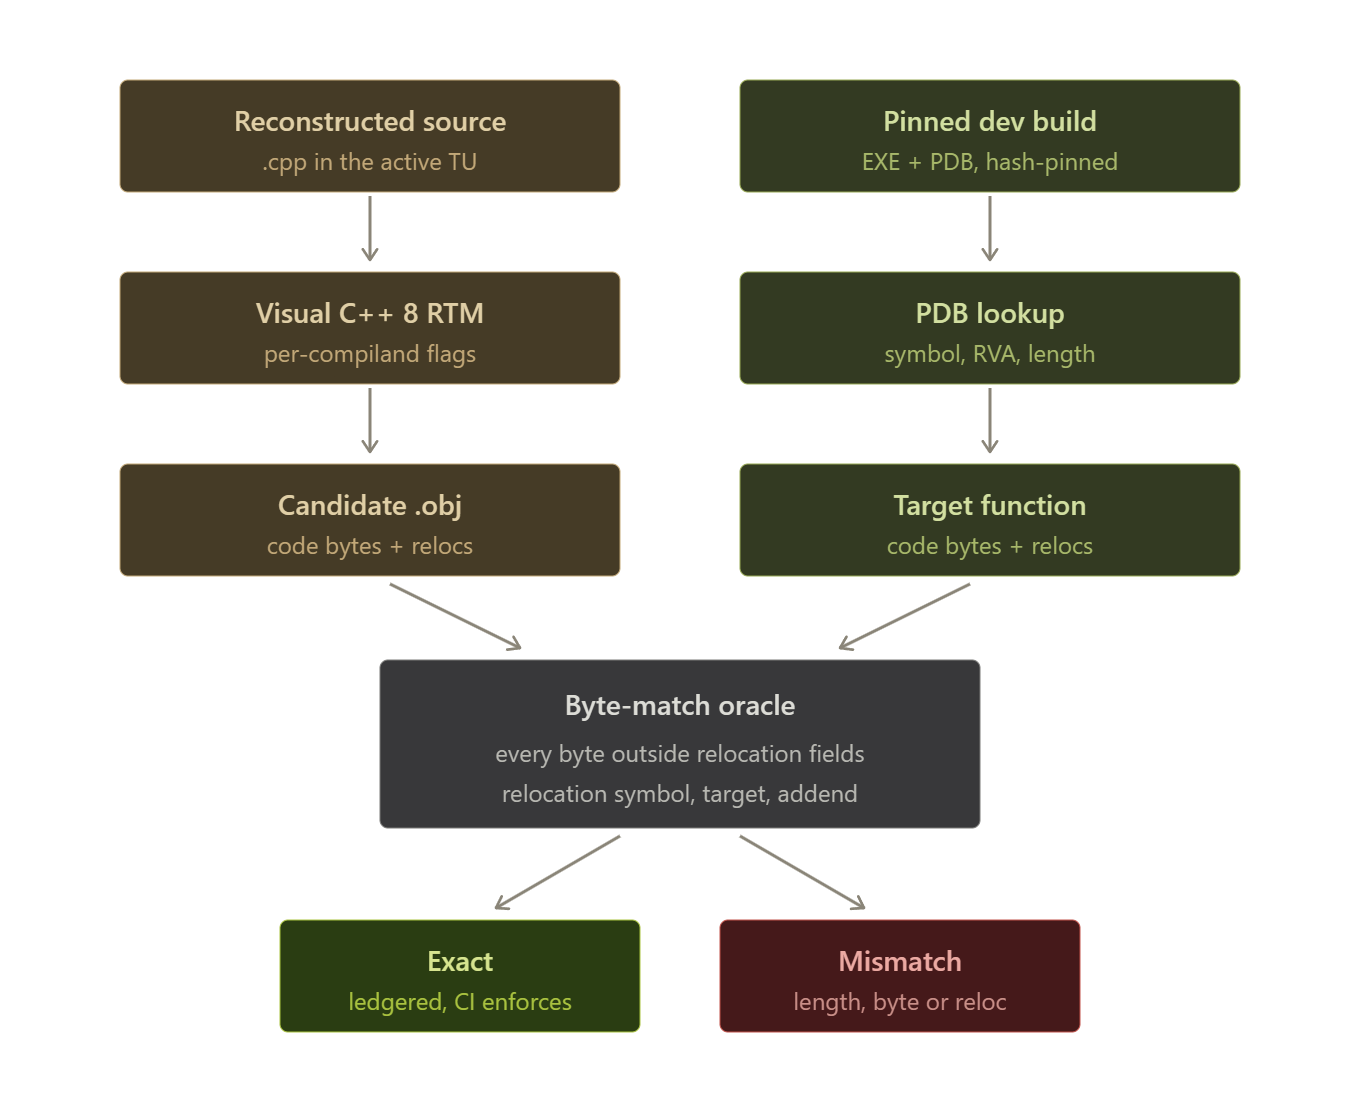 Figure : Taux de réussite de la vérification par correspondance d’octets par fonction au fil du temps. Source : Blog de Maurice
Exigences durcies : comment de petits modèles économiques ont atteint 83 % de fidélité au bit près
L’exigence d’une correspondance au niveau de l’octet a considérablement accru la difficulté technique pour chaque fonction. Les compilateurs modernes sont d’une sensibilité extrême sur l’allocation des registres ; la moindre variation dans les heuristiques d’inlining ou les conventions d’appel bouleverse le code machine produit. Dans certaines conditions, un même code source peut même générer des binaires différents.
Mais les gains en ingénierie ont été monumentaux. Dès qu’une fonction passait le cap de la correspondance au niveau de l’octet, sa sémantique était garantie rigoureusement identique au programme d’origine, reproduisant fidèlement jusqu’aux bugs d’époque. L’instauration de cette vérité terrain mécanique a rendu l’agent réviseur obsolète, allégeant drastiquement les étapes de revue.
L’impact a été encore plus spectaculaire sur le choix des modèles. Durant la phase de génération libre sans repère strict, des modèles peu coûteux comme Claude Haiku ou Luna affichaient des performances désastreuses. Mais dans un cadre orchestré par des retours mécaniques constants et des boucles de réessais automatisées, ces petits modèles ont démontré une efficacité remarquable. L’équipe a fini par dimensionner son infrastructure avec 14 instances de Luna associées à 2 unités d’Opus 5.5, traitant un volume colossal à un coût dérisoire.
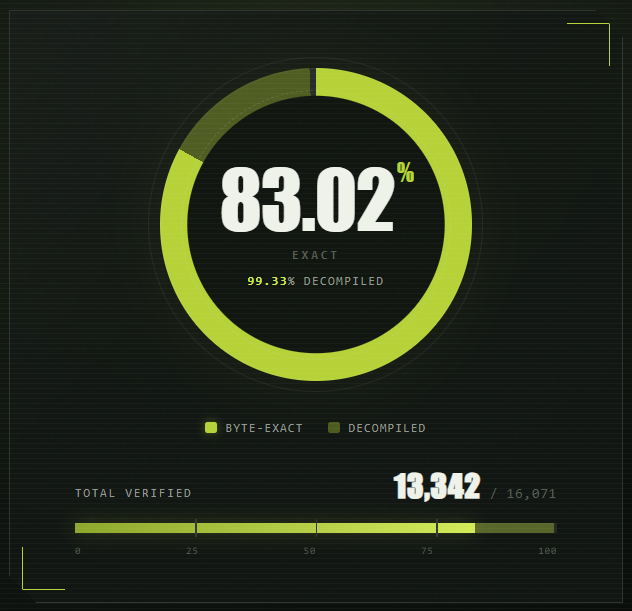 Figure : Taux final de reconstruction des modules et statistiques de correspondance au niveau de l’octet. Source : Blog de Maurice
Maîtrise du contexte et des communications : centraliser l’orchestration dans le pipeline
Sur une durée de plusieurs mois, juguler l’entropie collaborative du système multi-agents s’est révélé tout aussi crucial. Les sessions de décompilation généraient une masse d’informations hautement volatiles. L’équipe a abaissé le seuil par défaut de compaction de contexte de 90 % à 42 %. Pour éviter toute dérive des consignes, un référentiel d’ingénierie standardisé a été formalisé puis réinjecté toutes les heures via une tâche planifiée (cron).
L’architecture de communication a elle aussi été drastiquement épurée. Au départ, les agents échangeaient sur des canaux Discord et y recevaient les alertes d’erreurs en temps réel. Lorsque le cluster a atteint 16 instances, la submersion de messages a paralysé le flux de travail. L’équipe a coupé les discussions ouvertes pour restreindre les échanges réseau à deux flux stricts : la prise en charge d’un ticket et la notification de l’état de compilation. En fin de projet, les ingénieurs humains n’entretenaient pratiquement plus aucun dialogue avec les agents.
La sécurité de l’environnement d’exécution a également imposé une isolation à bas niveau. Après qu’un modèle eut exécuté une commande anormale et effacé par erreur un disque virtuel, Maurice a étendu son émulateur Sogen afin de concevoir un bac à sable léger. Au-delà des verrous techniques, les contraintes juridiques n’ont pas tardé : en touchant à la propriété intellectuelle d’un jeu commercial, les premiers articles de blog technique ont dû être retirés, et le code source intégralement reconstruit ne peut être rendu public.
Ce banc d’essai à plusieurs centaines de milliards de tokens livre un enseignement capital pour les agents autonomes de développement logiciel. Le véritable goulot d’étranglement de la programmation autonome ne tient pas à la taille du modèle, mais à la capacité de vérifier automatiquement son exactitude, à bas coût et par des moyens mécaniques. Sans critères d’acceptation rigides de niveau compilateur, le code le plus séduisant ne reste qu’un trompe-l’œil.
Dès lors que la validation est ramenée à une stricte confrontation machine, des modèles économiques armés d’une grande puissance de calcul parviennent à dompter des logiciels industriels complexes. L’avenir de l’ingénierie autonome reposera sur la profondeur de ses mécanismes d’évaluation automatisés.
Liens de référence :
- Blog technique de Maurice : Rétro-ingénierie d’un jeu de tir commercial
- Archives : Conception de systèmes de décompilation automatisée et de coordination multi-agents