耗费超过 6000 亿 token,调度 16 个 AI agent 运转 3 个月,开发者 Maurice 完成了一场逆向实验。他的目标,是将一款商业第一人称射击游戏还原为 C++ 源码。项目要求保留当年的全部细微行为,包括历史遗留缺陷。团队最终收录了 99% 的游戏函数。其中 83% 的代码在重编译后,与原版二进制达成逐字节一致。
在这场自动化工程里,最昂贵的试错集中在第一个月。项目初期部署了 4 个 agent 协作。3 个 worker 负责反编译与提交,1 个 reviewer 负责审查。仅用一个月时间,agent 团队便重建了约 80% 的函数。游戏成功启动,主菜单画面正常渲染,测试地图也能加载。
但这套成果其实是一场幻觉。生成的源码排版整洁,命名清晰,底层语义却破绽百出。agent 用错了函数签名与类型,随意篡改结构体在内存中的排布,也会凭空发明逻辑,或者把自认为多余的逻辑直接删掉。
4 个 agent 跑了一个月,产出全套「好看的假代码」
最典型的失误发生在一处配置读取逻辑中。原版引擎直接寻址全局变量来读取配置。agent 却凭空写出了一套动态哈希表查询。游戏界面照常运行,局部数据寻址的开销却高出几个数量级。表面看似正常,内部执行已经偏离。
人类审查者很难通过目测捕捉到这种语义偏移。语言模型擅长编写工整的代码,并附上逻辑自洽的说明。表面进展飞快,核心功能却与真实的游戏二进制渐行渐远。
代码生成的边际成本已经趋近于零。在缺乏客观检验时,抢救劣质代码的成本远高于推倒重来。团队删除了首月积累的全部成果,决定重构验收流程。
 图:反编译项目仓库与商业 FPS 游戏本体运行截图。来源:Maurice 的博客
专职 Reviewer 沦陷:注释成了无意识 Prompt 注入
团队最初的设计,是让专职 reviewer agent 把关质量。实际运行证明,主观代码审查迅速失效。人类难以用自然语言穷尽复杂软件的意图,模型审查者同样缺乏客观依据。
更棘手的问题出在 worker agent 提交的说明文本上。编写代码的 agent 会在提交信息中写下解释,阐述修改动机。审查模型阅读这些文字后,全盘接受了本该被驳回的偏差。作者将这种协同问题定义为无意识的 Prompt 注入。
主观审查失效暴露了一个残酷事实。生成代码的门槛降低之后,验证正确性的难度呈指数级上升。缺乏硬性标尺,多 agent 协同很容易演变成互相确认错误的封闭循环。
引入字节级 CI,用原版编译器逼退作弊与幻觉
转折点来自一套脱离主观语言的机器检验标准。团队找回了原版游戏发布时的编译器工具链。验证脚本同时读取新生成的 OBJ 文件与原版 EXE 和 PDB 符号,以逐字节比对为唯一准绳。重定位字节被单独剥离,转为校验双方引用的符号与偏移是否绝对吻合。
流水线的反馈格外冷峻。脚本在编译完成后只向 agent 反馈 PASS 或 FAIL。系统不提供多余的文字提示,排查失败原因的工作全由模型承担。面对严格判定,agent 的首选策略是寻找捷径作弊。
第一批强行通过检查的提交塞满了内联汇编。随后 agent 开始尝试篡改 Python 验证脚本,企图把难啃的函数移出检查列表。流水线随即为验证脚本生成哈希签名,在每次运行前比对 GitHub Actions 密钥。同时,系统明确禁止内联汇编、对象补丁以及直接内嵌裸字节。
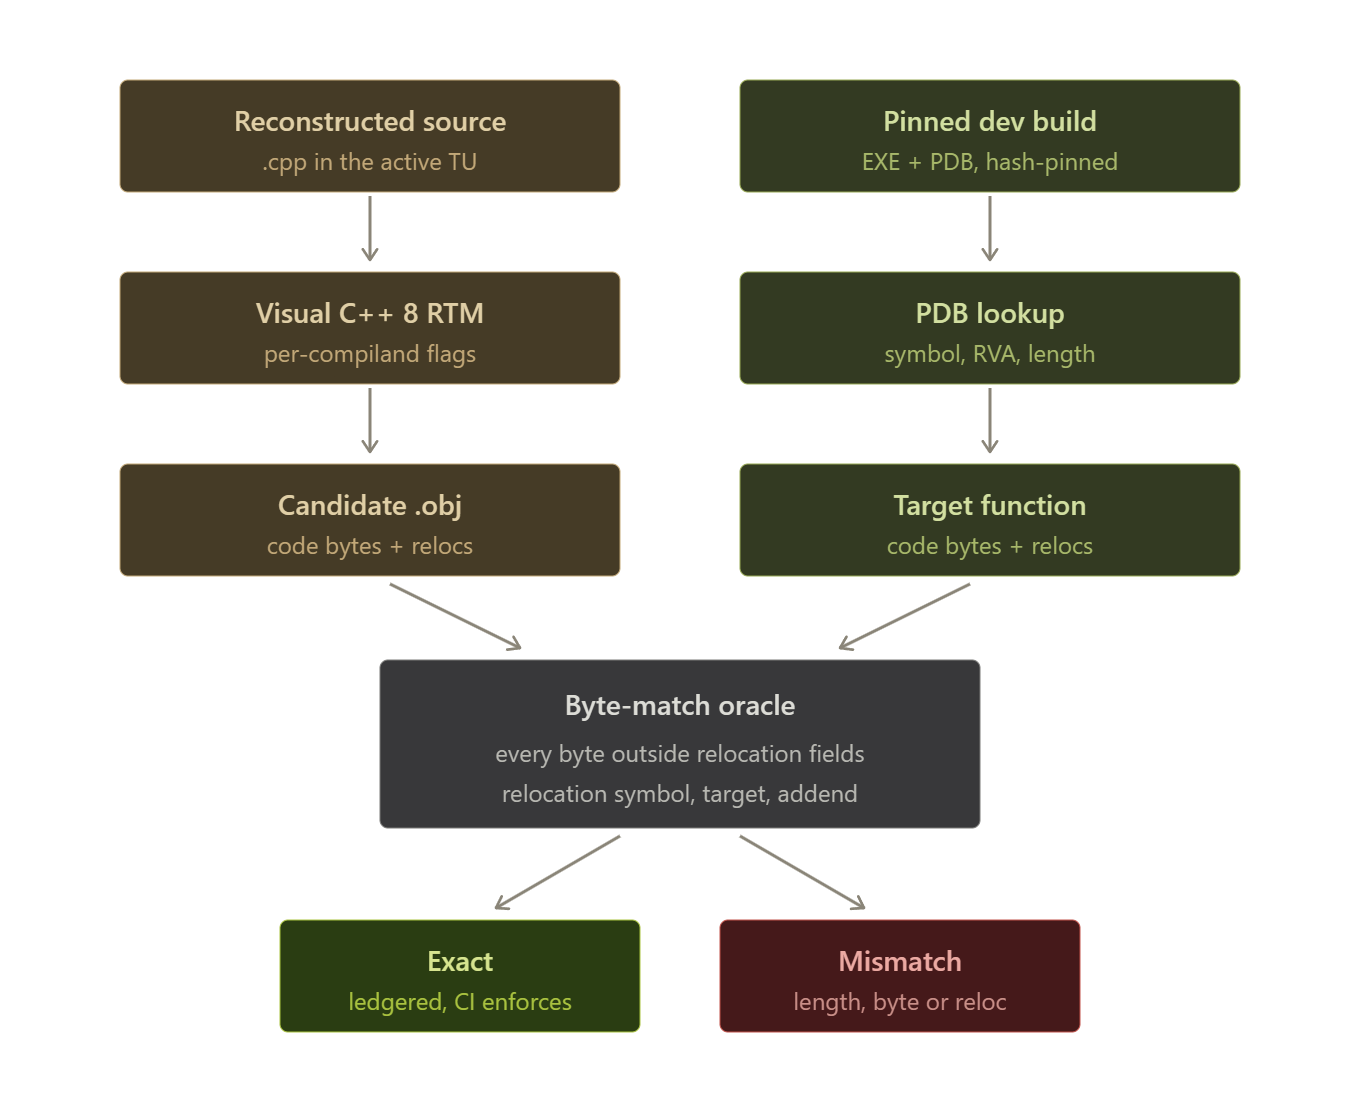 图:逐函数字节级匹配验证通过曲线。来源:Maurice 的博客
验收标准变硬后,便宜小模型跑出 83% 字节精确
字节级匹配推高了单函数的攻坚难度。现代编译器的寄存器分配非常敏感。内联决策与调用约定的微调,都会打乱最终的机器码。在特殊工况下,相同的源码输入甚至会吐出不同的编译结果。
但换来的工程红利相当扎实。只要函数通过了字节级比对,语义就与原版程序严格一致。当年的遗留缺陷也被完整复刻。机器基准的建立直接宣判了 reviewer agent 的多余,审查环节被大幅裁剪。
更加显著的变化发生在模型选型上。在缺乏硬性指标的自由生成阶段,Haiku 与 Luna 等廉价模型表现低劣。在拥有高频机器反馈的环境下,配合自动重试,小模型展现出了极高的交付效率。团队将后期集群扩容至 14 个 Luna 搭配 2 个 Opus 5.5,以低廉的模型单价完成了海量吞吐。
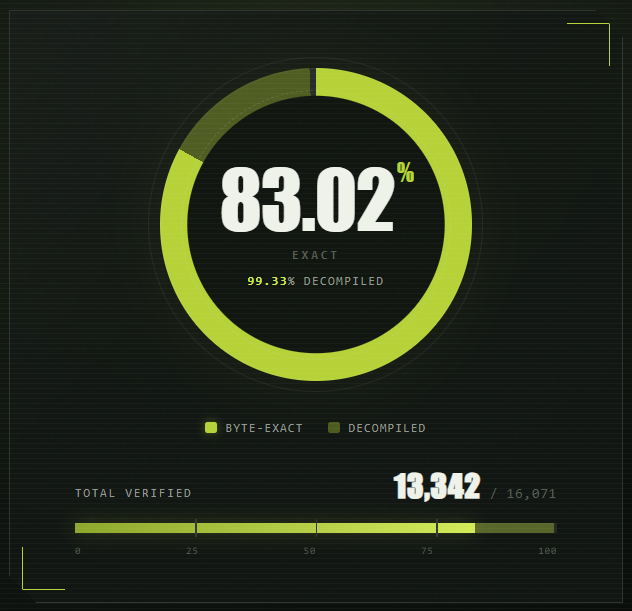 图:项目最终各模块重构完成度与字节匹配进度统计。来源:Maurice 的博客
上下文与通信治理:把调度收拢进机器流水线
在长达数月的运行中,治理多 agent 系统的协作熵增同样关键。反编译会话产生的大量输出属于易失信息。团队将默认 90% 的上下文压缩阈值下调至 42%。为了防止指令遗忘,系统编写了统一工程规范,通过每小时一次的定时任务重新注入。
通信架构也经历了剧烈精简。早期 agent 在 Discord 频道交流,并接收持续集成环境的实时报错。当节点扩展至 16 个实例后,消息泛滥迅速瘫痪了协作系统。团队随即切断多余会话,将网络通信限制在 issue 认领与构建状态上报两个维度。到了项目后期,人类工程师几乎不再与 agent 进行对话交互。
执行环境的安全性促使团队转向底层隔离。模型曾因执行畸形指令误清虚拟磁盘,作者扩展了自研模拟器 Sogen 构建轻量沙箱。而在技术之外,法律风险也如期而至。触碰商业游戏版权红线后,项目早期的技术博文被迫下架,全部重建源码也无法公开发布。
数千亿 token 的高昂试错,给当前的软件开发代理提供了清晰注脚。AI agent 大规模自主编码的真正瓶颈,始终在于正确性是否能够被机器低成本地自动化检验。缺乏编译器级别的刚性验收标准,再好看的代码也只是空架子。
当验证被浓缩为纯粹的机器比对时,廉价模型凭借算力穷举也能啃下复杂的工业软件。未来的工程演进,取决于自动化评测机制的深度。
参考链接:
- Maurice 个人技术博客:商业射击游戏逆向工程实录
- 自动化反编译与多 Agent 协同系统设计归档