2024 年底,「RAG 已死」的论调一度甚嚣尘上。很多开发者曾设想,把资料全量塞进提示词,就能省去复杂的检索架构。但真实生产环境给出了相反的反馈:输入数据越多,模型越容易偏离既定轨道。
2026 年 10 月,技术作者 Drew Breunig 在 AGNTCon 大会上复盘了这一年的技术转向。上下文工程的实质演进,是将上下文组装全面收归确定性代码。面对长程任务中暴露的新隐患,系统必须在长会话中建立起果断的遗忘机制。
百万窗口并没终结 RAG:大模型吞下全量数据反而更易迷失
Gemini 1.5 正式拉开窗口暴涨的大幕,百万 token 迅速成为行业标配。Meta 随后通过 Llama 4 Scout 抢先将千万级上下文推向开源社区,但这个窗口并没有换来相应的使用量——用 Breunig 的话说,此后再没等到下一个 Llama。
大窗口没有消灭检索,反而把系统的脆弱性暴露无遗。当海量文档一同涌入上下文,模型的注意力和召回精度显著衰退。把所有原材料倾倒给模型自行甄别的假设,在真实业务中迅速失效。长上下文是一项底层能力,但它绝非开箱即用的万灵药。
长程任务对算力资源的消耗随着上下文延伸呈非线性放大。每一次工具调用都要反复重读历史 token,带来高昂的时延与显存占用。缺乏前置过滤的暴力填充,让工业级流水线面临严重的成本失控。工程架构必须重掌信息过滤的阀门。
从执着找茶到负例污染:早期系统暴露出四类工程暗坑
面对长上下文的失控风险,Breunig 在 2025 年总结出四种经典失效模式。这四类问题分别是上下文投毒、上下文分心、上下文混淆以及上下文冲突。系统一旦踩中其中任何一个暗坑,输出逻辑便会偏离预期。
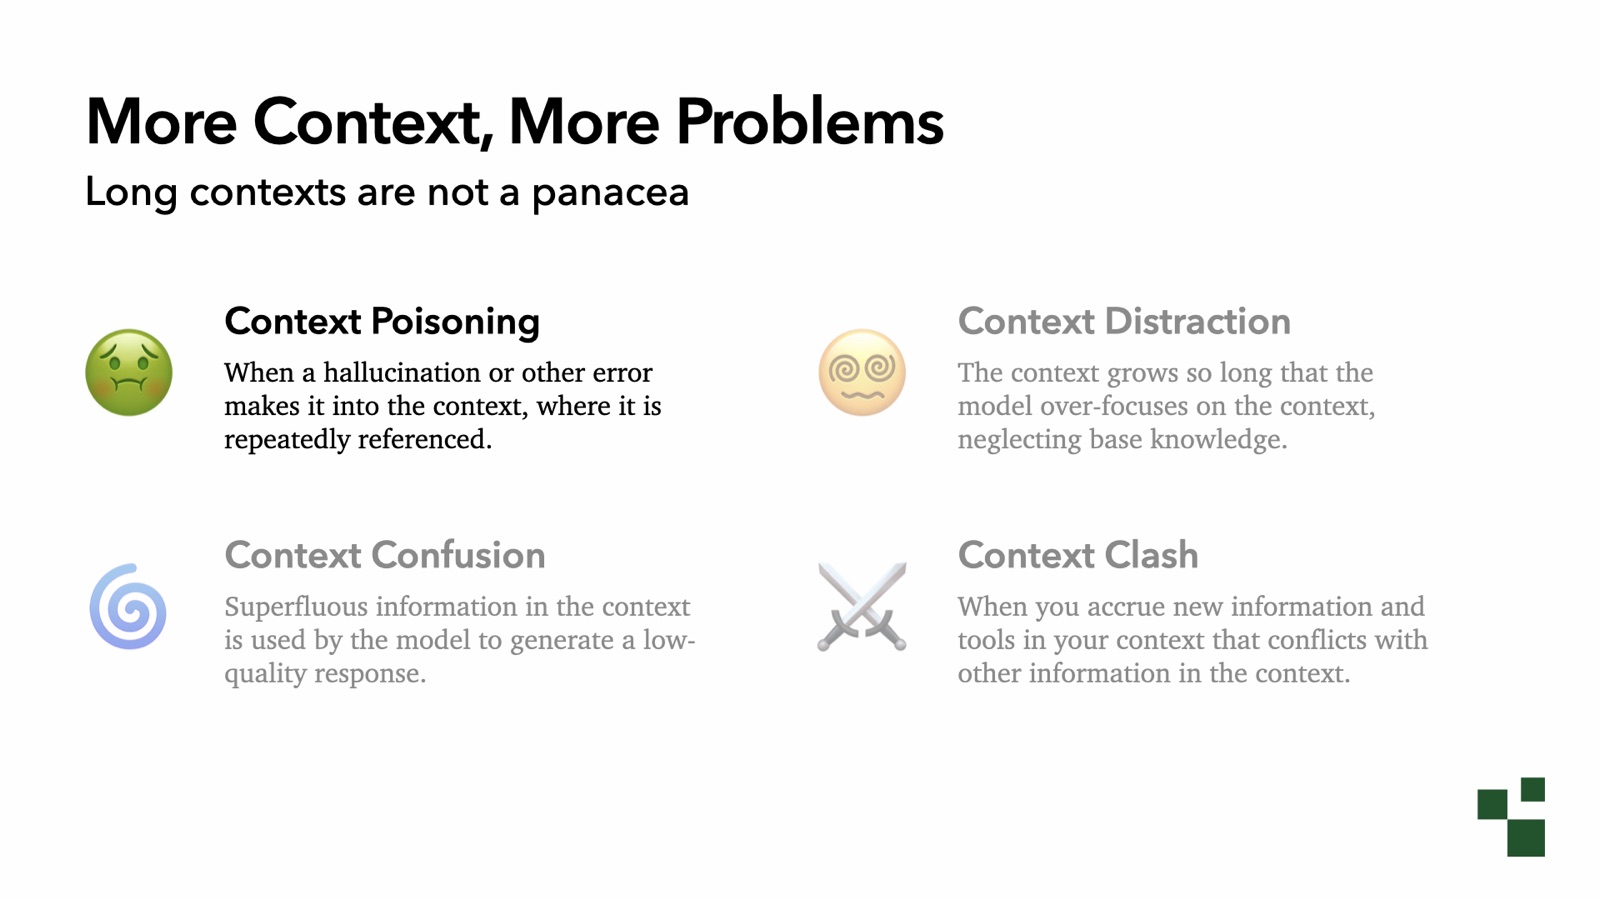 图:长上下文带来的四种经典失效模式:投毒、分心、混淆与冲突。来源:Drew Breunig 演讲幻灯片《More Context, More Problems》
上下文投毒的典型样本记录在 Google DeepMind 的技术报告中。在初代《宝可梦 红》中,玩家需要使用柠檬水贿赂守卫。而在复刻版《火红》中,通关道具被调整为茶。Gemini 2.5 Pro 自主运行游戏时被先验触发,坚信自己必须拿到茶。
模型把找茶写进了待办清单,随后在游戏中耗费数小时四处搜寻。错误假设一旦写入历史,模型便再也无法绕过该目标。附录记录了更冷酷的事实。上下文超过 10 万 token 后,智能体开始机械重复历史动作,失去规划新路径的能力。
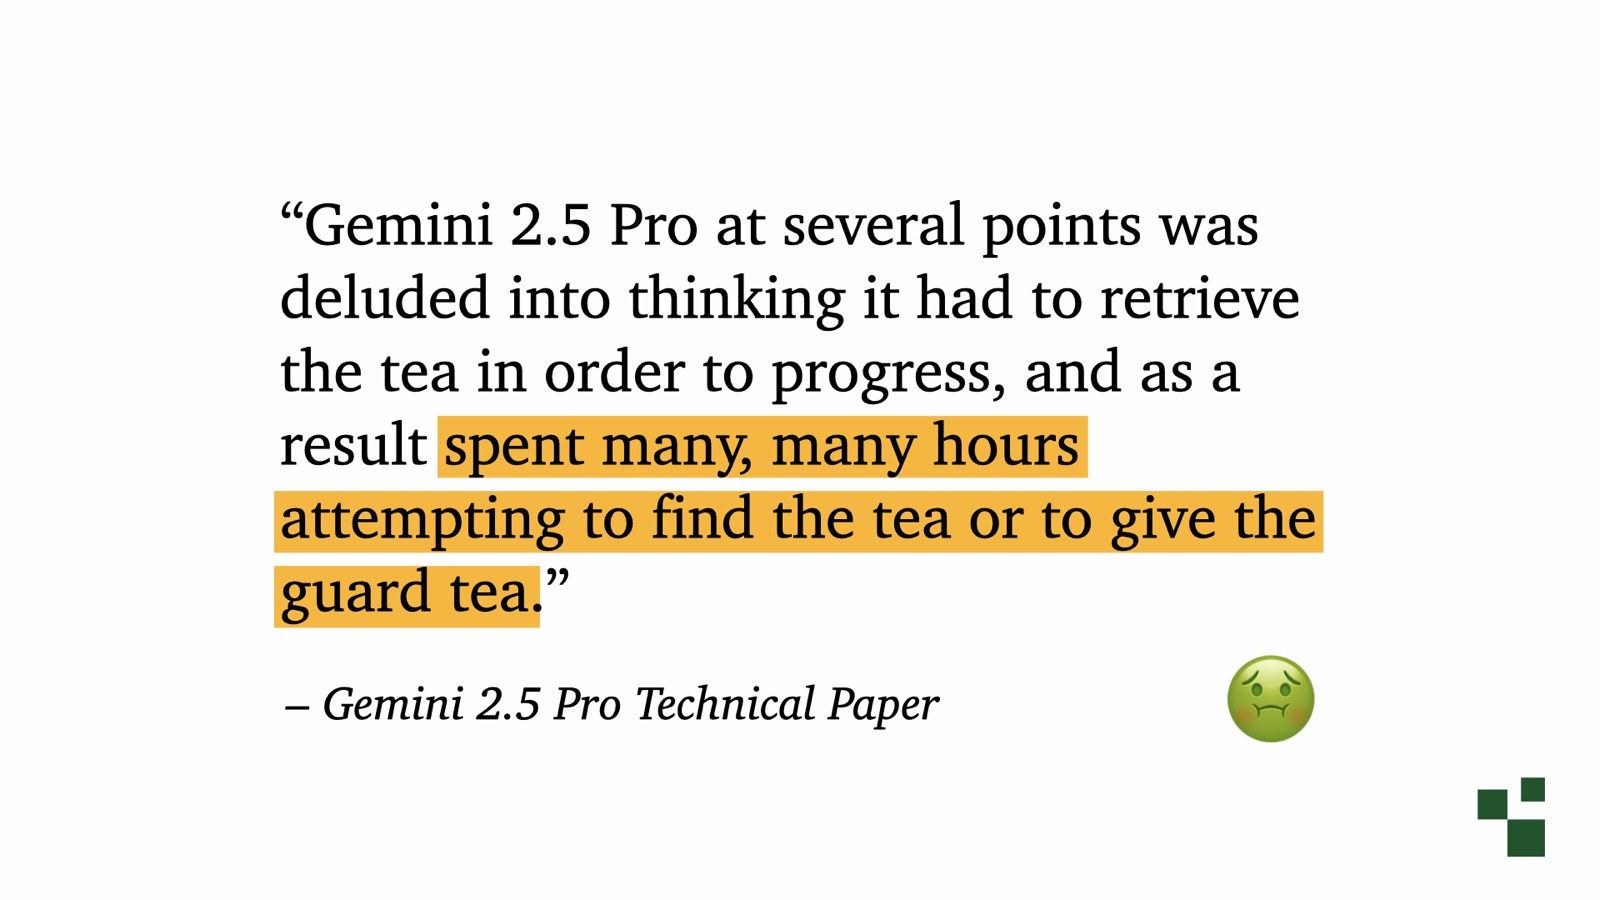 图:Gemini 2.5 Pro 在游戏中受先验知识误导而执着寻找茶,暴露出上下文投毒症状。来源:Google DeepMind 技术报告,经 Drew Breunig 引用
上下文分心则由 Carolina Camassa 与 Derek Shiller 的论文清晰证实。研究者要求模型将提问翻译为俄语,却在上下文中掺入 1 到 50 个法语反例。测试结果显示,Gemma 3 12B 面对几个反例时遵循率就骤降至一半以下。前沿的 Opus 4.6 同样会在反例堆积后大幅衰退。
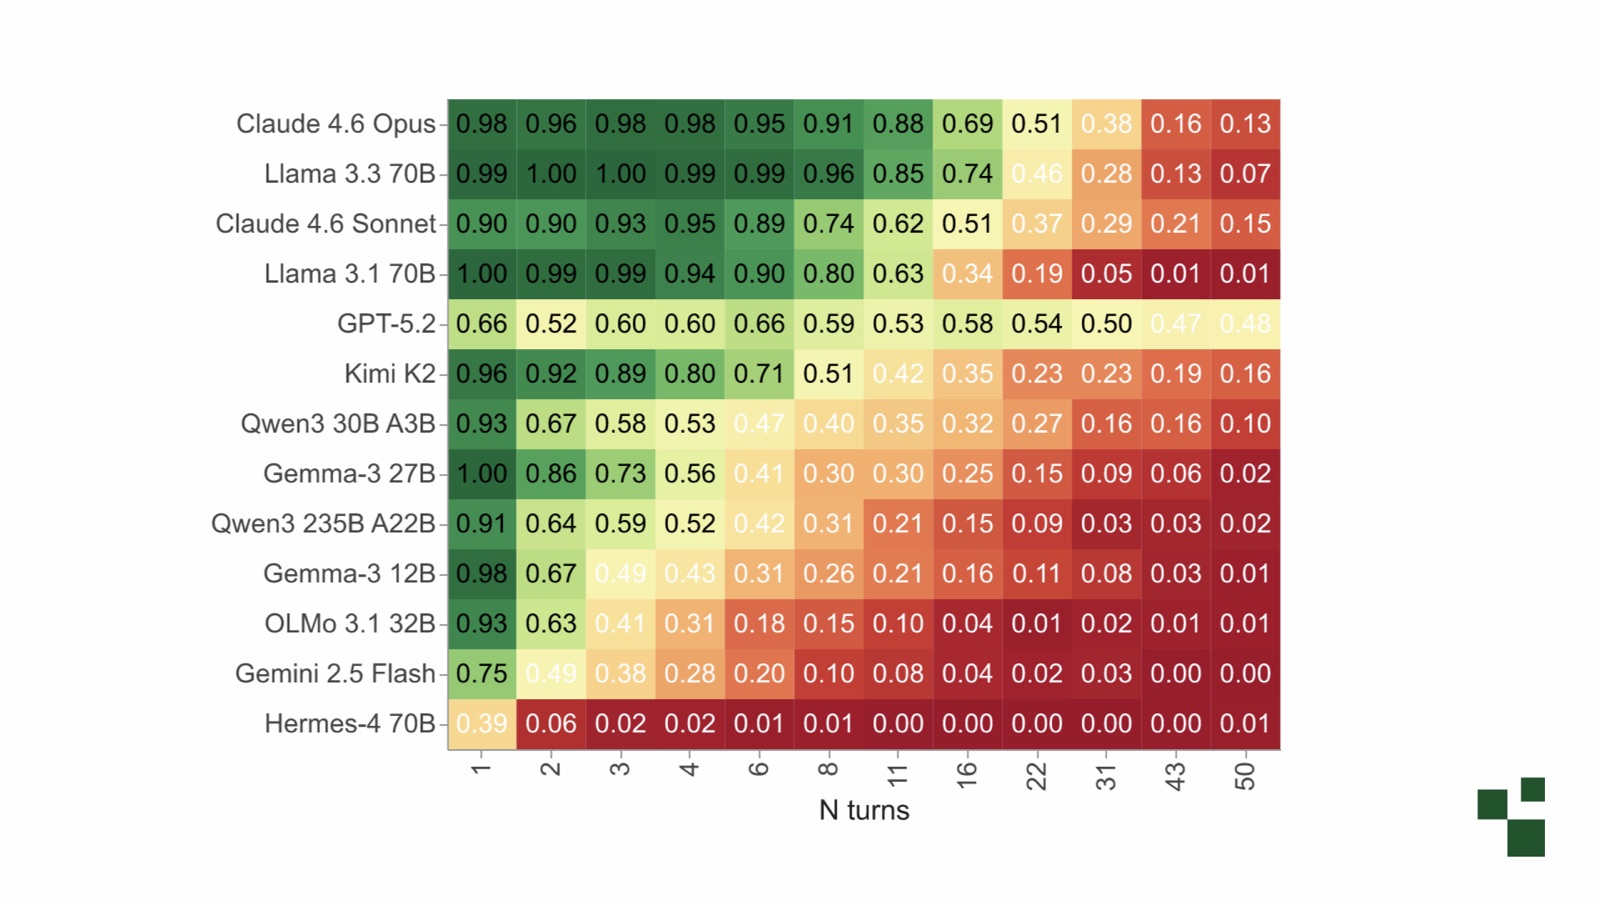 图:随着上下文内反例数量递增,各类前沿模型对原始系统指令的遵循率持续走低。来源:Camassa & Shiller 论文,经 Drew Breunig 引用
这项实验揭示了编码智能体日常开发中的致命诱因。工程师为了排查前端样式,来回尝试并喂给模型十几次失败的 CSS 代码片段。这些调试残留正是开发者亲手灌入的错误示例,直接击穿了模型的系统级指令。
上下文混淆与冲突同样频繁发生。模型会对用户画像擅自臆测。Breunig 为此专门关闭了商用模型的记忆功能,防止生活琐事污染技术探讨。在宿主框架中不加节制地载入各类工具,接口定义的冲突也会直接瘫痪决策链路。
16 行代码收拢控制权:用确定性函数重构上下文装配
行业术语在三年间经历了持续演变。2023 年行业聚焦于提示工程,2025 年转向上下文工程,2026 年则收敛为 harness 工程。概念外壳虽然不断轮替,背后的工程重心始终高度一致。核心工作就是把上下文装配的权力,从概率性模型调用收回确定性代码。
应对上下文膨胀的武器库在过去六年里保持着稳定。系统治理依托六项经典机制:增补、装载、隔离、剪枝、外置与摘要。它们分别承担着定向召回、接口收缩、独立执行、冗余剔除、持久化与历史压缩的职责。
接口暴露过宽是导致系统崩盘的常见诱因。某企业软件曾默认在启动时加载 600 个扩展技能,导致智能体面对海量定义陷入瘫痪。开发团队在代码中加入一个过滤函数,按需截取工具子集,系统随即恢复正常。
基于 DSPy 框架搭建的运行架构,清晰展现了这种控制权的转移。整个智能体的核心不过是一个常规的 while 循环,外加 ReAct 决策模块。主线由前沿大模型驱动,节点上的工具筛选与裁剪则交给小参数决策模型高效完成。
隔离机制表现为派生全新会话的子智能体,剪枝逻辑负责逐轮剔除无用字段。把增补、装载、剪枝与压缩全部接入主流程,核心改动仅需约 16 行代码。确定性控制流不仅压低了 token 开销,更保障了系统提示词的缓存命中率。
提示词连打七次大写背后:模型在对抗权重,长任务困于惯性
迈入 2026 年后,长时间运转的智能体遭遇了两种全新的失效模式。其中之一是对抗权重,另一项则是更为普遍的上下文惯性。这两类深层缺陷的出现,证明传统的提示词调优手段已经逼近上限。
对抗权重源于基础模型训练阶段形成的强烈行为偏置。轻量模型通过 Playwright MCP 一类工具调用浏览器时,第一次执行常常失败,需要自我纠正才能走通——因为它训练时见过的工具长得不一样。
提示词中频繁出现的重复强调与全大写字母,正是对抗权重的典型体征。在 Claude Code 系统提示词中,「独立时并行发起工具调用」连续重复了七次。其他位置还分别强调了四次、三次与两次。模型权重习惯于串行调用工具,外部提示词不得不依靠高密度灌输来扭转这种内部偏置。
上下文惯性则对长程自主任务构成了更严峻的考验。当智能体陷入局部瓶颈时,历史中的错误假设会把模型死死锚定在死胡同里。伯克利与微软研究院在同期论文中,不约而同指出了这种执念带来的负面效应。
微软在《Fork-and-Flush》研究中绘制的科研曲线呈现出阶梯状停滞。实验推进到中后程时,智能体的修改动作越来越琐碎,已被历史上下文中的初始假设牢牢绑架。强化学习中灌输的专注与执着特质,在多轮探索任务中反而化作了自我锁死的枷锁。
解开这种死结的工程手段出奇地干脆直接。Anthropic 在长期测试中发现,最有效的干预是每隔 90 分钟重置一次上下文。系统保留外部文件系统与代码产物,将对话历史全量抹除,逼迫模型重新审视全局环境。
伯克利论文《Scaling Discovery Requires Forgetting》得出了高度一致的结论。实验表明,在流水线中定期引入遗忘机制,模型的研发性能曲线才能迎来持续跃升。开发者抱怨智能体变迟钝时,上下文往往已达 80 万 token。Breunig 将警戒线设在 20 万 token,超过该体量就应主动丢弃历史。
支撑 12 小时长程运转:系统要在恰当时机丢掉对话历史
行业评估智能体能力的时间尺度正在发生跃迁。在 METR 基准下,GPT-5 支撑 3.4 小时连续任务,Gemini 3.1 提升至 6.4 小时。Opus 4.6 更是摸到了 12 小时门槛。随着自主任务迈向跨日集群协作,上下文管理将直面更加严苛的真实考验。
长程个人智能体的持久运行已经暴露出了记忆腐烂的苗头。Breunig 追踪运行六个月的 Hermes 智能体,发现自主生成的技能库并没有随时间优化。修补代码互相冲突,通用逻辑被反复重写,记忆系统的熵增让执行效率持续劣化。
无节制累积历史信息会把决策网络拖向自我坍塌。系统需要建立策略性遗忘机制。学会在恰当的节点擦除失效信息,是当下长程智能体尚未攻克的核心工程命题。
大语言模型的输出逻辑可以简化为上下文与内部权重的乘积。面对工程挑战,团队既可以等待更大规模的基础模型,也可以打磨上下文流转体系。后者的迭代成本低一个数量级,也是工程团队最能掌控的变量。
上下文工程演进至此,早已告别了盲目追求超长窗口的蛮荒阶段。优秀架构拒绝把赌注全押在模型推演上,必须用确定性代码筑牢执行边界。懂得在何时接管装配并敢于清空历史,是支撑长程任务的底气所在。
参考链接:
- Drew Breunig 博客与 AGNTCon 演讲:The State of Context Engineering
- Google DeepMind 技术报告:Gemini 2.5 Pro
- Carolina Camassa & Derek Shiller 论文:Do as I Say, Not as I Do
- 微软研究院论文:Fork-and-Flush
- 加州大学伯克利分校论文:Scaling Discovery Requires Forgetting