A finales de 2024, el mantra «RAG ha muerto» resonaba con fuerza en la comunidad de desarrolladores. Se extendió la idea de que bastaba con meter bases de código enteras y montañas de documentación en la ventana del prompt para prescindir de complejas arquitecturas de recuperación. Sin embargo, los entornos reales de producción pronto dieron un baño de realidad: cuantos más datos en bruto se introducen en el modelo, con mayor facilidad pierde el rumbo.
En octubre de 2026, el divulgador técnico Drew Breunig resumió este giro radical durante la conferencia AGNTCon. La verdadera maduración de la ingeniería de contexto no consistió en ampliar la capacidad, sino en devolver el ensamblaje de la información a manos del código determinista. Y ante las sutiles trampas que surgen en ejecuciones prolongadas, los sistemas deben incorporar mecanismos programados y contundentes de olvido.
Las ventanas millonarias no acabaron con RAG: saturar el modelo invita al extravío
Gemini 1.5 inauguró la carrera por las ventanas gigantescas, y el millón de tokens se convirtió rápidamente en el estándar de la industria. Poco después, Meta subió la apuesta en el ecosistema abierto con Llama 4 Scout y sus decenas de millones de tokens. Sin embargo, semejante capacidad nunca se tradujo en una adopción proporcional en producción; como señaló Breunig, la comunidad pasó meses esperando un sucesor que jamás llegó.
Tener ventanas descomunales no eliminó la necesidad de buscar y filtrar; al revés, dejó al descubierto la fragilidad del enfoque por fuerza bruta. Cuando se vierten toneladas de documentos sin depurar en el contexto, la atención del modelo se dispersa y la precisión en la recuperación se desploma. La premisa de que un modelo fundacional puede separar por sí solo el grano de la paja saltó por los aires en escenarios empresariales. El contexto largo es una capacidad formidable a bajo nivel, pero dista mucho de ser una panacea lista para usar.
Por si fuera poco, el consumo de cómputo en tareas autónomas de larga duración crece de forma no lineal. Cada llamada a una herramienta obliga a releer un historial de tokens cada vez más gigantesco, disparando la latencia y la memoria VRAM. Rellenar prompts sin filtros previos desboca los costes de infraestructura. El arnés de software debía recuperar urgentemente el control sobre el flujo de información.
De la obsesión por el té al envenenamiento por contraejemplos: cuatro trampas clásicas
Frente al descontrol de los contextos masivos, Breunig identificó en 2025 cuatro modos clásicos de fallo: envenenamiento (Poisoning), distracción (Distraction), confusión (Confusion) y conflicto (Clash). En cuanto un sistema cae en alguna de estas trampas, la coherencia de sus deducciones se desmorona.
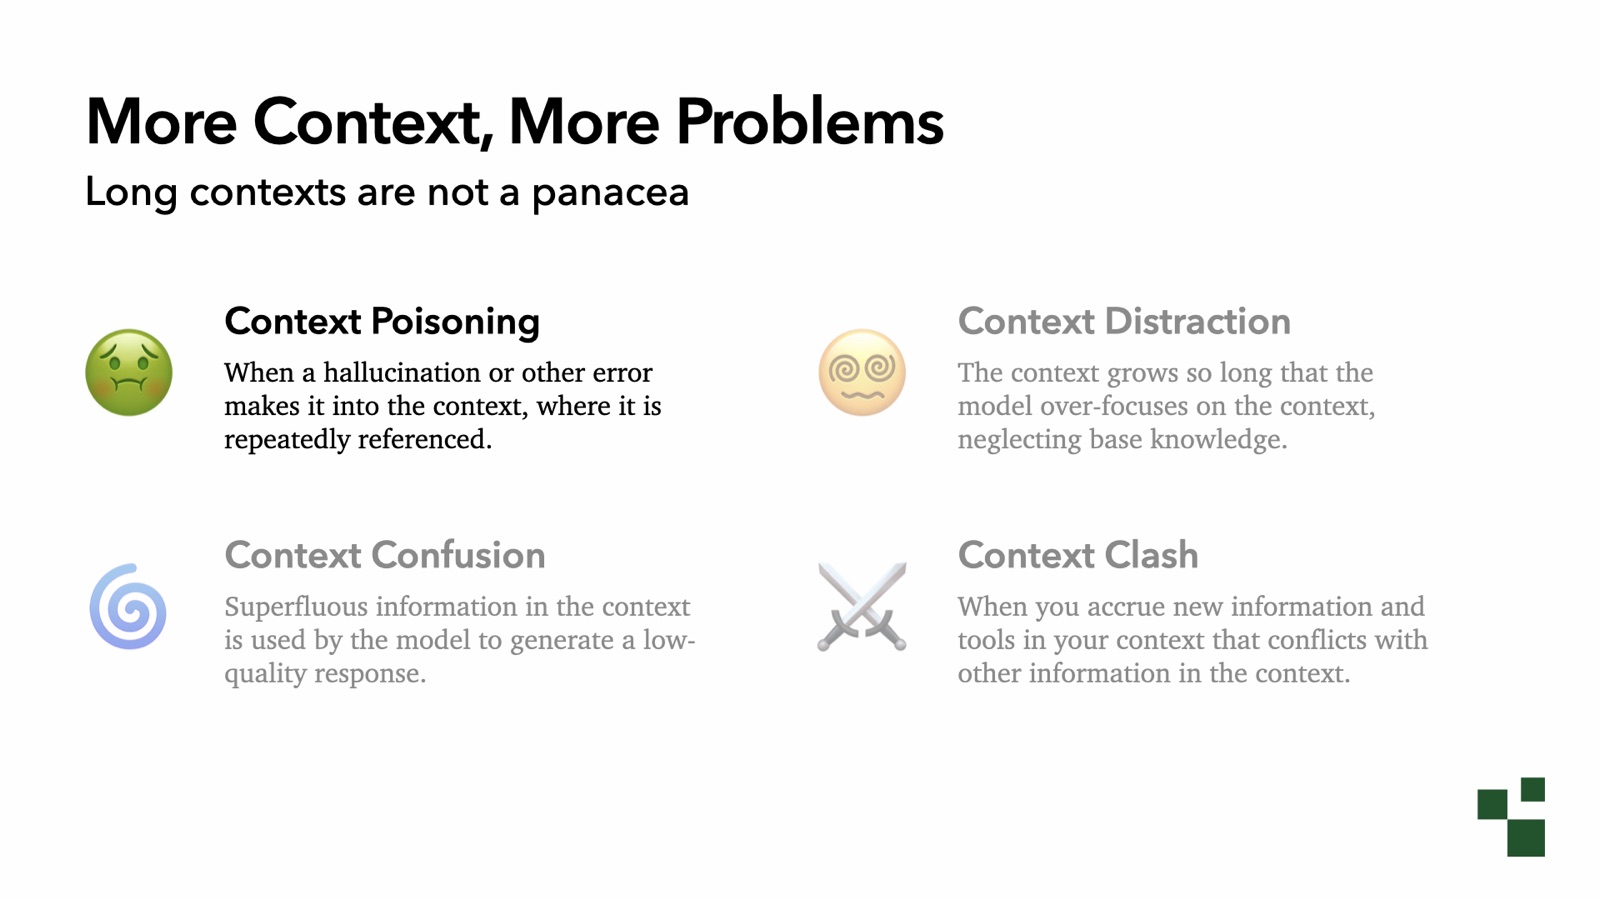 Figura: Los cuatro modos de fallo clásicos en contextos masivos: envenenamiento, distracción, confusión y conflicto. Fuente: Presentación de Drew Breunig «More Context, More Problems»
Un ejemplo paradigmático de envenenamiento de contexto quedó registrado en un informe técnico de Google DeepMind. En el juego original Pokémon Rojo, el jugador soborna a un guardia con limonada; en la reedición Rojo Fuego, el objeto necesario se sustituyó por té. Cuando Gemini 2.5 Pro jugó de manera autónoma, un sesgo de conocimiento previo se activó y el modelo quedó convencido de que su única meta era conseguir té.
El modelo anotó «buscar té» en su lista de tareas y pasó horas vagando sin rumbo por el mapa. Una vez que una hipótesis errónea queda grabada en el historial, el modelo es incapaz de ignorarla. El apéndice del informe recogía un dato aún más revelador: al superar los 100.000 tokens de contexto, el agente comenzó a repetir mecánicamente acciones pasadas, perdiendo por completo la capacidad de planificar nuevas rutas.
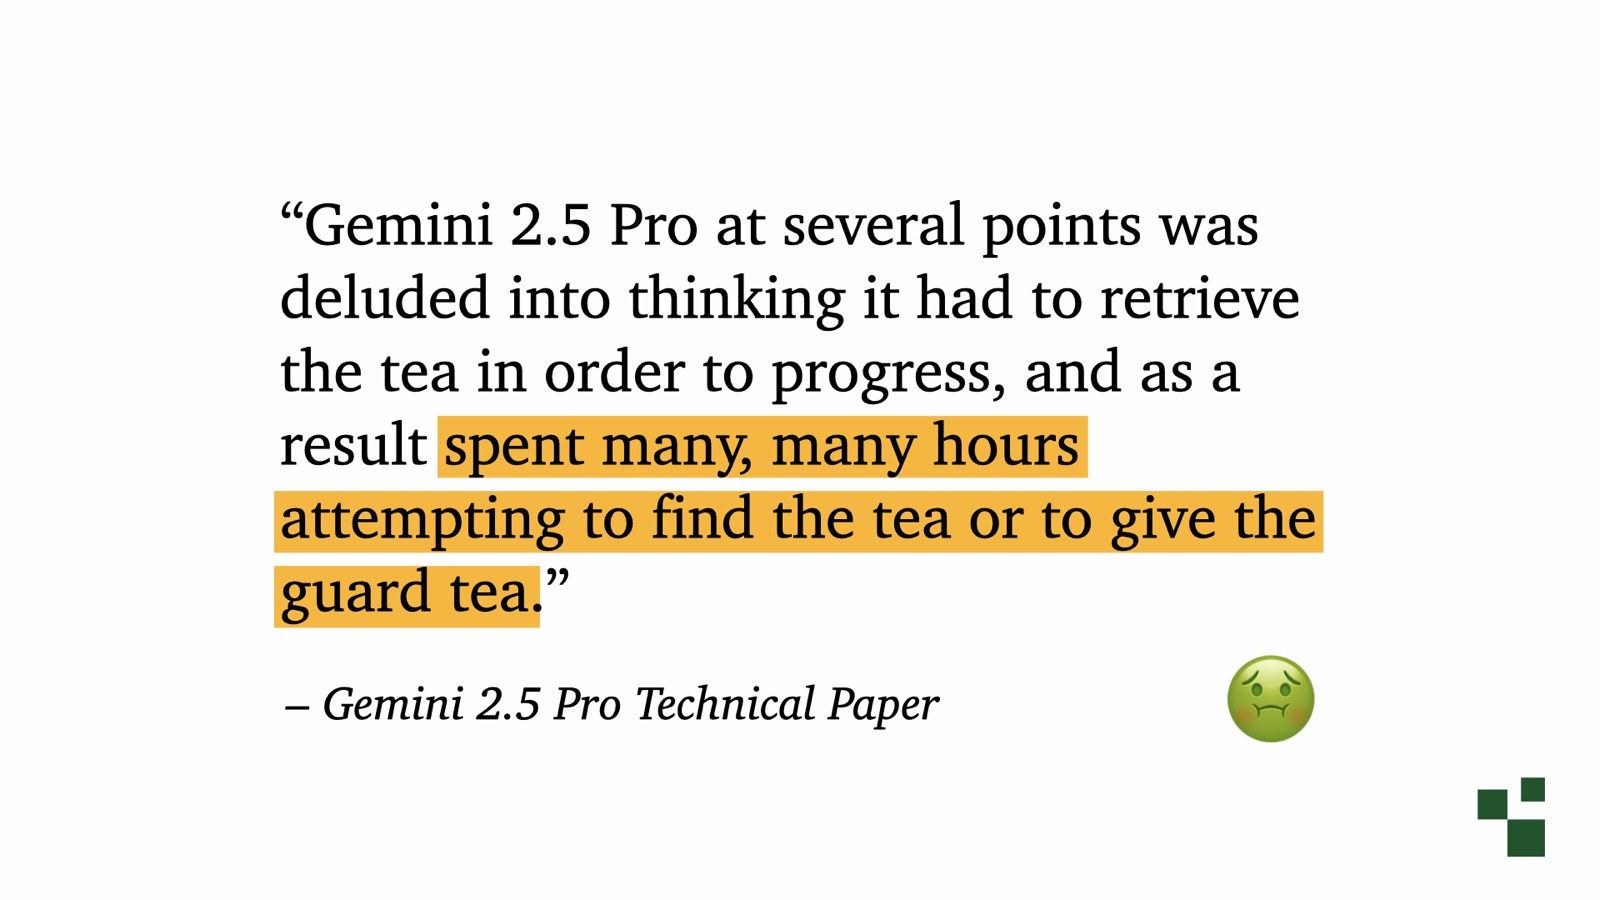 Figura: Gemini 2.5 Pro buscando té de forma obstinada por un sesgo previo, ilustrando el envenenamiento de contexto. Fuente: Informe técnico de Google DeepMind, citado por Drew Breunig
Por su parte, la distracción de contexto fue demostrada con rigor por Carolina Camassa y Derek Shiller en su investigación Do as I Say, Not as I Do. Los investigadores pidieron a varios modelos que tradujeran entradas al ruso, pero intercalaron en el contexto entre 1 y 50 contraejemplos en francés. Los resultados mostraron que Gemma 3 12B reducía su tasa de seguimiento de instrucciones a menos de la mitad con solo ver unos pocos ejemplos erróneos. Incluso modelos punteros como Opus 4.6 sufrían un deterioro notable a medida que se acumulaban los contraejemplos.
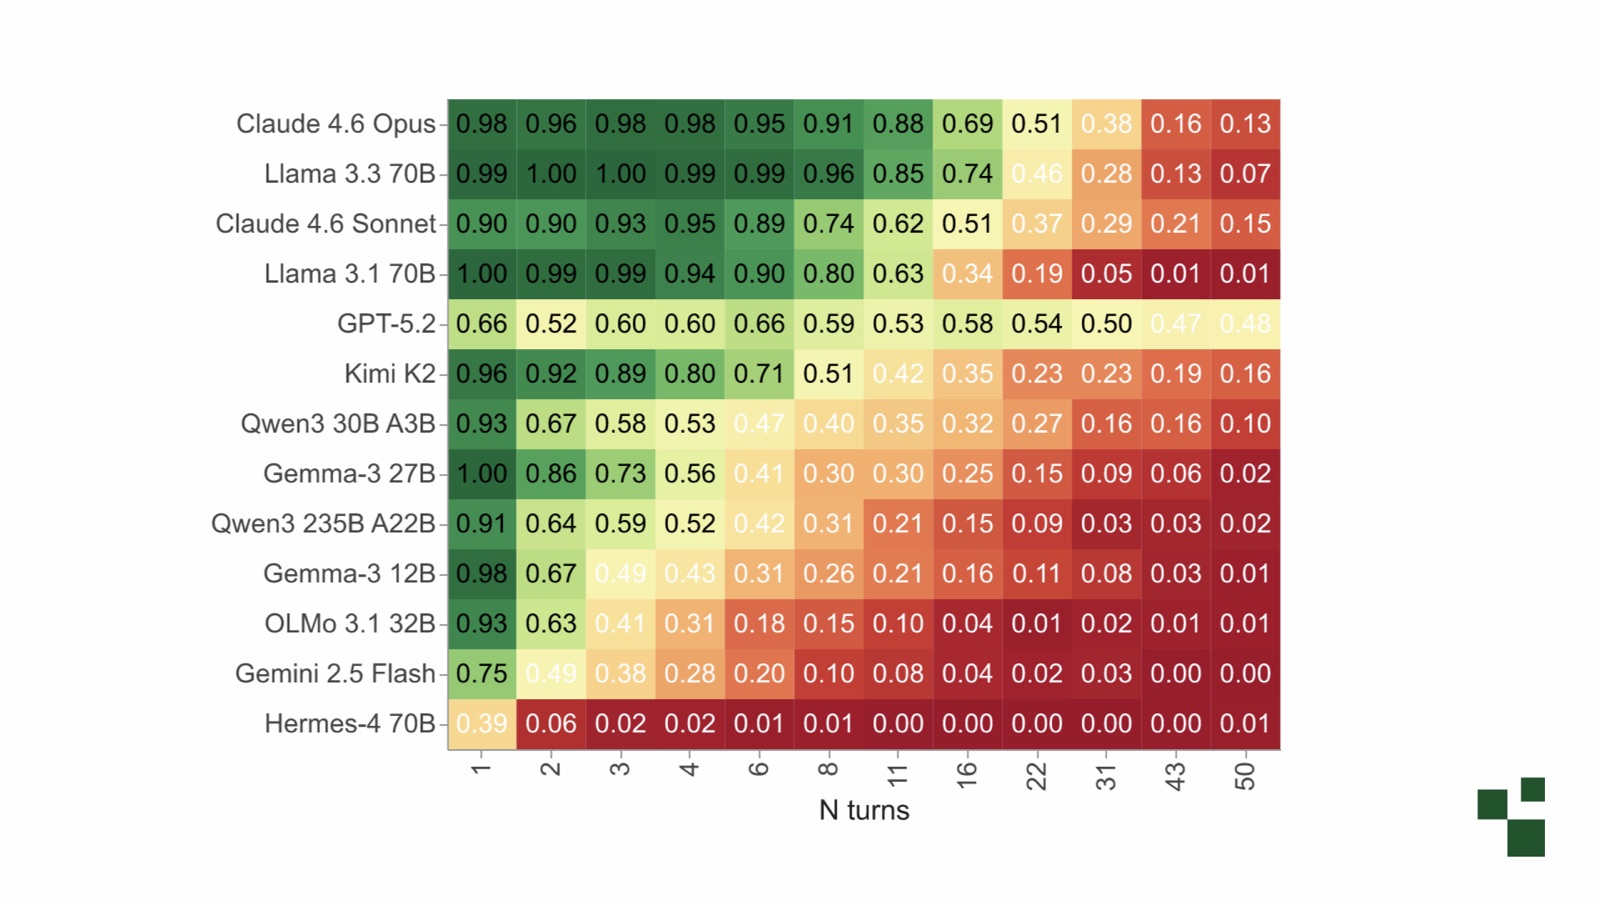 Figura: A medida que aumentan los contraejemplos en el contexto, el seguimiento de las instrucciones del sistema decae de forma constante. Fuente: Camassa & Shiller, citado por Drew Breunig
Este experimento refleja un error letal muy común en el desarrollo con agentes de programación. Al depurar estilos web, un ingeniero puede probar decenas de veces y reenviar al modelo fragmentos de CSS fallidos. Esos restos del depurado no son más que contraejemplos introducidos manualmente por el desarrollador, los cuales dinamitan la adherencia del modelo a sus instrucciones de sistema.
La confusión y los conflictos de contexto son igualmente habituales. Los modelos extrapolan conjeturas infundadas a partir de fragmentos del perfil del usuario. Por eso, Breunig desactivó por completo las funciones de memoria en modelos comerciales, impidiendo que anécdotas cotidianas contaminen el análisis técnico. Asimismo, cargar cientos de herramientas sin criterio en el entorno del agente provoca colisiones en la definición de interfaces que paralizan la toma de decisiones.
Retomar el control en 16 líneas: reconstruir el ensamblaje con lógica determinista
La terminología ha evolucionado con rapidez en los últimos tres años: de la ingeniería de prompts en 2023 pasamos a la ingeniería de contexto en 2025, y en 2026 nos centramos en la ingeniería de arneses (harness engineering). Aunque los términos cambien, el núcleo técnico es invariable: arrebatar el ensamblaje del contexto a las llamadas probabilísticas del modelo para devolverlo al código determinista.
El arsenal de patrones para domar el desbordamiento de contexto se ha mantenido estable durante seis años, apoyado en seis mecanismos fundamentales: aumentar (Augment), cargar (Load), aislar (Isolate), podar (Prune), descargar (Offload) y resumir (Summarize). Estos se corresponden, respectivamente, con la recuperación selectiva, la reducción de esquemas, la ejecución aislada, la eliminación de redundancias, la persistencia externa y la compresión semántica.
Exponer interfaces demasiado amplias suele desencadenar el colapso del sistema. Una plataforma empresarial cargaba por defecto 600 definiciones de herramientas al arrancar, colapsando de inmediato al agente. Bastó con que el equipo añadiera una función de filtrado en el código para cargar solo las herramientas necesarias bajo demanda, y el sistema recuperó al instante su estabilidad.
Las arquitecturas construidas sobre el framework DSPy ilustran con claridad este traspaso de control. El bucle central de un agente no es más que un bucle while convencional acoplado a un módulo de decisión ReAct. La línea principal de razonamiento la ejecuta un gran modelo de vanguardia, mientras que la selección y poda de herramientas se delegan con rapidez en modelos ligeros y especializados.
El aislamiento crea subagentes en sesiones limpias para subtareas concretas, y la poda elimina campos JSON superfluos en cada turno. Integrar el aumento, la carga dinámica, la poda y el resumen en el bucle principal requiere apenas unas 16 líneas de código. Este flujo de control determinista no solo desploma el gasto de tokens, sino que dispara la tasa de acierto de la caché en las instrucciones de sistema.
Mayúsculas reiteradas en el prompt: pesos adversarios e inercia de contexto
Al adentrarnos en 2026, los agentes autónomos de larga duración toparon con dos nuevos modos de fallo: los pesos adversarios (Adversarial Weights) y la inercia de contexto (Context Inertia). Estos problemas estructurales evidencian que el ajuste mediante prompts ha tocado techo.
Los pesos adversarios derivan de sesgos de comportamiento fuertemente arraigados durante el preentrenamiento del modelo. Cuando un modelo ligero intenta manejar un navegador a través de herramientas MCP como Playwright, su primera llamada suele fallar y precisa autocorrección, sencillamente porque la interfaz difiere de las APIs que vio durante su entrenamiento.
El síntoma más visible de la lucha contra estos sesgos es el uso de mayúsculas continuas y advertencias reiteradas en los prompts. En las instrucciones de Claude Code, la orden de «ejecutar llamadas independientes a herramientas en paralelo» se repite hasta siete veces consecutivas en mayúsculas, además de insistir en otros puntos cuatro, tres y dos veces. Como los pesos del modelo tienden por naturaleza a llamar herramientas en serie, el prompt externo se ve obligado a machacar la instrucción para torcer esa inercia interna.
Por su parte, la inercia de contexto representa un reto todavía más severo en tareas autónomas complejas. Cuando un agente se bloquea en un problema local, las hipótesis fallidas acumuladas en el historial actúan como anclas, dejándolo atrapado en un callejón sin salida. Estudios simultáneos de la Universidad de Berkeley y Microsoft Research coincidieron en alertar sobre este perjudicial encasillamiento.
En el artículo Fork-and-Flush de Microsoft Research, las curvas de rendimiento de los agentes mostraban mesetas escalonadas. En fases intermedias o avanzadas, las modificaciones del agente se volvían insignificantes y redundantes, completamente secuestradas por las suposiciones iniciales del contexto. La constancia y perseverancia inculcadas mediante aprendizaje por refuerzo se transforman, en exploraciones complejas, en una trampa que bloquea al modelo.
La solución de ingeniería resulta sorprendentemente tajante. En sus pruebas prolongadas, Anthropic descubrió que la intervención más eficaz consistía en vaciar el contexto por completo cada 90 minutos. El sistema conserva los archivos y el código generado, pero borra todo el historial de conversación, obligando al modelo a mirar el entorno con ojos nuevos.
La investigación de Berkeley Scaling Discovery Requires Forgetting llegó a la misma conclusión: incorporar mecanismos programados de olvido es indispensable para que las curvas de rendimiento sigan ascendiendo. Cuando los desarrolladores se quejan de que el agente se ha vuelto torpe, el contexto suele rozar ya los 800.000 tokens. Breunig sitúa la barrera de seguridad en 200.000 tokens; superado ese umbral, el historial debe purgarse de forma proactiva.
Sostener 12 horas de ejecución: la valentía de desechar el historial
La escala temporal con la que medimos a los agentes autónomos se está dilatando a pasos agigantados. En las pruebas del benchmark METR, GPT-5 soportó 3,4 horas de tarea continua, Gemini 3.1 subió hasta las 6,4 horas y Opus 4.6 alcanzó la cota de las 12 horas. A medida que las tareas autónomas se orientan a colaboraciones de varios días entre enjambres de agentes, la gestión del contexto se enfrenta a su prueba de fuego.
Los agentes personales que se ejecutan sin interrupción ya muestran los primeros síntomas de «pudrición de memoria» (Memory Rot). Al analizar un agente Hermes funcionando durante seis meses seguidos, Breunig comprobó que la biblioteca de habilidades que generaba no mejoraba con el tiempo. El código improvisado entraba en conflicto consigo mismo, las funciones comunes se reescribían una y otra vez y la entropía de la memoria degradaba sin cesar la eficiencia.
Acumular información histórica sin mesura aboca a la red de decisiones al colapso. Los sistemas necesitan un olvido estratégico. Saber purgar datos obsoletos en el momento justo es el gran desafío pendiente de la autonomía a largo plazo.
La salida de un modelo de lenguaje puede entenderse como el producto de su contexto por sus pesos internos. Ante las dificultades de ingeniería, los equipos pueden esperar a que llegue el próximo gran modelo o pulir a fondo sus conductos de contexto. Esta segunda vía cuesta un orden de magnitud menos y representa la única palanca que los desarrolladores controlan por completo.
La ingeniería de contexto ha superado su fase ingenua de perseguir ventanas infinitas a toda costa. Las arquitecturas sólidas no se la juegan todo a las deducciones probabilísticas del modelo; levantan barreras firmes mediante código determinista. Saber cuándo tomar las riendas del ensamblaje y atreverse a vaciar el historial es lo que mantiene en pie las ejecuciones autónomas más exigentes.
Enlaces de referencia:
- Blog de Drew Breunig y ponencia en AGNTCon: The State of Context Engineering
- Informe técnico de Google DeepMind: Gemini 2.5 Pro
- Investigación de Carolina Camassa y Derek Shiller: Do as I Say, Not as I Do
- Artículo de Microsoft Research: Fork-and-Flush
- Artículo de la Universidad de California en Berkeley: Scaling Discovery Requires Forgetting