En tan solo cuatro meses, el precio unitario de los grandes modelos de lenguaje se ha desplomado un 80 %, y sin embargo, el gasto total de las empresas en cómputo no deja de crecer. Una vez eliminada la barrera económica de entrada, los asistentes de programación basados en agentes ejecutan miles de ciclos autónomos en cuestión de minutos. La inferencia se ha convertido en un insumo de consumo masivo: cuanto más baja el coste unitario, más se dispara el volumen total demandado por los sistemas.
La estructura económica subyacente ha despojado a los modelos de frontera de su margen de exclusividad. En el desarrollo de agentes autónomos, más del 96 % de los costes de ejecución se concentran en la lectura de la caché de contexto (prompt caching). Con 29 plataformas independientes compitiendo globalmente por cada llamada y un cambio de proveedor que solo requiere modificar una línea de configuración, los líderes de los modelos propietarios han visto cómo se cerraba definitivamente la puerta a subir precios para rentabilizar sus enormes inversiones.
Cuatro rebajas en cuatro meses: dos gigantes desatan la guerra de precios
Entre junio y septiembre de 2026, OpenAI y Anthropic redujeron los precios de sus modelos de referencia en un 80 %. Desde fuera, muchos interpretaron esta batalla tarifaria como la clásica subvención inicial de plataforma para captar cuota de mercado, asumiendo que los gigantes volverían a subir tarifas tras asfixiar a sus rivales. La realidad contable del hardware demostró exactamente lo contrario: ninguno de los dos líderes disponía de suficiente poder de monopolio para fijar precios a su antojo, y ambos quedaron atrapados en una guerra de márgenes sin billete de vuelta.
Las rebajas se sucedieron a ritmo semanal. El 26 de junio de 2026, OpenAI lanzó GPT-5.6 Sol junto a su variante ligera Luna. La estructura tarifaria oficial (entrada por millón de tokens, salida por millón de tokens y lectura de caché por millón de tokens) fijó los precios en $5/$30/$0.50 y $1/$6/$0.10 respectivamente. Solo cuatro días después, Anthropic respondió lanzando Claude Sonnet 5 a un agresivo precio de $2/$10/$0.20, asegurando en ese momento que se trataba de una promoción temporal.
La batalla se recrudeció a finales de julio. El 24 de julio, Anthropic presentó su buque insignia de gama alta Claude Opus 5 ($5/$25/$0.50). Apenas seis días más tarde, el 30 de julio, OpenAI recortó por sorpresa el precio de GPT-5.6 Luna en un 80 %, dejándolo en $0.20/$1.20/$0.02. Esta maniobra borró de un plumazo cualquier sobreprecio en los modelos ligeros. Anthropic claudicó el 10 de agosto: retiró sus planes de subida y convirtió el precio promocional de Sonnet 5 en su tarifa estándar definitiva.
Los ajustes defensivos se convirtieron pronto en una inercia imparable para toda la industria. El 21 de agosto, OpenAI rebajó GPT-5.6 Sol otro 20 %, fijándolo en $4/$20/$0.40. Los precios oficiales de los modelos de cabecera se redujeron a la mitad en repetidas ocasiones en cuestión de meses, haciendo estallar el mito de las rentas monopolísticas del software propietario.
La verdadera palanca de costes: más del 90 % del gasto está en la caché
Quienes observan las tarifas de los LLM de forma superficial suelen fijarse únicamente en las columnas de entrada y salida. Sin embargo, en los entornos de producción reales, la factura mensual la decide la tercera columna: la lectura de caché (Prompt Cache Read).
Cuando un ingeniero utiliza un asistente de programación, cada línea de código modificada obliga a reempaquetar todo el historial de la conversación y el contexto del proyecto. El modelo no necesita volver a computar desde cero esa información ya conocida, ya que la memoria gráfica recupera al instante los estados KV precalculados. Este mecanismo se conoce como prompt caching. En los flujos de trabajo con agentes de programación, la lectura de caché representa entre el 96 % y el 99 % del volumen total de tokens consumidos, con tasas de acierto que se mantienen habitualmente entre el 90 % y el 100 %.
Por muy baratos que sean los tokens nominales de entrada y salida, solo representan menos del 5 % del tráfico real. En cambio, cuando un proveedor reduce un 75 % la tarifa de lectura de caché, la factura neta a final de mes de los clientes empresariales se reduce de golpe entre un 70 % y un 75 %.
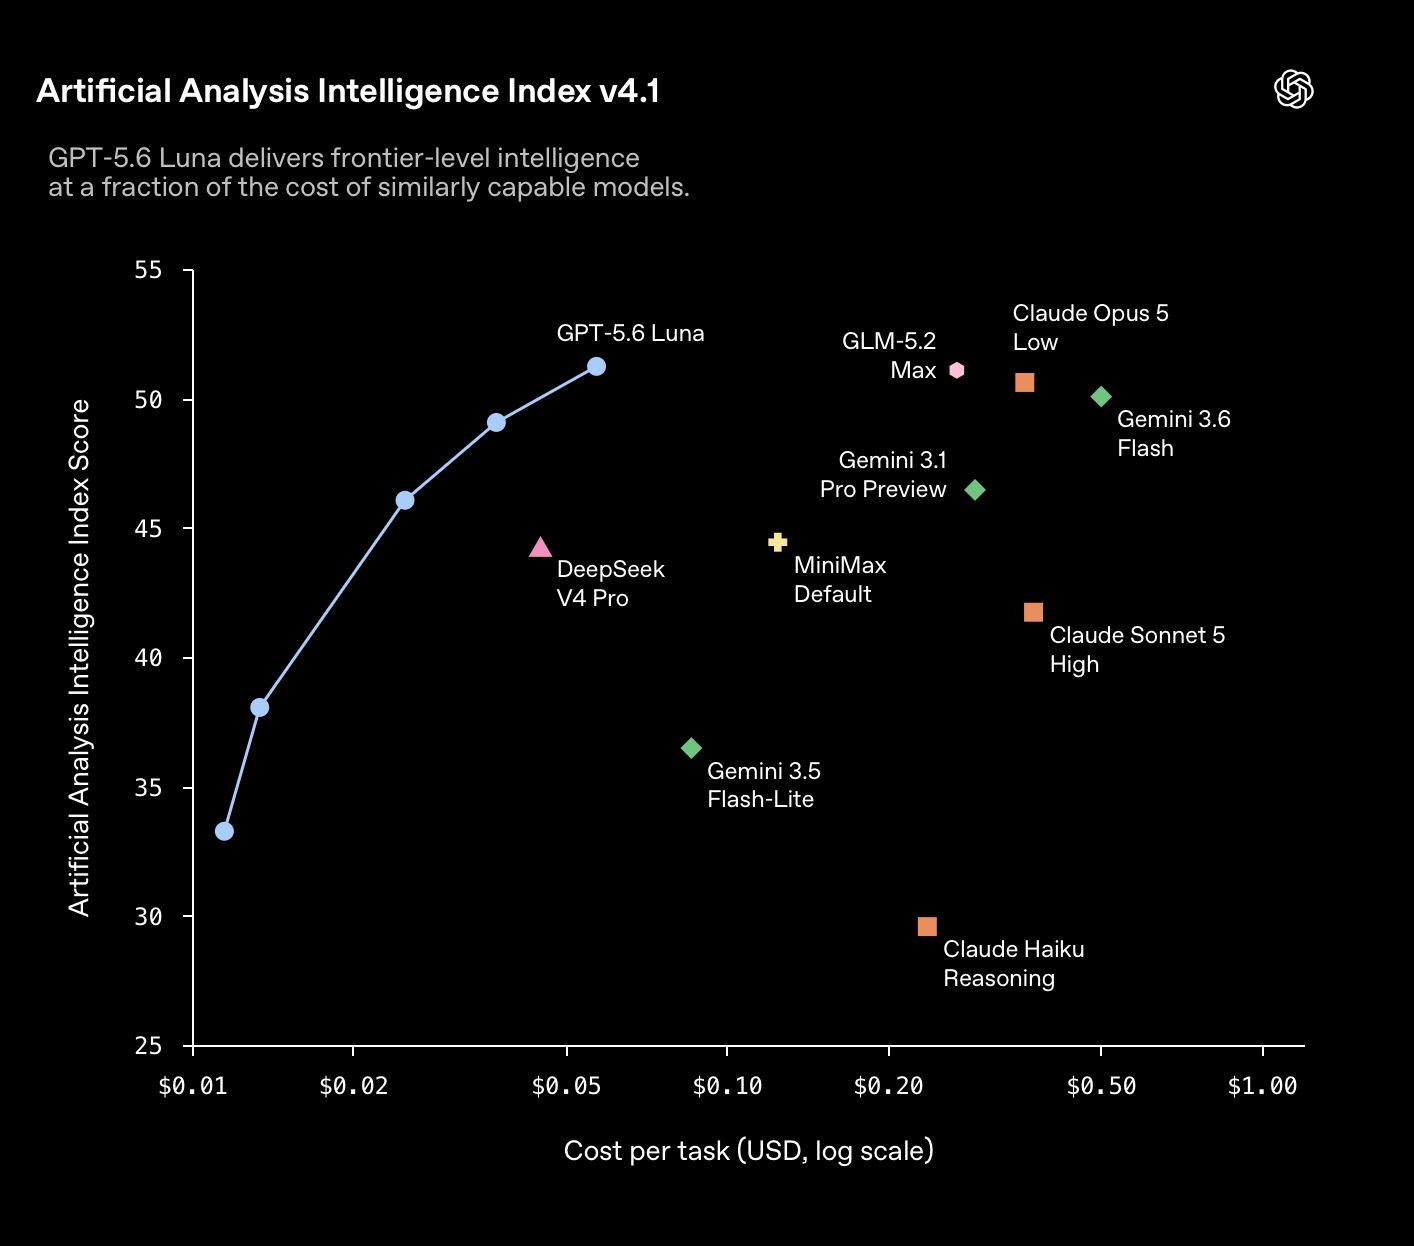 Gráfico: Distribución de calidad del modelo frente a coste por tarea tras la rebaja del 80 %. Fuente: OpenAI (vía minimaxir.com)
El choque frontal de septiembre entre ambos competidores giró precisamente en torno a esta palanca. El 1 de septiembre, Anthropic lanzó Fable 5.1 ($10/$50/$0.25), recortando un 75 % el coste de lectura de caché. OpenAI contraatacó el 3 de septiembre con GPT-6 Astra ($10/$50/$1), un modelo de mayor capacidad general pero que quedó en clara desventaja de relación coste-rendimiento debido a una tarifa de caché más elevada.
El 22 de septiembre, ambas compañías volvieron a medirse el mismo día. OpenAI presentó GPT-6 Sol ($2/$10/$0.20) y GPT-6 Luna ($0.10/$0.50/$0.01), reduciendo las tarifas de entrada y salida a la mitad respecto a sus versiones ya rebajadas. Paralelamente, Anthropic lanzó Claude Opus 5.5 ($4/$20/$0.20), confirmando que sus costes operativos de infraestructura se habían reducido sustancialmente y rebajando el gasto real de los usuarios entre un 40 % y un 60 %. A principios de octubre, ante las críticas sobre ciertas variaciones de rendimiento en GPT-6 Sol, OpenAI lanzó GPT-6.1 Sol, bajando el precio de la caché a $0.10 y consolidando un recorte acumulado del 75 % en toda su gama en cuatro meses.
29 proveedores compitiendo: cambiar de servicio solo cuesta una línea de configuración
El hecho de que los gigantes bajaran sus tarifas de forma tan drástica no respondió a la generosidad, sino a la formidable presión del ecosistema de código abierto y de las redes de alojamiento de cómputo. Si los modelos propietarios hubiesen intentado proteger sus márgenes, los clientes habrían migrado de inmediato hacia alternativas más económicas.
El frente del código abierto ya había mostrado sus cartas meses antes. En abril de 2026, el lanzamiento de DeepSeek V4 Flash 0420 fijó precios de solo $0.14/$0.28/$0.0028. Su coste de lectura de caché equivalía a apenas el 2 % del precio de entrada, muy lejos del margen del 5 % al 10 % que los líderes del sector habían intentado defender. El 17 de octubre, la versión optimizada DeepSeek V4.1 Flash 1017 duplicó prácticamente su rendimiento en las pruebas de referencia mientras conservaba su ajustada tarifa de $0.15/$0.60/$0.003.
Una amenaza todavía mayor provino de la rápida proliferación de las redes de distribución de cómputo. En mayo de 2026, solo 13 proveedores independientes ofrecían instancias gestionadas de DeepSeek V4 Flash en todo el mundo. Cuando llegó la actualización de octubre, esa cifra había saltado a 29 proveedores. En plataformas de infraestructura como Cloudflare o DeepInfra, la diferencia de precio real frente a la API oficial del desarrollador original se redujo a menos del 10 %.
El modelo Kimi K3.1 Pro de Moonshot AI ejerció una presión adicional. Con un precio de $2/$10/$0.20, sus evaluaciones técnicas igualaban el rendimiento de Opus 5.5, y la compañía fijó la apertura pública de sus pesos para el 4 de noviembre. Una vez liberados los pesos, decenas de proveedores de computación en la nube estarán listos para ofrecer inferencia equivalente a precios de coste estricto.
Los protocolos de llamada a las API de LLM se han estandarizado por completo. Para una empresa, cambiar de proveedor de modelos ya no requiere reescribir la lógica de negocio ni adaptar conectores complejos. A los ingenieros les basta con sustituir una única URL en el archivo de configuración. Frente a un coste de migración nulo, cualquier intento de encarecer las tarifas se traduce en una fuga inmediata de clientes.
La paradoja de las pasarelas: los precios caen un 60 %, pero el gasto total aumenta
El colapso en el precio unitario del cómputo provocó un fenómeno sumamente revelador en los entornos de producción reales: a medida que los tokens se abarataban a ritmos históricos, el gasto total de las empresas en infraestructura no paraba de crecer.
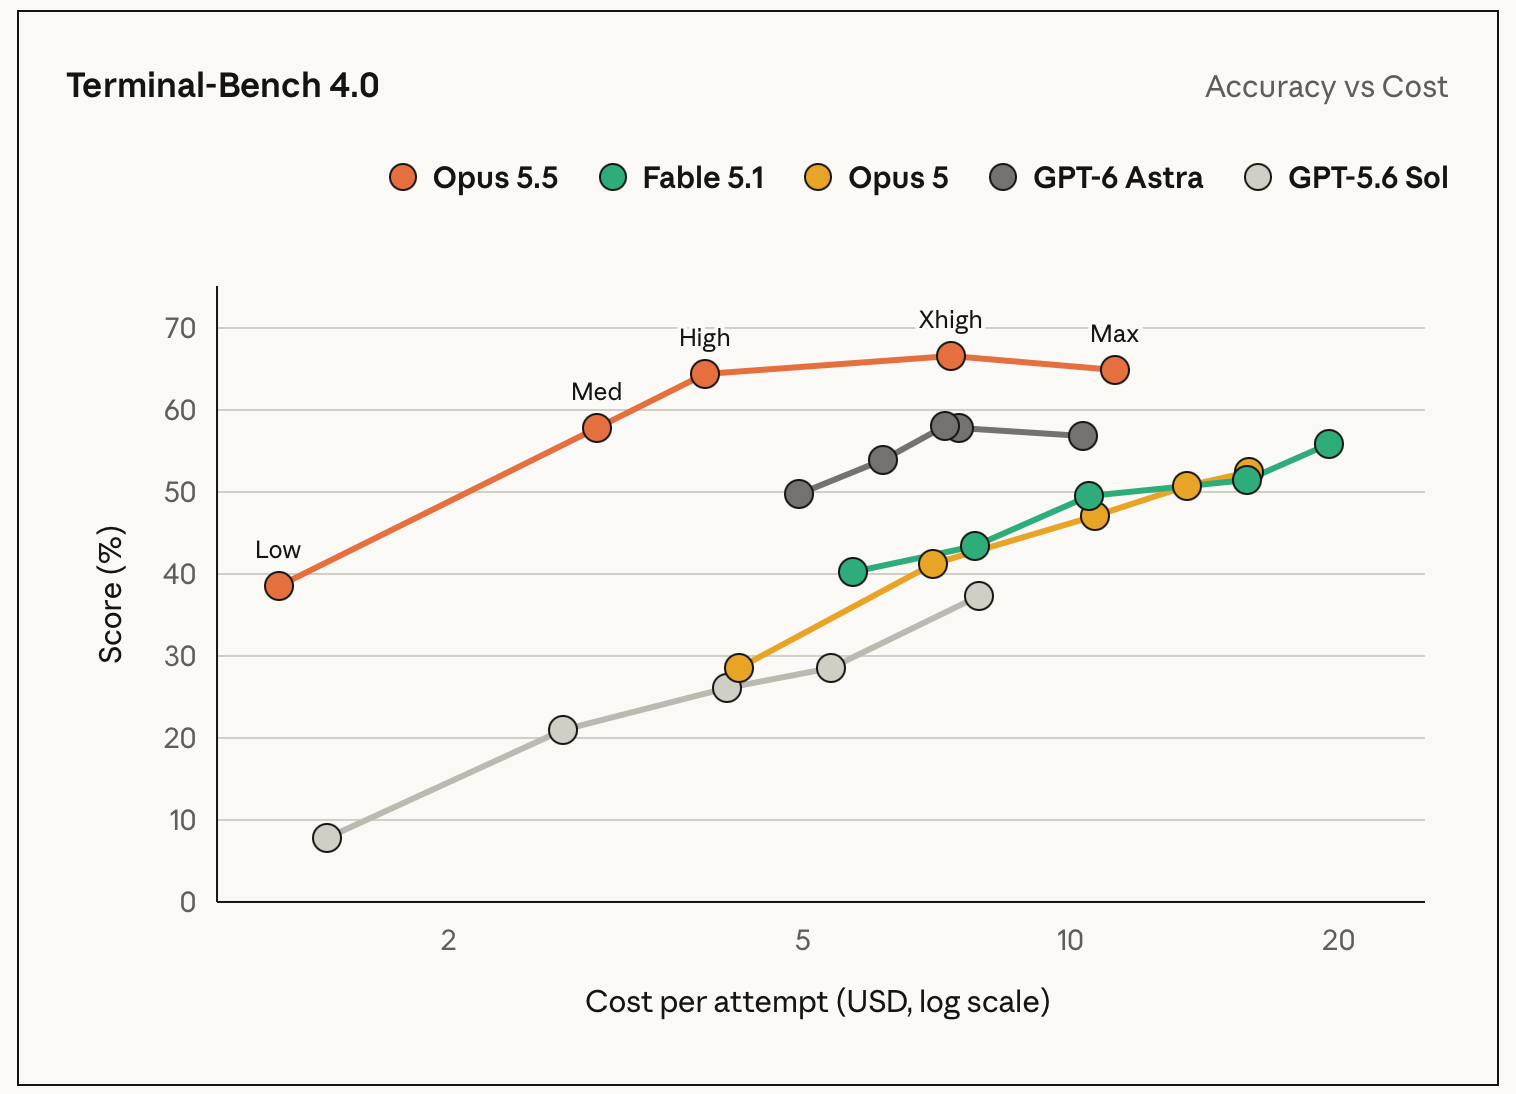 Gráfico: Rendimiento global y costes de llamada de Claude Opus 5.5. Fuente: Anthropic (vía minimaxir.com)
Según los datos registrados por Vercel AI Gateway, en septiembre de 2026 el coste medio abonado por los desarrolladores por token se había reducido al 43,3 % respecto a los niveles de abril del mismo año. Sin embargo, el gasto mensual consolidado de las cuentas corporativas creció de forma ininterrumpida durante ese mismo periodo.
Esta paradoja se explica por una transformación radical en la forma de consumir IA. Cuando el precio de los tokens era elevado, los desarrolladores racionaban estrictamente cada llamada y dedicaban valiosas horas de ingeniería a recortar el contexto. Al desplomarse el coste de lectura de caché a fracciones de céntimo, los equipos dieron rienda suelta a la ejecución desatendida de flujos de trabajo autónomos.
En las arquitecturas de agentes actuales, los sistemas ejecutan de forma autónoma cientos o miles de interacciones continuas: revisiones recursivas de código, comparación de alternativas en paralelo y pruebas de corrección automática. El abaratamiento del cómputo dinamitó las barreras de uso y desató una frecuencia de llamadas sin precedentes. El acceso a una computación económica impulsó una automatización de altísima densidad. La inferencia de vanguardia se ha transformado en un suministro básico cotidiano, tan indispensable y accesible como la electricidad o el agua.
El comprador toma el control: los grandes modelos pasan a ser un bien genérico
Durante dos décadas, las plataformas de Internet repitieron el mismo libreto: subsidiar servicios a pérdida para asfixiar a los rivales, consolidar el monopolio y luego elevar los precios para capturar rentas. En el terreno de la inferencia de grandes modelos, ese guion ya no tiene cabida.
La inferencia inteligente es, por naturaleza, una carga de trabajo de cómputo estandarizada y fácilmente sustituible. Los modelos de código abierto aseguran un listón de rendimiento muy elevado, mientras decenas de proveedores en la nube aportan una capacidad de ejecución prácticamente infinita. Ningún laboratorio cuenta con una ventaja insalvable, y ningún gigante tiene herramientas para impedir que sus clientes se marchen cuando lo deseen.
Los dos líderes del sector son plenamente conscientes de esta amenaza de comoditización. OpenAI y Anthropic se esfuerzan por cerrar contratos corporativos plurianuales e integran sus modelos en entornos de trabajo propios, como OpenAI Dots o Claude Duet. Ambas firmas buscan que la integración profunda con los datos y los flujos de trabajo internos de las empresas construya las barreras de salida que la capa de API ya no puede garantizar.
Sin embargo, mientras el modelo de fondo pueda ser sustituido entre 29 proveedores con una sola línea de configuración, el margen comercial no volverá. El precio del cómputo tenderá inevitablemente al coste físico del silicio y de la electricidad. La espiral bajista que recortó un 80 % los precios en cuatro meses ha decretado el fin de los márgenes desorbitados en la IA: el mercado de la computación pertenece ya, de forma definitiva, a los compradores.
Enlaces de referencia:
- Informe de análisis técnico en minimaxir.com
- Debate técnico en la comunidad de Hacker News