四个月内大模型单价跌去八成,企业算力总支出却逆势上扬。使用门槛抹平后,代码助手几分钟就能跑完上千轮自主交互。推理算力正在演化为日常耗材,单价降得越快,系统消耗得越多。
技术账本剥离了前沿模型的溢价空间。在智能体开发中,超过 96% 的开销集中在缓存读取。全球 29 家算力托管商同台抢单,开发者切换模型只需改一行配置。面对零迁移成本的买方市场,闭源巨头关死了涨价回本的通道。
四个月连降四次:两家巨头掀起杀价潮
2026 年 6 月到 9 月,OpenAI 与 Anthropic 在短短四个月内将主力模型定价压缩了八成。外界通常把杀价看作平台早期的亏损圈地,认定巨头消灭对手后就会涨价回本。真实的技术账本给出了相反的答案。两家顶尖公司根本没有垄断定价的资本,早已在激烈的成本战中失去了涨价退路。
降价以周为单位快速推进。2026 年 6 月 26 日,OpenAI 发布 GPT-5.6 Sol 与低配版本 Luna。官方的计费标准是输入每百万 token、输出每百万 token 与缓存读取每百万 token,两款模型分别标价 $5/$30/$0.50 与 $1/$6/$0.10。仅仅四天后,Anthropic 就推出 Claude Sonnet 5,以 $2/$10/$0.20 的低价正面阻击,并在当时坚称这只是限期促销。
价格战在 7 月底进一步升温。7 月 24 日,Anthropic 发布高阶旗舰模型 Claude Opus 5($5/$25/$0.50)。不到一周后的 7 月 30 日,OpenAI 突然将 GPT-5.6 Luna 的价格下调 80%,直接降到 $0.20/$1.20/$0.02。这一举措封死了廉价模型的溢价空间。Anthropic 随后在 8 月 10 日放弃涨价计划,宣布 Sonnet 5 的促销价改为永久定价。
防守型调价随后演化为全行业惯性。8 月 21 日,OpenAI 将 GPT-5.6 Sol 的单价调降两成至 $4/$20/$0.40。主力模型的账面单价在数月内连续腰斩,直接戳破了原先高昂的技术溢价。
账单杠杆现形:九成开销花在缓存读取上
外行看大模型定价,往往只盯住输入与输出两列数字。开发者的真实账单,其实由第三列定价决定。真正的开销杠杆藏在「缓存读取」的单价里。
工程师使用编程助手时,软件每修改一行代码,都要重新打包工程的历史对话与背景文件。这些已经存在的内容不需要模型重复做深度推理,显存会自动命中已有的计算结果。这一机制被称为提示词缓存(Prompt Caching)。在智能体编程场景中,缓存读取占到总 token 消耗量的 96% 至 99%,系统命中率长期维持在 90% 到 100% 之间。
输入与输出的标价再低,也只覆盖不到 5% 的数据量。厂商只要将缓存读取单价调低 75%,企业用户的实际总账单就会减少 70% 至 75%。
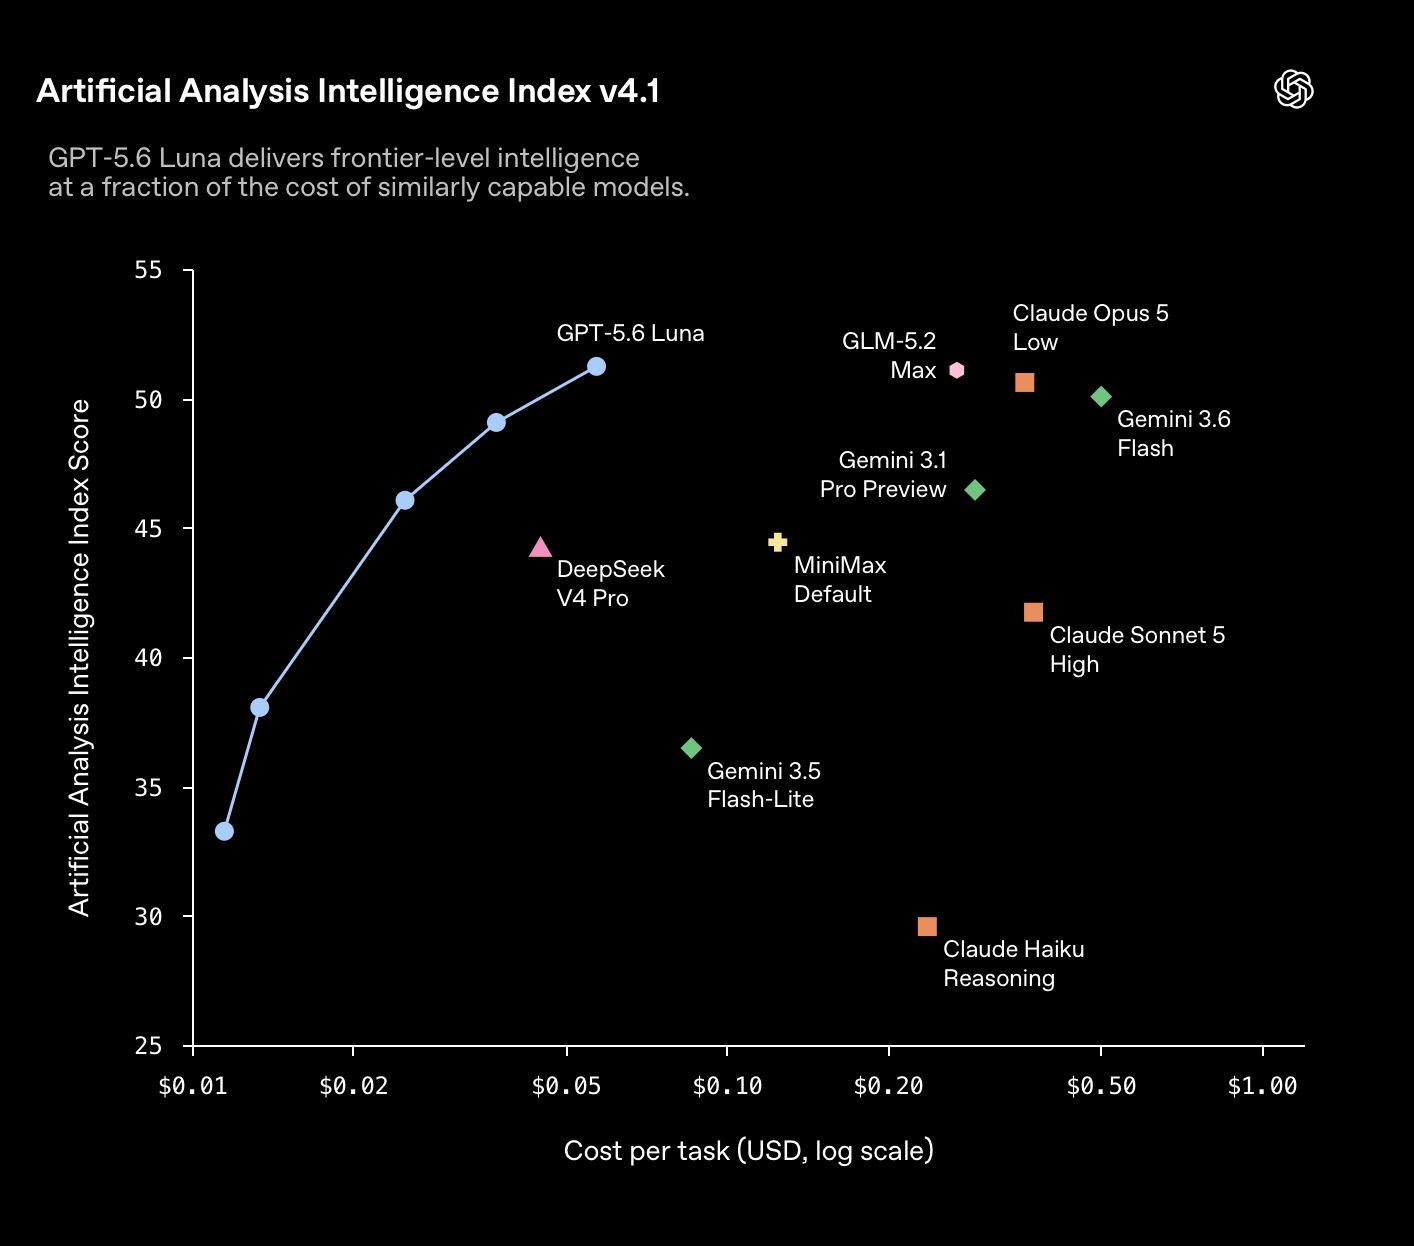 图:降价 80% 后的模型质量与每任务成本分布。来源:OpenAI(经 minimaxir.com)
两强在 9 月的较量直接围绕这个杠杆展开。9 月 1 日,Anthropic 发布 Fable 5.1($10/$50/$0.25),将缓存读取费用直降 75%。OpenAI 紧接着在 9 月 3 日推出综合性能更强的 GPT-6 Astra($10/$50/$1),却因为维持了较高的缓存单价而在性价比上吃亏。
9 月 22 日两家公司同日正面对决。OpenAI 推出 GPT-6 Sol($2/$10/$0.20)与 GPT-6 Luna($0.10/$0.50/$0.01),输入与输出单价仅为前代打折后的一半。Anthropic 同步发布 Claude Opus 5.5($4/$20/$0.20),并明确表示后台运营成本低于前代,带动用户总开销下降 40% 至 60%。随后在 10 月初,针对 GPT-6 Sol 性能波动的反馈,OpenAI 发布 GPT-6.1 Sol,把缓存单价进一步压到 $0.10,全系列四个月内的综合降幅定格在 75%。
29家同行同台抢单:换掉供应商只要改一行配置
巨头们主动大幅让利,背后站着开源生态与算力托管商构成的强大对手。如果闭源厂商不主动压低价格,客户就会以极低门槛投向替代方案。
开源阵营早在数月前就亮出了价格底牌。2026 年 4 月亮相的 DeepSeek V4 Flash 0420,定价低至 $0.14/$0.28/$0.0028。它的缓存读取价格仅相当于输入价格的 2%,远低于两家巨头早期保留的 5% 至 10% 比例。到了 10 月 17 日,升级版 DeepSeek V4.1 Flash 1017 在权威基准测试中的综合指标提升了近一倍,而价格依旧维持在 $0.15/$0.60/$0.003 的低位。
更严峻的挑战来自算力分销网络的迅速扩张。2026 年 5 月,全球提供 DeepSeek V4 Flash 托管服务的独立厂商只有 13 家。到了 10 月版本更新时,提供同款模型服务的供应商猛增至 29 家。Cloudflare 与 DeepInfra 等第三方算力平台的实际调用价格,已经压缩到原厂官方报价的 10% 差距以内。
月之暗面的 Kimi K3.1 Pro 同样形成了沉重的外部压力。该模型定价定在 $2/$10/$0.20,综合测试表现紧贴 Opus 5.5,并确定在 11 月 4 日公开发布权重。一旦公开权重,二十多家算力托管商便会迅速跟进,提供同等规格的低价服务。
大模型调用协议早已高度标准化。企业切换底层服务商,不需要修改核心业务代码,也不需要重写适配层。技术人员只需在配置文件里替换一行 API 接口地址。零迁移成本面前,任何提价企图都会直接导致客户流失。
网关实测浮出反差:单价降了六成,总支出不降反升
算力单价的断崖式下跌,在真实业务环境中引发了有趣的变化。工程数据出现了一个反常现象:单价越来越便宜,企业总账单却越来越庞大。
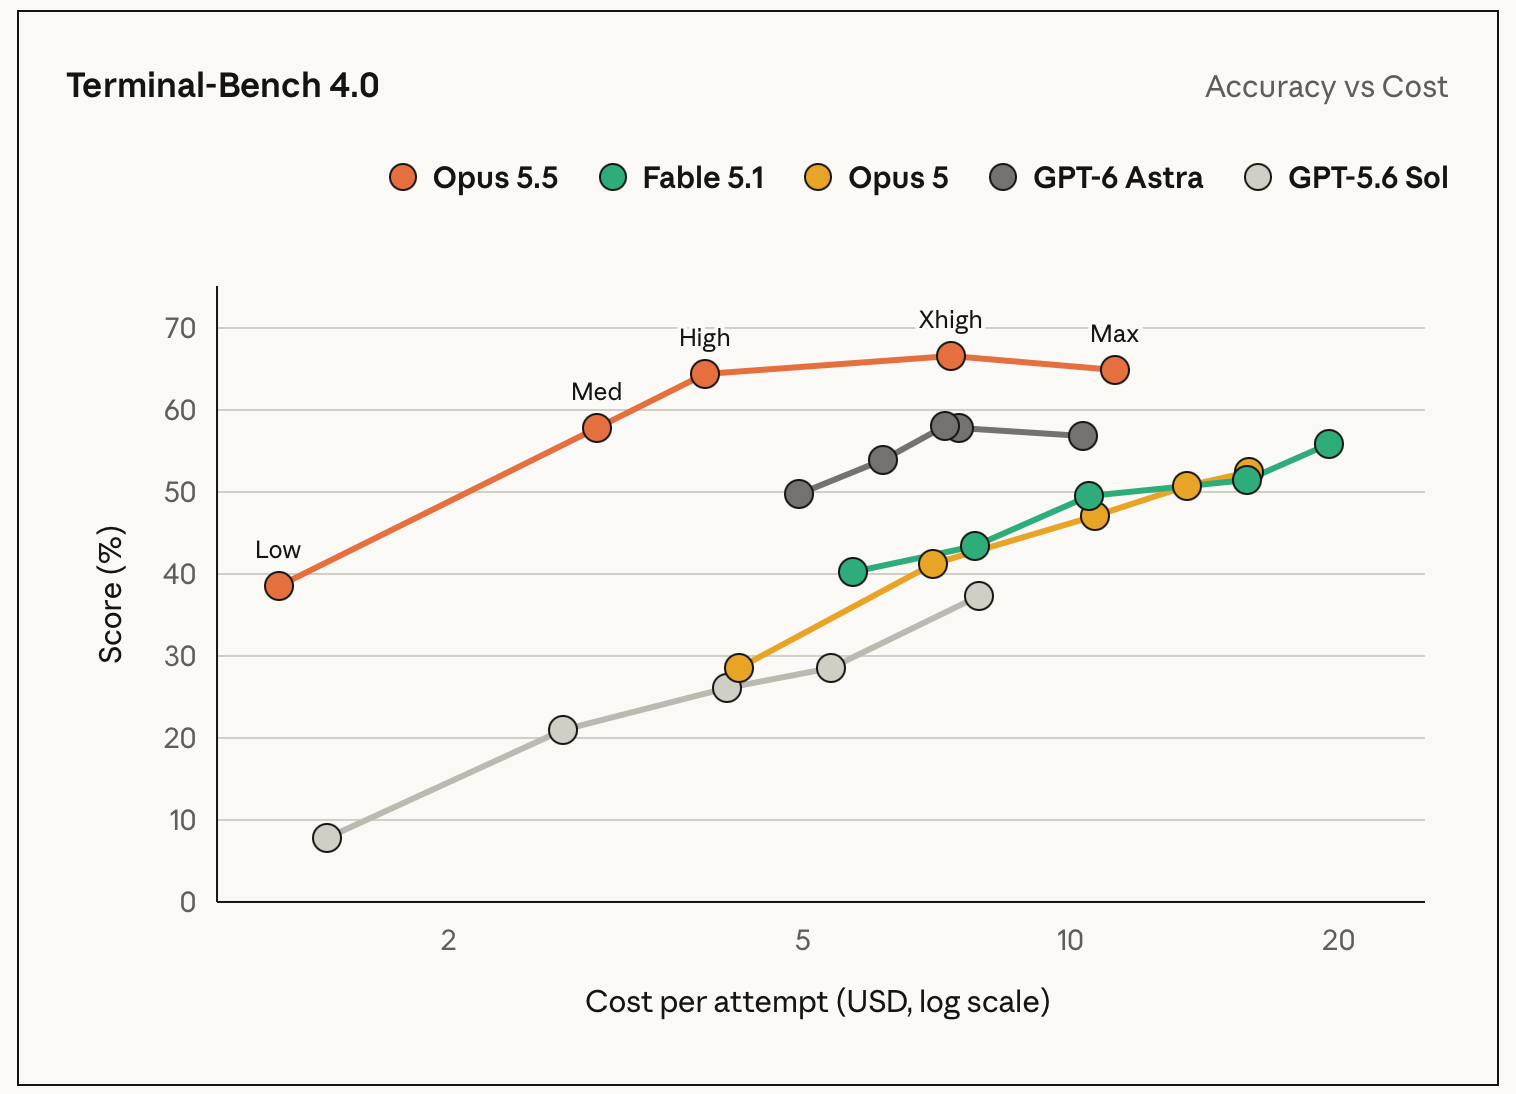 图:Claude Opus 5.5 的综合性能与调用成本分布。来源:Anthropic(经 minimaxir.com)
根据网络调度服务商 Vercel AI Gateway 记录的统计,2026 年 9 月开发者调用大模型的平均单位 token 支出,已经回落到同年 4 月的 43.3%。企业客户在此期间的总支出却保持着上升趋势。
这种反差源于应用模式的根本转变。过去模型单价居高不下时,工程师必须克制调用的次数与范围,每次提示词输入都要反复精简。当缓存读取降到几美分以后,团队开始放手让程序自动化运行。
在现在的智能体开发中,系统会自主发起成百上千轮交互。模型反复执行代码审查、多方案对比测试与自动纠错。单价下调打碎了使用门槛,释放了爆发式的调用频次。便宜的算力带来了更密集的调用习惯。高端算力由此变成了像水和电一样的日常消耗品。
买方掌握主动权:大模型正在沦为普通日用品
过去二十年,平台型互联网公司总在上演熟悉的剧本:前期依靠资本补贴打垮对手,建立垄断后再提价收割利润。大模型推理领域没有这种剧本的生存土壤。
智能推理本质上是高度可替代的标准化计算服务。开源模型提供了稳固的基准性能,全球数十家云服务商则提供了充足的代工算力。没有任何一家模型公司能够建立绝对的排他优势,也没有任何巨头能够阻止买方随时离开。
两家头部企业显然意识到了这种大宗商品化的威胁。OpenAI 与 Anthropic 正在努力推销长周期企业合同。两家公司加紧将模型封装为专属助手,比如 OpenAI Dots 与 Claude Duet。厂商试图通过私有数据与工作流的深度结合,筑起新的竞争壁垒。
只要底层模型能被 29 家托管商随时替换,溢价空间就不复存在。算力单价只能紧贴芯片与电费的真实成本。四个月连降八成的杀价潮,宣告了大模型暴利时代的终结。算力市场全面倒向了握有选择权的买方。
参考链接:
- minimaxir.com 技术分析报告
- Hacker News 社区技术讨论