Innerhalb von nur vier Monaten sind die Token-Preise für große Sprachmodelle um 80 Prozent eingebrochen – und dennoch steigen die Gesamtausgaben der Unternehmen für Rechenleistung unaufhörlich. Nachdem die finanziellen Einstiegshürden fielen, führen KI-Coding-Assistenten binnen weniger Minuten Tausende autonome Interaktionsschleifen aus. Inferenzleistung entwickelt sich rasant zum Verbrauchsgut des Alltags: Je schneller der Stückpreis sinkt, desto massiver explodiert der Gesamtverbrauch im System.
Die ökonomischen Realitäten haben den Spitzenmodellen jeglichen Preisaufschlag entzogen. Bei der Entwicklung autonomer Agenten entfallen über 96 Prozent der laufenden Ausgaben auf das Auslesen zwischengespeicherter Prompts (Prompt Caching). Weltweit konkurrieren mittlerweile 29 unabhängige Hostinganbieter um dieselben Anfragen, und Entwickler wechseln den Modellbetreiber durch die Anpassung einer einzigen Konfigurationszeile. In einem reinen Käufermarkt ohne Wechselkosten ist den führenden Anbietern proprietärer Modelle der Rückweg zu früheren Margen endgültig versperrt.
Vier Preissenkungen in vier Monaten: Wie zwei Branchenriesen einen Preiskampf entfesselten
Zwischen Juni und September 2026 reduzierten OpenAI und Anthropic die Preise ihrer wichtigsten Modelle um vier Fünftel. Beobachter deuteten diesen Preiskampf anfangs gerne als klassische Anfangssubvention: Man nehme Verluste in Kauf, um Konkurrenten aus dem Markt zu drängen, und hebe nach Erreichen eines Monopols die Preise kräftig an. Die technische Kostenrealität belegt das genaue Gegenteil. Beide Spitzenunternehmen verfügen über keinerlei Spielraum für Monopolpreise; sie wurden in einen unerbittlichen Margenkrieg gezwungen, aus dem es kein Zurück mehr gibt.
Die Preissenkungen vollzogen sich im Wochentakt. Am 26. Juni 2026 veröffentlichte OpenAI das Modell GPT-5.6 Sol nebst der schlankeren Variante Luna. Das offizielle Abrechnungsschema basierte auf Input, Output und Cache-Read pro Million Token: Die beiden Modelle starteten bei $5/$30/$0.50 bzw. $1/$6/$0.10. Nur vier Tage später konterte Anthropic mit Claude Sonnet 5 für günstige $2/$10/$0.20 – und betonte damals ausdrücklich, es handele sich um eine befristete Werbeaktion.
Ende Juli eskalierte die Preisschlacht weiter. Am 24. Juli brachte Anthropic sein High-End-Flaggschiff Claude Opus 5 ($5/$25/$0.50) auf den Markt. Keine Woche später, am 30. Juli, senkte OpenAI den Preis von GPT-5.6 Luna überraschend um 80 Prozent auf $0.20/$1.20/$0.02 ab. Dieser Schritt vernichtete jegliche Margenreserve bei kompakten Modellen. Anthropic gab am 10. August schließlich klein bei, strich die geplanten Preiserhöhungen und erklärte den Aktionspreis von Sonnet 5 zur dauerhaften Standardgebühr.
Die defensive Anpassung entwickelte eine branchenweite Eigendynamik. Am 21. August reduzierte OpenAI den Preis für GPT-5.6 Sol um weitere 20 Prozent auf $4/$20/$0.40. Die Listenpreise der führenden Modelle halbierten sich innerhalb weniger Monate mehrfach hintereinander und zerstörten den Mythos unantastbarer Technologieprämien.
Der Hebel in der Abrechnung: Über 90 % der Kosten entfallen auf Cache-Reads
Wer LLM-Preise nur flüchtig betrachtet, achtet meist ausschließlich auf die beiden Spalten für Input und Output. Auf den tatsächlichen Rechnungen von Entwicklerteams entscheidet jedoch eine dritte Spalte über die Höhe der Kosten: der Stückpreis für das Auslesen aus dem Prompt-Cache (Cache Read).
Wenn Programmierer einen KI-Assistenten nutzen, packt das System bei jeder einzelnen Codeänderung den bisherigen Dialogverlauf und relevante Projektdateien neu zusammen. Für diese bereits bekannten Inhalte muss das Modell keine aufwendige Neuberechnung durchführen; der Grafikspeicher greift direkt auf die zuvor berechneten KV-Zustände zu. Dieses Verfahren wird als Prompt Caching bezeichnet. In modernen Agentenszenarien macht das Auslesen des Caches 96 bis 99 Prozent des gesamten Tokenvolumens aus, während die Trefferquote stabil zwischen 90 und 100 Prozent verharrt.
Ganz gleich, wie stark die Listenpreise für Input und Output fallen: Sie betreffen weniger als 5 Prozent des tatsächlichen Datenverkehrs. Senkt ein Anbieter hingegen die Gebühren für Cache-Reads um 75 Prozent, sinkt die monatliche Gesamtrechnung für Firmenkunden unmittelbar um 70 bis 75 Prozent.
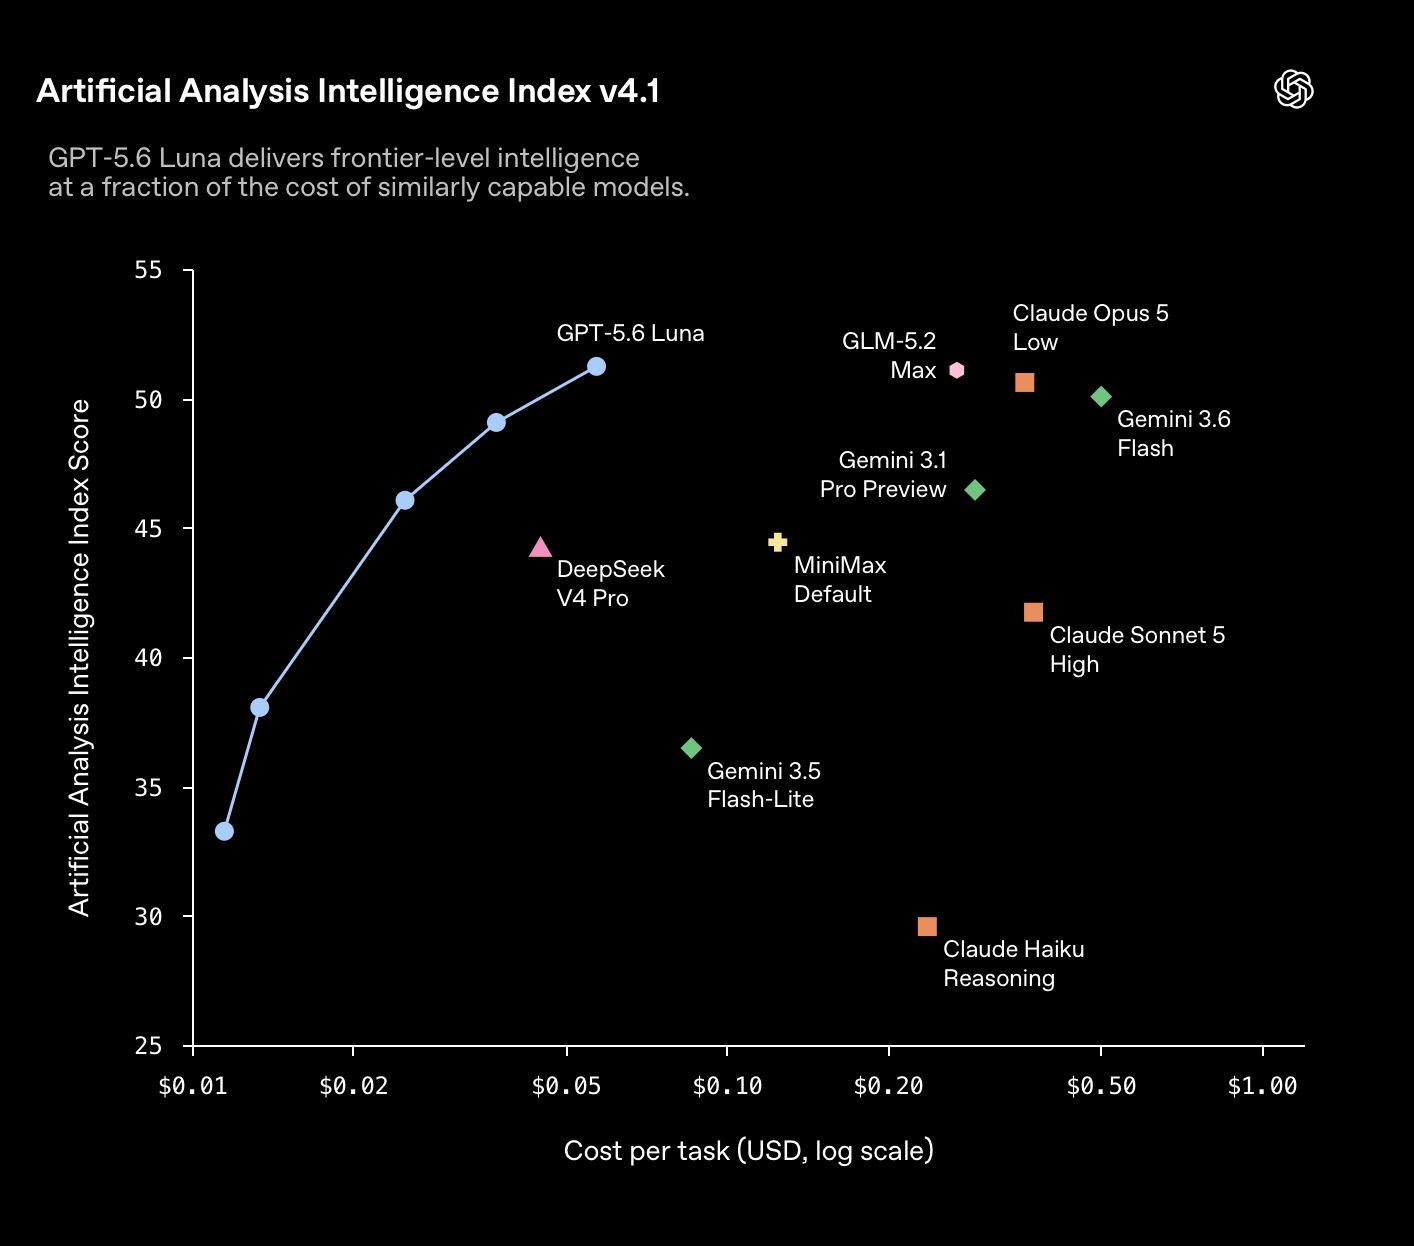 Abbildung: Modellqualität und Kostenverteilung pro Aufgabe nach der 80-Prozent-Preissenkung. Quelle: OpenAI (via minimaxir.com)
Das Kräftemessen der beiden Giganten im September drehte sich direkt um diesen Kostenhebel. Am 1. September senkte Anthropic mit Fable 5.1 ($10/$50/$0.25) die Cache-Read-Gebühren drastisch um 75 Prozent. OpenAI konterte am 3. September mit dem leistungsfähigeren GPT-6 Astra ($10/$50/$1), geriet jedoch wegen des vergleichsweise hohen Cache-Preises beim Preis-Leistungs-Verhältnis ins Hintertreffen.
Am 22. September trafen beide Unternehmen am selben Tag aufeinander. OpenAI präsentierte GPT-6 Sol ($2/$10/$0.20) und GPT-6 Luna ($0.10/$0.50/$0.01), womit die Input- und Outputpreise gegenüber den bisherigen Rabattstufen nochmals halbiert wurden. Anthropic zog zeitgleich mit Claude Opus 5.5 ($4/$20/$0.20) nach, verwies auf spürbar gesunkene interne Betriebskosten und senkte die Nettoausgaben der Anwender um 40 bis 60 Prozent. Anfang Oktober reagierte OpenAI auf Leistungsschwankungen bei GPT-6 Sol mit dem Update GPT-6.1 Sol, senkte den Cache-Preis auf $0.10 ab und besiegelte damit eine kumulierte Preissenkung von 75 Prozent über alle Modellreihen hinweg.
29 Anbieter für dasselbe Modell: Providerwechsel mit einer einzigen Codezeile
Dass die Technologieriesen ihre Preise freiwillig derart massiv nach unten korrigierten, lag vor allem an der wachsenden Konkurrenz aus der Open-Source-Welt und unabhängigen Hosting-Netzwerken. Hätten die proprietären Anbieter ihre Preise verteidigt, wären die Kunden binnen kürzester Zeit zu günstigen Alternativen abgewandert.
Das Open-Source-Lager hatte die Preisuntergrenze bereits Monate zuvor vorgegeben. Das im April 2026 vorgestellte DeepSeek V4 Flash 0420 bot Tarife von nur $0.14/$0.28/$0.0028. Die Kosten für Cache-Reads lagen bei lediglich 2 Prozent des Inputpreises – ein Bruchteil der 5 bis 10 Prozent, die die westlichen Branchenführer bis dahin verlangt hatten. Am 17. Oktober verdoppelte die verbesserte Version DeepSeek V4.1 Flash 1017 ihre Benchmark-Leistung nahezu, behielt jedoch das extrem günstige Preisniveau von $0.15/$0.60/$0.003 bei.
Eine noch größere Bedrohung stellt der rasante Ausbau des Hosting-Ökosystems dar. Im Mai 2026 gab es weltweit gerade einmal 13 unabhängige Plattformen, die DeepSeek V4 Flash als Managed Service anboten. Bis zum Oktober-Update war diese Zahl auf 29 Anbieter angewachsen. Bei Drittanbietern wie Cloudflare oder DeepInfra liegen die effektiven Abrufpreise inzwischen innerhalb einer Spanne von kaum 10 Prozent gegenüber den offiziellen Preisen der Originalentwickler.
Auch Kimi K3.1 Pro von Moonshot AI übte immensen Marktdruck aus. Mit einem Tarif von $2/$10/$0.20 kam das Modell in Benchmarks gefährlich nah an Opus 5.5 heran; zudem wurden die Modellgewichte für den 4. November zur freien Veröffentlichung angekündigt. Sobald die Gewichte öffentlich sind, stehen dutzende Hostingbetreiber bereit, um Rechenleistung auf identischem Niveau zu Grenzkosten bereitzustellen.
Die Schnittstellenprotokolle für LLM-Aufrufe sind längst universell standardisiert. Möchte ein Unternehmen seinen Modelllieferanten wechseln, müssen weder Kernfunktionen umgeschrieben noch proprietäre Adapter angepasst werden. Entwickler müssen lediglich eine einzige URL in der Konfigurationsdatei austauschen. Angesichts fehlender Wechselkosten führt jeder Versuch einer Preiserhöhung unweigerlich zur sofortigen Abwanderung der Kundschaft.
Das Gateway-Paradoxon: Stückpreise brechen um 60 % ein, Gesamtausgaben steigen
Der massive Verfall der Rechenkosten führte in realen Produktivumgebungen zu einer bemerkenswerten Entwicklung: Während die Token-Stückpreise historische Tiefststände erreichten, stiegen die Gesamtrechnungen der Unternehmen weiter an.
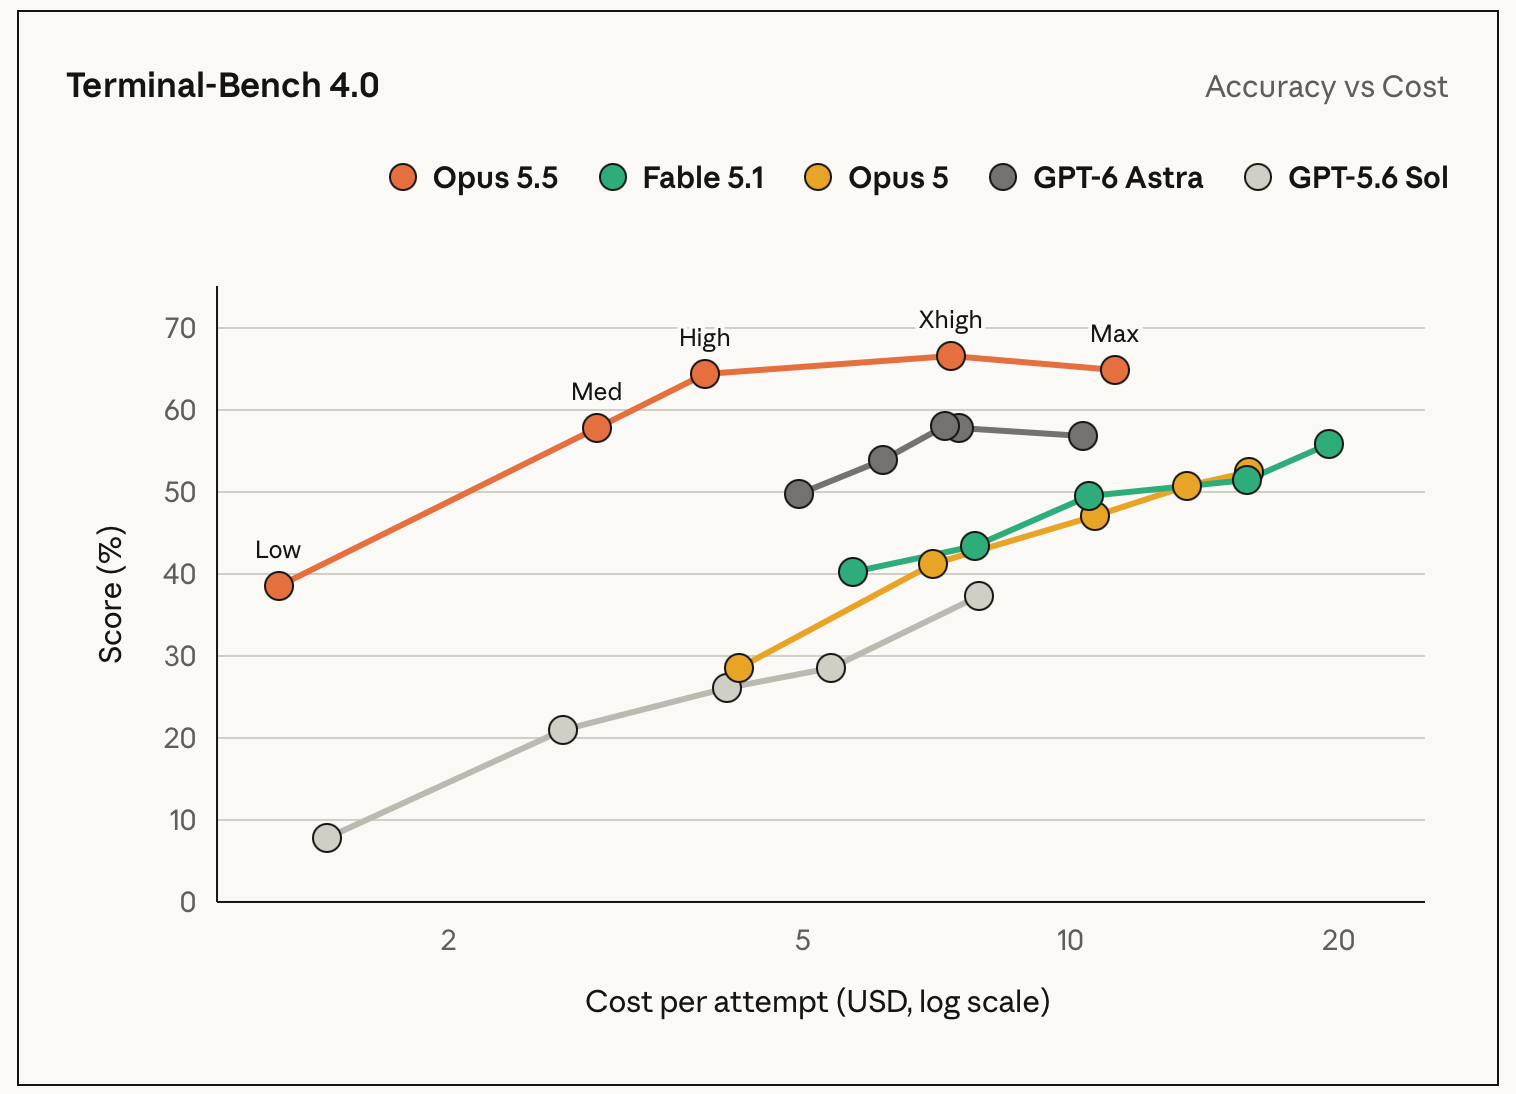 Abbildung: Gesamtleistung und Aufrufkosten von Claude Opus 5.5 im Vergleich. Quelle: Anthropic (via minimaxir.com)
Messdaten des API-Routing-Dienstes Vercel AI Gateway belegen, dass die durchschnittlichen Token-Kosten pro Entwickler im September 2026 auf 43,3 Prozent des April-Niveaus abgesackt waren. Dennoch stiegen die monatlichen Gesamtausgaben der Unternehmenskunden im selben Zeitraum kontinuierlich an.
Dieses Paradoxon erklärt sich durch einen grundlegenden Wandel in der Nutzung. Als Token-Preise noch hoch waren, mussten Entwickler jeden Aufruf rationieren und investierten viel Zeit in das Kürzen von Prompts. Seitdem Cache-Reads für Bruchteile von Cents abgerechnet werden, lassen Teams ihre Systeme vollautomatisch und ohne Drosselung agieren.
In modernen Agentenarchitekturen laufen hunderte oder gar tausende Interaktionsschleifen autonom im Hintergrund ab: Modelle führen rekursive Code-Reviews durch, vergleichen mehrere Lösungswege parallel und korrigieren Fehler selbstständig. Die radikale Preissenkung beseitigte die Barrieren und setzte eine Flut automatisierter Abrufe frei. Billige Rechenleistung führte zu einer nie dagewesenen Dichte an Automatisierung. Hochwertige Inferenzrechenleistung ist damit endgültig zu einem alltäglichen Grundversorger geworden – vergleichbar mit Wasser oder Strom.
Die Käufer übernehmen das Kommando: KI-Modelle als austauschbare Massenware
Über zwei Jahrzehnte hinweg folgten Internetplattformen demselben Muster: Mithilfe von Risikokapital drückten sie die Preise, verdrängten Wettbewerber und nutzten ihre Monopolstellung anschließend zur Gewinnmaximierung. Im Markt für KI-Inferenz gibt es für diese Strategie keinerlei Nährboden mehr.
Intelligente Inferenz ist im Grunde eine standardisierte, hochgradig austauschbare Rechenaufgabe. Open-Source-Modelle garantieren eine verlässliche Leistungsbasis, während weltweite Cloud-Infrastrukturen unbegrenzte Rechenkapazitäten liefern. Kein Modellentwickler kann sich dauerhafte Monopolvorteile sichern, und kein Anbieter kann Kunden daran hindern, jederzeit zur Konkurrenz zu wechseln.
Beide Marktführer haben die Gefahr dieser Kommodifizierung erkannt. OpenAI und Anthropic werben mit Nachdruck um mehrjährige Unternehmensverträge und verpacken ihre Modelle in vertikale Arbeitsplatzlösungen wie OpenAI Dots oder Claude Duet. Die Anbieter versuchen, durch die tiefe Verankerung in unternehmenseigenen Workflows und Datenbeständen neue Wechselbarrieren zu errichten.
Doch solange die grundlegende Intelligenz über 29 Hostinganbieter hinweg mit einer einzigen Zeile Konfiguration austauschbar bleibt, sind Margenaufschläge passé. Die Preise für Rechenleistung werden sich dauerhaft an den realen Kosten für Halbleiter und elektrischen Strom orientieren. Der 80-prozentige Preissturz innerhalb von vier Monaten markiert das definitive Ende astronomischer KI-Margen. Der Markt hat sich unwiderruflich zu einem reinen Käufermarkt gewandelt.
Weiterführende Links:
- Technischer Analysebericht auf minimaxir.com
- Fachdiskussion in der Hacker News Community