En l’espace de quatre mois, le tarif unitaire des grands modèles de langage s’est effondré de 80 %, alors même que les factures globales de calcul des entreprises poursuivent une ascension vertigineuse. Une fois les verrous financiers levés, les assistants de programmation automatisés se sont mis à enchaîner des milliers de boucles d’interactions autonomes en quelques minutes. La puissance d’inférence s’est muée en un bien consommable ordinaire : plus son coût unitaire diminue, plus le système en engloutit de volumes massifs.
Cette nouvelle équation économique a dépouillé les modèles de frontière de leur marge de valorisation. Dans le développement d’agents autonomes, plus de 96 % des dépenses d’exécution sont désormais concentrées sur la lecture du cache de contexte (prompt caching). Avec 29 hébergeurs indépendants rivalisant à l’échelle planétaire pour exécuter les mêmes requêtes, et une bascule de fournisseur qui ne requiert qu’une seule ligne de configuration, les champions des modèles propriétaires voient la porte définitivement close à toute hausse tarifaire destinée à rentabiliser leurs investissements colossaux.
Quatre baisses en quatre mois : deux géants déclenchent la guerre des prix
Entre juin et septembre 2026, OpenAI et Anthropic ont raboté de près de 80 % la tarification de leurs modèles vedettes. Les observateurs extérieurs ont d’abord voulu y voir la stratégie classique des plateformes Web : subventionner les services à perte pour éliminer les concurrents, avant d’augmenter unilatéralement les prix une fois le monopole établi. Les bilans techniques réels révèlent pourtant une vérité inverse. Les deux leaders n’ont jamais disposé du pouvoir de fixation des prix nécessaire à une telle manœuvre ; pris dans un engrenage infernal sur les coûts, ils ont perdu toute possibilité de retour en arrière.
La décrue s’est accélérée à un rythme hebdomadaire. Le 26 juin 2026, OpenAI a déployé GPT-5.6 Sol aux côtés de sa version allégée Luna. La grille tarifaire officielle — entrée par million de tokens, sortie par million de tokens et lecture de cache par million de tokens — affichait respectivement $5/$30/$0.50 et $1/$6/$0.10. Quatre jours plus tard à peine, Anthropic répliquait avec Claude Sonnet 5 au tarif agressif de $2/$10/$0.20, tout en affirmant à l’époque qu’il ne s’agissait que d’une promotion temporaire.
La bataille a franchi un palier à la fin du mois de juillet. Le 24 juillet, Anthropic présentait son fleuron très haut de gamme Claude Opus 5 ($5/$25/$0.50). Moins d’une semaine après, le 30 juillet, OpenAI taillait par surprise 80 % dans les prix de GPT-5.6 Luna pour le positionner à $0.20/$1.20/$0.02. Cette initiative a anéanti la moindre prime sur les modèles légers. Anthropic a fini par capituler le 10 août, renonçant à ses hausses programmées pour transformer la tarification promotionnelle de Sonnet 5 en standard définitif.
Ces réajustements défensifs ont rapidement pris des allures d’inertie sectorielle. Le 21 août, OpenAI réduisait encore de 20 % le tarif de GPT-5.6 Sol à $4/$20/$0.40. Les prix catalogue des modèles phares ont ainsi été divisés par deux à plusieurs reprises en quelques mois, crevant pour de bon la bulle de la rente technologique.
Le vrai levier de la facture : plus de 90 % des coûts résident dans le cache
Ceux qui analysent superficiellement les tarifs des LLM ont tendance à ne scruter que les colonnes d’entrée et de sortie. Sur la facture réelle des développeurs, c’est pourtant la troisième colonne qui dicte la sentence : le tarif unitaire de la lecture de cache (Prompt Cache Read).
Lorsqu’un ingénieur fait appel à un assistant de programmation, chaque ligne modifiée implique de réexpédier l’historique complet de la session et les fichiers de contexte du projet. Ces éléments récurrents ne nécessitent pas un calcul d’inférence approfondi à partir de zéro : la mémoire VRAM réutilise directement les états KV précalculés. Ce mécanisme, connu sous le nom de prompt caching, représente 96 % à 99 % du volume total de tokens consommés dans les architectures d’agents, avec des taux d’atteinte du cache qui se maintiennent couramment entre 90 % et 100 %.
Dès lors, les prix affichés pour les tokens d’entrée et de sortie ne concernent que moins de 5 % du trafic effectif. Qu’un fournisseur baisse son tarif de lecture de cache de 75 %, et la facture finale de l’entreprise s’effondre mécaniquement de 70 % à 75 %.
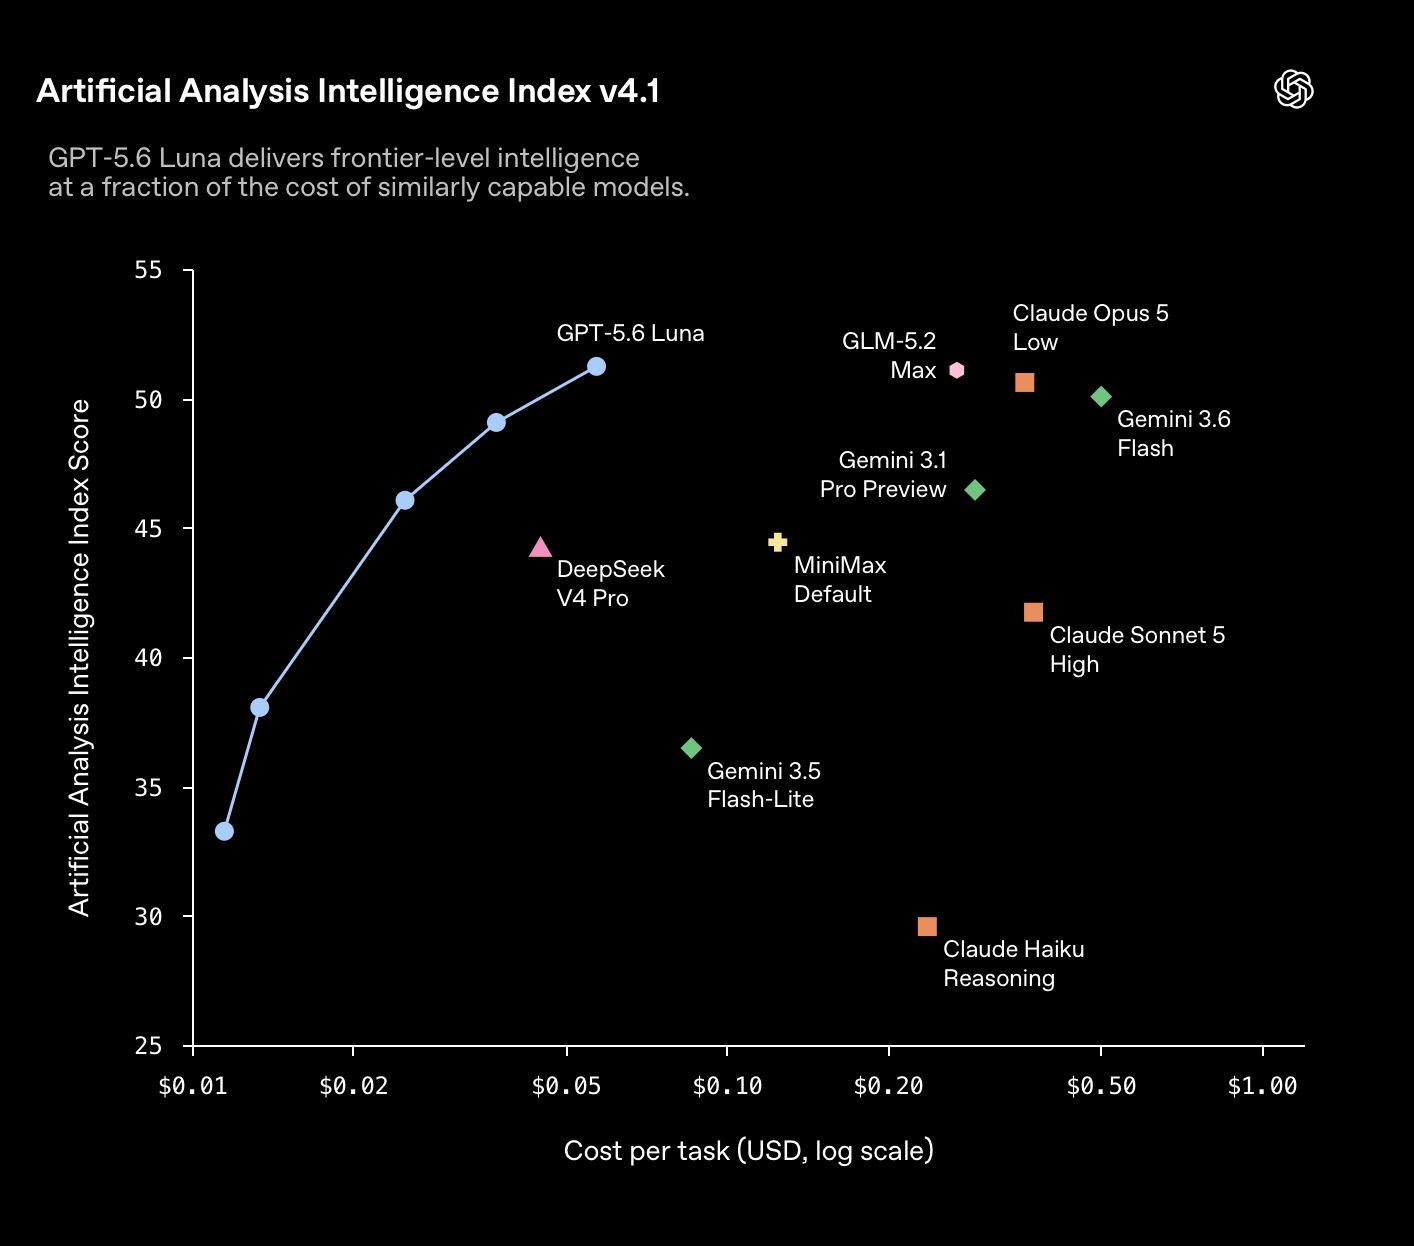 Figure : Distribution de la qualité des modèles par rapport au coût unitaire par tâche après 80 % de baisse de prix. Source : OpenAI (via minimaxir.com)
Le duel de septembre entre les deux rivaux s’est joué directement sur ce levier financier. Le 1er septembre, Anthropic lançait Fable 5.1 ($10/$50/$0.25), réduisant d’un coup de 75 % les frais de lecture de cache. OpenAI a riposté le 3 septembre avec un modèle aux capacités supérieures, GPT-6 Astra ($10/$50/$1), mais son tarif de cache plus élevé l’a immédiatement pénalisé sur le plan du rapport coût-efficacité.
Le 22 septembre, les deux géants se sont affrontés le même jour. OpenAI a dévoilé GPT-6 Sol ($2/$10/$0.20) et GPT-6 Luna ($0.10/$0.50/$0.01), divisant par deux les coûts d’entrée et de sortie par rapport aux barèmes déjà remisés. Anthropic a lancé en simultané Claude Opus 5.5 ($4/$20/$0.20), confirmant que la réduction de ses coûts d’exploitation internes permettait de réduire les dépenses effectives des clients de 40 % à 60 %. Début octobre, répondant aux retours sur certaines variations de performance de GPT-6 Sol, OpenAI a sorti GPT-6.1 Sol, abaissant la lecture de cache à $0.10 et scellant une baisse globale de 75 % sur l’ensemble de son catalogue en quatre mois.
29 prestataires pour un même modèle : changer de fournisseur en une ligne de code
Si les mastodontes de l’IA ont consenti à de telles concessions, c’est avant tout sous la pression conjointe du monde open source et du réseau grandissant des hébergeurs de calcul. Si les acteurs propriétaires s’étaient obstinés à préserver leurs marges, leurs clients auraient immédiatement migré vers des solutions alternatives.
Le front open source avait abattu ses cartes dès le printemps. Lancé en avril 2026, DeepSeek V4 Flash 0420 s’affichait au tarif plancher de $0.14/$0.28/$0.0028. Le coût de sa lecture de cache n’atteignait que 2 % de son prix d’entrée, bien en deçà des 5 % à 10 % longtemps défendus par les leaders américains. Le 17 octobre, la version perfectionnée DeepSeek V4.1 Flash 1017 doublait quasiment ses scores sur les benchmarks de référence tout en préservant son niveau tarifaire dérisoire de $0.15/$0.60/$0.003.
Une menace plus redoutable encore a émergé de la décentralisation de la distribution de calcul. En mai 2026, seules 13 entreprises indépendantes proposaient des services managés pour DeepSeek V4 Flash. Lors de la mise à jour d’octobre, ce contingent atteignait 29 fournisseurs distincts. Sur des plateformes comme Cloudflare ou DeepInfra, les tarifs réels d’appel se situent désormais dans une fourchette inférieure à 10 % d’écart avec le prix officiel du créateur du modèle.
Kimi K3.1 Pro de Moonshot AI a accentué cette pression extérieure. Commercialisé à $2/$10/$0.20, il talonne Opus 5.5 dans les tests comparatifs, et ses poids doivent être rendus publics le 4 novembre. Dès que ces poids seront accessibles, des dizaines d’hébergeurs s’aligneront instantanément pour proposer une inférence équivalente à prix coûtant.
Les protocoles d’appel d’API de LLM sont devenus universellement standardisés. Pour une entreprise, remplacer le prestataire de calcul sous-jacent ne demande plus de remanier le code métier ni d’écrire des couches d’adaptation complexes. Il suffit aux équipes techniques de changer une simple URL d’API dans un fichier de configuration. Face à un coût de transition nul, toute velléité d’augmenter les tarifs se traduit par une fuite immédiate des clients.
Le paradoxe des passerelles : les prix chutent de 60 %, les dépenses explosent
L’effondrement du coût unitaire du calcul a engendré une dynamique surprenante dans les environnements de production réels : alors que le prix du token atteignait des plus-bas historiques, les factures globales des entreprises continuaient d’enfler.
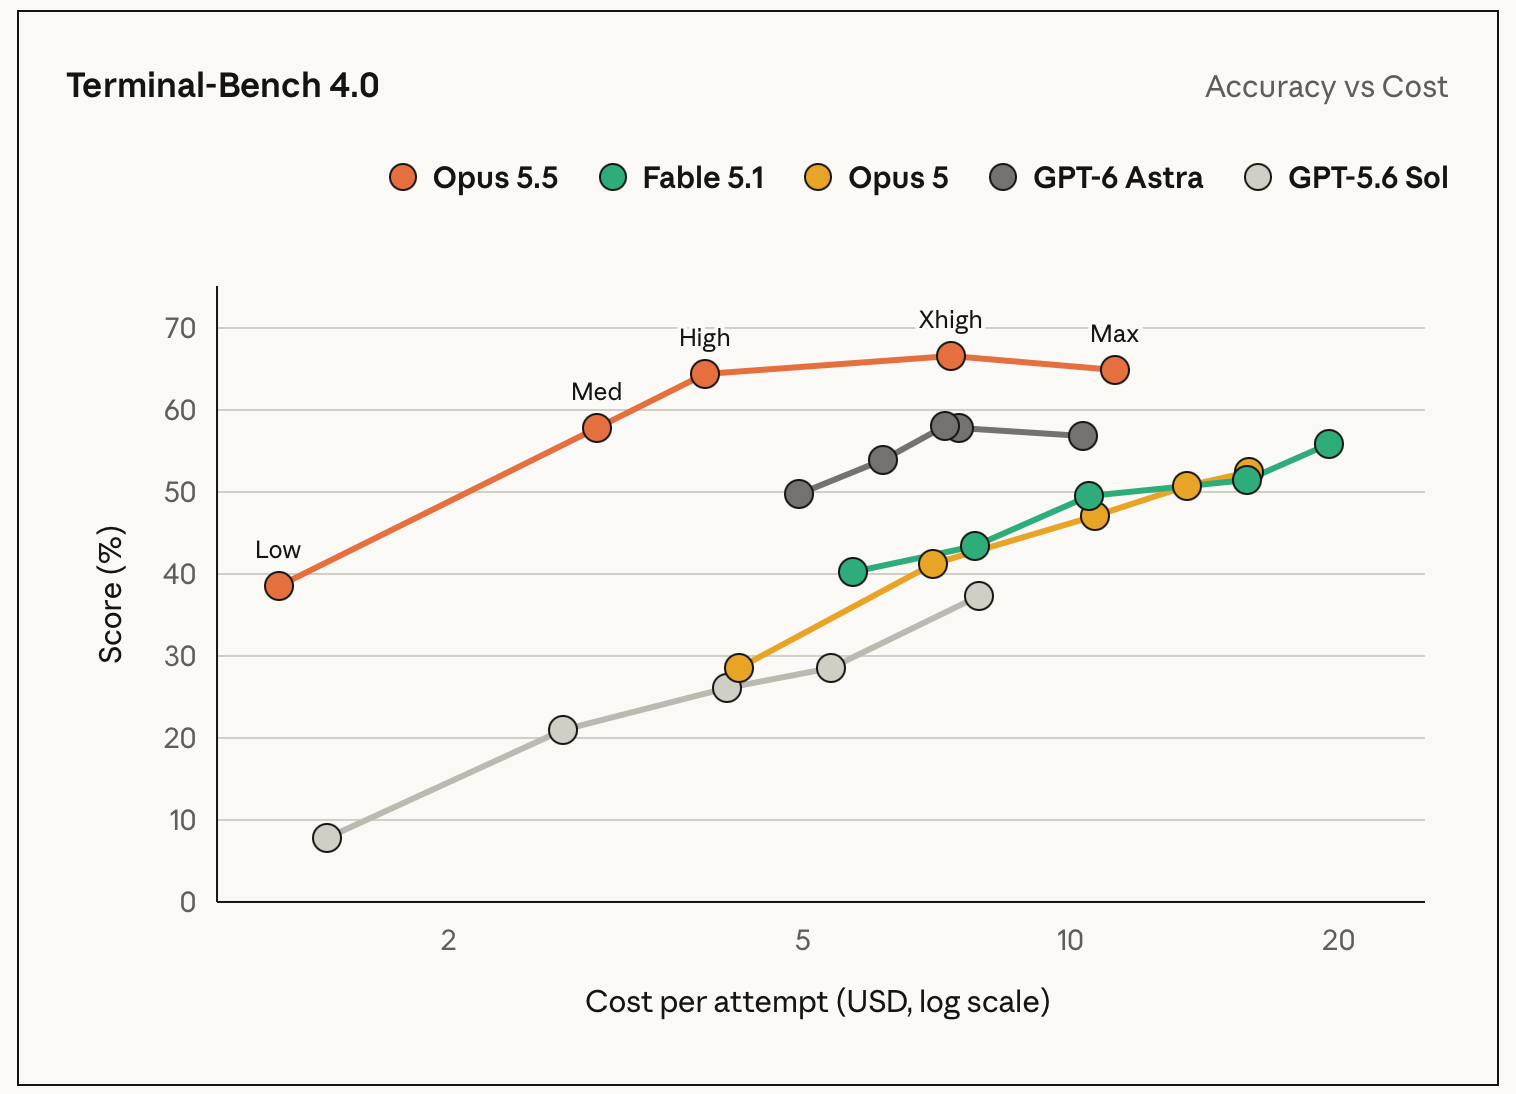 Figure : Performances globales et coûts d’appel pour Claude Opus 5.5. Source : Anthropic (via minimaxir.com)
D’après les relevés de Vercel AI Gateway, le montant moyen dépensé par les développeurs pour un token unitaire est tombé en septembre 2026 à 43,3 % de son niveau d’avril. Et pourtant, sur cette même période, les dépenses consolidées des comptes d’entreprise ont poursuivi une trajectoire résolument ascendante.
Ce paradoxe s’explique par une mutation structurelle des usages. À l’époque où les tokens étaient onéreux, les développeurs rationnaient minutieusement chaque requête et passaient des heures à épurer leurs invites de commande. Dès lors que la lecture de cache est passée sous la barre des centimes, les équipes ont laissé les agents logiciels tourner en continu sans supervision humaine.
Dans les architectures d’agents modernes, le système déclenche de lui-même des centaines ou des milliers de boucles d’interactions : revues de code récursives, comparaisons d’alternatives en parallèle et tests d’autocorrection. La baisse des tarifs a brisé le plafond de verre de l’usage, libérant une fréquence d’appels exponentielle. Un calcul abordable a engendré une automatisation à très haute densité. L’inférence de pointe est ainsi devenue un bien de consommation courante, aussi fondamental et disponible que l’eau ou l’électricité.
Les acheteurs prennent les commandes : les LLM relégués au rang de commodité
Durant deux décennies, les plateformes Internet ont exécuté le même scénario : subventionner des services grâce au capital-risque pour asphyxier la concurrence, établir une position de force, puis augmenter les tarifs sur une clientèle captive. Dans l’arène de l’inférence des grands modèles de langage, ce modèle économique est définitivement caduc.
L’inférence intelligente constitue au fond une charge de calcul standardisée et hautement interchangeable. Les modèles open source garantissent un niveau d’exigence élevé, tandis que des dizaines d’infrastructures cloud fournissent une capacité de traitement abondante. Aucun laboratoire de recherche ne peut s’arroger un avantage exclusif indéboulonnable, et aucun acteur ne peut empêcher ses clients de partir voir ailleurs.
Les deux figures de proue du secteur ont parfaitement compris ce péril de la banalisation. OpenAI et Anthropic s’efforcent de verrouiller des contrats pluriannuels auprès des grands comptes et intègrent leurs modèles dans des solutions complètes d’environnement de travail, telles qu’OpenAI Dots ou Claude Duet. Les deux entreprises tentent de nouer des liens étroits avec les données et les processus internes des clients pour ériger de nouvelles barrières à la sortie, là où la couche d’API s’est montrée incapable de le faire.
Mais tant que le modèle sous-jacent pourra être substitué entre 29 hébergeurs concurrents au moyen d’un simple commutateur de configuration, la rente technologique ne reviendra pas. Le coût unitaire de l’inférence restera irrémédiablement indexé sur le coût physique du silicium et de l’électricité. Cette dégringolade tarifaire de 80 % en quatre mois scelle la fin de l’ère des superprofits dans l’IA générative. Le marché de la puissance de calcul a définitivement basculé du côté de l’acheteur.
Liens de référence :
- Rapport d’analyse technique sur minimaxir.com
- Discussion technique au sein de la communauté Hacker News