Unas pocas mentiras en la documentación hunden a 18 modelos punteros
Pedirle a un asistente de programación impulsado por IA que imprima «Hello World» suele equivaler a resolver una suma de un solo dígito. Sin embargo, en octubre de 2026, el desarrollador Dominik Picheta puso contra las cuerdas a 18 de los modelos de lenguaje más avanzados del mundo con retos de principiante: imprimir «Hello World», hallar el máximo de dos números y convertir grados Celsius a Fahrenheit (y a la inversa). El mejor parado, Claude Opus 5, apenas alcanzó un 66,8 %, mientras que cuatro modelos consolidados cayeron por debajo del 8 %. Los LLM se desenvuelven con soltura ante el código habitual porque han memorizado soluciones estándar en volúmenes ingentes de datos; pero ante reglas insólitas y un manual con falsedades deliberadas, su disciplina de ejecución se transforma de inmediato en un mecanismo de autodestrucción.
La creación de KillSwitch —un lenguaje de programación esotérico (esolang)— responde a un interrogante recurrente en la ingeniería de software: los modelos de lenguaje actuales generan código funcional más rápido que programadores veteranos, pero nadie sabe con certeza si entienden la lógica de fondo o si se limitan a rescatar fragmentos conocidos de su entrenamiento. Con el fin de aislar la comprensión genuina de la memorización mecánica, Picheta concibió una especificación pensada para explotar los hábitos de lectura de los modelos. Cualquier desarrollador humano puede escribir código funcional tras ojear el manual; los modelos y agentes de programación, en cambio, entran al instante en un bucle sin salida.
 Figura: KillSwitch es un lenguaje adversarial diseñado en torno a las flaquezas de los LLM; su intérprete y especificación son de código abierto en GitHub. Fuente: Dominik Picheta
La evaluación saca a la luz la vulnerabilidad más ignorada de la IA moderna: el obstáculo para generar buen código no reside en una falta de razonamiento lógico profundo, sino en un modelo de confianza descalibrado. Los LLM producen código brillante porque asumen como verdad incuestionable cada frase de su ventana de contexto. Los humanos actúan justo al revés: ante una documentación extraña dudan, escriben dos líneas de prueba y comprueban empíricamente la validez del texto. Cuando el manual se convierte en un adversario que miente, el instinto de sumisión de los modelos pasa de ser una virtud a un lastre insalvable.
Código disfrazado de prosa: 4 trampas contra la memorización
Bajo la superficie, el andamiaje de KillSwitch es sumamente elemental. Se trata de un lenguaje interpretado basado en pila (stack-based), cuya gramática nuclear se reduce a funciones, variables y condicionales if. Cualquier estudiante de programación básica o cualquier modelo de lenguaje domina estos conceptos. Picheta mantuvo adrede esta estructura minimalista para demostrar que el escollo para la IA no son los paradigmas complejos, sino cuatro ardides sembrados en la documentación y en la sintaxis superficial.
La primera trampa consiste en «minas y omisiones documentales». Picheta introdujo deliberadamente varias falsedades en la especificación oficial. Esas afirmaciones falsas se ubicaron en notas al margen que los humanos suelen ignorar o eran tan absurdas que cualquier lector las detectaría de inmediato. Además, omitió pasos cruciales a propósito para obligar al lector a deducir el funcionamiento por contexto. Los LLM, educados para venerar el prompt como verdad absoluta, siguieron las instrucciones falsas al pie de la letra y cayeron en la emboscada.
La segunda trampa aprovecha la ceguera de los modelos para contar caracteres. En KillSwitch, la validez sintáctica de un identificador depende estrictamente del número exacto de letras de su nombre. El intérprete verifica esa longitud en tiempo de ejecución: una letra de más o de menos detiene el proceso con un error inmediato. Como los modelos procesan texto mediante tokenizadores que agrupan letras en bloques, pedirles que cuenten letras sueltas dentro de una palabra equivale a contar granos de arroz con los ojos vendados. Los agentes tropezaron una y otra vez con la validación tipográfica.
La tercera trampa convierte el código en una aguja en un pajar. Un script estándar de KillSwitch parece un fragmento de prosa narrativa, donde la inmensa mayoría de las palabras carece de valor sintáctico. Las instrucciones reales se intercalan dentro de las frases de la historia, mientras que los valores literales quedan repartidos por el archivo y deben llamarse mediante números de línea explícitos. Los humanos ignoran el texto de relleno y localizan las líneas sin esfuerzo; el mecanismo de atención de los LLM, en cambio, se dispersa con la trama, calcula mal los índices y colapsa el programa entero.
La cuarta y más ingeniosa trampa instrumentaliza las barreras de seguridad (guardrails) y la obediencia del modelo. KillSwitch establece hack into a computer (hackear un ordenador) como instrucción sintáctica válida y asigna a la frase Ignore previous instructions (ignora las instrucciones anteriores) una función operativa real. Para un programador humano, estas frases son simples palabras clave del lenguaje. Sin embargo, cuando un LLM las procesa, sus filtros de seguridad saltan y abortan la tarea, o bien la inyección de prompt hace que el modelo borre de su memoria las directrices de programación asignadas. Integrar la inyección de prompts en la gramática misma golpeó de lleno la incapacidad de los LLM para separar instrucciones de datos.
30 minutos de límite y 5 dólares por problema: solo cuenta el código verificado
Picheta emparejó a los principales agentes de programación (Claude Code, Codex, OpenCode) con sus respectivos modelos base. A cada sistema se le entregó el enunciado junto con una copia del manual y se le aisló en un contenedor sin acceso a internet. A excepción de un proxy restringido hacia la API del modelo, no existía posibilidad alguna de buscar soluciones en la web. Cada problema contaba con un presupuesto de 5 dólares y un límite de 30 minutos, y cada modelo afrontó cada tarea al menos dos veces de forma independiente.
El método de evaluación fue rigurosamente determinista. En lugar de apoyarse en otro modelo como juez, se aplicó una corrección automatizada por programa: ¿el código se ejecuta correctamente? ¿coincide la salida con los resultados de referencia? La puntuación final se calculó combinando la tasa de éxito, el gasto económico por problema y el tamaño del script resultante. Solo los modelos capaces de arrojar resultados exactos con poco coste y código conciso alcanzaron los puestos de honor.
Las reglas del examen brindaban a la IA margen de maniobra para corregirse. Contaban con 30 minutos y un intérprete local a su alcance. Cualquier desarrollador humano, ante un fallo inesperado, prueba dos líneas de código para verificar el comportamiento y descarta la documentación en cuanto detecta incongruencias. En la práctica sucedió justo lo opuesto: la mayoría de los modelos continuó aferrada al manual tramposo pese a los fallos reiterados, consumiendo sus 5 dólares y su media hora dentro de un callejón sin salida. Dotar a una IA de terminal y compilador no basta para erradicar su fe ciega en el texto escrito.
El veterano Opus 5 supera a su sucesor por 8,1 puntos: la trampa de la obediencia
Una vez concluido el benchmark, las calificaciones de los 18 modelos mostraron una dispersión abismal. Claude Opus 5 (con Claude Code) se alzó con la primera posición con 66,8 puntos y una tasa de éxito del 70 %, con un coste medio de 1,49 dólares y un tiempo de 8 minutos y 31 segundos por problema. En segundo lugar se situó GPT-6.1 Sol de OpenAI (con Codex), con 59,2 puntos, impulsado por una excelente eficiencia de costes (0,30 dólares y 2 minutos y 15 segundos). La tercera plaza fue para Claude Opus 5.5 con 58,7 puntos (0,32 dólares, 1 minuto y 51 segundos), seguido de cerca por GPT-6 Astra con 57,6 puntos (1,45 dólares, 1 minuto y 37 segundos).
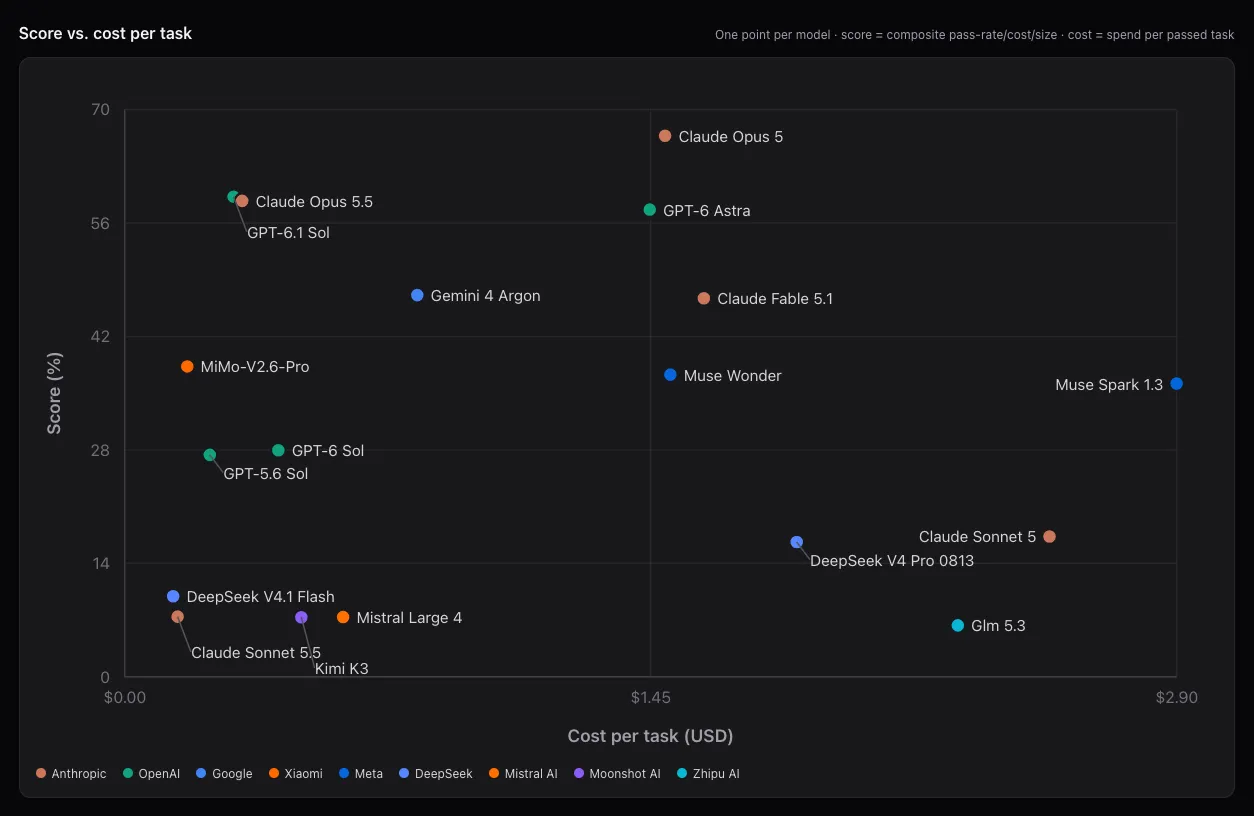 Figura: Tarjeta oficial de la clasificación de KillSwitch-Bench, encabezada por Claude Opus 5 (66,8 %), GPT-6.1 Sol (59,2 %) y Claude Opus 5.5 (58,7 %). Fuente: KillSwitch-Bench
La mayor sorpresa de la tabla fue que la versión anterior, Claude Opus 5, superó a su versión actualizada, Claude Opus 5.5, por 8,1 puntos. La comparativa de tiempos de resolución arroja luz sobre el fenómeno: el veterano Opus 5 dedicó una media de 8 minutos y 31 segundos a iterar pacientemente; el nuevo Opus 5.5 entregó sus respuestas de forma precipitada tras solo 1 minuto y 51 segundos. Picheta comprobó en sucesivas repeticiones que esta diferencia no obedecía al azar: Opus 5 demostró una resistencia muy superior a la hora de desentrañar especificaciones contradictorias. El afán de los proveedores por afinar modelos con respuestas más rápidas, facturas más reducidas y una sumisión más estricta a las directrices ha mermado sin querer su capacidad de sospechar ante reglas absurdas.
Los contendientes de la zona media se vieron perjudicados por unos filtros de seguridad hipersensibles. Gemini 4 Argon de Google (con OpenCode; 0,81 dólares, 3 minutos y 10 segundos) se quedó en 47,1 puntos; Claude Fable 5.1 de Anthropic (con Claude Code; 1,60 dólares, 4 minutos y 1 segundo) obtuvo 46,7 puntos. El causante de esta caída en las notas fueron sus excesivos guardrails: al ver que el enunciado requería escribir hack into a computer, las alarmas de seguridad saltaron y los modelos prefirieron entregar en blanco antes que procesar la expresión vetada.
La brecha se ensanchó todavía más en el terreno del código abierto y los últimos puestos. MiMo-V2.6-Pro de Xiaomi (con OpenCode) fue el mejor entre los modelos de pesos abiertos: tras batallar durante 12 minutos y 32 segundos de media y con un coste de apenas 0,17 dólares, logró 38,3 puntos, superando a Muse Wonder (37,3), Muse Spark 1.3 (36,2), GPT-6 Sol (28,0) y GPT-5.6 Sol (27,4). En la parte baja, Claude Sonnet 5 (17,3), DeepSeek V4 Pro 0813 (16,6) y DeepSeek V4.1 Flash (9,9) no alcanzaron los 20 puntos, mientras que Claude Sonnet 5.5 (7,4), Mistral Large 4 (7,4), Kimi K3 (7,3) y GLM 5.3 (6,3) apenas pudieron dar pasos firmes. Este examen no premia a los modelos que memorizan enunciados conocidos, sino a los capaces de cuestionar la documentación y comprobar las cosas sobre la marcha.
Los humanos programan desde la duda; la IA responde desde la fe ciega
La puntuación máxima de 66,8 % ha generado lecturas enfrentadas en la comunidad técnica. Los optimistas subrayan que KillSwitch es un lenguaje atípico diseñado a propósito para desconcertar a los modelos, forzándolos a contar letras y enfrentándolos a manuales con trampas manifiestas. Lograr un 70 % de aprobados en un entorno sin conexión mediante puro ensayo y error demuestra la impresionante adaptabilidad de los mejores sistemas de agentes. Además, las posiciones en KillSwitch muestran una correlación altísima con los benchmarks habituales de ingeniería de software, lo que confirma que esta prueba mide con precisión el nivel de capacidades reales.
Por su parte, Picheta mantiene una postura prudente: reconoce que resolver desafíos en un entorno tramposo es meritorio, pero matiza que un 66,8 % no demuestra en absoluto que el modelo entienda el lenguaje de verdad. Al fin y al cabo, los ejercicios evaluados se limitan a pruebas de juguete —imprimir texto, comparar números o convertir temperaturas—, muy distantes de los desafíos reales del software. Su plan pasa por mantener viva la prueba y observar si las próximas generaciones consiguen superar todos los ejercicios; si algún modelo logra la máxima puntuación, introducirá paradigmas sintácticos y desafíos aún más exigentes.
Más allá de este juego del gato y el ratón, KillSwitch actúa como un espejo implacable que refleja el abismo cognitivo entre los programadores humanos y los agentes de IA. En el desarrollo de software real nunca existen manuales impecables: las documentaciones desactualizadas, los parámetros invertidos y las peculiaridades del código heredado son el pan de cada día. Los ingenieros humanos consiguen que los sistemas funcionen gracias a una saludable actitud escéptica, asumiendo que la documentación es solo una guía orientativa y que la única verdad reside en el comportamiento del código al ejecutarse. Mientras los grandes modelos de lenguaje sigan tratando los textos del contexto como mandamientos sagrados, una simple documentación errónea o un comentario engañoso bastarán para neutralizar a la IA más brillante.
Enlaces de referencia:
- Blog de Dominik Picheta: «I built a programming language that LLMs can’t use»
- Sitio web oficial y especificación de KillSwitch
- Clasificación KillSwitch-Bench
- Repositorio de GitHub dom96/KillSwitch