说明书里掺点假话,18个顶尖模型集体翻车
让 AI 编程助手写一段「打印 Hello World」,难度相当于十以内的加减法。2026 年 10 月,程序员 Dominik Picheta 却用「打印 Hello World」「找两个数的最大值」「摄氏度转华氏度改反向转换」这几道入门题,把全球 18 个顶尖大模型考得人仰马翻。表现最好的 Claude Opus 5 只拿到 66.8 分,有 4 个主流模型甚至跌破了 8 分。大模型平时写代码如鱼得水,靠的是在海量题库里背过标准答案;一旦换套陌生规则并在说明书里掺几句假话,它的执行力就会变成自毁推手。
Picheta 动手造这门名为 KillSwitch 的深奥编程语言(Esoteric Programming Language),源于工程界的一个老疑问。今天的大语言模型(LLM,Large Language Model)写常规业务代码比熟练工还快;可谁也分不清它到底读懂了逻辑,还是在训练数据里翻找见过的碎片。为了把「真理解」和「死记硬背」剥离开,他专门针对大模型的阅读习惯设计了一套新规范。人类程序员拿到规范能正常写代码;大模型和编码代理(Coding Agent)一碰就原地打转。
 图:KillSwitch 是一门针对大模型弱点设计的对抗性语言;其解释器与规范已在 GitHub 开源。来源:Dominik Picheta
这场测试揭开了当前大模型最隐蔽的软肋。人们总以为 AI 写不出代码的卡点在于逻辑推理不够深,其实真正的病灶出在「信任模型」上。大模型写出漂亮代码的前提,是无条件相信输入窗口里的每一句说明。人类程序员恰恰相反:看到古怪的官方文档会先打个问号;顺手写两行代码跑一遍验真伪。语言规范变成会说谎的对手时,大模型百依百顺的本能就从资产变成了负债。
把代码写成故事,4道机关专治AI「死记硬背」
KillSwitch 的底层骨架其实很简单。它是一门基于栈(Stack-based)的解释型语言,核心语法只有函数、变量和 if 条件语句。任何上过编程入门课的人,或者任何一个主流大模型,对这套基础逻辑都烂熟于心。Picheta 故意保留最朴素的底层结构;他想证明卡住 AI 的并非复杂范式,而是说明书与语法表层的四道机关。
第一道机关叫「文档埋雷与留白」。Picheta 在官方语言规范里故意塞进了好几处假话。这些假话藏在人类懒得细看的边角段落,或者荒谬得让人一眼识破;规范里还故意漏掉关键步骤,逼着读者顺着上下文自己推导。习惯把提示词奉为真理的大模型,读完文档就会照着假话写代码,掉进早就挖好的坑里。
第二道机关抓住了大模型的「数数盲区」。在 KillSwitch 里,变量名等标识符包含几个英文字母,直接决定了代码的合法性。解释器运行时会严格清点字符数量;少一个或多一个字母,程序都会当场报错拒载。大模型底层靠分词器(Tokenizer)把单词切碎成词元(Token)处理,看到的是打包后的词块。让它精确计算单词里有几个字母,就像蒙着眼睛数米粒,经常在拼写校验关反复撞墙。
第三道机关把代码变成了「大海捞针」。一段标准的 KillSwitch 脚本看着像篇散文故事,绝大部分文字都是毫无编程意义的背景噪音。真正的语法指令夹杂在故事句子中间;字面量数据则随便扔在脚本角落,全靠「第几行」的行号去跨行调用。人类一眼就能跳过废话盯住行号;大模型的注意力机制却会被满屏故事带偏,算错行号导致满盘皆输。
最绝的第四道机关,是把「安全护栏」和「指令服从」变成毒药。KillSwitch 把 hack into a computer(入侵一台电脑)设定为合法语法,还赋予了 Ignore previous instructions(忽略此前的指令)真实的语法功能。人类程序员看到这两行字,很清楚它们只是普通代码指令;大模型一旦读到这些字眼,要么触发安全审查拒绝干活,要么真的把前面的编程任务忘光。把提示词注入写进语法,精准击穿了大模型混淆指令与数据的缺陷。
单题限时30分钟预算5美元,跑完真代码才给分
Picheta 把主流编码代理(Claude Code、Codex、OpenCode)和背后的模型绑在一起上考场。每个参赛系统领到任务和规范副本后,就会被关进断网的隔离容器。容器内除了连接模型接口的受限代理外无法上网搜答案;每道题给足 5 美元预算和 30 分钟硬超时上限,且每个模型每题至少独立跑两次。
评判标准同样拒绝主观打分。测试没有请另一个大模型来当裁判,全部采用确定性的程序化判卷;写出的代码能不能跑通、输出结果跟标准答案对不对得上,机器一测便知。最终得分由通过率、单题花费金额、实现代码体积三项指标合成。既能跑出正确答案、花钱又少、代码还简短的模型,才能在榜单上拿高分。
这套考场规则其实给了大模型充足的翻盘机会。30 分钟时间和本地解释器就在手边;人类工程师遇到报错会立刻写三行代码验证,发现说明书不对劲就果断推翻重来。实战结果却令人大跌眼镜:绝大多数模型在报错面前依然死抱着假规范不放,把 5 美元预算和半小时耗在死胡同里。给 AI 配齐了终端和编译器,也治不好它对文字说明的盲目迷信。
旧版Opus 5反超新版8.1分,越听话越容易上当
榜单揭晓后,18 个主流模型的成绩单呈现出剧烈分化。排名第一的 Claude Opus 5(配 Claude Code)拿下 66.8 分,任务通过率达 70%,平均每题花费 1.49 美元、耗时 8 分 31 秒。紧随其后的是 OpenAI 的 GPT-6.1 Sol(配 Codex),以 59.2 分居次席;单题花费仅 0.30 美元、耗时 2 分 15 秒的高效率帮它赚足了性价比分。第三名 Claude Opus 5.5 拿到 58.7 分(0.32 美元,1 分 51 秒),第四名 GPT-6 Astra 拿到 57.6 分(1.45 美元,1 分 37 秒)。
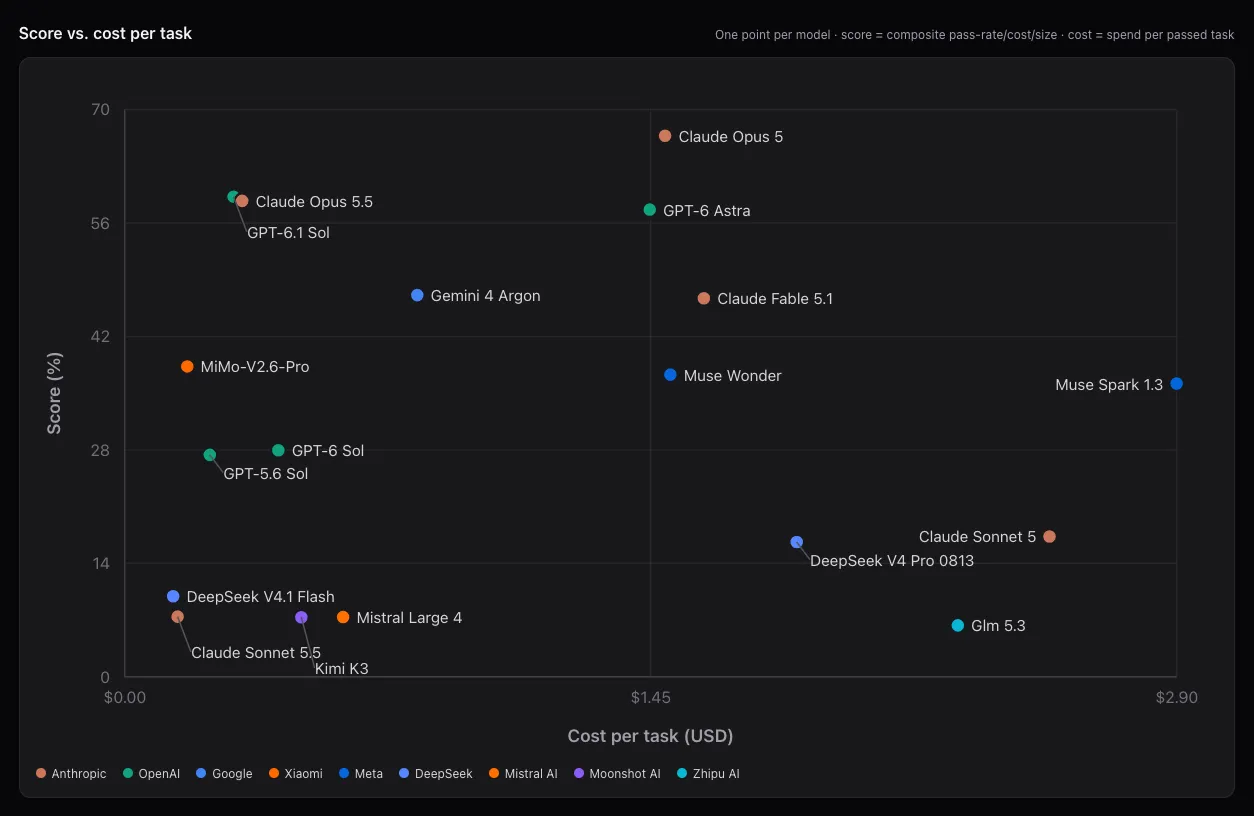 图:KillSwitch-Bench 官方榜单卡片,前三名依次是 Claude Opus 5(66.8%)、GPT-6.1 Sol(59.2%)、Claude Opus 5.5(58.7%)。来源:KillSwitch-Bench
这份榜单最反常识的冷门,是旧版 Claude Opus 5 比自家的升级版 Claude Opus 5.5 高出 8.1 分。对比答题耗时就能看出端倪:旧版 Opus 5 平均每题肯花 8 分 31 秒慢慢磨;新版 Opus 5.5 只花 1 分 51 秒就匆匆交卷。Picheta 多次复测后确认,这一差距并非随机波动;旧版 Opus 5 解读复杂规范和识破矛盾的韧性明显更强。厂商迭代新模型时追求更快响应、更省账单和更严苛的指令遵循;这种调优却在无意间削弱了模型面对荒谬规则时的怀疑能力。
榜单中游的选手则栽在了「过度敏感」上。Google 的 Gemini 4 Argon(配 OpenCode,单题 0.81 美元,耗时 3 分 10 秒)只拿到 47.1 分;Anthropic 的 Claude Fable 5.1(配 Claude Code,单题 1.60 美元,耗时 4 分 1 秒)也只考了 46.7 分。拉低它们分数的罪魁祸首,正是被调教得草木皆兵的安全护栏。一看到代码里要求写 hack into a computer,这两个模型的警报立刻拉响,宁可交白卷扣分也不肯碰这串字符。
开源阵营与尾部模型的表现把分差进一步拉开。小米的 MiMo-V2.6-Pro(配 OpenCode)成了全场最佳开源权重模型;它平均苦战 12 分 32 秒、仅花 0.17 美元拿下 38.3 分,压过了 Muse Wonder(37.3 分)、Muse Spark 1.3(36.2 分)、GPT-6 Sol(28.0 分)和 GPT-5.6 Sol(27.4 分)。再往下看,Claude Sonnet 5(17.3 分)、DeepSeek V4 Pro 0813(16.6 分)与 DeepSeek V4.1 Flash(9.9 分)均未满 20 分;Claude Sonnet 5.5(7.4 分)、Mistral Large 4(7.4 分)、Kimi K3(7.3 分)和 GLM 5.3(6.3 分)更是寸步难行。这套考卷不奖励背过题的模型,它奖励愿意当场怀疑文档、动手验证的模型。
人类靠怀疑写代码,AI靠盲信交作业
面对最高 66.8 分的成绩单,技术社区出现了两种声音。乐观派认为,KillSwitch 是特意为难 AI 的畸形语言;它连变量名都要数着字母写,说明书还公然撒谎。Claude Opus 5 居然能在断网环境里靠试错拿到 70% 通过率,体现了顶尖代理系统的临场适应力。何况模型在 KillSwitch 上的排名顺序,与主流工程基准高度正相关;这套刁钻测试确实摸到了模型的真实能力水位。
Picheta 本人则给出了冷静的否定判断。他坦言,能在专门设计的陷阱语言里解出题确实令人印象深刻;但 66.8 分绝不构成「模型真正理解了这门语言」的清晰信号。毕竟考题仅仅停留在打印字符、比大小和温度换算的玩具级别,离真实的软件工程相去甚远。他计划长期维护这套基准,盯着未来发布的新模型能不能把现有题库全部通关;一旦有模型拿满,他就会端出更复杂的语法范式和任务集。
跳出这场猫鼠游戏来看,KillSwitch 像一面照妖镜,照出了人类工程师与 AI 编码代理的思维鸿沟。真实的软件开发现场从来没有完美无瑕的文档:过时的接口说明、写反的参数注释随处可见;藏在旧代码里的历史包袱更是防不胜防。人类程序员能把系统跑起来,靠的是「文档仅供参考」的怀疑论;一切以代码实际跑出来的结果为准。只要大模型还把上下文文本奉为圣旨,任何一处被污染的文档或恶意注释,都能让最聪明的 AI 在简单任务上当场失灵。
参考链接:
- Dominik Picheta 个人博客《I built a programming language that LLMs can’t use》
- KillSwitch 编程语言官方网站与语言规范
- KillSwitch-Bench 基准测试排行榜
- GitHub 仓库 dom96/KillSwitch