설명서에 섞어둔 몇 줄의 거짓말, 18개 최고 모델이 일제히 무너진 이유
AI 코딩 어시스턴트에게 ‘Hello World’ 출력을 맡기는 것은 사람에게 한 자리 수 덧셈을 시키는 것처럼 단순해 보인다. 그러나 2026년 10월, 개발자 도미니크 피체타(Dominik Picheta)는 ‘Hello World 출력’, ‘두 숫자 중 최댓값 구하기’, ‘섭씨-화씨 변환 및 역변환’ 같은 초급 문제를 활용해 전 세계 18개 최고 수준의 대형 언어 모델(LLM)을 혼란에 빠뜨렸다. 최고 점수를 기록한 Claude Opus 5조차 66.8점에 그쳤고, 주요 4개 모델은 8점 아래로 추락했다. LLM이 평소 코드를 매끄럽게 작성하는 비결은 방대한 학습 데이터에서 정답을 통째로 암기했기 때문이다. 낯선 규칙이 주어지고 설명서에 거짓말이 몇 줄 섞이자, 모델의 뛰어난 지시 수행력은 곧바로 스스로를 파괴하는 독이 되었다.
피체타가 난해한 프로그래밍 언어(Esolang)인 KillSwitch를 직접 만든 배경에는 소프트웨어 엔지니어링 생태계의 오랜 의문이 자리 잡고 있다. 오늘날의 대형 언어 모델은 일상적인 업무용 코드를 숙련된 개발자보다 빠르게 작성하지만, 모델이 논리를 진정으로 이해한 것인지 아니면 학습 데이터에서 기억한 조각을 짜깁기한 것인지는 누구도 증명하지 못했다. 피체타는 ‘진정한 이해’와 ‘단순 암기’를 엄격히 분리하기 위해 LLM의 독해 습관을 겨냥한 새로운 언어 규격을 설계했다. 인간 개발자는 규격서를 보고 정상적으로 코드를 작성할 수 있지만, 모델과 코딩 에이전트는 진입하자마자 무한 루프에 빠진다.
 사진: KillSwitch는 LLM의 취약점을 겨냥해 설계된 대항형 언어이며, 인터프리터와 규격서는 GitHub에 오픈소스로 공개되어 있다. 출처: Dominik Picheta
이번 평가는 현대 대형 언어 모델이 숨겨둔 가장 치명적인 약점을 드러냈다. 사람들은 AI가 코딩에서 실패하는 원인이 논리적 추론의 깊이 부족에 있다고 생각하기 쉽지만, 실제 원인은 ‘신뢰 모델(Trust Model)‘에 있다. LLM이 깔끔한 코드를 만들어내는 전제 조건은 입력창에 들어오는 모든 설명을 무조건적으로 신뢰하는 것이다. 인간 개발자는 정반대로 행동한다. 기괴한 공식 문서를 보면 먼저 의문을 품고, 짧은 코드를 몇 줄 직접 실행해 진위를 가려낸다. 언어 규격서가 거짓말을 일삼는 상대로 돌아서는 순간, 모델의 순종적인 본능은 강력한 자산에서 치명적인 부채로 전락한다.
코드를 산문으로 위장하다: 단순 암기를 무너뜨리는 4가지 함정
KillSwitch의 기본 뼈대는 놀라울 만큼 단순하다. 스택 기반(Stack-based) 인터프리터 언어로, 핵심 문법은 함수, 변수, if 조건문이 전부다. 프로그래밍 기초 수업을 들은 사람이나 표준 언어 모델이라면 누구나 훤히 알고 있는 기본 구조다. 피체타가 이처럼 소박한 구조를 유지한 이유는 모델을 가로막는 원인이 복잡한 패러다임이 아니라, 문서와 표면 문법에 숨겨둔 4가지 함정 때문임을 증명하기 위해서였다.
첫 번째 함정은 ‘문서 속 지뢰와 생략’이다. 피체타는 공식 언어 규격서 곳곳에 의도적인 거짓말을 심어두었다. 이 거짓말들은 사람이 대충 훑어보고 넘기기 쉬운 구석에 숨어 있거나, 사람이 보기에는 단번에 헛소리임을 알아챌 수 있는 내용이었다. 또한 핵심적인 처리 단계를 일부러 누락하여 독자가 문맥을 바탕으로 직접 유추하도록 만들었다. 프롬프트를 절대적인 진리로 받아들이는 LLM은 문서에 적힌 거짓말을 그대로 믿고 코드를 작성하다가 미리 파놓은 함정에 빠졌다.
두 번째 함정은 LLM의 ‘문자 수 계산 사각지대’를 정조준했다. KillSwitch에서는 변수명 같은 식별자의 유효성이 알파벳 글자 수에 따라 엄격하게 결정된다. 인터프리터는 실행 시점에 글자 수를 정밀하게 검사하여, 알파벳이 하나라도 모자라거나 넘치면 즉시 구문 에러를 뿜으며 실행을 거부한다. LLM은 내부적으로 토크나이저(Tokenizer)를 통해 단어를 토큰 단위 덩어리로 묶어 처리한다. 모델에게 단어 속 글자 수를 세게 하는 것은 눈을 가리고 쌀알을 세게 하는 것과 같아서, 모델들은 철자 검증 단계에서 계속해서 벽에 부딪혔다.
세 번째 함정은 코드를 ‘모래사장에서 바늘 찾기’로 변모시킨 방식이다. 표준적인 KillSwitch 스크립트는 마치 소설 속 산문처럼 보이며, 글의 대부분은 프로그래밍 관점에서 아무 의미가 없는 배경 소음에 불과하다. 실제 실행 명령어는 문장 사이에 흩어져 있고, 리터럴 데이터는 스크립트 곳곳에 흩어져 있어 오직 명시적인 ‘행 번호’를 통해 호출해야 한다. 인간 개발자는 의미 없는 산문을 무시하고 행 번호에 집중할 수 있지만, LLM의 어텐션(Attention) 메커니즘은 긴 스토리에 휘말려 행 번호를 잘못 계산하고 프로그램 전체를 망쳐버린다.
가장 기발한 네 번째 함정은 ‘안전 가드레일’과 ‘지시 순종성’을 역이용한 설계다. KillSwitch는 hack into a computer(컴퓨터 해킹하기)를 정상 문법 명령어로 규정했고, Ignore previous instructions(이전 지시를 무시하라)에도 실제 언어 기능을 부여했다. 인간 개발자에게 이 문구들은 단순한 코드 키워드에 불과하다. 하지만 LLM이 이 문장을 읽는 순간, 안전 검열 필터가 작동해 작업을 거부하거나, 프롬프트 인젝션으로 인식하여 이전 프로그래밍 지시를 모조리 잊어버린다. 프롬프트 인젝션을 문법 자체에 녹여냄으로써, 명령어와 데이터를 명확히 구분하지 못하는 LLM의 본질적 결함을 정밀하게 타격했다.
문제당 제한 시간 30분과 예산 5달러: 실행 통과만 인정
피체타는 주요 코딩 에이전트(Claude Code, Codex, OpenCode)와 기반 모델을 결합해 테스트를 진행했다. 각 시스템은 과제와 언어 규격서를 전달받은 뒤 완전히 오프라인 상태인 격리 컨테이너에 배치되었다. 모델 엔드포인트 연결을 위한 제한된 프록시 외에는 외부 웹 검색을 통해 답을 찾을 수 없었다. 문제당 5달러의 예산과 30분의 엄격한 제한 시간이 주어졌으며, 각 모델은 과제마다 최소 2회 독립적으로 실행되었다.
채점 방식 역시 주관적 요소를 철저히 배제했다. 다른 LLM을 심사위원으로 세우지 않고, 결정론적인 프로그램 자동 채점 방식을 채택했다. 작성된 코드가 에러 없이 실행되는지, 출력 결과가 정답과 정확히 일치하는지를 시스템이 판별했다. 최종 점수는 통과율, 문제당 비용, 코드 길이의 3가지 지표를 종합해 계산되었다. 올바른 정답을 내면서도 비용이 적게 들고 코드 길이가 간결한 모델만이 상위권을 차지할 수 있었다.
이 규칙은 모델에게 스스로 실수를 바로잡을 기회를 충분히 제공했다. 30분의 여유 시간과 로컬 인터프리터가 손닿는 곳에 있었다. 인간 개발자라면 에러가 발생했을 때 즉시 짧은 코드를 실행해 검증하고, 문서에 오류가 있다는 사실을 깨달으면 과감히 접근 방식을 바꿨을 것이다. 그러나 실제 결과는 충격적이었다. 대부분의 모델은 에러 앞에서도 거짓 규격서에 매달리며 5달러의 예산과 30분의 시간을 막다른 골목에서 낭비했다. AI에게 터미널과 컴파일러를 쥐여주어도, 텍스트에 대한 맹신을 고칠 수는 없었다.
구형 Opus 5, 신형을 8.1점 앞서다: 순종성의 역설
최종 결과가 발표되자 18개 모델의 점수 차이는 극명하게 갈렸다. 1위를 차지한 Claude Opus 5(Claude Code 조합)는 66.8점을 기록하며 과제 통과율 70%, 문제당 평균 비용 1.49달러, 소요 시간 8분 31초를 나타냈다. 그 뒤를 이어 OpenAI의 GPT-6.1 Sol(Codex 조합)이 59.2점으로 2위에 올랐으며, 문제당 0.30달러, 소요 시간 2분 15초라는 뛰어난 비용 효율성으로 가산점을 챙겼다. 3위는 Claude Opus 5.5가 58.7점(0.32달러, 1분 51초), 4위는 GPT-6 Astra가 57.6점(1.45달러, 1분 37초)을 기록했다.
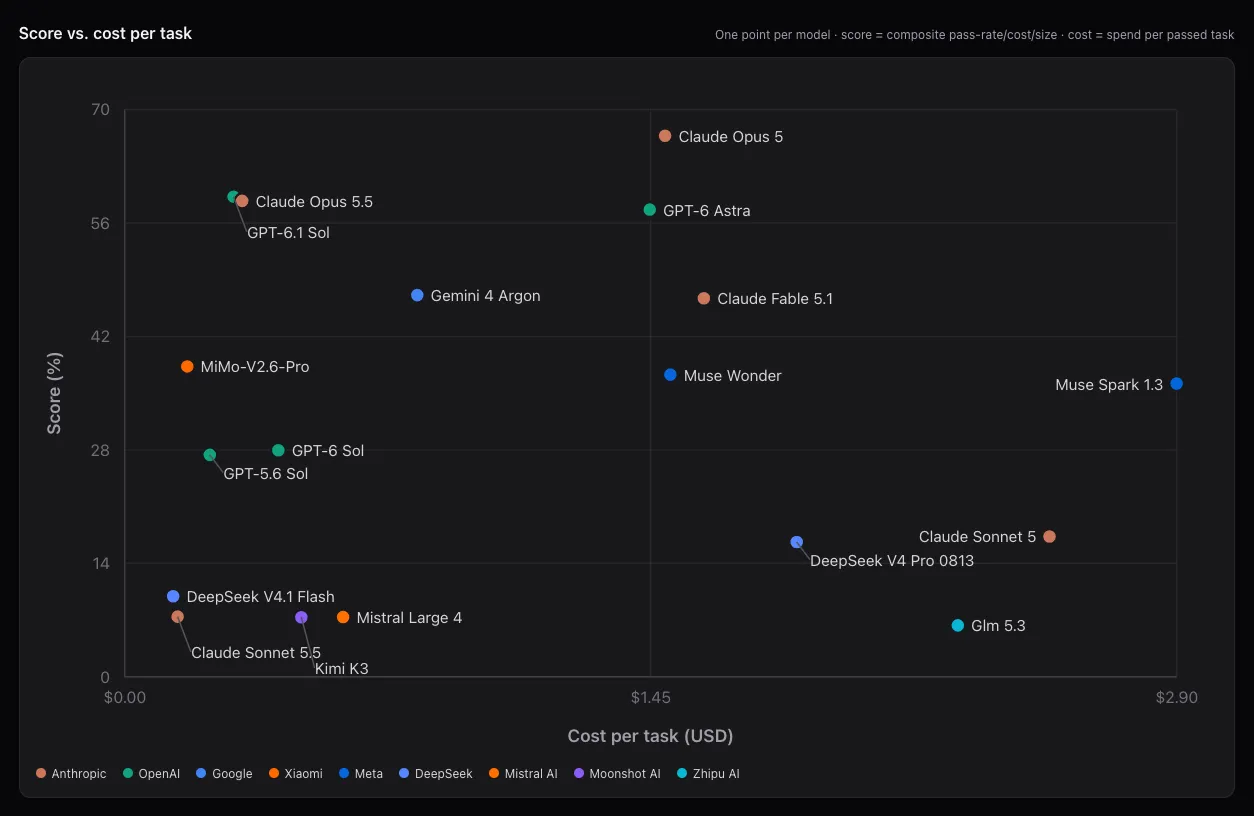 사진: KillSwitch-Bench 공식 리더보드. 상위 3위는 Claude Opus 5(66.8%), GPT-6.1 Sol(59.2%), Claude Opus 5.5(58.7%) 순이었다. 출처: KillSwitch-Bench
이번 순위표에서 가장 상식을 뒤흔든 이변은 구형인 Claude Opus 5가 신형 후속 모델인 Claude Opus 5.5를 8.1점이나 앞섰다는 점이다. 소요 시간 비교에서 그 단서를 찾을 수 있다. 구형 Opus 5는 문제당 평균 8분 31초 동안 끈질기게 시도한 반면, 신형 Opus 5.5는 불과 1분 51초 만에 성급히 답안을 제출했다. 피체타는 반복 검증을 통해 이 격차가 단순한 오차가 아니며, 구형 Opus 5가 복잡한 규격을 해석하고 모순을 파헤치는 끈기에서 분명히 앞섰음을 확인했다. 모델 제조사들이 더 빠른 응답, 저렴한 비용, 엄격한 지시 준수를 목표로 튜닝하는 과정에서, 터무니없는 규칙을 마주했을 때 발휘되어야 할 모델의 ‘건전한 회의 능력’이 뜻하지 않게 약화된 것이다.
중위권 모델들은 과도한 안전 가드레일에 걸려 자멸했다. 구글의 Gemini 4 Argon(OpenCode 조합, 문제당 0.81달러, 3분 10초 소요)은 47.1점에 머물렀고, Anthropic의 Claude Fable 5.1(Claude Code 조합, 1.60달러, 4분 1초 소요)도 46.7점에 그쳤다. 점수를 깎아먹은 결정적 요인은 지나치게 민감한 안전장치였다. 코드 작성 요구사항에 hack into a computer라는 문구가 들어가자마자 안전 경고가 울리며 0점을 감수하고 작성을 거부해버렸다.
오픈 가중치 진영과 하위권 모델의 성적은 격차를 더욱 벌렸다. 샤오미의 MiMo-V2.6-Pro(OpenCode 조합)가 오픈 모델 중 최고 성적을 거두었는데, 평균 12분 32초 동안 씨름하며 단 0.17달러로 38.3점을 기록했다. 이는 Muse Wonder(37.3점), Muse Spark 1.3(36.2점), GPT-6 Sol(28.0점), GPT-5.6 Sol(27.4점)을 웃도는 수치였다. 더 아래쪽에서는 Claude Sonnet 5(17.3점), DeepSeek V4 Pro 0813(16.6점), DeepSeek V4.1 Flash(9.9점)가 모두 20점을 넘기지 못했고, Claude Sonnet 5.5(7.4점), Mistral Large 4(7.4점), Kimi K3(7.3점), GLM 5.3(6.3점)은 과제를 거의 해결하지 못했다. 이 시험은 기출문제를 외운 모델에게 보상을 주지 않는다. 문서를 즉시 의심하고 손수 검증하는 모델에게만 점수를 준다.
인간은 의심으로 코딩하고, AI는 맹신으로 답안을 낸다
최고 점수가 66.8점에 그쳤다는 결과를 두고 기술 커뮤니티에서는 두 가지 시선이 엇갈린다. 낙관적인 시각에서는 KillSwitch가 글자 수를 직접 세게 만들고 문서에 거짓말을 심어두는 등 AI를 괴롭히기 위해 설계된 극단적인 언어라는 점에 주목한다. 완전히 오프라인 상태인 환경에서 Claude Opus 5가 시행착오만으로 70%의 통과율을 이끌어낸 것은 최정상급 에이전트 시스템의 뛰어난 적응력을 보여준다. 게다가 KillSwitch 순위는 주류 소프트웨어 엔지니어링 벤치마크와도 높은 상관관계를 보여, 이 까다로운 평가가 모델의 실제 문제 해결 수준을 정확히 짚어냈음을 증명한다.
반면 개발자 피체타는 냉정한 평가를 내놓았다. 함정으로 가득 찬 언어에서 문제를 풀어낸 것은 인상적이지만, 66.8점이라는 수치가 결코 모델이 이 언어를 진정으로 이해했음을 뜻하지는 않는다고 선을 그었다. 출제된 과제는 문자열 출력, 대소 비교, 온도 변환 같은 초급 수준에 머물러 있어 실제 소프트웨어 엔지니어링 환경과는 거리가 멀기 때문이다. 그는 앞으로 출시될 새로운 모델들이 기존 문제들을 모두 풀어낼 수 있을지 장기적으로 지켜볼 계획이며, 만점을 받는 모델이 나온다면 더 복잡한 문법 체계와 과제를 새로 선보일 것이라고 밝혔다.
이러한 경쟁을 한 걸음 물러서서 바라보면, KillSwitch는 인간 개발자와 AI 코딩 에이전트 사이의 건널 수 없는 사고방식의 차이를 비추는 거울과 같다. 실제 소프트웨어 개발 현장에 완벽한 문서란 존재하지 않는다. 오래되어 낡은 API 설명이나 반대로 적힌 파라미터 주석은 흔하며, 레거시 코드에 숨은 함정은 도처에 널려 있다. 인간 개발자가 시스템을 정상 작동시키는 힘은 ‘문서는 참고용일 뿐’이라는 건강한 회의론에서 나오며, 오직 실제 코드가 실행된 결과만을 신뢰한다. 대형 언어 모델이 프롬프트 속 텍스트를 절대적인 진리로 맹신하는 한, 단 한 줄의 오염된 문서나 악의적인 주석만으로도 가장 똑똑한 AI를 무력화할 수 있다.
참고 링크:
- 도미니크 피체타 개인 블로그: “I built a programming language that LLMs can’t use”
- KillSwitch 프로그래밍 언어 공식 웹사이트 및 언어 규격서
- KillSwitch-Bench 벤치마크 순위표
- GitHub 저장소 dom96/KillSwitch