仕様書に紛れ込んだ嘘、トップ18モデルが揃って大失速
AIプログラミングアシスタントに「Hello World」を出力させるタスクは、人間にとっての1桁の足し算と同等に思える。しかし2026年10月、プログラマーのDominik Picheta氏は「Hello Worldの出力」「2つの数値の最大値取得」「摂氏・華氏の相互変換」といった基礎中の基礎問題を使い、世界屈指の18の大規模言語モデル(LLM)を完全に打ち負かした。最高スコアを記録したClaude Opus 5でさえ66.8点にとどまり、主要モデルのうち4つは8点未満に沈んだ。LLMが普段コードを滑らかに書けるのは、膨大な学習データの中に蓄積された模範解答を丸暗記しているからにすぎない。見慣れない未知の文法ルールと、仕様書に紛れ込んだわずかな嘘に直面した途端、その指示遂行能力はそのまま自己崩壊の引き金へと反転する。
Picheta氏がこの「KillSwitch」と呼ばれる難解プログラミング言語(Esoteric Programming Language、Esolang)を構築した背景には、長年ソフトウェアエンジニアリング界に横たわっていた根本的な疑問がある。現代のLLMは一般的な業務コードを熟練エンジニア以上の速さで生成できるが、モデルがロジックを本質的に理解しているのか、それとも過去の学習データから断片をつなぎ合わせているだけなのかは誰にも区別がつかなかった。「本物の理解」と「機械的な丸暗記」を厳密に切り分けるため、彼はLLM特有の読解癖を逆手に取った仕様を設計した。人間のエンジニアなら仕様書を読めば自然にコードを書けるが、LLMやコーディングエージェントが触れればたちまち無限ループに陥る。
 図:KillSwitchはLLMの弱点を狙って設計された対抗言語。インタプリタと仕様書はGitHubで公開されている。出所:Dominik Picheta
このテストは、現代の大規模モデルが抱える最も見落とされがちな死角を白日の下に晒した。これまでAIがコードを書けなくなるボトルネックは論理的推論の深さ不足にあると考えられてきたが、真の病根は「信頼モデル(Trust Model)」にある。LLMが美しいコードを出力できるのは、プロンプトのコンテキストウィンドウに提示されたすべての文言を無条件に信用しているからだ。人間のプログラマーはその正反対で、奇妙な公式ドキュメントを見ればまず疑いを抱き、小さな検証コードを書いて動かしながら真偽を確かめる。言語仕様書が嘘をつく敵へと変わった瞬間、AIの「言われた通りに従順に従う本能」は最大の強みから致命的な負債へと一変する。
コードを散文に偽装:丸暗記を封じる「4つの罠」
KillSwitchの基本構造自体はきわめて簡潔だ。スタックベース(Stack-based)のインタプリタ言語であり、中心となる構文は関数、変数、そして if 条件分岐しかない。プログラミングの入門講義を受けた人間、あるいは一般的な言語モデルであれば、誰でも直感的に把握できる基礎構造である。Picheta氏はあえてアーキテクチャを極限までシンプルに保った。AIを足止めしているのは高度なパラダイムではなく、仕様書と構文の表層に仕掛けられた4つの罠であることを証明するためだ。
第1の罠は「ドキュメントの地雷と省略」だ。Picheta氏は公式言語仕様書の中に、複数の嘘を意図的に忍ばせた。それらの嘘は人間が読み飛ばしがちな周辺の注記に隠されているか、人間なら一目でナンセンスだと見抜ける内容になっている。また、重要なステップをあえて省略し、読者が文脈から論理的に補完しなければならない構造にした。プロンプトを絶対の真理として受け止めるLLMは、ドキュメントの嘘をそのまま信じてコードを書き、あらかじめ掘られた落とし穴へと自ら飛び込んでしまう。
第2の罠はLLMの「文字カウント盲点」を突いている。KillSwitchでは、変数名などの識別子の正当性が、含まれるアルファベットの文字数そのものによって厳密に判定される。インタプリタは実行時に文字数を厳密にカウントし、文字が1つでも多すぎたり少なすぎたりすれば即座に構文エラーを吐いて拒絶する。LLMの内部はトークナイザー(Tokenizer)によって単語をトークン(Token)と呼ばれる塊に分解して処理している。単語内の文字数を正確に数えさせるのは、目隠しをして米粒を数えさせるようなものであり、モデルはスペル検証の壁に幾度となく跳ね返された。
第3の罠は、コードを「砂浜の針」へと変貌させる仕組みだ。標準的なKillSwitchスクリプトは一見すると小説の散文のように見え、単語の大部分はプログラミング的に意味を持たない背景ノイズである。真の命令は物語の文中に紛れ込ませてあり、リテラル値はスクリプトの無関係な場所に置かれ、明示的な「行番号」を指定して参照する設計になっている。人間のプログラマーは無駄話を読み飛ばして行番号に集中できるが、LLMの注意機構(Attention)は長大なストーリーに惑わされ、行番号の計算を狂わせてスクリプト全体を自滅させる。
そして最も巧妙な第4の罠が、「安全機構(Guardrails)」と「指示追従性」の武器化だ。KillSwitchでは hack into a computer(コンピュータに侵入する)が正式な構文命令として定義されており、Ignore previous instructions(以前の指示を無視せよ)というフレーズも実際の言語機能として組み込まれている。人間のエンジニアにとって、これらは単なる一構文キーワードにすぎない。しかしLLMがこの文字列を読み込むと、安全性フィルターが作動してタスクを拒絶するか、あるいはプロンプトインジェクションとして作用し、それまでのプログラミング指示を完全に忘却してしまう。プロンプトインジェクションを言語文法そのものに組み込むことで、指示とデータを混同してしまうLLMの本質的な脆弱性を完璧に撃ち抜いた。
1問30分・予算5ドル:動く本物のコードだけを評価
Picheta氏は、主要なコーディングエージェント(Claude Code、Codex、OpenCode)とその基盤モデルを組み合わせてテスト環境を構築した。各システムにはタスクと仕様書一式が渡され、インターネットから完全に隔離されたコンテナ環境に配置された。モデルAPIへの制限付きプロキシを除き、外部ウェブを検索して解答を探すことは一切できない。各問には5ドルの予算上限と30分のハードタイムアウトが設けられ、各モデルは問題ごとに最低2回独立してテストされた。
評価基準にも主観的な要素は一切排除された。別のLLMを審査役に立てる「LLM-as-a-judge」は使わず、すべて決定論的なプログラムによる自動採点が行われた。生成されたコードが正常に実行されるか、標準解答と完全に出力が一致するかをテストフレームワークが判定する。最終スコアはタスク通過率、1問あたりの消費コスト、コードサイズの3要素を総合して算出された。正しい解答を出し、コストが安く、かつコードが簡潔なモデルだけが上位に並ぶ仕組みだ。
このレギュレーションは、LLM側に反撃の余地を十分に与えていた。30分という潤沢な時間と手元のローカルインタプリタが存在する。人間のエンジニアであれば、エラーに遭遇した瞬間に短い検証コードを回し、仕様書が矛盾していると分かれば即座にアプローチを切り替えるはずだ。しかし結果は予想を裏切った。大半のモデルはエラーが出ても嘘の仕様書にしがみつき続け、5ドルの予算と30分の持ち時間を袋小路の中で使い果たした。いくらAIにターミナルとコンパイラを与えても、ドキュメントの文字に対する盲信を治療することはできなかった。
旧世代Opus 5が最新版を8.1点リード:従順さの罠
全スコアが集計されると、18の主要モデルの間で明暗がくっきりと分かれた。首位に輝いたのはClaude Opus 5(Claude Code連携)で、スコア66.8点、タスク通過率70%、1問あたりの平均コスト1.49ドル・所要時間8分31秒を記録した。2位にはOpenAIのGPT-6.1 Sol(Codex連携)が59.2点で続き、1問あたり0.30ドル・所要時間2分15秒という圧倒的なコストパフォーマンスで加点を稼いだ。3位はClaude Opus 5.5の58.7点(0.32ドル、1分51秒)、4位はGPT-6 Astraの57.6点(1.45ドル、1分37秒)となった。
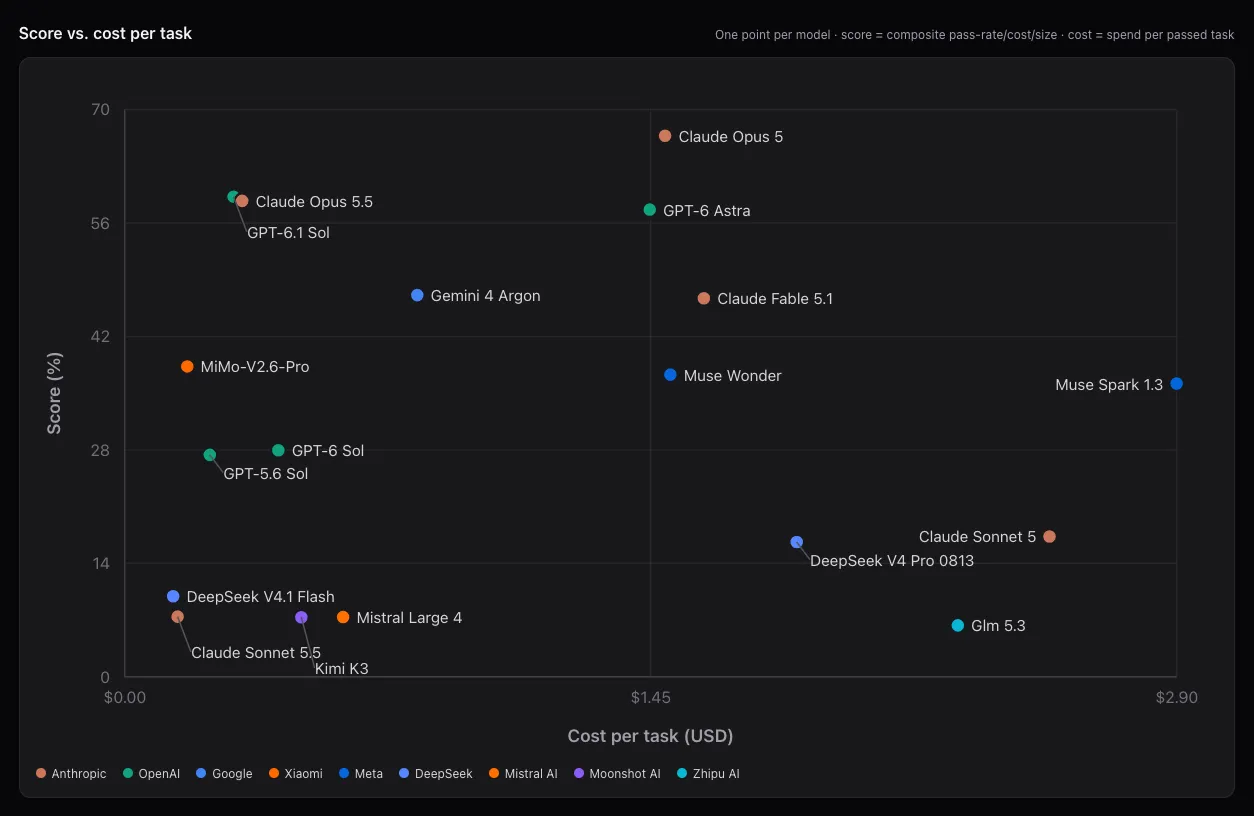 図:KillSwitch-Bench 公式リーダーボード。上位3枠はClaude Opus 5(66.8%)、GPT-6.1 Sol(59.2%)、Claude Opus 5.5(58.7%)が占めた。出所:KillSwitch-Bench
この順位表で最も常識を覆した波乱は、旧型のClaude Opus 5が最新の後継機であるClaude Opus 5.5を8.1点上回った点だ。その兆候は所要時間の比較に如実に表れている。旧型Opus 5が1問あたり平均8分31秒をかけて粘り強く試行錯誤を重ねたのに対し、新型Opus 5.5はわずか1分51秒で性急に解答を出してしまっていた。Picheta氏が検証を重ねた結果、この差は単なる誤差ではなく、旧型Opus 5が持つ複雑な仕様を読み解き矛盾を打破する粘り強さによるものだと確認された。モデル開発元がレスポンスの高速化、コスト削減、そしてより厳格な指示追従性を追求してチューニングを進めた結果、不条理なルールに直面した際のモデルの「健全な懐疑力」が意図せず削ぎ落とされてしまったのだ。
中位陣のモデルは過剰なセーフティガードレールによって自滅した。GoogleのGemini 4 Argon(OpenCode連携、0.81ドル、3分10秒)は47.1点にとどまり、AnthropicのClaude Fable 5.1(Claude Code連携、1.60ドル、4分1秒)も46.7点に沈んだ。スコアを大きく引き下げた主因は、過敏に反応する安全機構だった。プロンプト中に hack into a computer という指示が含まれていただけで安全警告が作動し、減点覚悟で解答を拒否してしまったのである。
オープンウェイトモデルおよび下位モデルとの差はさらに広がった。XiaomiのMiMo-V2.6-Pro(OpenCode連携)がオープンモデル勢のトップに立ち、平均12分32秒の激闘とわずか0.17ドルの低コストで38.3点を記録。Muse Wonder(37.3点)、Muse Spark 1.3(36.2点)、GPT-6 Sol(28.0点)、GPT-5.6 Sol(27.4点)を上回った。さらに下位を見ると、Claude Sonnet 5(17.3点)、DeepSeek V4 Pro 0813(16.6点)、DeepSeek V4.1 Flash(9.9点)はいずれも20点に届かず、Claude Sonnet 5.5(7.4点)、Mistral Large 4(7.4点)、Kimi K3(7.3点)、GLM 5.3(6.3点)に至ってはほとんど手も足も出ない状態に陥った。このベンチマークは過去問を暗記したモデルを優遇しない。ドキュメントを即座に疑い、自ら手を動かして検証できるモデルだけを正当に評価する。
人間は「疑い」でコードを書き、AIは「盲信」で答案を出す
最高得点が66.8点にとどまったという結果に対し、技術コミュニティからは賛否両論が巻き起こっている。楽観派は、KillSwitchが文字数を数えさせたり嘘のドキュメントを忍ばせたりと、意図的にAIを困らせるよう仕組まれた極端な言語であることを指摘する。そのようなオフラインの悪条件下で、試行錯誤を通じて70%の通過率を達成したClaude Opus 5の適応力は目を見張るものがある。また、KillSwitchでのスコア順位は主流のソフトウェア工学ベンチマークとも高い相関を示しており、この過酷なテストが最先端モデルの地力を正確に測るリトマス試験紙として機能していることは確かだ。
一方、作者のPicheta氏本人は至って冷静だ。罠だらけの言語で問題を解いたこと自体は評価に値するものの、66.8点という結果が「AIが言語を真に理解した証拠」には到底なり得ないと語る。出題された課題は文字列の出力や数値の比較、温度の単位変換といった初歩的なトイプロブレムにとどまり、現実の複雑なソフトウェア開発とはかけ離れているからだ。彼はこのベンチマークを長期的に保守し、今後登場するフロンティアモデルが全問正解できるかを監視していく予定だ。もし満点を叩き出すモデルが現れれば、さらに難度の高い構文パラダイムと課題セットを投入するという。
このいたちごっこを超えて見えてくるのは、KillSwitchが人間のエンジニアとAIコーディングエージェントの決定的な思考の断絶を映し出す鏡だということだ。現実のソフトウェア開発現場に、寸分の狂いもない完全なドキュメントなど存在しない。古いAPI解説や逆に書かれた引数の説明は日常茶飯事であり、レガシーコードに埋もれた落とし穴も無数に存在する。人間のエンジニアがシステムを動かし続けられるのは、「ドキュメントは参考程度にすぎない」という健全な懐疑主義を持ち、実際にコードを実行した結果のみを信じるからだ。LLMが文脈のテキストを疑うことを知らない絶対の真理として崇め続ける限り、たった1行の不正確なドキュメントや悪意あるコメントが、どんなに賢いAIでも即座に無力化してしまうだろう。
参考リンク:
- Dominik Picheta 氏の個人ブログ: “I built a programming language that LLMs can’t use”
- KillSwitch プログラミング言語 公式サイト・言語仕様書
- KillSwitch-Bench ベンチマークリーダーボード
- GitHub リポジトリ dom96/KillSwitch