2026年10月13日、スタンフォード大学とTogether AIらの研究チームが、新しい推論アーキテクチャ「HybridAgent」を発表した(arXiv:2610.18861)。11種類の領域横断ベンチマークにおいて、8Bおよび14Bパラメータモデルが既存の先端LLMエージェントや専用ツールフレームワークを凌駕し、14Bモデルでは最強ベースラインを平均17.4%上回る精度を達成した。同時に、テキストトークン消費量を純粋なテキストベースラインの1/2.7に圧縮し、トークン全体の消費量を35.5%〜54.7%削減することに成功している。
従来の自律型エージェントは、複雑なツール連携タスクを実行する際、思考プロセスのすべてを離散的なテキストトークンとして出力する必要があった。数百にも及ぶ中間トークンがGPUメモリを圧迫し、推論レイテンシを押し上げていた。思考の推論過程を連続潜在空間に留め、外部との対話が生じる瞬間だけテキストへデコードすることで、生成速度は2倍以上に向上する。削減された計算リソースは、長大なインタラクションにおけるスループット向上へと直結する。
思考を連続潜在空間に折りたたむ:テキストトークンを3分の1以下に削減
従来のReActフレームワークは、密な自己対話(モノローグ)によってタスクを前進させてきた。エージェントはWeb検索の実行やコード実行を行う前に、計画を説明するために数百のトークンを出力する。これらの中間テキストは外部ツールにとっては意味を持たないにもかかわらず、語彙テーブルのSoftmax射影を毎回通過しなければならない。自己回帰デコード処理によって、貴重なメモリ帯域幅がモデル内部の自己内省のために浪費されていた。
HybridAgentは、思考と表現の境界線を再定義した。モデルは単一の生成プロセスの中で、2つのモードを滑らかに切り替える。潜在空間モードが再帰的な内部推論を担い、テキストモードが外部への行動出力を受け持つ。研究チームはモード切り替えのアンカーとして <latent> と </latent> を導入した。潜在空間内では、1回のフォワードパスで1つの潜在ベクトル状態を進め、ステップ数は通常16から256ステップの間に設定される。
論文が示す効率向上データは3つの領域にわたる。ハイブリッドモードにおけるテキストトークンの消費量は純粋なテキストベースラインの1/2.7に低下し、総生成ステップ数は最大54%削減され、エンドツーエンドの推論速度は2.1倍に達した。潜在状態は語彙テーブル射影と再埋め込みの2つの行列演算をバイパスするため、メモリ帯域幅への負荷が劇的に軽減される。
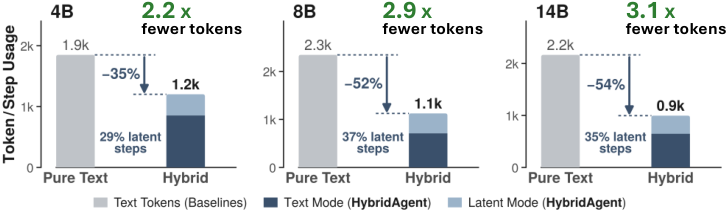 図:4B、8B、14BモデルにおけるHybridAgentのテキストトークン消費量と総生成ステップ数の変化(テキストベースライン比)。出典:arXiv 2610.18861
速度だけでなく、運用コストの改善も顕著である。NVIDIA H100を1時間あたり2.50ドル、BF16ピーク計算能力の利用率を10%と仮定した場合、100万問の質問に回答するコストは、4Bモデルで359ドルから98ドルへ、8Bモデルで439ドルから121ドルへ、14Bモデルで470ドルから176ドルへと削減され、それぞれ3.7倍、3.6倍、2.7倍のコスト効率を達成した。この試算には、潜在ステップが消費したバックボーンモデルの計算量もすべて算入されている。
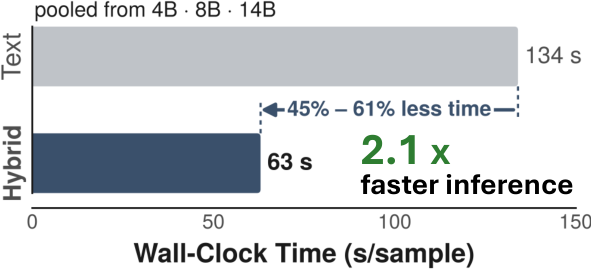 図:3つのモデル規模におけるHybridAgentの推論時間短縮倍率。出典:arXiv 2610.18861
残差マッピングで2つのコンテキストを結合:KVキャッシュの再エンコードを排除
連続ベクトルと離散トークンを同一のニューラルネットワーク内で循環させるには、表現空間の接続が課題となる。研究チームは HybridLink と呼ばれる軽量な残差アダプタ層を設計した。このモジュールはモデル最終層の隠れ状態を入力埋め込み空間へと直接マッピングする。これにより、潜在状態はテキストへの逆エンコードを経ることなく、次ステップの入力ベクトルとして直ちに利用可能となる。
この設計により、マルチターン対話におけるワーキングメモリの整合性が保たれる。入力プロンプト、潜在思考ベクトル、ツールの実行結果は、単一の連続KVキャッシュに一元保存される。エージェントがツール呼び出しを完了した後も、コンテキストを破棄して再エンコードする必要がない。蓄積されたGPUメモリキャッシュ上でそのまま後続の推論を行えるため、重複したフォワードパスの計算コストが完全に排除される。
このハイブリッドシステムを訓練するために、専用の2段階パイプラインが開発された。第1段階の HybridSFT では自己条件付き2パス学習手法を採用。1パス目ではTeacher Forcingにより目標潜在入力を生成し、2パス目では教師埋め込みをモデル自身の予測値へと置き換える。テキスト位置にはクロスエントロピー損失を、潜在状態位置には回帰損失を適用し、バックボーンと HybridLink を共同更新する。第2段階の HybridRL では強化学習を導入し、潜在空間で思考すべきタイミングとテキスト行動を起こすべきタイミングの意思決定を最適化する。
実装には verl と vLLM が基盤として拡張され、32枚のNVIDIA H100 GPU上で大規模な訓練が実施された。中間の推論処理をTensor Core内部に閉じ込めることで、メモリコントローラは語彙読み書きの負荷から解放され、限られた帯域幅を真に必要な外部インタラクションに集中できる。
潜在ベクトルの可視化と解釈:内部隠れ状態はセマンティクスを維持
潜在空間推論に対するエンジニアの最大の懸念はブラックボックス化である。思考過程が浮動小数点ベクトルの列になってしまえば、デバッグや安全性の監査が困難になるからだ。しかし本論文が提示する復元手法は、追加のデコーダーを必要としない。HybridLink でマッピングされた潜在ベクトルと語彙テーブル内のトークン埋め込みとのコサイン類似度を比較し、最も近いトークンを拾い上げることで擬似テキストを再構成できる。数式5はこのマッピングを語彙に対する argmax として定式化しており、潜在空間の終了アンカー </latent> も同一の基準で判定される。
可読性は、潜在ベクトルと最も近いトークン埋め込みとの平均コサイン類似度によって測定される。値が1であれば辞書内の特定のトークンと完全に一致していることを示す。研究チームは2,000個のガウス乱数ベクトルからノイズ閾値を算出し、200のタスクで検証を行った。コンテキスト特異性は、復元された擬似テキストと元の設問との単語一致度を他の無関係な設問との一致度と比較することで評価され、比率が1を超えていればその潜在思考が課題に即していることを示す。ノイズ閾値を超え、特異性が1以上となる領域こそが、人間の監査に耐えうる潜在思考である。
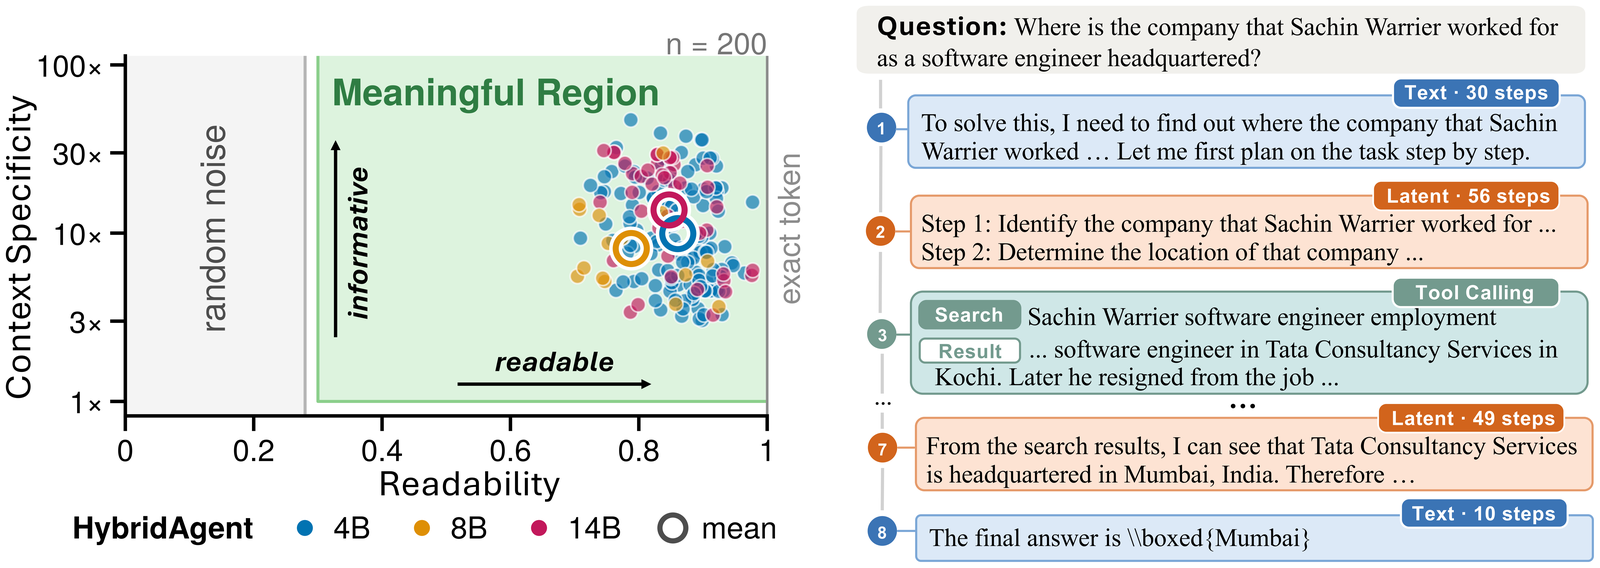 図:潜在ベクトルのセマンティクス探査分布と複数ステップのツール呼び出し実行軌跡の例。出典:arXiv 2610.18861
自己条件付き学習の効果はここで明確に現れる。同一のQwen3-14B-Baseバックボーンを用いた場合、フォーマットのみを導入した状態ではAIME25、AIME26、MATH500のスコアは20.6、19.8、62.4にとどまるが、HybridLink を有効化すると23.8、22.5、73.8へ上昇し、さらに自己条件付き学習を加えることで32.5、31.7、84.2まで跳ね上がる。復元されたテキストの可読性も学習段階に伴って向上した。
潜在思考に保持されているのは、トークン埋め込み空間における意味を持った方向性であり、ランダムな幾何学的ノイズではない。自己条件付き学習を行わない手法では、埋め込み空間から意味を読み取れない破片しか得られない。潜在状態が解釈可能かどうかは学習設計に依存するのであり、潜在推論というアプローチ自体の欠陥ではない。
11の複雑なベンチマークで実証:複数ターンの対話コストを3分の1に圧縮
評価環境には実用的なインタラクション環境が用意され、PythonサンドボックスとTavily検索ツールが接続された。探索プロセスでは最大10回のツール呼び出しが許可され、検索ごとに上位10件のスニペットを取得する構成とした。評価および要約抽出にはGPT-5.6-Lunaが判定モデルとして採用された。
ベンチマークにはGAIA、WebWalker、HLE、SealQA、AIME数学コンペティションなど11のタスクが含まれる。5回の独立試行において、正解率の標準偏差は±0.014、95%信頼区間は±0.017(数学カテゴリでは±0.031、知識検索では±0.018)と極めて安定していた。8Bおよび14Bモデルにおいて、既存の先端LLMエージェントや専用ツールフレームワークを上回り、14Bモデルは最強ベースライン比で平均17.4%向上した。同一パラメータ数・同一学習予算の条件下で、HybridSFT と HybridRL はテキストベースラインおよび潜在空間ベースラインに対してそれぞれ18.5%、10.4%の性能向上を示した。
課金対象となるテキストトークン数は、潜在推論の割合が増えるにつれて減少する。多段階エージェントは数十回に及ぶツール連携を日常的に実行するため、各ステップで削減された計算コストが軌跡全体で累積し、運用コストの大幅な圧縮につながる。
ハイブリッド推論が変えるエンジニアリングの境界線:学習と運用のトレードオフ
潜在空間推論は業界内でも議論を呼ぶアプローチである。肯定派は、テキスト自己回帰モデルはすでに工学的な限界に近づいていると指摘する。高頻度なマルチエージェント協調や数十ステップの探索タスクでは、テキストのみの手法は急速にコンテキスト長を肥大化させてしまう。内部の論理演算をTensor Coreに委ね、メモリ帯域消費を大幅に抑制することは、大規模展開において不可欠なアプローチである。
一方、慎重派のエンジニアは運用の移行コストを懸念する。現在の商用エコシステムは成熟したテキストAPIを前提に構築されており、監視やデバッグ、安全対策のルールもテキスト解析に依存している。HybridAgentはモデルの追加微調整と専用の推論ランタイムを要求するため、現時点ではブラックボックスな商用クローズドモデルに直接組み込むことができない。インフラ刷新にかかる投資が、ハードウェア効率によるコスト削減を部分的に相殺する可能性もある。
テスト時計算量(Test-time compute)のスケーリング結果は、この議論に新たな視点を与えている。難関数学・科学問題100問において、サンプリング数kを4から64まで拡大したところ、ハイブリッドモデルのpass@k曲線は継続的に上昇し、純粋な強化学習テキストエージェントよりも高い計算効率を示した。連続潜在状態は高度な推論探索を十分に支える容量を備えており、サンプリング規模を拡大するほど両者の性能差は広がる。
自律型エージェントの性能ボトルネックは、思考を表現するメディアの選択にある。中間推論を無理にテキストへと変換することは、メモリ帯域幅を無駄に消費する。連続潜在空間は内部論理を深めるのに十分な能力を持ち、外部に対しては自然言語のツールインターフェースを維持できる。計算資源が逼迫する長大なタスクにおいて、不要な内部対話を省くことこそが、スループット向上の本質的な解となる。
参考リンク:
- arXiv論文:Hybrid Reasoning Agents (2610.18861)
- スタンフォード大学とTogether AIによる共同研究プロジェクト