Le 13 octobre 2026, une équipe de l’Université Stanford et de Together AI a publié les travaux d’une nouvelle architecture d’inférence baptisée HybridAgent (arXiv:2610.18861). Évaluée sur 11 bancs d’essai pluridisciplinaires, ses déclinaisons à 8 et 14 milliards de paramètres ont surpassé les agents LLM de pointe ainsi que les cadres d’outils dédiés ; la version 14B devance la meilleure référence d’une moyenne de 17,4 %. Dans le même temps, le système a comprimé la consommation de tokens textuels à 1/2,7 de celle des références purement textuelles, réduisant la dépense globale de tokens de 35,5 % à 54,7 %.
Lorsqu’ils accomplissent des tâches complexes outillées, les agents autonomes conventionnels doivent expliciter chaque étape de réflexion sous forme de tokens textuels discrets. Des centaines de mots intermédiaires encombrent la mémoire vive de la carte graphique (VRAM) et dégradent la latence du service. En maintenant la réflexion interne au sein d’un espace latent continu pour ne décoder le texte qu’au moment précis de l’interaction, la vitesse de génération fait plus que doubler. Les ressources de calcul ainsi épargnées bénéficient directement au débit lors des interactions au long cours.
Replier la réflexion dans l’espace latent : les tokens textuels réduits au tiers
Les cadres traditionnels de type ReAct s’appuient sur un monologue intérieur dense pour faire progresser leurs tâches. Avant de lancer une recherche web ou d’exécuter un script Python, un agent émet des centaines de tokens explicitant sa démarche. Ces mots intermédiaires n’ont aucune utilité pour les outils externes, mais doivent néanmoins traverser la projection Softmax du vocabulaire. Ce décodage autorégressif gaspille une précieuse bande passante mémoire dans une pure introspection.
HybridAgent redéfinit la frontière entre réflexion et expression. Au cours d’un processus de génération unifié, le modèle bascule sans heurt entre deux modes d’opération. Le mode latent prend en charge le raisonnement interne récursif, tandis que le mode textuel orchestre les interactions avec l’environnement extérieur. L’équipe de recherche a introduit les balises <latent> et </latent> comme repères de transition. Dans l’espace latent, le réseau fait progresser un état vectoriel par passe avant (forward pass), avec des séquences généralement calibrées entre 16 et 256 étapes.
Les gains d’efficacité documentés dans la publication couvrent trois dimensions majeures. En mode hybride, la consommation de tokens textuels chute à 1/2,7 de la référence textuelle, le nombre total d’étapes de génération diminue jusqu’à 54 %, et la vitesse d’inférence de bout en bout est multipliée par 2,1. En s’affranchissant de la projection sur le vocabulaire et de la ré-incorporation matricielle, les états latents soulagent considérablement la bande passante mémoire.
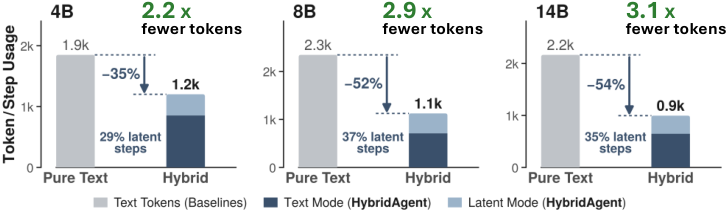 Figure : Évolution de la consommation de tokens textuels et du nombre total d’étapes de génération d’HybridAgent sur les échelles 4B, 8B et 14B par rapport aux références purement textuelles. Source : arXiv 2610.18861
À la réduction de la latence s’ajoute un bénéfice économique direct. Sur la base d’un coût de location horaire de 2,50 dollars par GPU NVIDIA H100 et d’une utilisation de 10 % de la puissance de crête BF16, le coût pour traiter un million de requêtes passe de 359 à 98 dollars sur le modèle 4B, de 439 à 121 dollars sur le 8B, et de 470 à 176 dollars sur le 14B, soit des facteurs d’économie respectifs de 3,7x, 3,6x et 2,7x. Cette estimation intègre rigoureusement le calcul mobilisé par les étapes latentes au sein du réseau dorsal, sans se contenter de comptabiliser les tokens textuels épargnés.
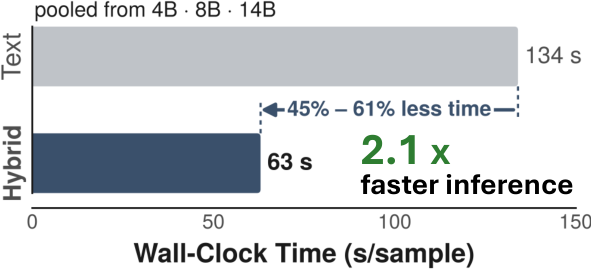 Figure : Facteur d’accélération du temps d’inférence d’HybridAgent sur trois échelles de modèles. Source : arXiv 2610.18861
Une passerelle résiduelle entre deux contextes : le cache KV préserve l’état sans réencodage
Faire cohabiter des vecteurs continus et des caractères discrets dans un même réseau de neurones impose de concilier leurs espaces de représentation. Les chercheurs ont conçu HybridLink, une couche adaptatrice résiduelle légère. Ce module projette l’état caché de la dernière couche du modèle directement dans l’espace d’intégration d’entrée. L’état latent peut ainsi être réinjecté tel quel lors de l’étape de calcul suivante, évitant tout décodage textuel inverse.
Cette architecture garantit la continuité de la mémoire de travail au fil des échanges successifs. Les invites initiales, les vecteurs de réflexion latente et les retours des outils sont conservés conjointement dans un cache Clé-Valeur (KV) unifié. Une fois l’appel d’outil terminé, nul besoin de réinitialiser le contexte pour le réencoder : les déductions suivantes reprennent directement sur la mémoire GPU existante, éliminant toute redondance de calcul.
L’apprentissage de ce système hybride repose sur une méthode dédiée en deux étapes. La première phase, HybridSFT, applique un mécanisme d’entraînement auto-conditionné en deux passes. La première passe utilise le guidage par l’enseignant (teacher forcing) pour produire les entrées latentes cibles, tandis que la seconde remplace les plongements réels par les prédictions du modèle lui-même. Les positions textuelles sont optimisées par perte d’entropie croisée et les positions latentes par perte de régression, mettant à jour de concert le réseau dorsal et HybridLink. La seconde phase, HybridRL, introduit l’apprentissage par renforcement pour affiner les arbitrages entre réflexion dans l’espace latent et passages à l’action en texte.
Développée sur les fondations de verl et vLLM, la solution a été entraînée à grande échelle sur un parc de 32 processeurs graphiques NVIDIA H100. En retenant la réflexion intermédiaire au sein des cœurs Tensor, les contrôleurs mémoire s’affranchissent de lectures et écritures incessantes dans le dictionnaire de vocabulaire, préservant la bande passante pour les interactions réelles.
Des vecteurs latents inspectables : clarté sémantique des états internes
La principale critique formulée à l’égard du raisonnement latent tient à son opacité : si la pensée se résume à une suite de vecteurs à virgule flottante, le débogage et l’audit de sécurité s’avèrent périlleux. Les auteurs démontrent cependant qu’une telle interprétation ne nécessite aucun décodeur auxiliaire. En mesurant la similarité cosinus entre le vecteur latent projeté par HybridLink et les plongements du vocabulaire, le plus proche voisin permet de reconstituer un pseudo-texte intelligible. L’équation 5 formalise cette correspondance sous la forme d’un argmax sur le vocabulaire, critère qui sert également à détecter la balise de sortie </latent>.
La lisibilité se mesure par la similarité cosinus moyenne entre les vecteurs latents et les plongements lexicaux les plus proches. Une valeur de 1 correspond à une identité stricte avec un token du dictionnaire. Les chercheurs ont établi un seuil de bruit à l’aide de 2 000 vecteurs gaussiens aléatoires, avant d’auditer 200 tâches en aval. La spécificité contextuelle évalue quant à elle le chevauchement lexical entre le pseudo-texte et l’énoncé source par rapport à des questions sans lien. Un ratio supérieur à 1 garantit que la pensée latente s’adresse directement au problème traité. Seules les représentations situées au-dessus du seuil de bruit et affichant une spécificité supérieure à 1 constituent des traces auditables fiables.
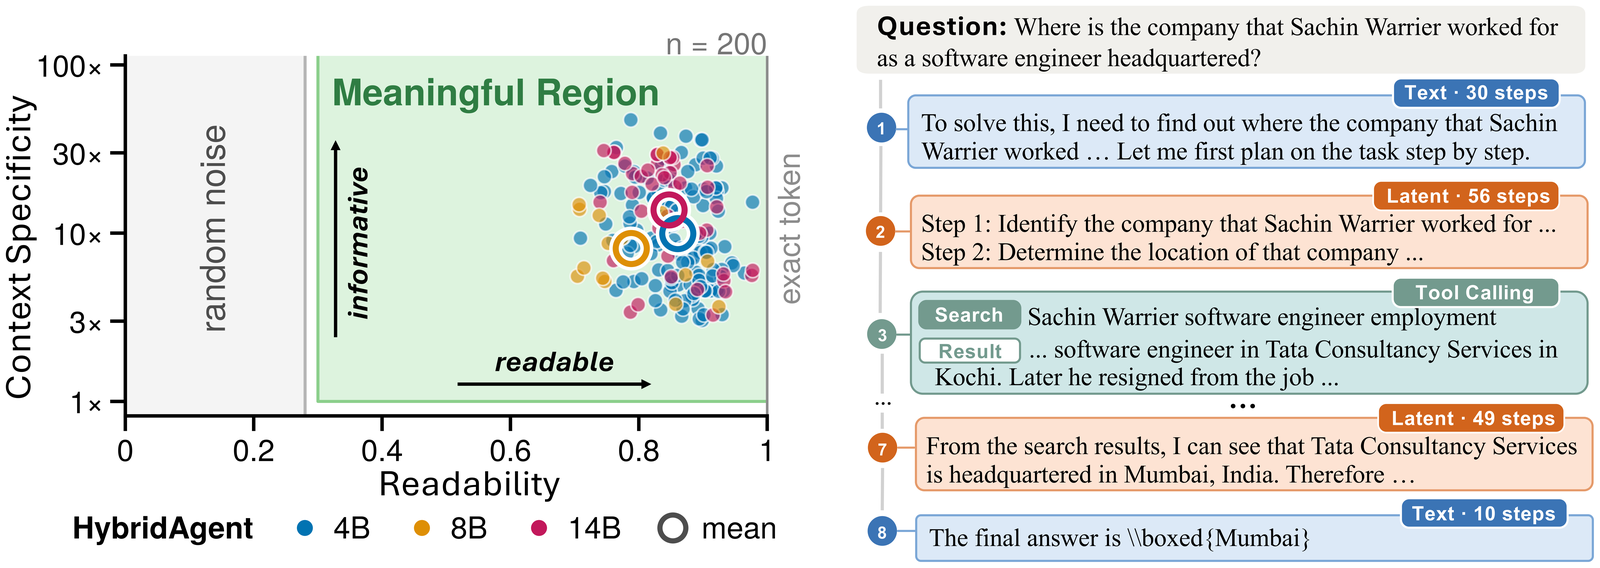 Figure : Distribution du sondage sémantique des vecteurs latents et exemple d’une trajectoire d’appels d’outils en plusieurs étapes. Source : arXiv 2610.18861
L’apport de l’entraînement auto-conditionné se révèle ici déterminant. Sur un même réseau Qwen3-14B-Base, l’activation par simple formatage n’obtient que 20,6, 19,8 et 62,4 sur AIME25, AIME26 et MATH500. Avec l’activation HybridLink, ces scores grimpent à 23,8, 22,5 et 73,8 ; l’ajout de l’apprentissage auto-conditionné les propulse enfin à 32,5, 31,7 et 84,2. La lisibilité des pensées latentes progresse de manière synchrone au fil des étapes d’entraînement.
L’espace latent abrite ainsi des directions porteuses de sens alignées sur l’espace d’intégration lexical, et non un bruit géométrique indéchiffrable. Les approches privées d’apprentissage auto-conditionné tendent à produire des fragments inexploitables. La transparence des états latents dépend donc de la rigueur de la méthode d’entraînement, et non d’une tare inhérente à l’inférence latente.
Validé sur 11 bancs d’essai complexes : un coût d’interaction divisé par trois
Le protocole d’évaluation s’est articulé autour de scénarios d’interaction réels et exigeants, intégrant un environnement d’exécution Python isolé et le moteur de recherche web Tavily. Chaque parcours d’exploration autorisait jusqu’à 10 appels d’outils, extrayant les 10 meilleurs extraits de pages web par requête. GPT-5.6-Luna a officié comme modèle juge et extracteur de synthèses.
L’ensemble de tests a réuni 11 tâches diversifiées, comprenant GAIA, WebWalker, HLE, SealQA ainsi que des épreuves de mathématiques de niveau AIME. Sur 5 passes indépendantes, l’écart-type de précision s’est établi à un niveau très stable de ±0,014, pour un intervalle de confiance à 95 % de ±0,017 (soit ±0,031 pour les mathématiques et ±0,018 pour la recherche documentaire). Sur les échelles 8B et 14B, l’architecture a devancé les grands agents généralistes et les cadres d’outils spécialisés, le 14B distançant la meilleure référence de 17,4 %. À taille de modèle et budget d’entraînement identiques, HybridSFT et HybridRL ont surpassé les lignes de base textuelles et latentes de 18,5 % et 10,4 % respectivement.
Le volume de tokens textuels facturables décroît à mesure que la part d’inférence latente augmente. Dans la mesure où les agents au long cours enchaînent des dizaines d’appels d’outils, les gains accumulés à chaque étape se répercutent de manière sensible sur la facture finale.
Le raisonnement hybride bouscule l’ingénierie : le cap de l’adoption logicielle
L’inférence dans l’espace latent alimente les débats d’architecture logicielle. Ses partisans soulignent que la génération autorégressive de texte atteint désormais ses limites pratiques. La collaboration intense entre agents multiples et la recherche arborescente saturent rapidement les fenêtres de contexte des solutions purement textuelles. Confier les déductions logiques internes aux cœurs Tensor pour soulager la bande passante mémoire apparaît indispensable pour assurer le déploiement à grande échelle.
À l’inverse, les ingénieurs prudents mettent en avant les coûts de transition. L’écosystème professionnel repose massivement sur des API textuelles standardisées ; l’instrumentation, le débogage et le filtrage de sécurité sont tous bâtis autour de l’analyse du texte. HybridAgent exigeant un réglage fin sur mesure et un moteur d’inférence spécifique, il ne peut être directement greffé sur des modèles propriétaires fermés. Le coût d’adaptation de l’infrastructure sous-jacente pourrait ainsi modérer une partie des économies matérielles réalisées.
L’étude du passage à l’échelle du calcul au moment du test (Test-time compute) apporte un éclairage supplémentaire : sur 100 problèmes pointus de sciences et de mathématiques, en étendant l’échantillonnage k de 4 à 64, la courbe pass@k de la structure hybride poursuit sa progression et tire un meilleur parti du calcul disponible que les agents textuels entraînés par simple renforcement. Les états latents continus offrant une marge d’exploration supérieure, l’écart de performance s’accroît à mesure que le budget de calcul s’élargit.
Le goulot d’étranglement des agents autonomes découle directement du support mobilisé pour formaliser la réflexion. Contraindre chaque déduction intermédiaire à s’écrire en caractères alphabétiques gaspille inutilement la mémoire. L’espace latent continu est tout à fait apte à porter la logique interne, tout en préservant des interfaces textuelles claires pour agir sur le monde. Face à des tâches prolongées aux ressources contraintes, s’épargner les bavardages internes superflus demeure le levier le plus puissant pour démultiplier le débit global.
Liens de référence :
- Publication arXiv : Hybrid Reasoning Agents (2610.18861)
- Projet de recherche conjoint de l’Université Stanford et Together AI