Deux cents billions de tokens ont été traités dans le plus grand secret, sous les yeux de tous. Des dizaines de milliers de développeurs à travers le monde viennent tout juste de réaliser qu’ils ont servi d’évaluateurs en aveugle pendant des mois. Sur plusieurs plateformes d’API tierces, un modèle énigmatique répondant au nom de code « Space Bunny » était apparu sans mention d’éditeur, absorbant sans faillir une avalanche de tâches complexes de programmation et de débogage. Le 20 octobre 2026, le voile s’est levé : ce modèle discret émane de l’entreprise chinoise MiniMax et porte le nom officiel de M3.1 Flash.
Les données techniques publiées dans la foulée ont secoué l’industrie : sa vitesse d’inférence en ligne a presque triplé, tandis que ses coûts d’utilisation ont chuté de 70 %. Depuis trop longtemps, les modèles d’avant-garde concentrent leurs efforts sur l’obtention de notes flatteuses sur des bancs d’essai statiques. Cependant, dès qu’une entreprise tente de les intégrer à ses flux réels, la facture devient exorbitante. M3.1 Flash déplace le terrain d’affrontement là où il compte vraiment : un modèle doit non seulement résoudre des problèmes ardus, mais également préserver l’équilibre financier des organisations.
200 billions de tokens traités incognito : Space Bunny tombe le masque
Dans le domaine de l’intelligence artificielle, l’optimisation excessive sur des jeux de données d’évaluation publics est devenue monnaie courante. De nombreuses équipes affinent leurs modèles spécifiquement pour exceller aux examens standardisés. Si leurs résultats s’envolent dans les classements, les défaillances s’enchaînent dès qu’ils se heurtent à du code réel en production. Face à cette dérive, MiniMax a fait le choix d’une validation diamétralement opposée.
En déployant discrètement ses versions préliminaires sous le pseudonyme « Space Bunny » sur des plateformes de développement tierces, l’équipe a soumis son modèle à des conditions opérationnelles impitoyables. Durant des mois de tests en aveugle, de véritables utilisateurs lui ont confié plus de 200 billions de tokens. Cette mise à l’épreuve prolongée a balayé les aléas statistiques des benchmarks de laboratoire. Des journaux d’exécution issus d’utilisateurs sans filtre s’avèrent infiniment plus probants que des séries d’exercices calibrés.
À l’occasion de ce lancement officiel, MiniMax a ouvert ses interfaces API, son offre d’abonnement M Plan et son environnement de développement MiniMax Code. L’entreprise a également pris l’engagement de publier prochainement les poids du modèle en open source pour la communauté. La vision de l’équipe d’ingénierie est limpide : livrer des travailleurs numériques opérationnels, capables de prendre place à un poste de travail et de produire de la valeur sans délai.
Quand l’IA prend les commandes de l’ordinateur : les budgets d’entreprise tiendront-ils ?
La plupart des utilisateurs perçoivent encore l’intelligence artificielle à travers le prisme d’une simple interface de conversation. Or, les besoins réels des entreprises exigent des agents autonomes capables d’orchestrer des dizaines d’actions successives. Prenons l’exemple des opérations bancaires : exécuter un virement international ne se résume pas à composer une réponse textuelle. Le système doit s’authentifier sur le backend, extraire des dossiers, vérifier la conformité réglementaire, consulter les taux de change en direct et enregistrer la transaction.
Toutes ces étapes s’enchaînent avec une stricte interdépendance. À chaque palier, le modèle doit renvoyer l’intégralité de l’historique d’exécution dans la fenêtre de contexte pour recalculer la suite. Au sein de chaînes d’appels aussi denses, une simple vérification de dossier absorbe facilement plusieurs millions de tokens. Si le tarif unitaire reste élevé, le traitement d’une seule opération courante coûte plusieurs dollars rien qu’en calcul brut.
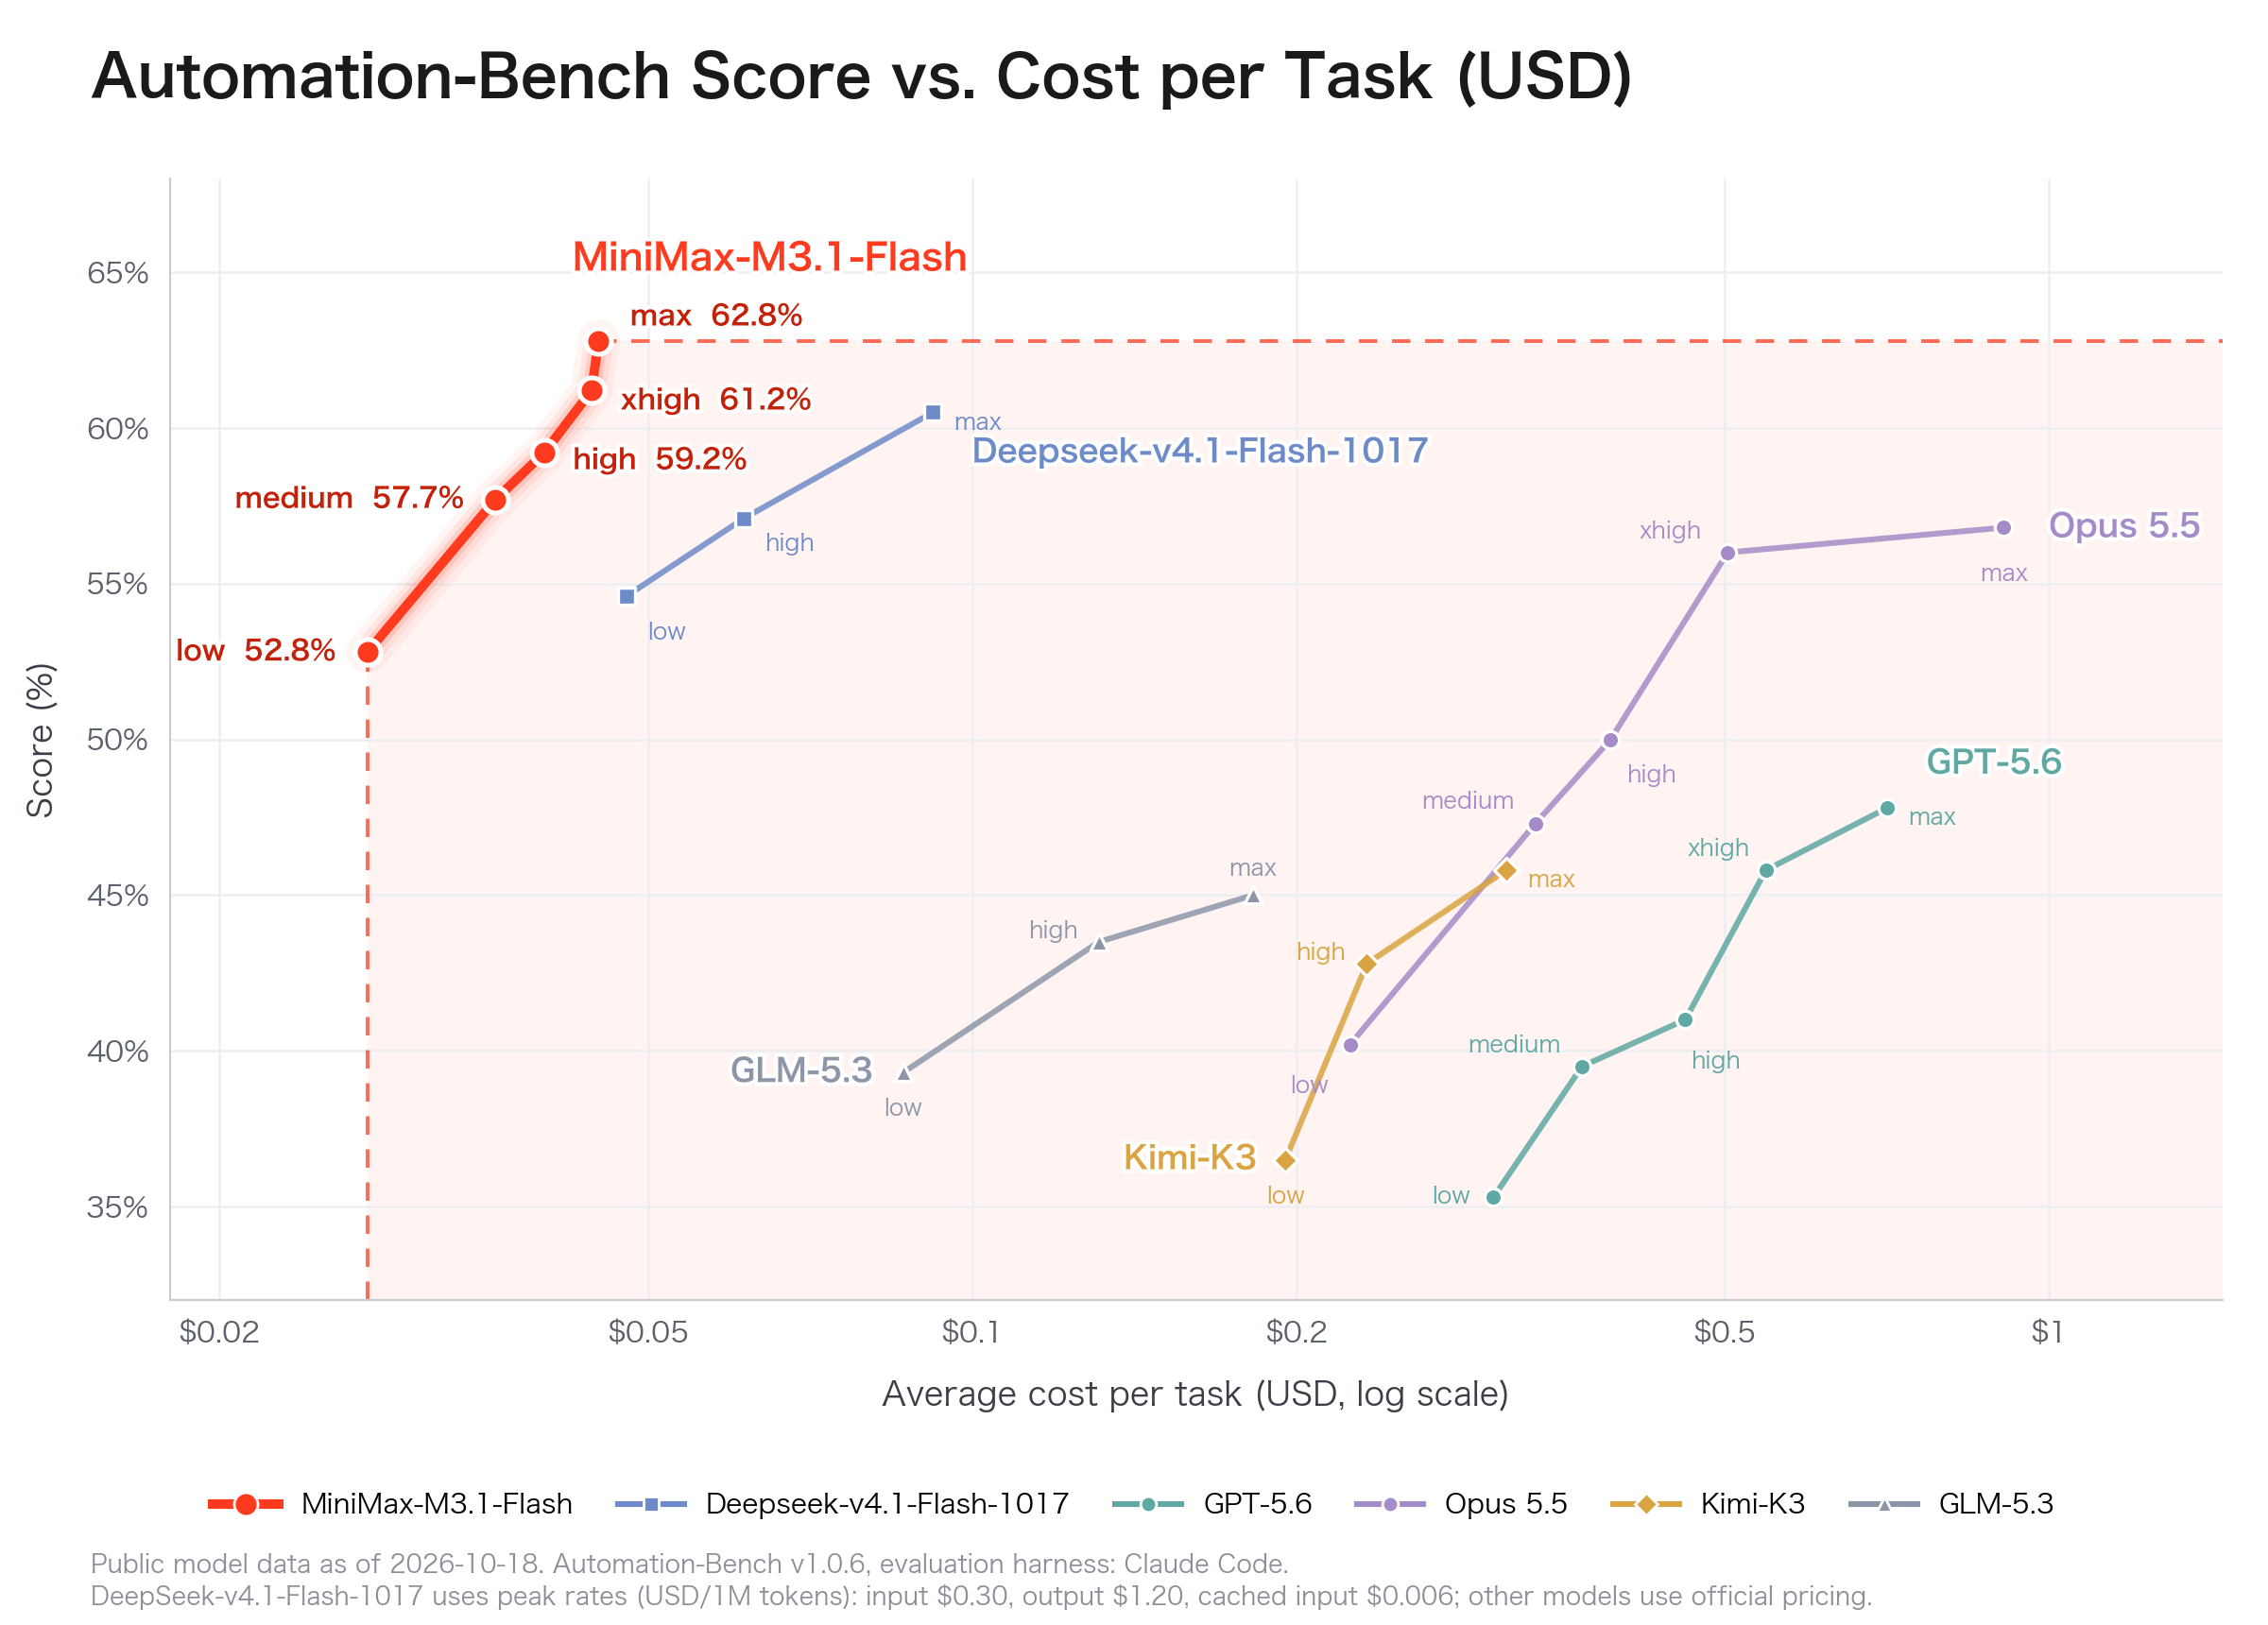 Figure : Comparaison des scores de référence et des coûts d’inférence entre MiniMax M3.1 Flash et les principaux modèles concurrents. Source : MiniMax (Blog technique officiel)
M3.1 Flash restructure en profondeur cette économie de calcul. La grille tarifaire officielle fixe le million de tokens d’entrée à 0,15 dollar et la sortie à 0,60 dollar. Lorsque la mise en cache du contexte est activée, le coût d’entrée s’effondre à 0,015 dollar. Sur le banc d’essai BankerToolBench, qui jauge l’exactitude des appels d’outils en contexte bancaire, le modèle a décroché un score de 76,2. Ce coût plancher, conjugué à un contrôle rigoureux des outils, permet enfin aux tâches d’automatisation de franchir le seuil de rentabilité.
Plus de 200 tokens par seconde : en finir avec l’attente dans les chaînes d’actions
Dans l’exécution automatisée, la latence constitue un goulot d’étranglement tout aussi critique que le coût financier. Lorsqu’une IA pilote un environnement de bureau pour manipuler des classeurs, la moindre saccade à chaque clic brise la fluidité du travail. Une attente excessive accroît considérablement les risques d’expiration des délais réseau et de désynchronisation des actions.
M3.1 Flash propulse la cadence d’émission au-delà de 200 tokens par seconde, avec une vitesse médiane P50 solidement établie autour de 170 tokens par seconde. Une consigne structurée de plusieurs centaines de signes est générée intégralement en à peine plus d’une seconde. Pour les scénarios d’automatisation requérant des dizaines d’actions consécutives, ce gain temporel trace la frontière entre une exécution stable et un échec prématuré.
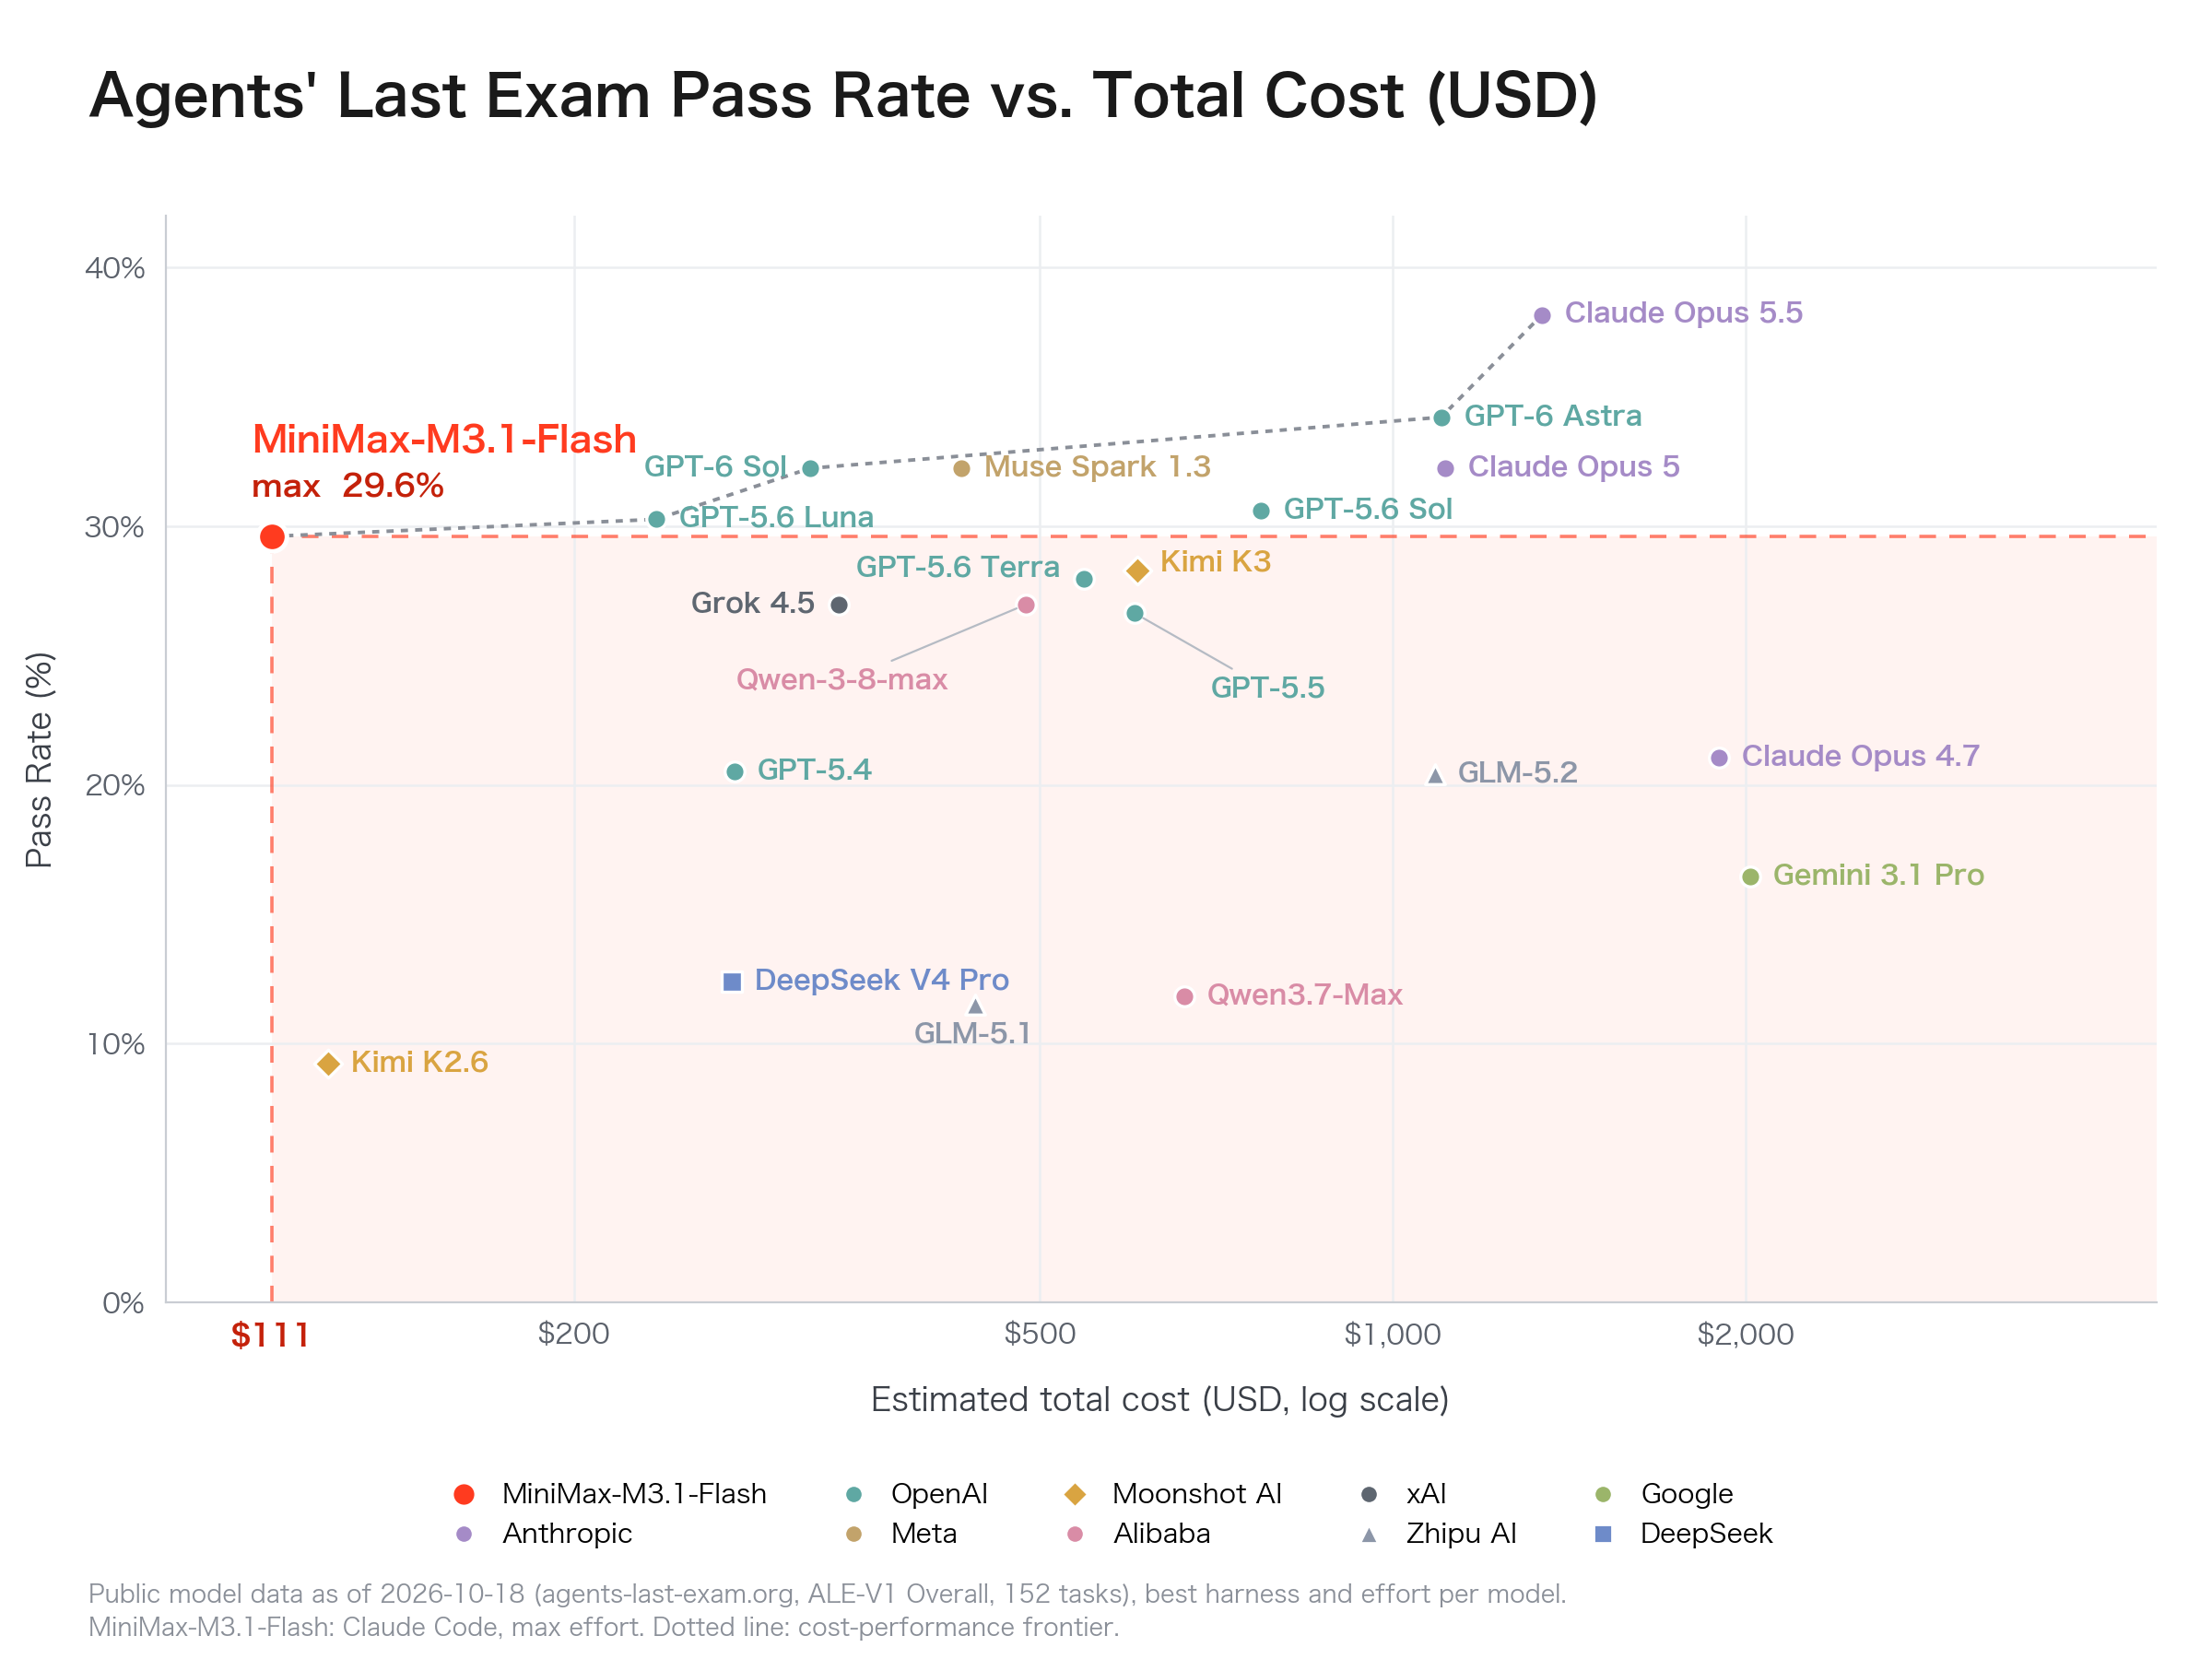 Figure : Performances de MiniMax M3.1 Flash sur différents bancs d’essai d’automatisation et de manipulations opérationnelles. Source : MiniMax (Blog technique officiel)
Ce débit élevé procure des bénéfices tangibles en ingénierie. Sur le benchmark OSWorld V2, qui simule un système d’exploitation complet, M3.1 Flash a atteint 61,7 points. Sur DeepSWE v1.1, référence d’évaluation pour la résolution de bugs logiciels réels, il affiche un taux de résolution de 73,7 %, tandis qu’il culmine à 82 % sur la plateforme de cybersécurité CyberGym. Cette réactivité supprime les temps morts dans les pipelines séquentiels et insuffle aux processus automatisés un rythme d’exécution fluide.
L’illusion des examens théoriques : la valeur réside dans le travail accompli
Ces derniers mois, la contestation autour des scores de référence artificiellement gonflés a pris une ampleur inédite. Sur les forums d’ingénieurs, de nombreux spécialistes dénoncent une crise de confiance au sein de l’écosystème. Certains modèles, surentraînés pour briller sur des questionnaires publics, échouent lamentablement dès qu’ils sont confrontés à des bases de code industrielles. Cet écart béant entre d’excellentes notes scolaires et une piètre efficacité opérationnelle a refroidi l’ardeur de nombreuses organisations.
Afin de balayer ces illusions, des tests d’une sévérité accrue ont été mis au point, à l’image du banc d’essai « Agents’ Last Exam » (ALE). Ce protocole bannit les questions faisant appel à la simple mémorisation pour se concentrer sur le raisonnement complexe en environnement inconnu. M3.1 Flash y a recueilli 29,6 points, intégrant le peloton de tête sur AutomationBench-AA. Selon les données officielles, il se hisse au premier rang des modèles chinois à la fois sur ALE et OSWorld V2. Ces indicateurs éprouvés sur le terrain constituent une réponse convaincante aux doutes légitimes des utilisateurs.
Cette quête de pragmatisme et de maîtrise budgétaire dépasse le seul cadre de MiniMax. Durant la même période, l’équipe d’Inception a dévoilé Mercury 3, un modèle fondé sur une architecture de diffusion qui franchit le cap des 1 068 tokens par seconde pour un coût d’entrée de 0,10 dollar par million de tokens. Bien que les partis pris technologiques diffèrent, le secteur s’accorde sur un impératif partagé : abaisser drastiquement le coût d’accès à l’intelligence artificielle. Les modèles qui misent uniquement sur une débauche de paramètres hors de prix s’exposent désormais au désintérêt du marché.
Du record d’apparat au travailleur rentable : les règles ont changé
L’aura mystique qui entourait les performances brutes s’estompe. Tout outil technologique doit répondre à un arbitrage pragmatique : est-il capable d’accomplir une tâche de façon irréprochable pour un coût raisonnable ? La véritable rupture incarnée par MiniMax M3.1 Flash réside dans ce rappel aux réalités économiques et budgétaires du quotidien.
Une réduction de coût de 70 % couplée à un triplement de la vitesse modifie profondément les repères de l’industrie. Dans l’écosystème qui s’annonce, la victoire ne se jouera plus lors de démonstrations scénarisées. C’est au cœur de millions d’opérations courantes — vérifications, clics et transferts de données — que les solutions capables de préserver le capital des organisations s’imposeront durablement. Cette transition de la salle d’examen vers l’atelier de travail ne fait que commencer.
Liens de référence :
- Blog technique officiel de MiniMax : Annonce de M3.1 Flash et spécifications techniques
- Télémétrie d’utilisation en aveugle : Space Bunny
- Débats communautaires sur Hacker News : Vitesse d’inférence et pertinence des benchmarks
- Rapport technique de publication d’Inception Mercury 3