Doscientos billones de tokens se procesaron ante los ojos de todo el mundo sin que nadie lo notara. Decenas de miles de desarrolladores acaban de descubrir que fueron examinadores a ciegas durante meses. En plataformas de llamadas API de terceros, había aparecido previamente un misterioso modelo con el nombre en clave «Space Bunny». Sin ningún distintivo de fabricante, asumió sin pausa un volumen masivo de complejas tareas de programación y depuración. El 20 de octubre de 2026, el misterio se desveló: este discreto modelo pertenecía a la compañía china MiniMax y fue bautizado oficialmente como M3.1 Flash.
Las métricas oficiales publicadas sacudieron al sector: su velocidad de inferencia se triplicó y el coste global de uso de la API cayó un 70%. Durante mucho tiempo, numerosos modelos se dedicaron a presumir de puntuaciones en bancos de pruebas estáticos. Sin embargo, las empresas que intentaban implementarlos en producción chocaban con facturas computacionales exorbitantes. M3.1 Flash sitúa el foco competitivo en el terreno decisivo: un modelo no solo debe resolver problemas complejos, sino ser viable en los libros contables corporativos.
200 billones de tokens anónimos: Space Bunny se quita la máscara
En el panorama actual de la inteligencia artificial, inflar notas en conjuntos de prueba públicos es habitual. Numerosos equipos sobreajustan sus modelos específicamente para superar exámenes. Las puntuaciones en las tablas de clasificación se disparan, pero al ponerlos a prueba en código real, los errores se multiplican. Frente a esta tendencia, MiniMax optó por una estrategia de validación totalmente opuesta.
Asignaron a las primeras versiones del modelo el alias «Space Bunny» y las integraron directamente en plataformas de programación de terceros para someterlas a condiciones reales de trabajo. A lo largo de meses de pruebas a ciegas, los usuarios reales consumieron más de 200 billones de tokens en cargas de trabajo de alta exigencia. Esta batalla prolongada y sin artificios comerciales eliminó las desviaciones casuales de los benchmarks de laboratorio. Un registro de uso real sin sesgos resulta infinitamente más convincente que un catálogo de pruebas cuidadosamente seleccionado.
Junto con el lanzamiento formal, MiniMax habilitó accesos API, su programa de suscripción M Plan y la herramienta de programación MiniMax Code. El equipo también prometió abrir los pesos del modelo a la comunidad técnica en el futuro. La intención es inequívoca: buscan entregar empleados digitales listos para sentarse en un puesto de trabajo y rendir desde el primer minuto.
Confiar el ordenador a un agente de IA: ¿pueden soportarlo los presupuestos empresariales?
La percepción cotidiana de la inteligencia artificial sigue limitada a menudo a una ventana de chat. No obstante, lo que las organizaciones requieren de verdad son agentes capaces de ejecutar secuencias de decenas de operaciones encadenadas. En la operativa bancaria, gestionar una transferencia internacional no consiste en redactar una respuesta amable. El sistema debe autenticarse en el backend, consultar datos, verificar listas de cumplimiento normativo, comprobar tipos de cambio en tiempo real y asentar la transacción final.
Cada uno de estos pasos depende del anterior. En cada acción, el modelo debe reenviar el historial acumulado de todas las fases anteriores a la ventana de contexto. En flujos de ejecución extensos, un único trámite o depuración puede devorar fácilmente varios millones de tokens. Si la tarifa por token permanece elevada, resolver una sola operación empresarial costaría varios dólares solo en capacidad de cómputo.
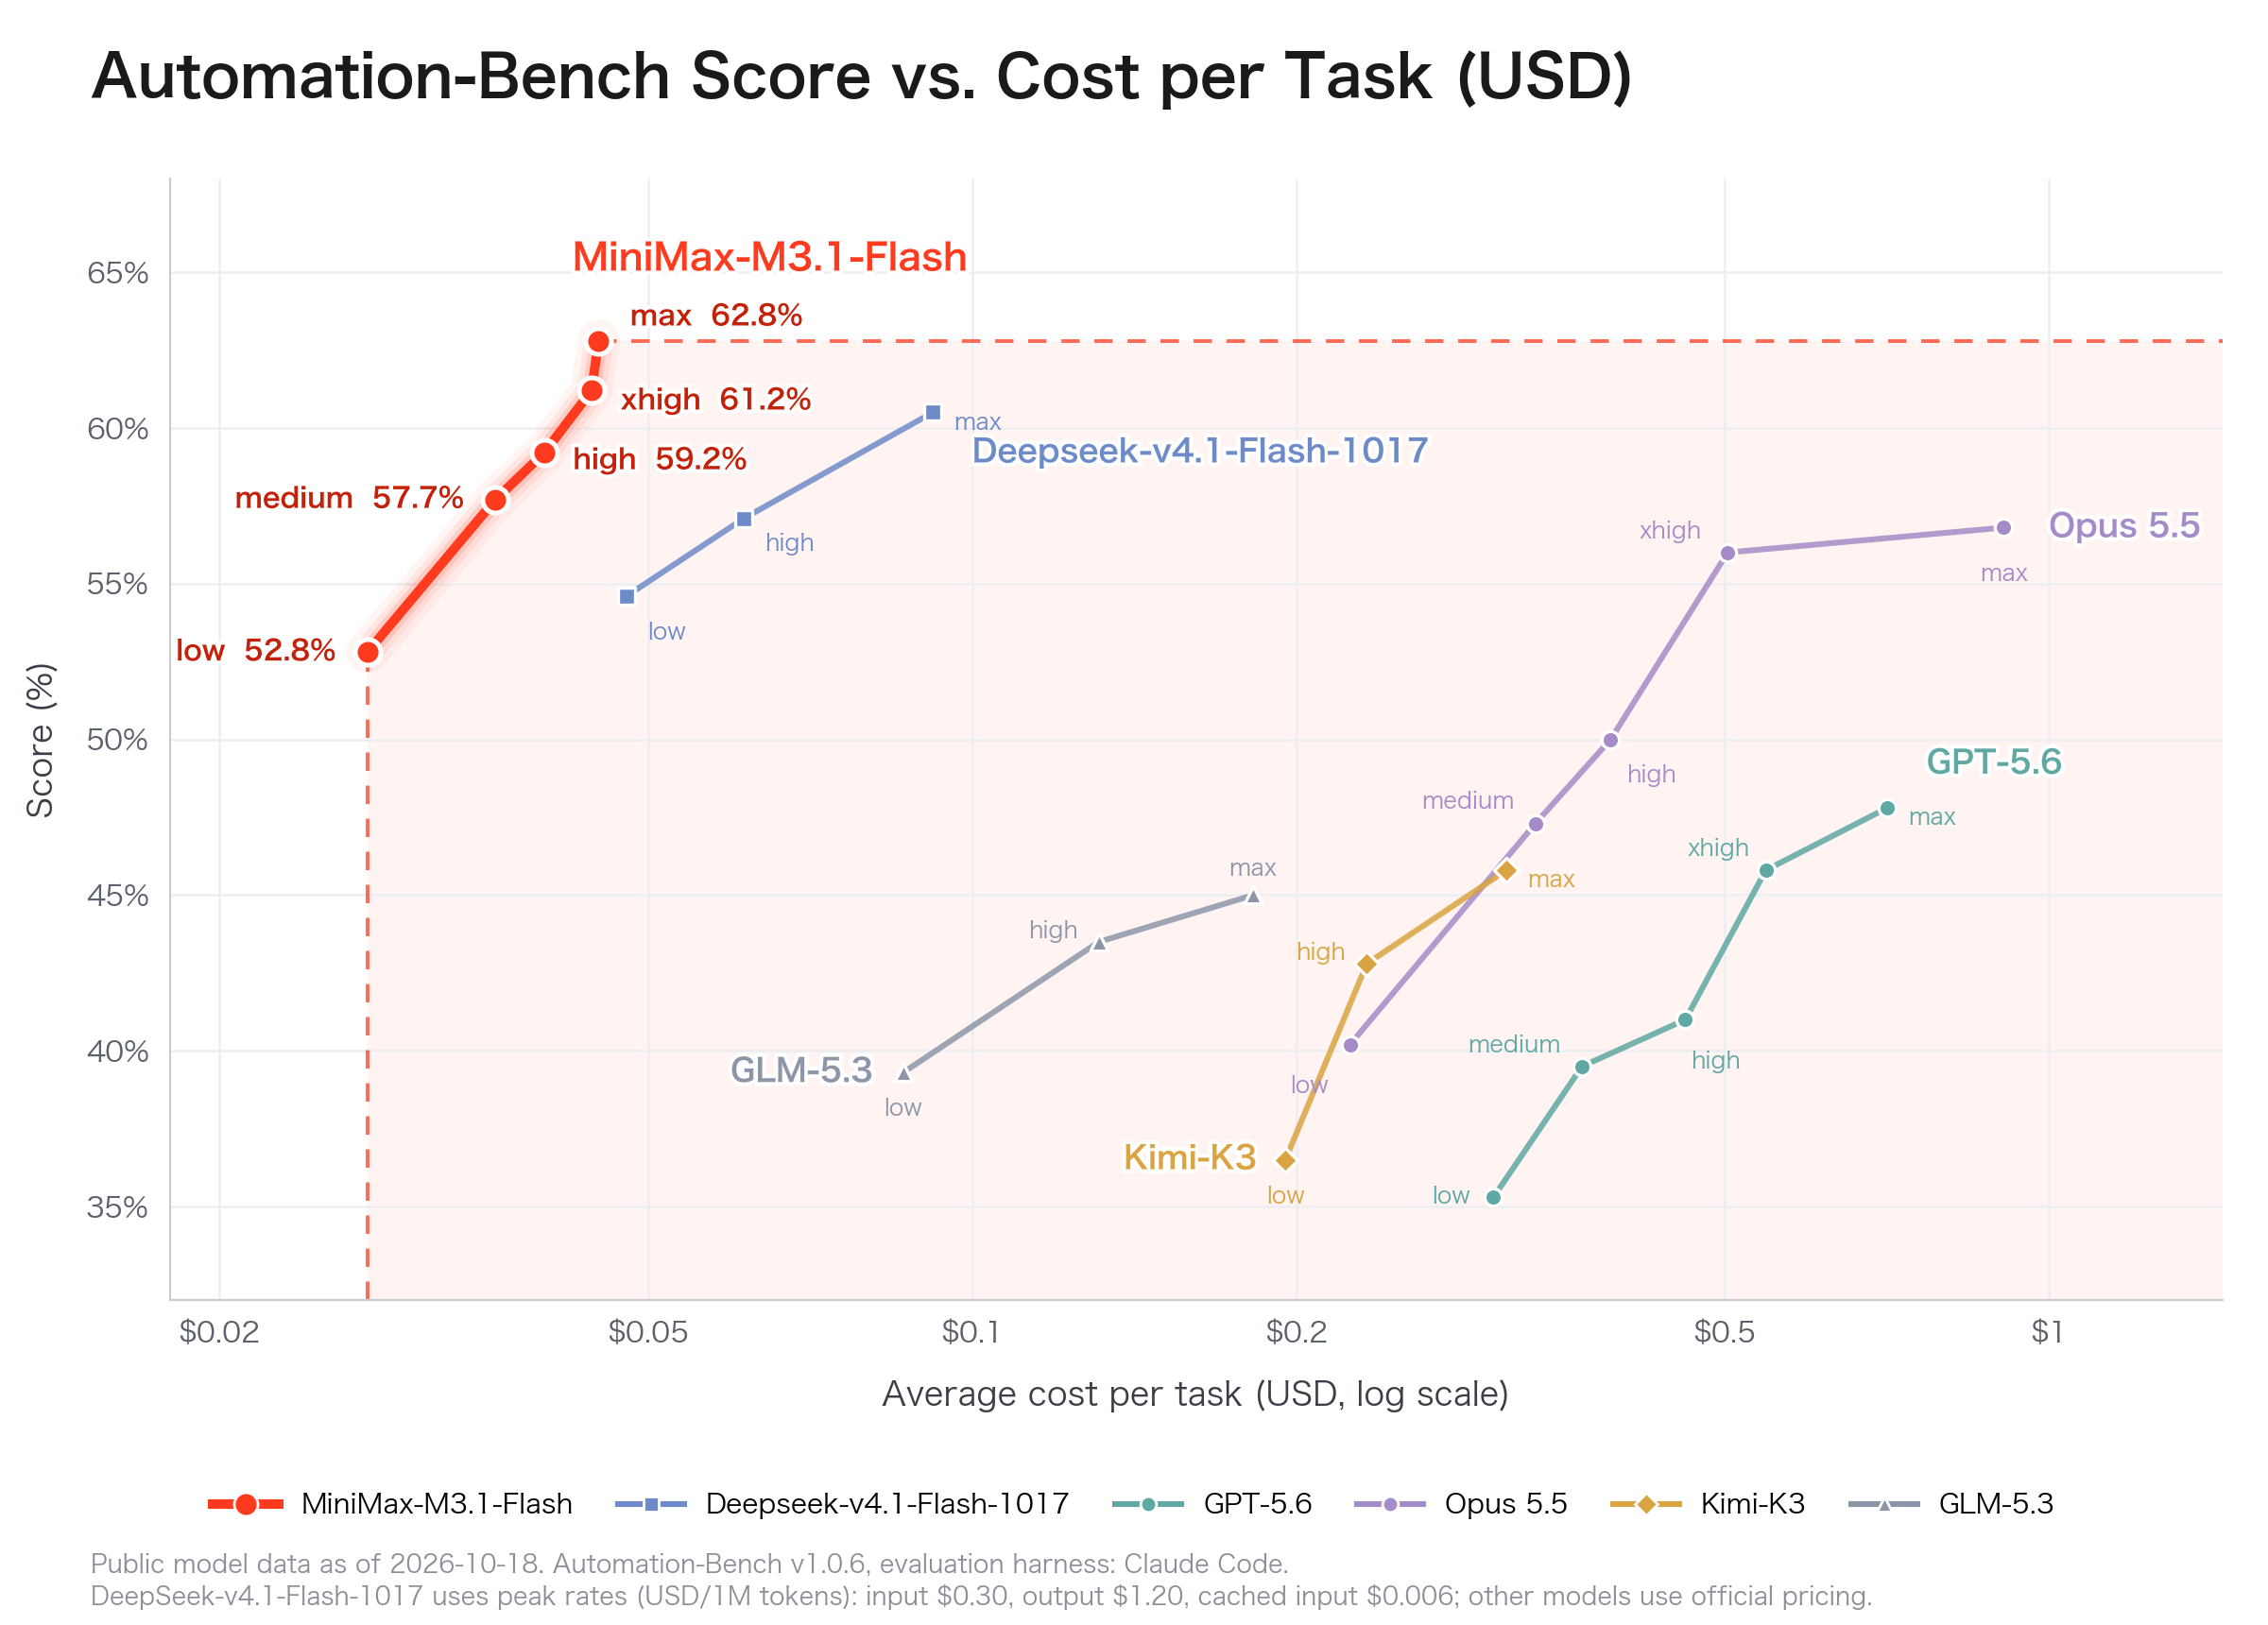 Figura: Comparativa de resultados en benchmarks y costes de inferencia entre MiniMax M3.1 Flash y modelos punteros de la competencia. Fuente: MiniMax (Blog técnico oficial)
M3.1 Flash transforma radicalmente esta estructura de costes. En la lista de precios oficial, la entrada se sitúa en 0,15 dólares por millón de tokens y la salida en 0,60 dólares. Al activar la caché de contexto, el coste de entrada se reduce a tan solo 0,015 dólares. En BankerToolBench, una prueba que evalúa la capacidad de llamadas a herramientas en banca, logró 76,2 puntos. Precios reducidos combinados con un control robusto de herramientas permiten que la automatización cruce el umbral de rentabilidad económica.
Más de 200 tokens por segundo: adiós a las esperas en cadenas complejas
En las labores de automatización, la latencia es un obstáculo tan determinante como el propio presupuesto. Cuando una IA toma el control del escritorio para rellenar tablas o gestionar interfaces, la falta de fluidez en cada clic fragmenta el flujo operativo. Los retrasos excesivos incrementan notablemente el riesgo de tiempos de espera de red agotados y descoordinación en las acciones.
M3.1 Flash eleva la velocidad de generación por encima de los 200 tokens por segundo, manteniendo una velocidad media P50 constante de 170 tokens por segundo. Una directriz estructurada de varios cientos de palabras se genera por completo en poco más de un segundo. Para flujos automatizados que enlazan decenas de acciones consecutivas, este ahorro de tiempo marca la frontera entre un proceso continuo y una ejecución fallida.
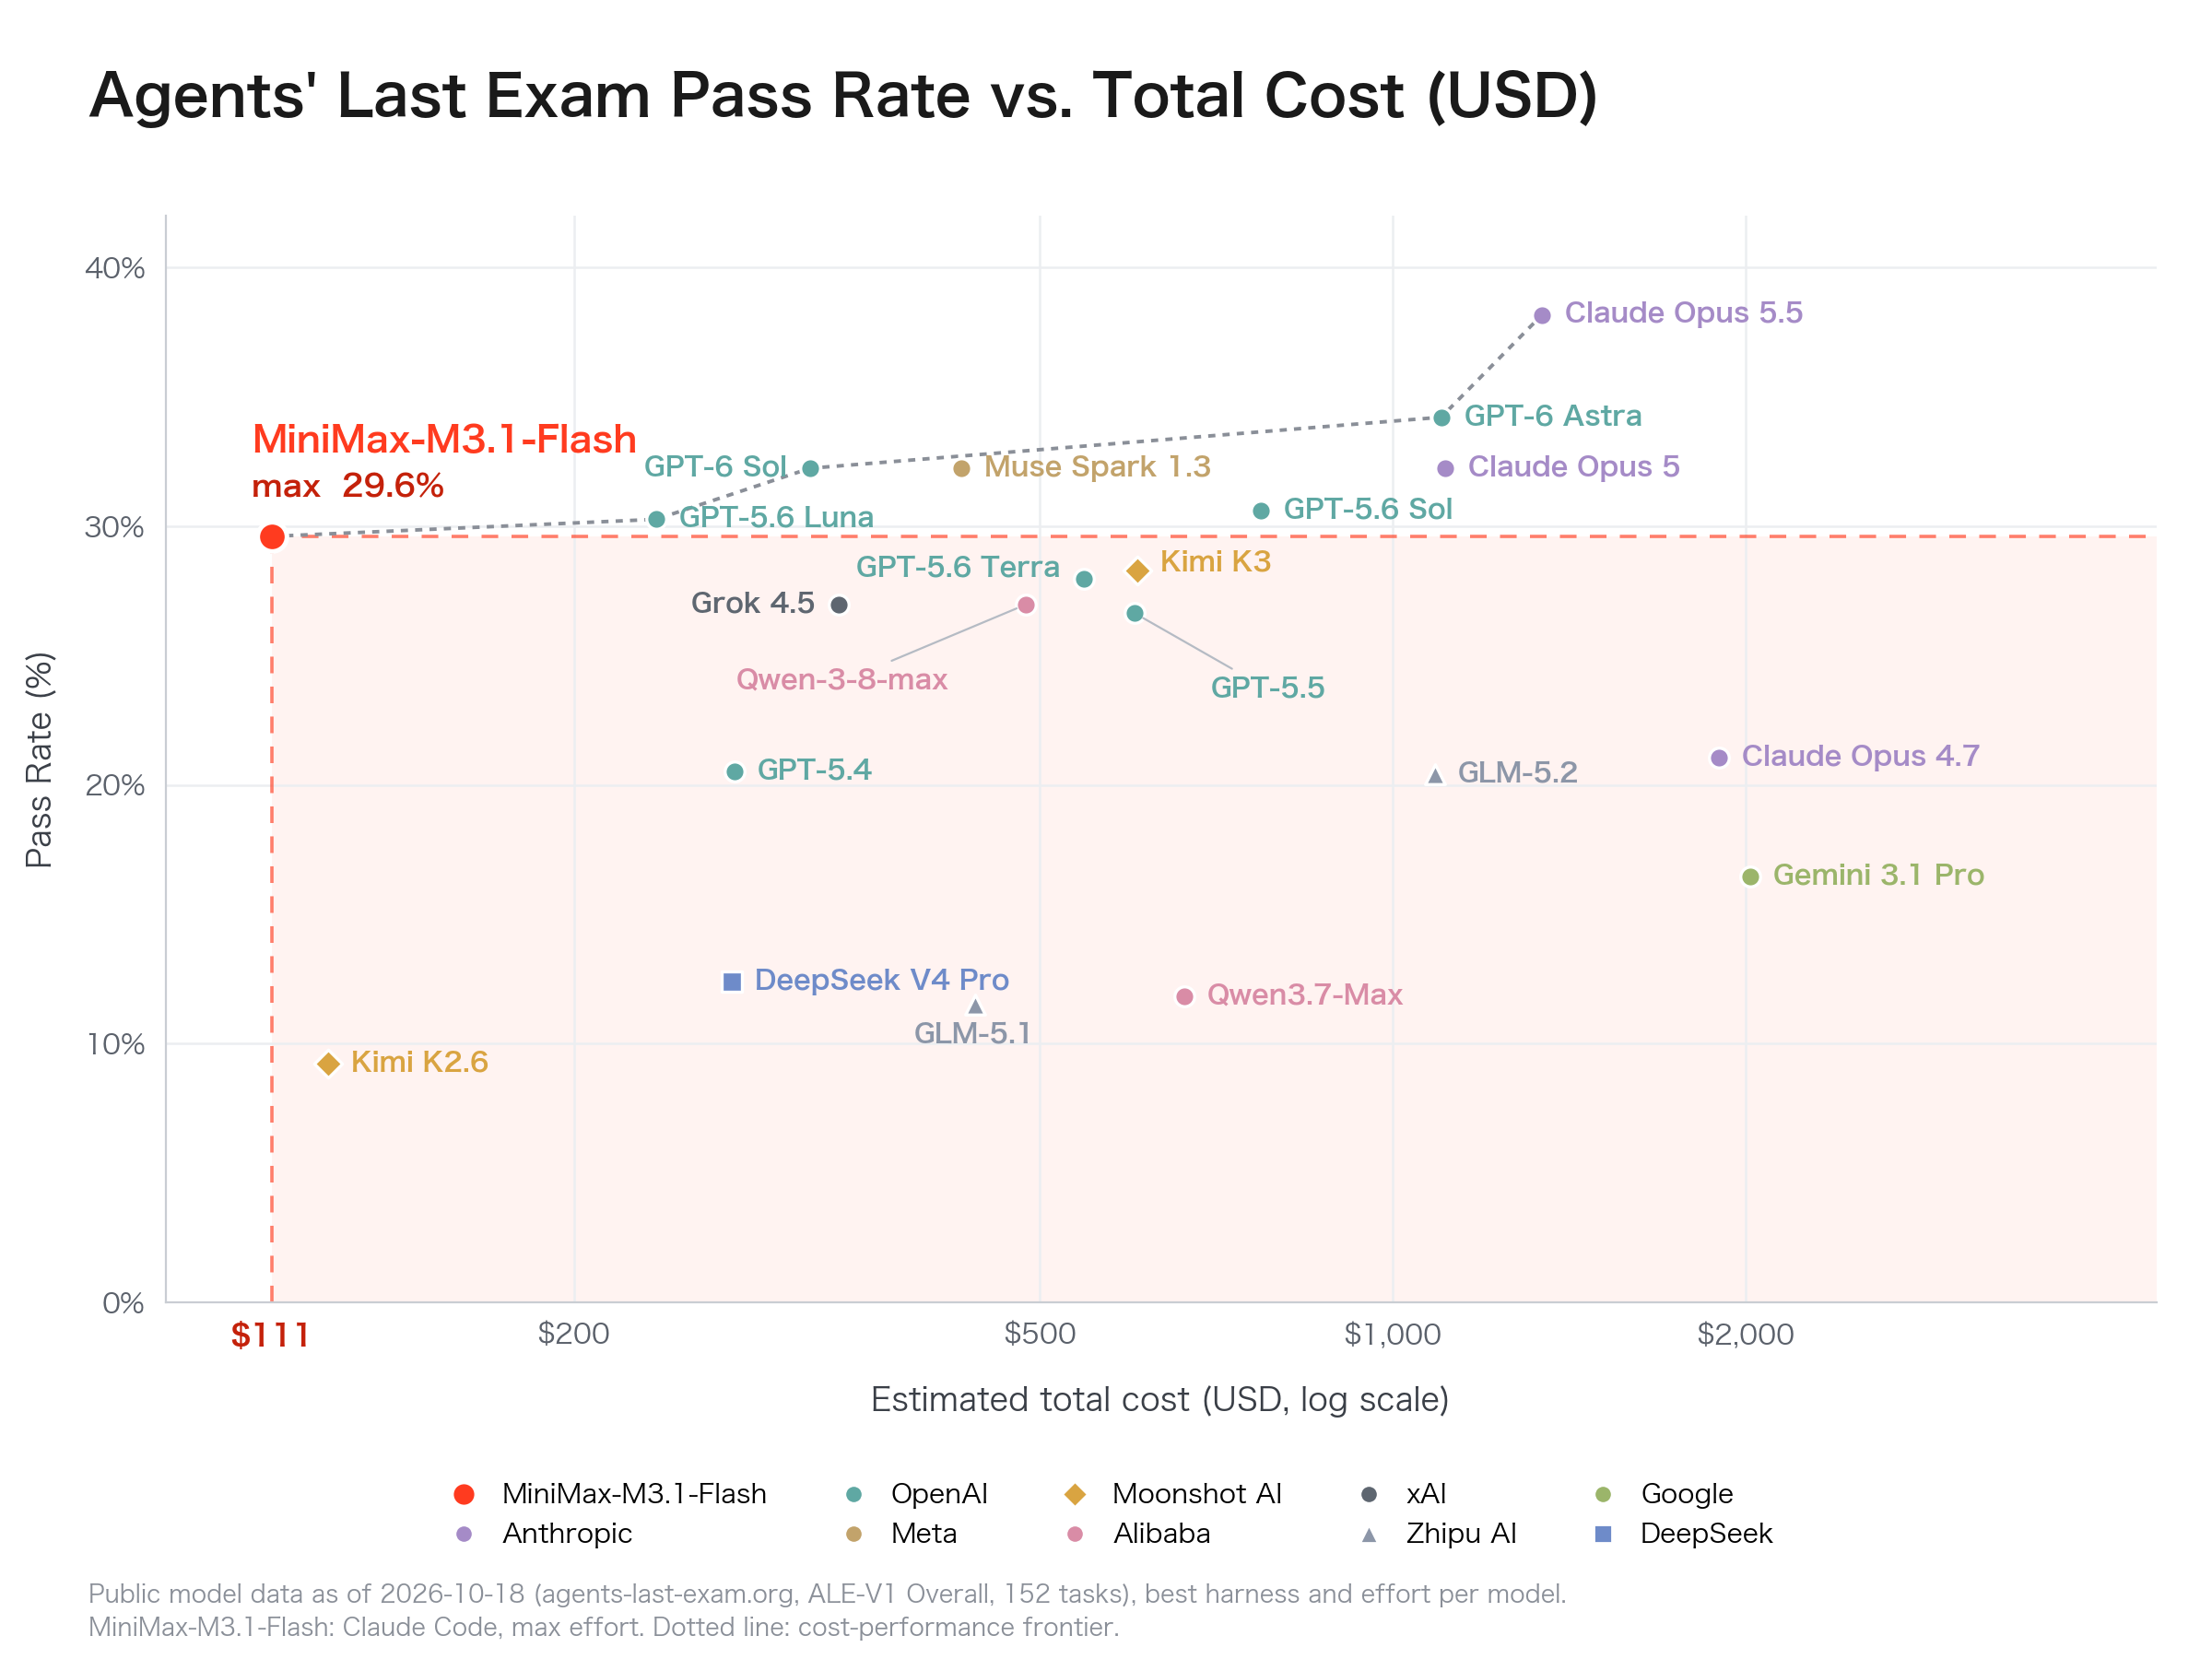 Figura: Puntuaciones de MiniMax M3.1 Flash en diversos entornos operativos reales y conjuntos de pruebas de automatización. Fuente: MiniMax (Blog técnico oficial)
Este alto caudal de procesamiento aporta claras ventajas de ingeniería. En la evaluación OSWorld V2, que emula un sistema operativo real, M3.1 Flash obtuvo 61,7 puntos. En DeepSWE v1.1, benchmark de depuración y corrección de software, alcanzó una tasa de resolución del 73,7%, mientras que en el simulador de ciberseguridad CyberGym registró un 82%. La rapidez en las respuestas elimina los periodos de inactividad, aportando a los flujos automatizados un ritmo operativo constante y estable.
El fin de la obsesión por los benchmarks: el mercado premia el rendimiento tangible
Durante los últimos meses, el debate en torno a los benchmarks hinchados ha crecido con fuerza. En foros especializados, muchos desarrolladores advierten de un deterioro de confianza en el sector. Algunos modelos han sido entrenados específicamente para aprobar cuestionarios públicos, pero fracasan con frecuencia ante código real de ingeniería. Esta brecha entre altas puntuaciones y baja competencia práctica ha provocado recelo en muchas empresas a la hora de contratar servicios de IA.
Para erradicar estos artificios, la industria diseñó evaluaciones más rigurosas como el «Agents’ Last Exam» (ALE). Este marco descarta preguntas de conocimiento general memorizables para evaluar exclusivamente el razonamiento complejo en entornos inéditos. M3.1 Flash obtuvo 29,6 puntos en ALE y se posicionó entre los modelos más avanzados en AutomationBench-AA. De acuerdo con los comunicados oficiales, lidera la clasificación entre los modelos chinos tanto en ALE como en OSWorld V2. Estos resultados tangibles ofrecen un respaldo sólido frente a los exámenes de laboratorio descontextualizados.
La búsqueda de eficiencia económica y pragmatismo no es un caso aislado. Durante las mismas fechas, el equipo de Inception presentó Mercury 3, un modelo con arquitectura de difusión que alcanza 1.068 tokens por segundo y un precio de entrada de 0,10 dólares por millón de tokens. Aunque los enfoques técnicos difieran, la industria muestra un consenso evidente: abaratar drásticamente las barreras de uso. Los modelos centrados exclusivamente en engordar parámetros a costes desorbitados afrontan el desinterés de los clientes.
De puntuaciones astronómicas a mano de obra asequible: un cambio en las reglas del juego
El misticismo alrededor de las tecnologías punteras se está disipando. Cualquier herramienta debe responder en última instancia a una pregunta sencilla: ¿puede realizar el trabajo de forma fiable y a un coste asumible? La verdadera relevancia de MiniMax M3.1 Flash radica en reorientar la atención de la industria hacia los presupuestos cotidianos de los proyectos reales.
Una rebaja del 70% en los precios, sumada a una velocidad casi tres veces mayor, redefine el estándar competitivo. En el ecosistema productivo que se avecina, los factores decisivos ya no serán las presentaciones espectaculares. En medio de millones de clics rutinarios, consultas e intercambios de datos, saldrán ganadores aquellos modelos capaces de ahorrar recursos reales a sus usuarios. El viaje desde las salas de examen hasta los puestos de trabajo reales no ha hecho más que comenzar.
Enlaces de referencia:
- Blog técnico oficial de MiniMax: Anuncio del lanzamiento de M3.1 Flash e indicadores técnicos
- Datos de tráfico real durante el despliegue anónimo: Space Bunny
- Debate técnico en la comunidad Hacker News: Velocidad de inferencia y autenticidad de los benchmarks
- Informe de lanzamiento técnico de Inception Mercury 3