Zweihundert Billionen Token wurden direkt vor den Augen der weltweiten Entwickler-Community verarbeitet – vollkommen unbemerkt. Zehntausende von Entwicklern realisierten erst im Nachhinein, dass sie monatelang als Prüfer in einem groß angelegten Blindtest fungiert hatten. Auf externen API-Aggregatoren war zuvor ein anonymes Modell mit dem Codenamen „Space Bunny“ aufgetaucht. Ohne jeden Hinweis auf den Hersteller bewältigte es kontinuierlich anspruchsvollste Programmier- und Debugging-Aufgaben. Am 20. Oktober 2026 wurde das Rätsel gelüftet: Hinter dem Modell steht das chinesische KI-Unternehmen MiniMax, und die offizielle Bezeichnung lautet M3.1 Flash.
Die zeitgleich veröffentlichten Leistungsdaten versetzten die Branche in Aufruhr: Die Online-Inferenzgeschwindigkeit verdreifachte sich nahezu, während die effektiven API-Kosten um 70 % einbrachen. Über Jahre hinweg überboten sich führende Modelle gegenseitig mit Labor-Benchmarks. Unternehmen, die diese Modelle in reale Produktionsabläufe integrieren wollten, sahen sich jedoch mit horrenden Rechnungen konfrontiert. M3.1 Flash rückt die entscheidende Frage in den Mittelpunkt: Ein Modell muss nicht nur schwierige Aufgaben lösen, sondern sich auf den Bilanzen von Unternehmen auch wirtschaftlich rechnen.
200 Billionen Token im Blindtest: Space Bunny legt die Maske ab
In der KI-Entwicklung gehört das gezielte Optimieren auf öffentliche Benchmark-Datensätze längst zum Alltag. Zahlreiche Teams überoptimieren Architekturen auf bekannte Testfragen. Die Punktzahlen in Bestenlisten steigen kontinuierlich, doch im produktiven Software-Engineering scheitern die Systeme an realen Codebases. Angesichts dieses Dilemmas wählte MiniMax einen radikal anderen Validierungsweg.
Frühe Modell-Checkpoints wurden unter dem Pseudonym „Space Bunny“ direkt in Entwicklerplattformen integriert, um sich unter realen Arbeitsbedingungen zu beweisen. Über Monate hinweg verarbeiteten echte Nutzer mehr als 200 Billionen Token in anspruchsvollen Arbeitsumgebungen. Dieser langwierige Härtetest ohne Marketing-Vorschusslorbeeren neutralisierte zufällige statistische Laborabweichungen. Unvoreingenommene Produktionsaufrufe besitzen ungleich höhere Aussagekraft als kuratierte Prüfungsaufgaben.
Mit dem offiziellen Launch stellte MiniMax API-Zugänge, das Mitgliedschaftsmodell M Plan sowie die Programmierumgebung MiniMax Code bereit. Zudem kündigte das Unternehmen an, die Modellgewichte der Community künftig als Open Source zur Verfügung zu stellen. Die Ausrichtung des Entwicklungsteams ist eindeutig: Sie liefern digitale Arbeitskräfte, die ab Tag eins produktiv am Arbeitsplatz eingesetzt werden können.
Wenn Agenten den Desktop steuern: Halten die Budgets stand?
Für Endnutzer beschränkt sich Künstliche Intelligenz meist auf Dialogfenster. Unternehmen benötigen jedoch autonome Agenten, die in der Lage sind, komplexe Arbeitsabläufe mit Dutzenden aufeinanderfolgenden Schritten durchzuführen. Ein Bankensystem, das einen internationalen Transfer abwickelt, kann sich nicht auf eine Textantwort beschränken: Es muss sich im Backend authentifizieren, Compliance-Datenbanken prüfen, Wechselkurse in Echtzeit abrufen und schließlich Transaktionsprotokolle verbuchen.
Jeder dieser Teilschritte greift ineinander. Bei jedem Aufruf muss die gesamte Historie früherer Aktionen erneut in das Kontextfenster geladen und berechnet werden. In langen Ausführungsketten verschlingt eine einzige Überprüfung mühelos Millionen von Token. Bleiben die Inferenzpreise auf hohem Niveau, kostet die Bearbeitung eines einzigen Geschäftsvorfalls mehrere Dollar an reiner Rechenleistung.
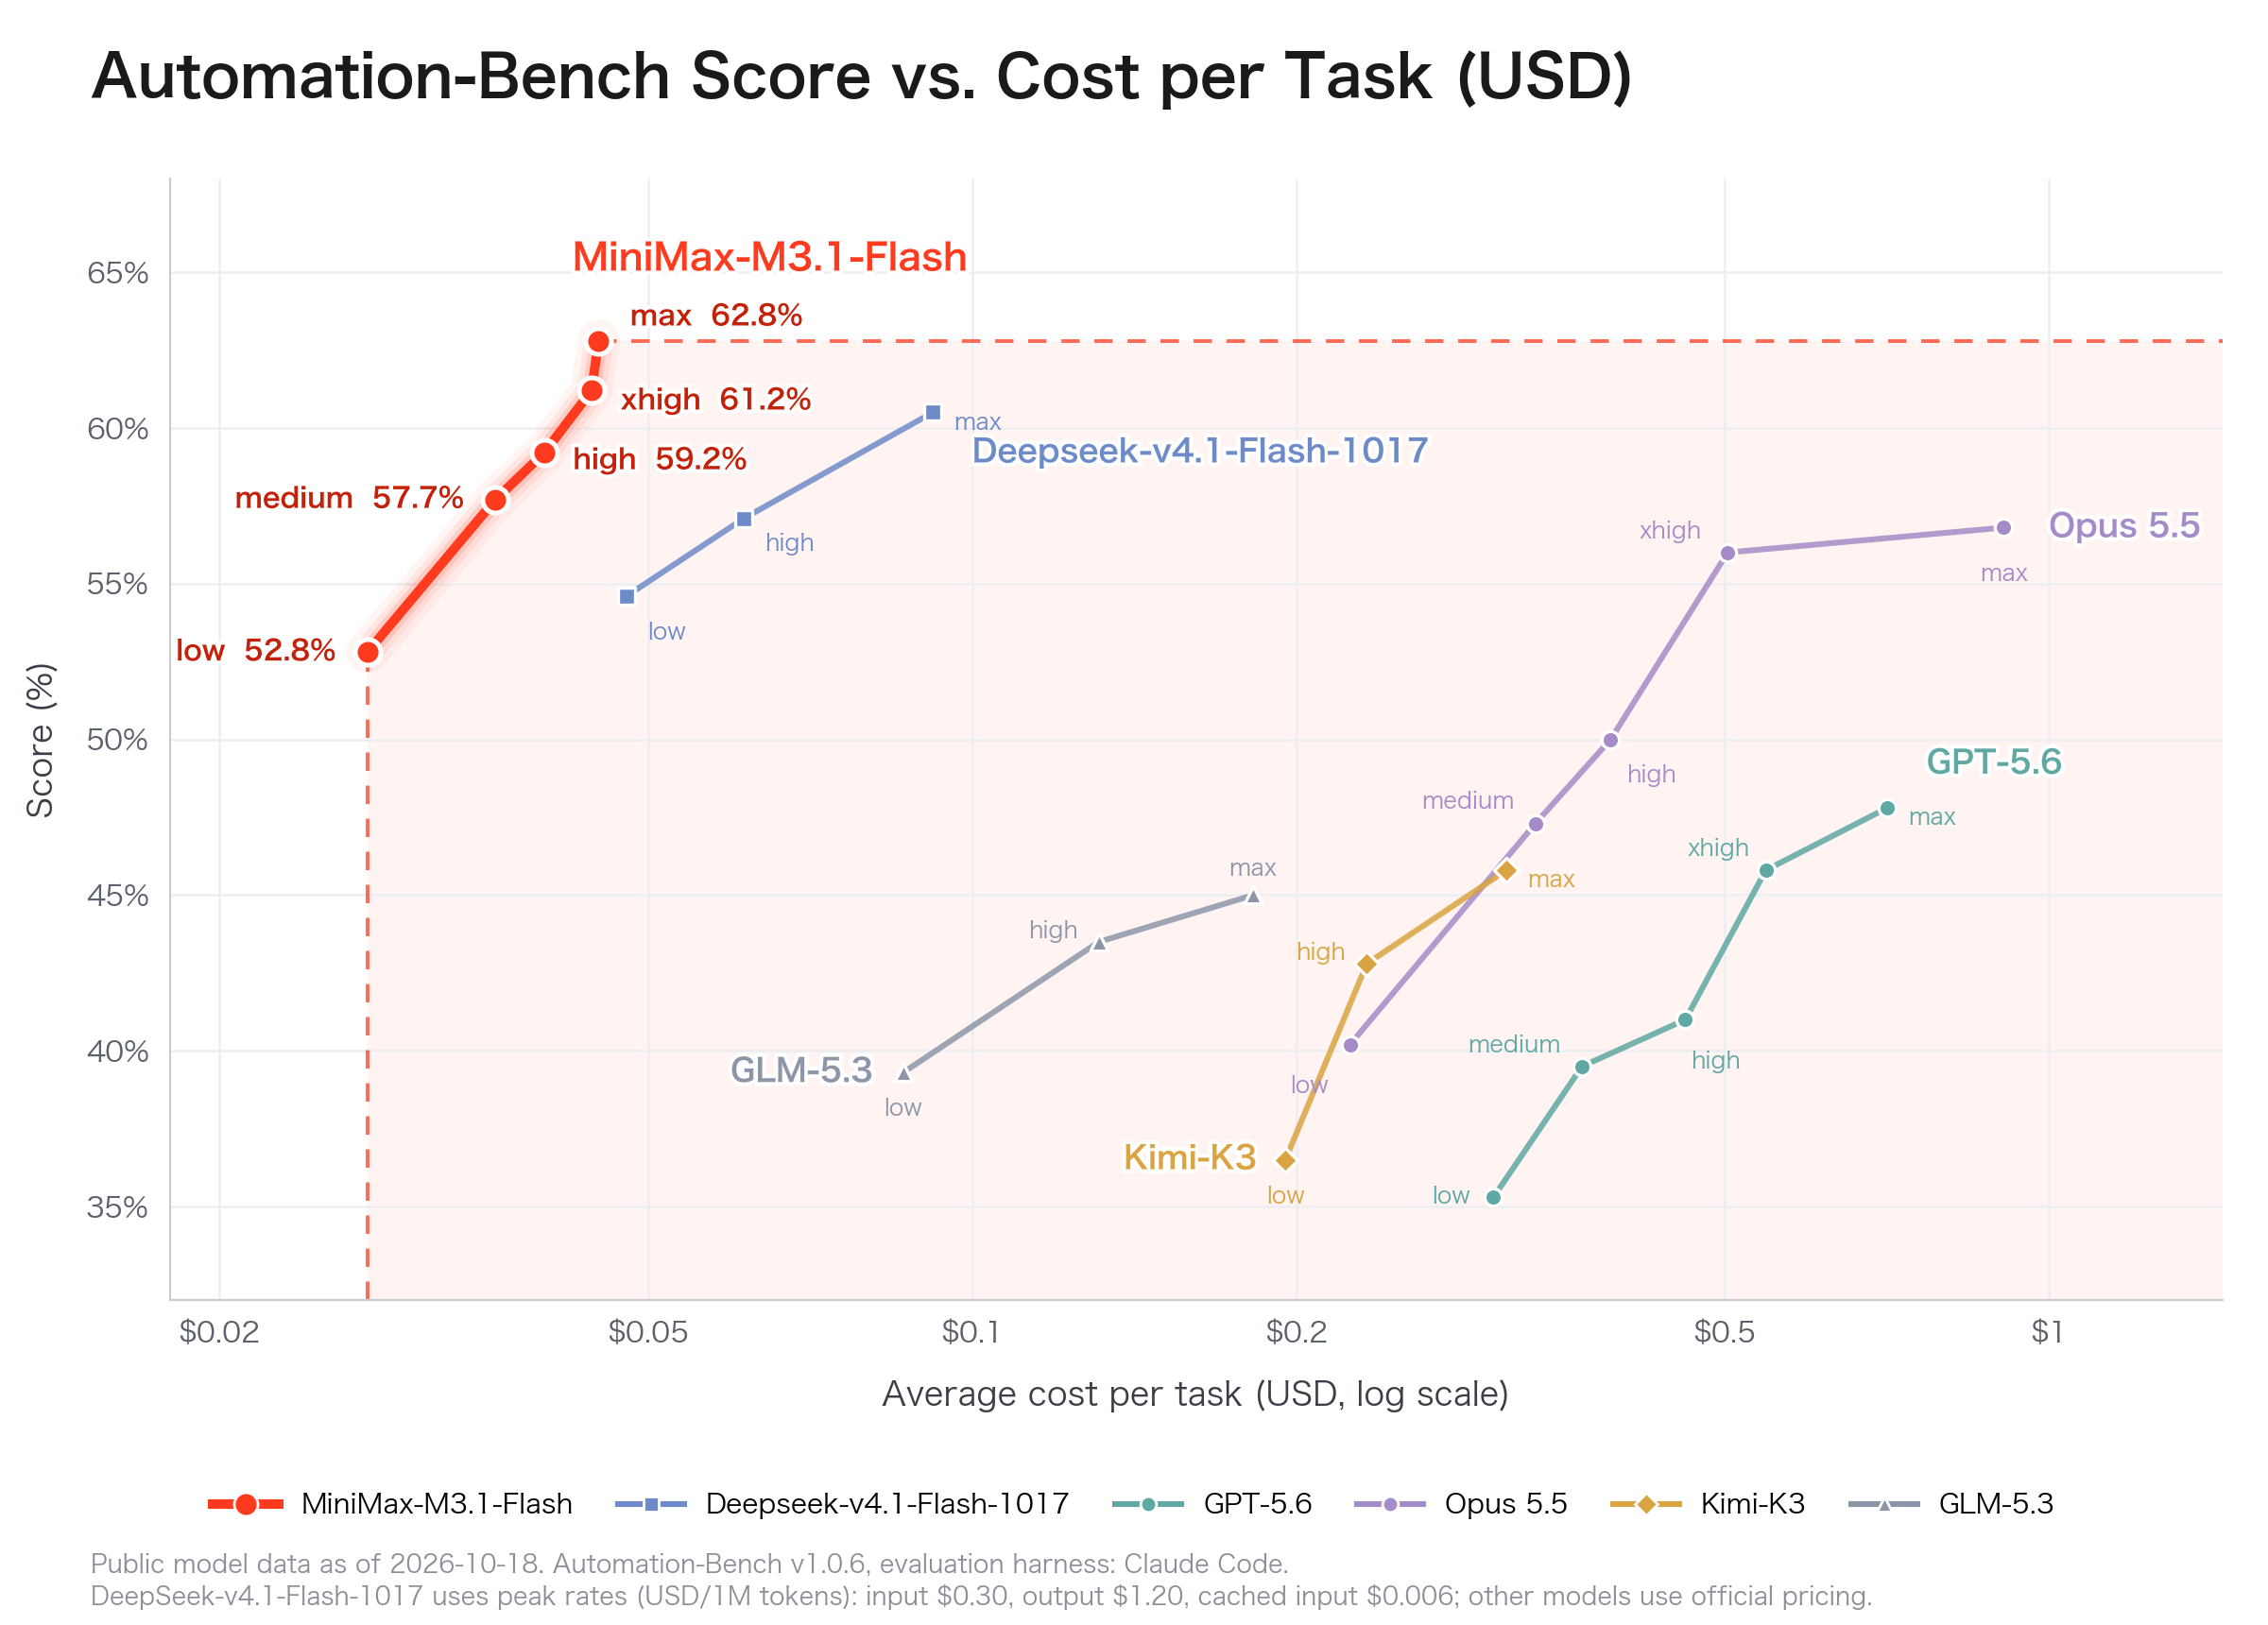 Abbildung: Benchmark-Ergebnisse und Inferenzkosten von MiniMax M3.1 Flash im Vergleich zu konkurrierenden Spitzenmodellen. Quelle: MiniMax (Offizieller Technik-Blog)
M3.1 Flash restrukturiert dieses Preisgefüge von Grund auf: Die offizielle Preisstruktur liegt bei 0,15 US-Dollar pro Million Input-Token und 0,60 US-Dollar pro Million Output-Token. Bei aktiviertem Context-Caching sinken die Input-Kosten sogar auf 0,015 US-Dollar. Im BankerToolBench, der die Zuverlässigkeit bei Werkzeugaufrufen in Finanzprozessen misst, erzielte das Modell 76,2 Punkte. Niedrige Aufrufkosten in Kombination mit robuster Funktionssteuerung heben Automatisierungsaufgaben über die Rentabilitätsschwelle.
Über 200 Token pro Sekunde: Schluss mit Verzögerungen in Aktionsketten
Bei der Prozessautomatisierung ist Latenz ein ebenso kritischer Engpass wie die Kosten. Wenn eine KI Steuerungsaufgaben auf dem Desktop übernimmt und Tabellen manipuliert, zerstört jede Verzögerung beim Mausklick den Ausführungsfluss. Zu lange Wartezeiten erhöhen zudem das Risiko von Netzwerk-Timeouts und asynchronen Fehlzuständen drastisch.
M3.1 Flash hebt die Ausgaberate auf über 200 Token pro Sekunde an, wobei die mediane P50-Geschwindigkeit stabil bei 170 Token pro Sekunde liegt. Strukturierte Handlungsanweisungen mit mehreren hundert Zeichen entstehen in knapp einer Sekunde. Bei Workflows, die Dutzende aufeinanderfolgende Aktionen erfordern, entscheidet diese Reaktionszeit darüber, ob eine Kette stabil durchläuft oder abreißt.
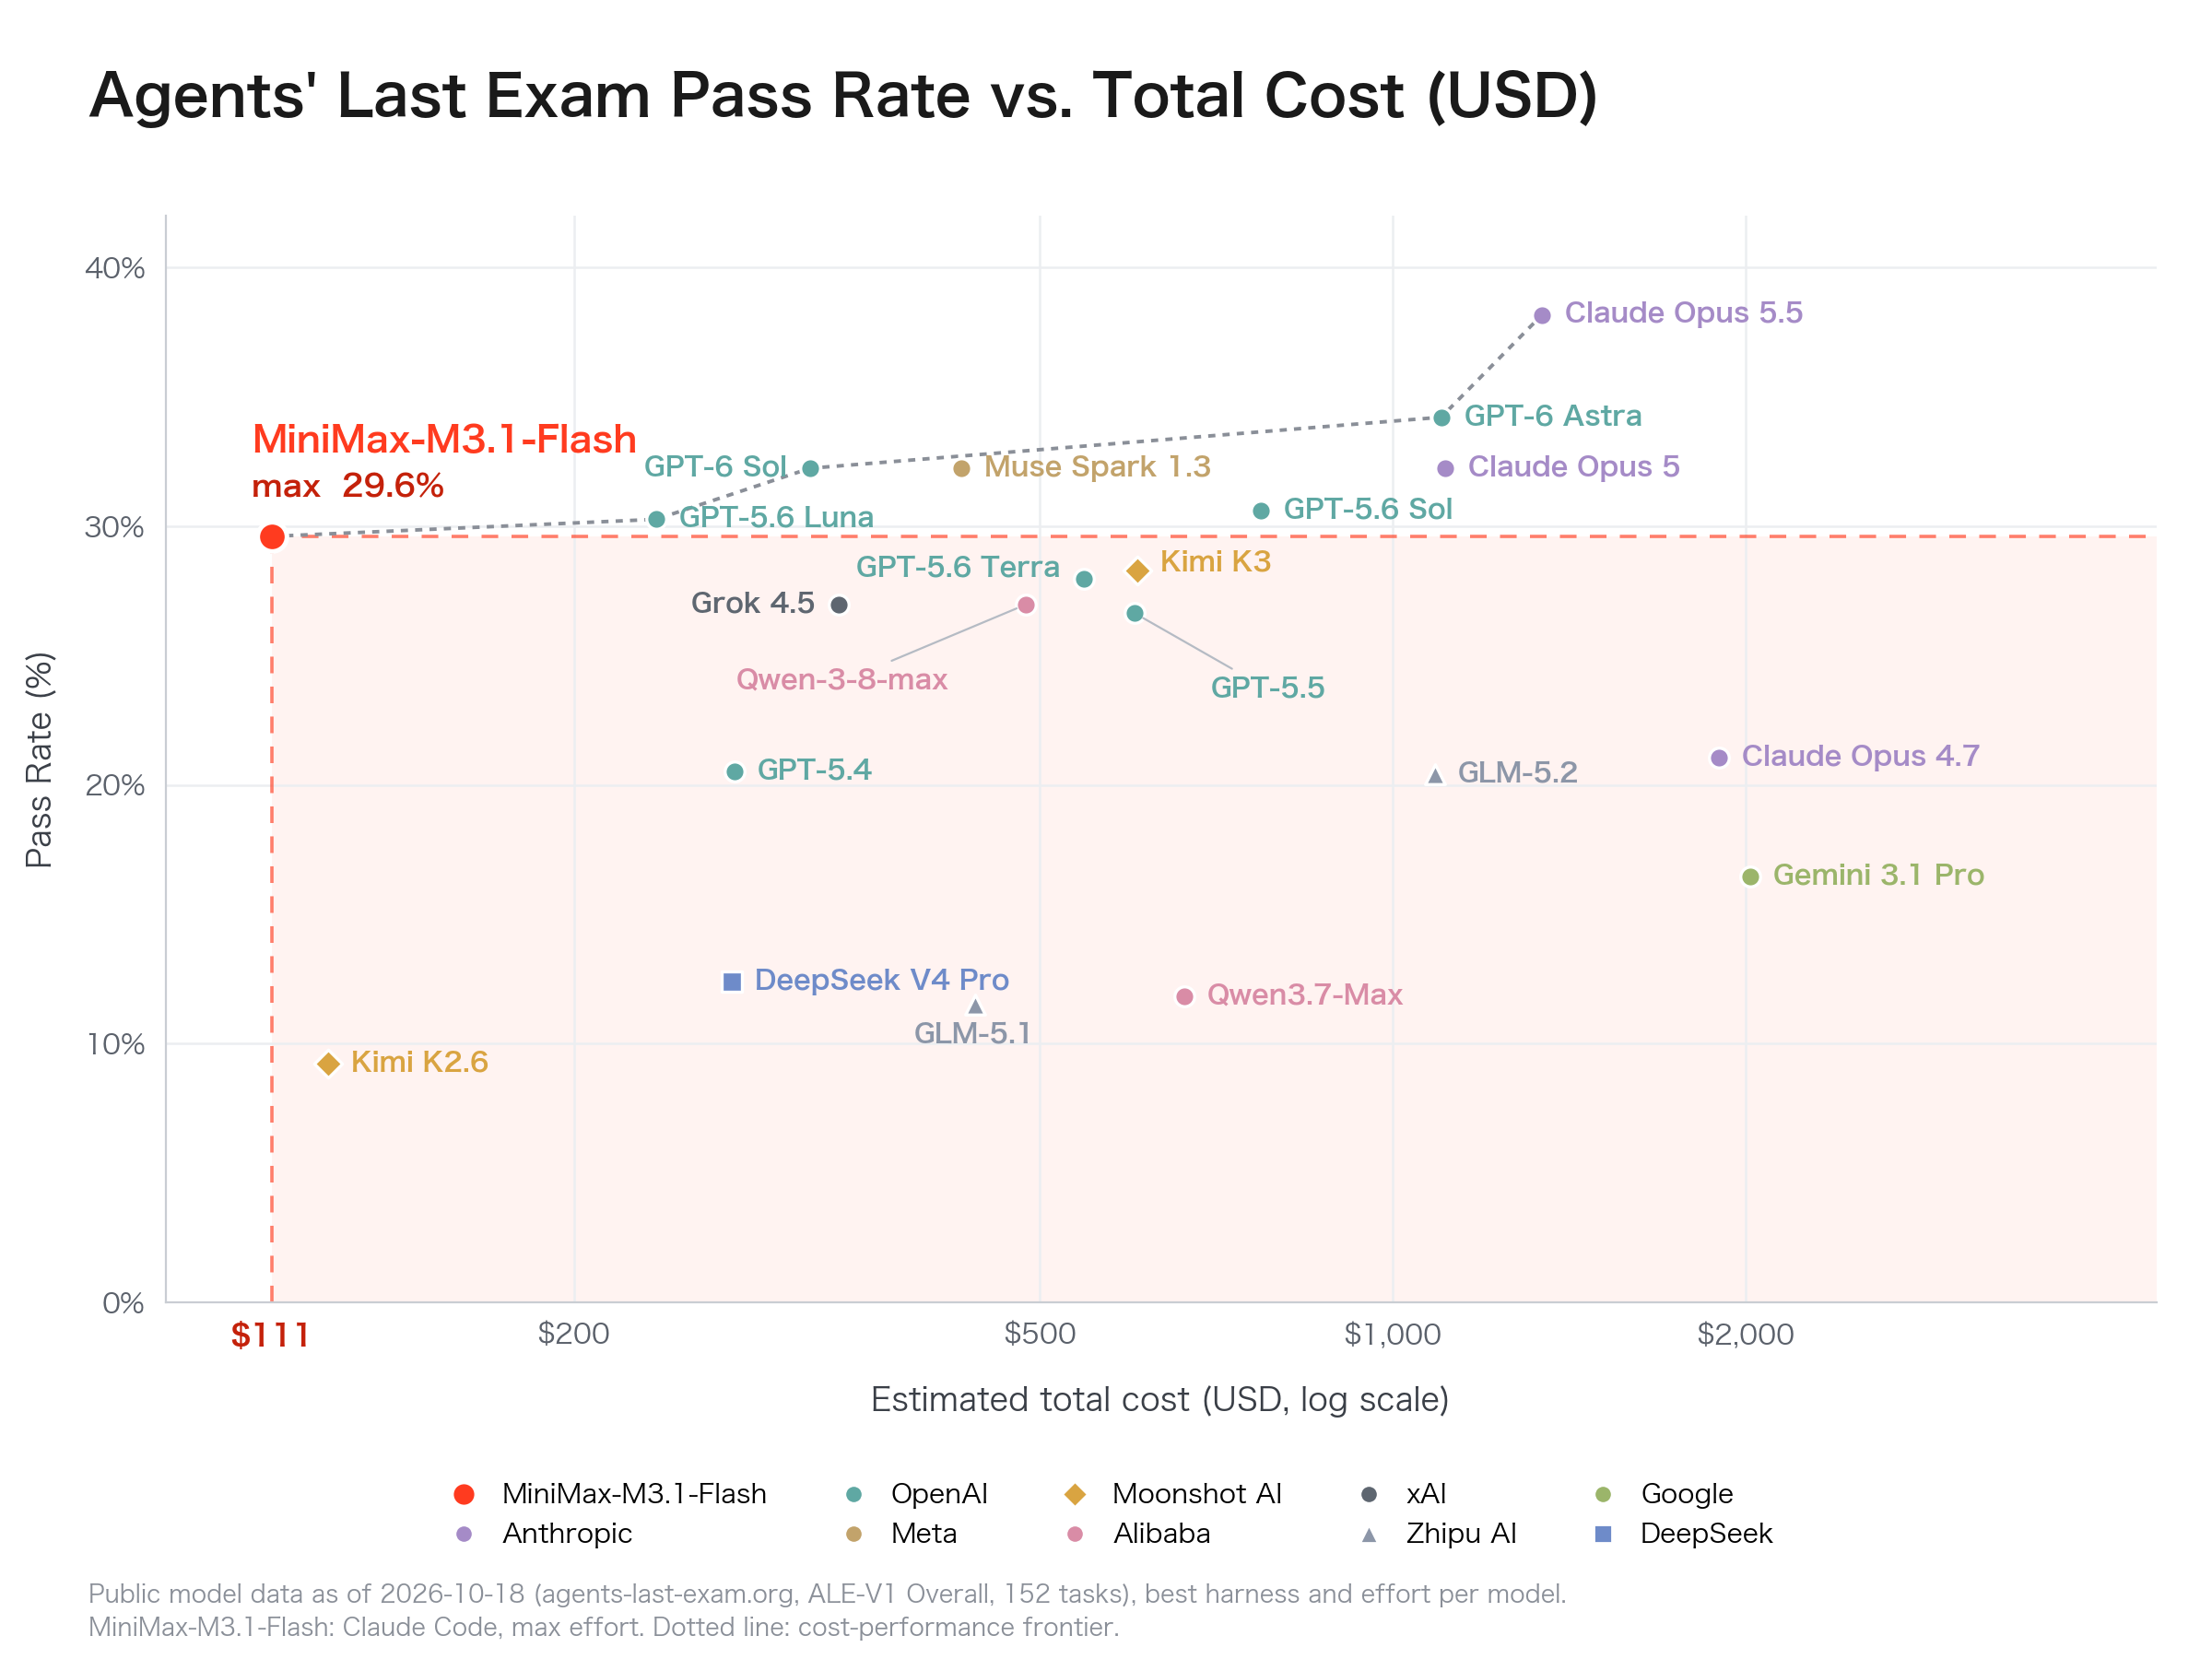 Abbildung: Leistungsdaten von MiniMax M3.1 Flash in realen Automatisierungs- und Systemsteuerungs-Benchmarks. Quelle: MiniMax (Offizieller Technik-Blog)
Der hohe Durchsatz zahlt sich technisch unmittelbar aus: Im Benchmark OSWorld V2, der reale Betriebssystemumgebungen simuliert, erreichte M3.1 Flash 61,7 Punkte. Im Software-Engineering-Benchmark DeepSWE v1.1 erzielte es eine Lösungsquote von 73,7 %, während im Cybersecurity-Szenario CyberGym 82 % erreicht wurden. Die hohe Verarbeitungsfrequenz minimiert Leerlaufzeiten und verleiht automatisierten Prozessen ein unterbrechungsfreies Ausführungstempo.
Das Ende des Benchmark-Gamings: Reale Wertschöpfung schlägt Prüfungsnoten
In Entwicklerkreisen wird die Aussagekraft synthetischer Benchmarks zunehmend hinterfragt. Zahlreiche Ingenieure warnen vor einem Glaubwürdigkeitsverlust der Branche: Modelle werden gezielt auf Testsets dressiert, versagen jedoch regelmäßig an echter Codebasis. Diese Diskrepanz zwischen exzellenten Noten und mangelnder Praxistauglichkeit bremste bisher viele Unternehmensentscheidungen.
Um praxisferne Verzerrungen zu bereinigen, wurden anspruchsvollere Kriterien wie das „Agents’ Last Exam“ (ALE) entwickelt. Dieser Standard schließt reine Auswendiglern-Aufgaben aus und testet komplexe Schlussfolgerungen in unbekannten Umgebungen. M3.1 Flash erzielte im ALE 29,6 Punkte und etablierte sich im AutomationBench-AA in der Spitzengruppe. Laut Herstellerangaben belegt das Modell sowohl im ALE als auch im OSWorld V2 den Spitzenplatz unter den chinesischen Modellen. Diese Ergebnisse liefern ein belastbares Fundament jenseits künstlicher Bestenlisten.
Dieser Fokus auf Pragmatismus und niedrige Stückkosten ist kein Einzelfall: Parallel stellte das Team von Inception das Modell Mercury 3 vor, das auf einer Diffusionsarchitektur basiert, Geschwindigkeiten von 1.068 Token pro Sekunde erreicht und den Input-Preis auf 0,10 US-Dollar drückt. Unabhängig von der gewählten Architektur herrscht in der Branche seltene Einigkeit über ein Ziel: Die Einstiegshürden müssen radikal sinken. Modelle, die allein auf rechenintensive Parameterberge setzen, stoßen am Markt auf wachsende Zurückhaltung.
Von teuren Prestige-Scores zu bezahlbarer Arbeitsleistung: Neue Spielregeln
Die anfängliche Faszination für bloße Modellgrößen weicht nüchternem Pragmatismus. Jedes System muss letztlich beweisen, ob es zugewiesene Aufgaben zuverlässig und zu tragbaren Kosten erledigen kann. Die eigentliche Bedeutung von MiniMax M3.1 Flash liegt darin, den Fokus wieder auf die betriebswirtschaftliche Realität zu lenken.
Eine Preissenkung um 70 % bei einer Verdreifachung des Durchsatzes definiert die Spielregeln neu. In der künftigen Softwarelandschaft entscheiden nicht spektakuläre Präsentationen über den Erfolg. Bei Millionen alltäglicher Klicks, Abfragen und Datenübertragungen setzen sich diejenigen Werkzeuge durch, die Anwendern bare Münze sparen. Der Wandel von der akademischen Prüfungskammer zur betrieblichen Werkbank hat gerade erst begonnen.
Weiterführende Links:
- MiniMax Offizieller Technik-Blog: Ankündigung und technische Spezifikationen zu M3.1 Flash
- Telemetriedaten aus der anonymen Blindtestphase: Space Bunny
- Hacker News Diskussion: Inferenzgeschwindigkeiten und Benchmark-Authentizität
- Inception Mercury 3 Technischer Veröffentlichungsbericht