Am 13. Oktober 2026 stellte ein Forschungsteam der Stanford University und von Together AI eine neuartige Inferenzarchitektur namens HybridAgent vor (arXiv:2610.18861). Über 11 domänenübergreifende Benchmarks hinweg übertrafen die 8B- und 14B-Modelle moderne LLM-Agenten sowie spezialisierte Werkzeug-Frameworks; die 14B-Variante lag im Schnitt um 17,4 % über der stärksten Baseline. Gleichzeitig reduzierte das System den Text-Token-Verbrauch auf 1/2,7 reiner Text-Baselines, was einer Gesamteinsparung an Tokens zwischen 35,5 % und 54,7 % entspricht.
Gängige autonome Agenten formulieren bei komplexen Aufgaben jeden einzelnen Denkschritt als diskrete Text-Tokens aus. Hunderte Zwischenwörter füllen den GPU-Speicher (VRAM) und treiben die Inferenzlatenz in die Höhe. Wird der interne Überlegungsprozess stattdessen in einem kontinuierlichen latenten Raum gehalten und erst im Moment der Interaktion in Text dekodiert, verdoppelt sich die Generierungsgeschwindigkeit. Die eingesparten Rechenressourcen verbessern den Durchsatz bei langwierigen Interaktionen spürbar.
Interne Denkprozesse im latenten Raum: Text-Tokens auf ein Drittel reduziert
Klassische ReAct-Frameworks stützen sich auf ausführliche Selbstgespräche, um Aufgaben zu lösen. Bevor ein Agent eine Websuche startet oder Python-Code ausführt, generiert er Hunderte von Tokens, die seinen Plan darlegen. Diese Zwischenwörter besitzen für externe Werkzeuge keinerlei Nutzen, müssen jedoch einzeln die Softmax-Projektion des Vokabulars durchlaufen. Die autoregressive Dekodierung verschwendet wertvolle Speicherbandbreite für interne Introspektion.
HybridAgent definiert die Grenze zwischen Denken und Handeln neu. Das Modell wechselt innerhalb eines einheitlichen Generierungsprozesses nahtlos zwischen zwei Modi. Der latente Modus übernimmt die rekursive interne Inferenz, während der Textmodus für externe Aktionen zuständig ist. Das Forschungsteam führte <latent> und </latent> als Anker für den Moduswechsel ein. Im latenten Raum führt das Netzwerk pro Vorwärtsdurchlauf genau einen latenten Vektorzustand fort, wobei die Verweildauer typischerweise zwischen 16 und 256 Schritten liegt.
Die in der Publikation belegte Effizienzsteigerung umfasst drei Dimensionen. Der Text-Token-Bedarf im Hybridmodus sinkt auf 1/2,7 der reinen Text-Baseline, die Gesamtzahl der Generierungsschritte verringert sich um bis zu 54 %, und die End-to-End-Inferenzgeschwindigkeit steigt um den Faktor 2,1. Da latente Zustände sowohl die Vokabularprojektion als auch die erneute Einbettung umgehen, sinkt die Belastung der Speicherbandbreite drastisch.
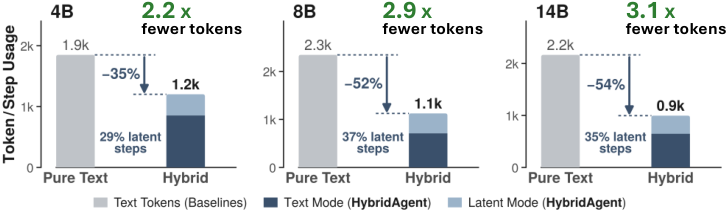 Abbildung: Veränderung des Text-Token-Verbrauchs und der Gesamtgenerierungsschritte von HybridAgent bei 4B-, 8B- und 14B-Modellen im Vergleich zur reinen Text-Baseline. Quelle: arXiv 2610.18861
Neben der Latenz sinken auch die Betriebskosten erheblich. Bei einem geschätzten Mietpreis von 2,50 US-Dollar pro NVIDIA-H100-Stunde und einer Auslastung von 10 % der BF16-Spitzenrechenleistung fallen die Kosten für die Beantwortung von einer Million Benchmark-Fragen beim 4B-Modell von 359 auf 98 Dollar, beim 8B-Modell von 439 auf 121 Dollar und beim 14B-Modell von 470 auf 176 Dollar – eine Kostenreduktion um den Faktor 3,7, 3,6 bzw. 2,7. Diese Berechnung berücksichtigt die von den latenten Schritten beanspruchte Backbone-Rechenleistung vollständig und zählt nicht bloß die eingesparten Tokens.
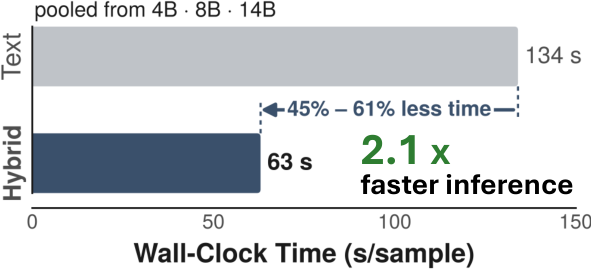 Abbildung: Beschleunigungsfaktor der Inferenzzeit von HybridAgent über drei Modellskalierungen hinweg. Quelle: arXiv 2610.18861
Residuelle Abbildung verbindet Kontexte: KV-Cache ohne erneutes Enkodieren
Um kontinuierliche Vektoren und diskrete Tokens in einem gemeinsamen neuronalen Netz zu verarbeiten, muss die Dimensionalität der Repräsentationen harmonisiert werden. Die Forscher entwickelten dazu HybridLink, eine schlanke residuelle Adapterschicht. Dieses Modul bildet den versteckten Zustand der letzten Modellschicht direkt in den Eingabe-Einbettungsraum zurück. Latente Zustände dienen so unmittelbar als Eingabevektor für den nächsten Berechnungsschritt, ohne den Umweg über eine inverse Textdekodierung.
Dieser Aufbau gewährleistet ein zusammenhängendes Arbeitsgedächtnis über mehrere Runden hinweg. Prompts, latente Inferenzvektoren und Werkzeugbeobachtungen werden gemeinsam in einem einzigen kontinuierlichen Key-Value-Cache (KV-Cache) abgelegt. Nach Abschluss eines Werkzeugaufrufs muss der Kontext nicht geleert und neu berechnet werden. Das Modell rechnet nahtlos auf dem bestehenden VRAM-Cache weiter, wodurch wiederholte Vorwärtsdurchläufe entfallen.
Das Training dieses hybriden Systems erfordert eine spezialisierte zweistufige Pipeline. Die erste Stufe, HybridSFT, nutzt einen selbstkonditionierten Zwei-Pass-Trainingsansatz: Der erste Durchlauf generiert latente Zieleingaben mittels Teacher Forcing, während der zweite Durchlauf reale Einbettungen durch die Vorhersagen des Modells ersetzt. Textpositionen werden mit Kreuzentropie-Verlust, latente Positionen mit Regressionsverlust optimiert, wodurch Backbone und HybridLink gemeinsam aktualisiert werden. In der zweiten Stufe, HybridRL, optimiert Reinforcement Learning die Entscheidung darüber, wann im latenten Raum gedacht und wann in Text agiert werden soll.
Die Implementierung basiert auf Erweiterungen von verl und vLLM und wurde auf 32 NVIDIA-H100-GPUs trainiert. Indem Zwischenberechnungen direkt in den Tensor Cores verbleiben, werden die Speichercontroller von ständigen Vokabularzugriffen entlastet und wertvolle Bandbreite für tatsächliche Interaktionen freigehalten.
Überprüfbare latente Vektoren: Interne Zustände bewahren semantische Klarheit
Die zentrale Kritik an latenter Inferenz betrifft die mangelnde Transparenz: Wenn Denkschritte nur als Fließkommavektoren existieren, sind Debugging und Sicherheitsüberprüfungen erschwert. Die Autoren zeigen jedoch, dass die Rekonstruktion ohne zusätzliche Decoder auskommt. Durch die Kosinus-Ähnlichkeit zwischen dem durch HybridLink projizierten latenten Vektor und den Token-Einbettungen des Vokabulars lässt sich über den nächsten Nachbarn ein lesbarer Pseudotext erzeugen. Formel 5 beschreibt diese Abbildung als argmax über das Vokabular; dieselbe Metrik bestimmt auch den Ausstiegsanker </latent>.
Die Lesbarkeit wird über die durchschnittliche Kosinus-Ähnlichkeit zwischen latenten Vektoren und den nächsten Token-Einbettungen quantifiziert. Ein Wert von 1 signalisiert die exakte Übereinstimmung mit einem Vokabulareintrag. Ein Rausch-Schwellenwert wurde anhand von 2.000 Gauß-Zufallsvektoren ermittelt und über 200 Aufgaben hinweg getestet. Die Kontextspezifität misst die Wortüberschneidung zwischen dem Pseudotext und der ursprünglichen Aufgabenstellung im Vergleich zu unbeteiligten Aufgaben. Liegt das Verhältnis über 1, zielt der Denkprozess nachweislich auf die aktuelle Frage ab. Nur Vektoren oberhalb des Rauschwerts mit einer Spezifität größer 1 eignen sich für verlässliche Prüfungen.
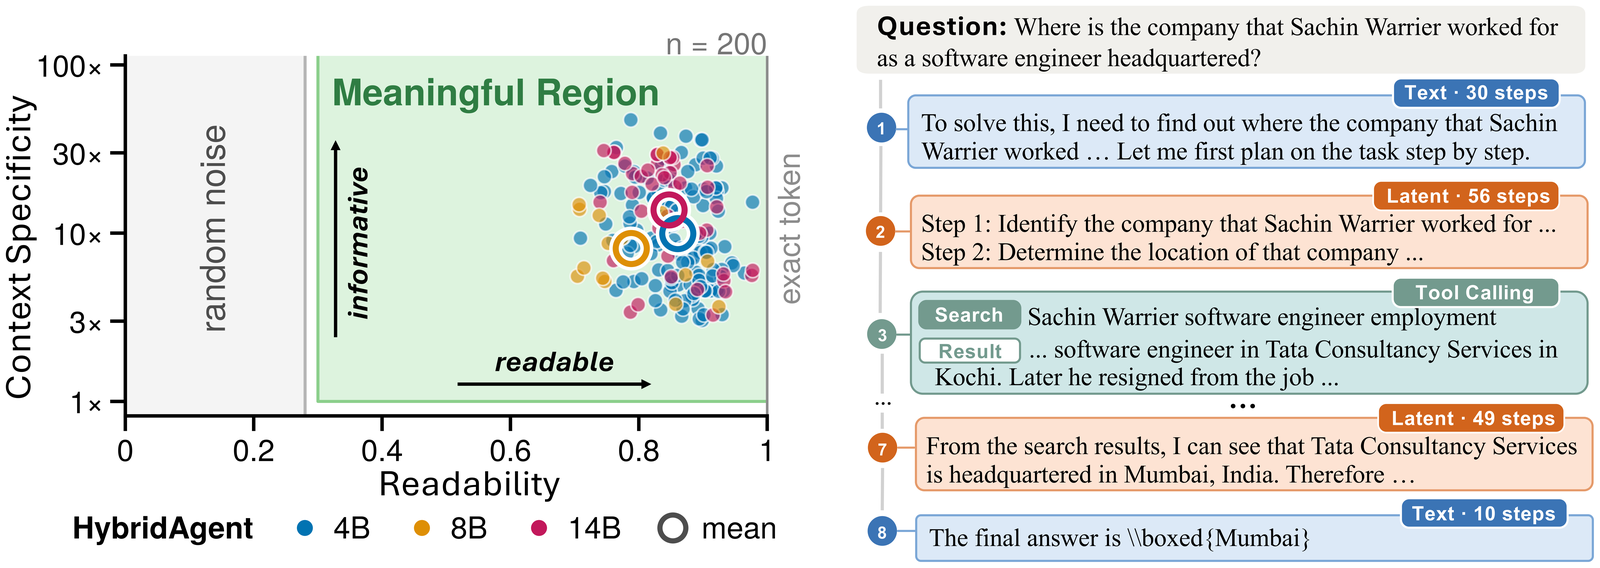 Abbildung: Verteilung der semantischen Untersuchung latenter Vektoren und beispielhafte Trajektorie eines mehrstufigen Werkzeugeinsatzes. Quelle: arXiv 2610.18861
Der Nutzen des selbstkonditionierten Trainings zeigt sich hier deutlich: Auf einem einheitlichen Qwen3-14B-Base-Backbone erreichen bloße Format-Prompts auf AIME25, AIME26 und MATH500 Werte von 20.6, 19.8 und 62.4. Mit HybridLink steigen diese auf 23.8, 22.5 und 73.8; unter Hinzunahme des selbstkonditionierten Trainings klettern sie auf 32.5, 31.7 und 84.2. Parallel dazu nimmt die Lesbarkeit der extrahierten latenten Gedanken zu.
Im latenten Raum entstehen somit keine willkürlichen geometrischen Störungen, sondern zielgerichtete semantische Repräsentationen. Ansätze ohne selbstkonditioniertes Training erzeugen meist unlesbare Fragmente. Die Interpretierbarkeit latenter Zustände hängt folglich von der Trainingsmethodik ab und ist kein inhärentes Defizit der latenten Inferenz.
Validiert an 11 komplexen Benchmarks: Interaktionskosten um das Dreifache gesenkt
Die Evaluierungsumgebung spiegelt praxisnahe, anspruchsvolle Szenarien wider und integriert eine Python-Sandbox sowie die Tavily-Websuche. Pro Trajektorie sind bis zu 10 Werkzeugaufrufe zulässig, wobei pro Abfrage die obersten 10 Auszüge erfasst werden. Als Schiedsrichtermodell und Extraktor fungiert GPT-5.6-Luna.
Die Testsuite umfasst 11 Benchmarks, darunter GAIA, WebWalker, HLE, SealQA und mathematische Wettbewerbe (AIME). Über 5 unabhängige Testläufe hinweg lag die Standardabweichung der Genauigkeit bei stabilen ±0,014 (95 %-Konfidenzintervall ±0,017; aufgeschlüsselt: Mathematik ±0,031, Wissenssuche ±0,018). In den Größen 8B und 14B übertraf das System moderne LLM-Agenten deutlich, wobei das 14B-Modell die beste Baseline um durchschnittlich 17,4 % distanzierte. Bei gleichen Parametern und gleichem Trainingsbudget erzielten HybridSFT und HybridRL Leistungssteigerungen von 18,5 % bzw. 10,4 % gegenüber reinen Text- und Latenz-Baselines.
Mit wachsendem Anteil latenter Inferenzschritte sinkt die Anzahl der abzurechnenden Text-Tokens. Da langlebige Agenten dutzende Werkzeugeinsätze aneinanderreihen, summieren sich die Einsparungen jedes Einzelschritts über den gesamten Ablauf zu einem erheblichen wirtschaftlichen Vorteil.
Hybride Inferenz verschiebt Systemgrenzen: Trainingsaufwand und Infrastrukturwechsel
Die latente Inferenz bleibt ein vieldiskutierter Pfad. Befürworter betonen, dass die autoregressive Texterzeugung an ingenieurtechnische Grenzen stößt. Hochfrequente Multi-Agenten-Systeme und langwierige Planungsabläufe lassen Kontexte in reinen Textarchitekturen rasch explodieren. Interne Logik den Tensor Cores zu überlassen und die Speicherbandbreite zu entlasten, gilt als unerlässlich für den großflächigen Produktiveinsatz.
Zurückhaltende Stimmen verweisen hingegen auf erhebliche Migrationshürden. Heutige kommerzielle Plattformen basieren auf etablierten Text-APIs; Debugging-Werkzeuge und Sicherheitsfilter sind auf Textparsing ausgelegt. HybridAgent setzt maßgeschneidertes Fine-Tuning und eigene Inferenz-Laufzeitumgebungen voraus, weshalb sich die Technologie derzeit nicht ohne Weiteres auf proprietäre Black-Box-Modelle übertragen lässt. Die Kosten für den Umbau der Basisinfrastruktur könnten Teile der Hardware-Einsparungen relativieren.
Untersuchungen zur Skalierung der Testzeit-Rechenleistung (Test-time compute) stützen jedoch die Weiterentwicklung: Bei 100 anspruchsvollen Mathematik- und Wissenschaftsaufgaben und Sampling-Werten von k=4 bis k=64 stieg die pass@k-Kurve der Hybridarchitektur kontinuierlich an und verwertete zusätzliche Rechenleistung effizienter als reine Text-Agenten mit Reinforcement Learning. Kontinuierliche latente Zustände bieten ausreichend Kapazität für tiefgehende Explorationen; mit steigendem Rechenbudget vergrößert sich der Vorsprung weiter.
Der primäre Engpass autonomer Agenten liegt im Medium ihrer internen Gedankengänge. Zwischenschritte zwingend in Textzeichen umzuwandeln, bindet unnötig Speicherbandbreite. Kontinuierliche latente Räume bewältigen interne logische Ableitungen zuverlässig, während nach außen weiterhin präzise Textwerkzeuge angesteuert werden. Bei komplexen Interaktionsketten mit knappen Rechenressourcen bleibt der Verzicht auf überflüssige interne Monologe der wirksamste Hebel zur Steigerung des Gesamtdurchsatzes.
Weiterführende Links:
- arXiv-Publikation: Hybrid Reasoning Agents (2610.18861)
- Gemeinsames Forschungsprojekt der Stanford University und Together AI