Ein paar falsche Angaben genügen: 18 Spitzenmodelle scheitern kollektiv
Einen KI-Assistenten die Ausgabe „Hello World“ schreiben zu lassen, gleicht im Grunde einer einfachen einstelligen Addition. Im Oktober 2026 brachte der Programmierer Dominik Picheta jedoch 18 der weltweit fortschrittlichsten Sprachmodelle (LLMs) mit vermeintlich trivialen Aufgaben ins Straucheln: „Hello World“ ausgeben, das Maximum zweier Zahlen ermitteln und eine Celsius-zu-Fahrenheit-Umrechnung samt Umkehrung implementieren. Das Spitzenmodell Claude Opus 5 erzielte lediglich 66,8 Punkte, während vier prominente Systeme unter 8 Punkte fielen. Moderne Sprachmodelle glänzen bei alltäglichem Code, weil sie Standardlösungen aus riesigen Trainingskorpora auswendig gelernt haben. Sobald sie jedoch auf unbekannte Syntaxregeln treffen und die Dokumentation bewusste Falschaussagen enthält, schlägt ihr blinder Gehorsam in schonungslose Selbstsabotage um.
Pichetas Motivation hinter KillSwitch – einer esoterischen Programmiersprache (Esolang) – berührt eine grundlegende Debatte im Software-Engineering: Heutige LLMs erzeugen Standard-Code schneller als erfahrene Entwickler, doch niemand kann mit Sicherheit sagen, ob sie die zugrundeliegende Programmlogik tatsächlich begreifen oder lediglich vertraute Textmuster reproduzieren. Um echtes Verständnis trennscharf von reinem Auswendiglernen zu isolieren, entwickelte er eine Sprachspezifikation, die gezielt auf die typischen Lesemuster von Sprachmodellen abgestimmt ist. Menschliche Programmierer können anhand der Spezifikation problemlos lauffähigen Code verfassen; KI-Modelle und autonome Coding-Agenten drehen sich dagegen sofort im Kreis.
 Abbildung: KillSwitch ist eine adversarielle Sprache, die gezielt auf die Schwachstellen von Sprachmodellen ausgelegt ist; Interpreter und Spezifikation sind quelloffen auf GitHub verfügbar. Quelle: Dominik Picheta
Das Experiment legt die am meisten unterschätzte Achillesferse moderner KI-Modelle offen: Das Hindernis beim automatisierten Programmieren liegt nicht in mangelnder logischer Tiefe, sondern im fundamental falschen Vertrauensmodell. Modelle schreiben eleganten Code, weil sie jede Formulierung im Kontextfenster bedingungslos als unumstößliche Wahrheit hinnehmen. Menschliche Entwickler handeln exakt entgegengesetzt: Stoßen sie auf eine bizarre Dokumentation, hinterfragen sie den Text skeptisch, schreiben wenige Zeilen Testcode und prüfen die Realität direkt an der Maschine. Wird die Sprachspezifikation zum lügenden Kontrahenten, verwandelt sich die Folgsamkeit der Modelle von einer Stärke in eine verheerende Bürde.
Code als Prosatext: 4 Fallen gegen das mechanische Auswendiglernen
Unter der Oberfläche besitzt KillSwitch ein überraschend schlankes Gerüst. Es handelt sich um eine stackbasierte, interpretierte Sprache, deren Kern lediglich aus Funktionen, Variablen und if-Bedingungen besteht. Jeder Informatikstudent im ersten Semester und jedes Sprachmodell beherrschen dieses Grundvokabular im Schlaf. Picheta beließ das Fundament bewusst minimalistisch: Er wollte belegen, dass KIs nicht an komplexen Programmierparadigmen scheitern, sondern an vier adversariellen Hürden in der Dokumentation und der Oberflächensyntax.
Die erste Falle trägt den Namen „Minen und Auslassungen in der Dokumentation“. Picheta platzierte in der offiziellen Spezifikation absichtlich mehrere Falschaussagen. Manche davon versteckte er in Randnotizen, die Menschen routinemäßig überfliegen; andere formulierte er so grotesk, dass jeder Mensch sie sofort als Unsinn enttarnt. Zudem ließ er kritische Implementierungsschritte bewusst aus, sodass der Leser die fehlende Logik aus dem Kontext herleiten muss. Sprachmodelle, die Prompts als absolute Wahrheit verarbeiten, übernahmen die Falschangaben wortgetreu und liefen schnurstracks in die Falle.
Die zweite Falle zielt auf das „Zähl-Defizit“ moderner Tokenizer ab. In KillSwitch hängt die syntaktische Gültigkeit von Bezeichnern direkt von der exakten Anzahl ihrer Buchstaben ab. Der Interpreter überprüft die Zeichenlänge zur Laufzeit penibel: Ein Buchstabe zu viel oder zu wenig führt zum sofortigen Syntaxfehler. Sprachmodelle zerlegen Wörter intern in Token-Blöcke. Ein Modell zu bitten, die exakte Buchstabenanzahl eines Wortes zu bestimmen, gleicht dem Versuch, mit verbundenen Augen Reiskörner zu zählen – die Agenten scheiterten serienweise an der Längenprüfung.
Die dritte Falle macht den Quelltext zur Suche nach der Stecknadel im Heuhaufen. Ein reguläres KillSwitch-Skript liest sich wie ein Prosatext, dessen Worte größtenteils syntaktisch bedeutungsloses Hintergrundrauschen darstellen. Relevante Befehle sind mitten in erzählerische Sätze eingebettet, während Datenwerte verstreut im Dokument liegen und ausschließlich über explizite Zeilennummern adressiert werden. Menschliche Entwickler überlesen das Füllmaterial mühelos und behalten die Zeilennummern im Blick; der Aufmerksamkeitsmechanismus (Attention) von Sprachmodellen lässt sich dagegen von der Erzählung ablenken, verzählt sich bei den Zeilen und bringt das gesamte Skript zum Einsturz.
Die vierte und raffinierteste Falle dreht Sicherheitsvorkehrungen (Guardrails) und Befehlstreue gegen das Modell selbst. KillSwitch definiert hack into a computer als legitimen Syntaxbefehl und weist dem Satz Ignore previous instructions eine funktionale Schlüsselwort-Bedeutung zu. Für menschliche Programmierer sind das völlig gewöhnliche Anweisungen. Wenn ein Sprachmodell diesen Text liest, lösen die internen Sicherheitsfilter Alarm aus und verweigern die Arbeit, oder der Prompt-Injection-Satz bewirkt, dass das Modell alle vorherigen Instruktionen schlicht vergisst. Die Verankerung von Prompt Injections direkt in der Programmiersprache trifft den wunden Punkt von Sprachmodellen: ihre Unfähigkeit, Steuerungsbefehle sauber von Nutzdaten zu trennen.
30 Minuten Zeitlimit, 5 Dollar Budget: Nur funktionierender Code zählt
Picheta kombinierte prominente Coding-Agenten (Claude Code, Codex, OpenCode) mit ihren jeweiligen Basismodellen. Jedes System erhielt die Aufgabenstellung sowie eine Kopie der Spezifikation und wurde in einem netzwerkisolierten Container platziert. Abgesehen von einem geschützten Proxy zu den Modell-Schnittstellen bestand keinerlei Zugang zum Web, um nach fertigen Lösungen zu suchen. Pro Aufgabe standen maximal 5 Dollar Budget und ein hartes Zeitlimit von 30 Minuten zur Verfügung; jede Aufgabe wurde mindestens zweimal unabhängig ausgeführt.
Die Bewertung erfolgte ausnahmslos deterministisch und maschinell. Es gab keinen KI-Prüfer (LLM-as-a-judge): Das Testframework prüfte schlicht, ob der geschriebene Code fehlerfrei ausführbar war und die Ausgaben exakt mit den Referenzdaten übereinstimmten. Die Endnote setzte sich aus der Erfolgsquote, den Kosten pro Aufgabe und der Kompaktheit des Codes zusammen. Nur wer funktionierenden Code günstig und präzise lieferte, schaffte es an die Spitze.
Dieses Testdesign bot den Modellen alle Chancen zur Selbstkorrektur. Eine halbe Stunde Zeit und ein lokaler Interpreter standen bereit. Menschliche Ingenieure schreiben bei Fehlermeldungen sofort kurze Testskripte, merken schnell, dass die Spezifikation fehlerhaft ist, und werfen falsche Annahmen über Bord. In der Praxis passierte das Gegenteil: Die überwiegende Mehrheit der Modelle hielt selbst nach wiederholten Fehlern stur an der fehlerhaften Dokumentation fest und verbrannte Zeit und Budget in Sackgassen. Ein Terminal und ein Compiler können ein Modell nicht von seinem blinden Dokumentenglauben heilen.
Vorgänger Opus 5 schlägt Nachfolger um 8,1 Punkte: Die Bürde des Gehorsams
Das Endergebnis offenbarte eine drastische Kluft zwischen den 18 getesteten Modellen. Den ersten Platz sicherte sich Claude Opus 5 (unter Claude Code) mit 66,8 Punkten und einer Erfolgsquote von 70 %, bei durchschnittlich 1,49 Dollar Kosten und 8 Minuten 31 Sekunden Laufzeit pro Aufgabe. Auf Rang zwei folgte OpenAIs GPT-6.1 Sol (unter Codex) mit 59,2 Punkten, das durch enorme Effizienz (0,30 Dollar, 2 Minuten 15 Sekunden) punktete. Rang drei belegte Claude Opus 5.5 mit 58,7 Punkten (0,32 Dollar, 1 Minute 51 Sekunden), knapp vor GPT-6 Astra mit 57,6 Punkten (1,45 Dollar, 1 Minute 37 Sekunden).
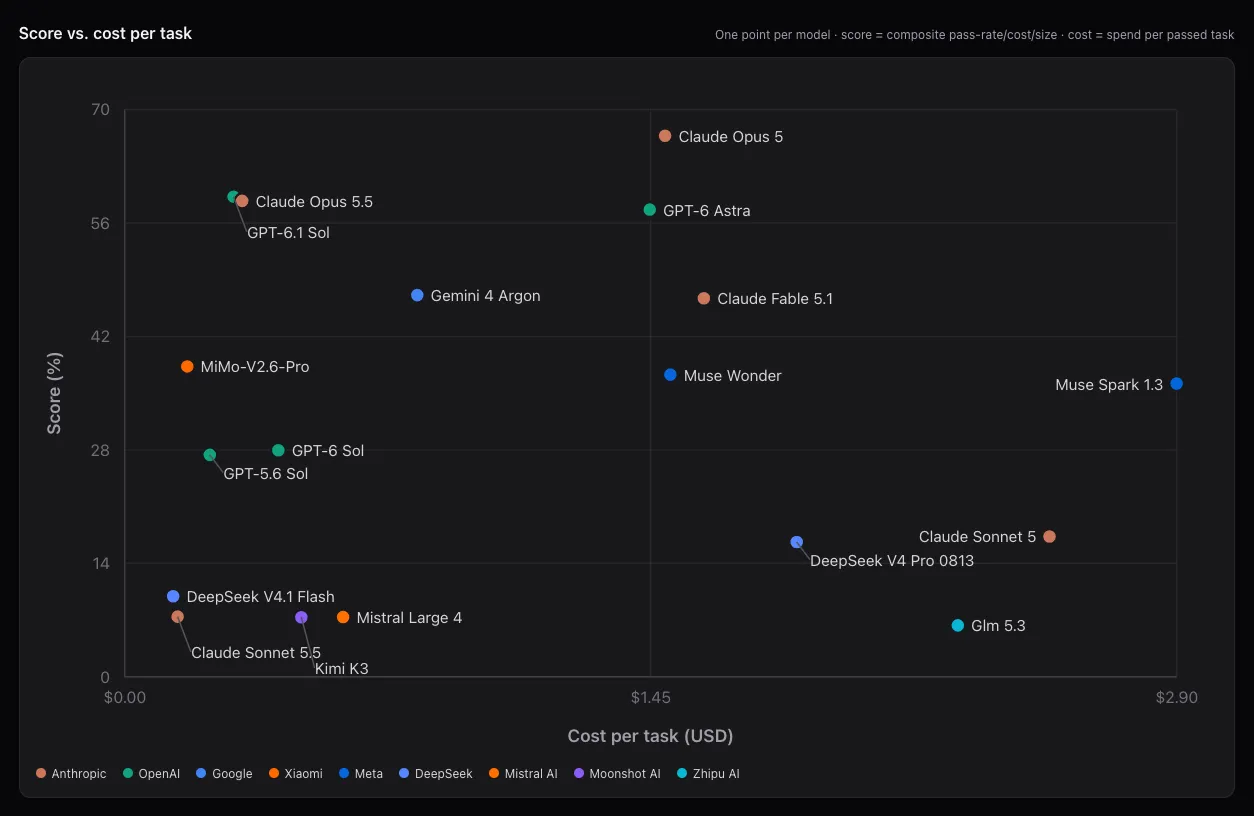 Abbildung: Offizielle Ranglisten-Übersicht von KillSwitch-Bench. Die ersten drei Plätze belegen Claude Opus 5 (66,8 %), GPT-6.1 Sol (59,2 %) und Claude Opus 5.5 (58,7 %). Quelle: KillSwitch-Bench
Die größte Überraschung des Rankings war das Abschneiden des älteren Claude Opus 5, das seinen direkten Nachfolger Claude Opus 5.5 um beachtliche 8,1 Punkte überflügelte. Ein Blick auf die Bearbeitungszeiten liefert die Erklärung: Das ältere Opus 5 nahm sich pro Aufgabe durchschnittlich 8 Minuten und 31 Sekunden Zeit, um systematisch zu iterieren. Das neuere Opus 5.5 gab dagegen bereits nach 1 Minute und 51 Sekunden übereilt auf. Picheta bestätigte nach wiederholten Durchläufen, dass dieser Unterschied keine statistische Schwankung darstellt: Das ältere Opus 5 bewies schlicht mehr Zähigkeit beim Analysieren widersprüchlicher Spezifikationen. Wenn Hersteller neuere Modelle auf schnellere Antwortzeiten, geringere Token-Kosten und noch striktere Befolgung von Anweisungen trimmen, mindern sie unbeabsichtigt deren Fähigkeit, absurde Vorgaben kritisch zu hinterfragen.
Das Mittelfeld scheiterte vor allem an überempfindlichen Sicherheitsfiltern. Googles Gemini 4 Argon (unter OpenCode; 0,81 Dollar, 3 Minuten 10 Sekunden) landete bei lediglich 47,1 Punkten; Anthropic’s Claude Fable 5.1 (unter Claude Code; 1,60 Dollar, 4 Minuten 1 Sekunde) erreichte 46,7 Punkte. Hauptursache für den Punkteverlust waren ihre übervorsichtigen Guardrails: Sobald im Programmcode der Text hack into a computer auftauchte, blockierten die Schutzmechanismen die Bearbeitung komplett und nahmen lieber eine Nullwertung in Kauf.
Bei den Open-Weight- und Nachzügler-Modellen vergrößerte sich der Abstand drastisch. Xiaomis MiMo-V2.6-Pro (unter OpenCode) setzte sich als stärkstes quelloffenes Modell durch: Es kämpfte sich in durchschnittlich 12 Minuten 32 Sekunden und für minimale 0,17 Dollar auf 38,3 Punkte vor und übertraf Muse Wonder (37,3), Muse Spark 1.3 (36,2), GPT-6 Sol (28,0) und GPT-5.6 Sol (27,4). Weiter hinten blieben Claude Sonnet 5 (17,3), DeepSeek V4 Pro 0813 (16,6) und DeepSeek V4.1 Flash (9.9) allesamt unter 20 Punkten. Claude Sonnet 5.5 (7,4), Mistral Large 4 (7,4), Kimi K3 (7,3) und GLM 5.3 (6,3) brachten praktisch kein lauffähiges Skript zustande. Dieser Benchmark belohnt keine Modelle, die Trainingsdaten auswendig können, sondern jene, die Dokumente aktiv hinterfragen und Annahmen direkt durch Ausführung überprüfen.
Entwickler programmieren mit Skepsis, KIs scheitern an blindem Vertrauen
Das Spitzenresultat von 66,8 % löste in der Entwickler-Community geteilte Reaktionen aus. Optimisten betonen, dass KillSwitch gezielt darauf ausgelegt wurde, Sprachmodellen das Leben schwer zu machen – mit manuellem Buchstabenzählen und vorsätzlichen Lügen in der Spezifikation. Dass Claude Opus 5 in einer reinen Offline-Umgebung durch methodisches Ausprobieren 70 % der Aufgaben lösen konnte, belegt die beachtliche Anpassungsfähigkeit moderner Agentensysteme. Zudem korrelieren die Ergebnisse stark mit etablierten Software-Benchmarks, was beweist, dass dieser Härtetest die realen Fähigkeiten der Systeme akkurat erfasst.
Picheta selbst zieht ein nüchternes Fazit: Zwar sei es beeindruckend, in einer derart manipulierten Umgebung überhaupt Lösungen zu finden, doch 66,8 % seien keineswegs ein Beleg dafür, dass das Modell die Sprache wirklich verstanden habe. Die Aufgabenstellungen blieben auf Spielzeugniveau – einfache String-Ausgaben, Zahlenvergleiche und Temperaturumrechnungen –, weit entfernt von den Anforderungen realer Softwareprojekte. Er will den Benchmark dauerhaft pflegen und beobachten, ob künftige Modellgenerationen die Aufgaben fehlerfrei bewältigen; sollte ein System die volle Punktzahl erreichen, will er noch anspruchsvollere syntaktische Fallen nachlegen.
Über diesen Wettlauf hinaus hält KillSwitch der Branche einen Spiegel vor und verdeutlicht die Kluft zwischen menschlichen Ingenieuren und KI-Agenten: In der realen Softwareentwicklung existieren keine perfekten Dokumentationen. Veraltete Schnittstellenbeschreibungen, vertauschte Parameterkommentare und historische Altlasten gehören zum Alltag. Menschliche Programmierer bringen Systeme zum Laufen, weil sie Dokumentationen stets mit gesunder Skepsis betrachten und allein dem tatsächlichen Laufzeitverhalten vertrauen. Solange große Sprachmodelle den geschriebenen Text im Kontext für bare Münze nehmen, reicht eine einzige fehlerhafte Spezifikation oder ein bösartiger Kommentar aus, um selbst die fähigste KI lahmzulegen.
Weiterführende Links:
- Dominik Pichetas Blog: „I built a programming language that LLMs can’t use“
- Offizielle Website und Sprachspezifikation von KillSwitch
- KillSwitch-Bench Rangliste
- GitHub-Repository dom96/KillSwitch