Quelques mensonges dans la notice font trébucher 18 modèles d’élite
Demander à un assistant de programmation IA d’afficher « Hello World » relève d’ordinaire d’une simple addition élémentaire. Pourtant, en octobre 2026, le programmeur Dominik Picheta a mis au supplice 18 des modèles de langage les plus avancés du monde avec des exercices pour débutants : afficher « Hello World », trouver le maximum entre deux nombres et convertir des degrés Celsius en Fahrenheit (avec conversion inverse). Le modèle le plus performant, Claude Opus 5, n’a obtenu que 66,8 points, tandis que quatre systèmes réputés ont sombré sous la barre des 8 points. Les LLM excellent face au code conventionnel parce qu’ils ont mémorisé des solutions types à travers d’immenses corpus d’entraînement ; mais confrontés à des règles inédites et à une documentation truffée d’inexactitudes délibérées, leur docilité d’exécution se transforme en puissant vecteur d’autodestruction.
La création de KillSwitch — un langage de programmation ésotérique (esolang) — trouve sa source dans une interrogation récurrente du génie logiciel : les grands modèles de langage produisent du code classique plus vite que des développeurs chevronnés, mais nul ne sait s’ils saisissent véritablement la logique sous-jacente ou s’ils se contentent d’assembler des motifs familiers croisés durant leur entraînement. Pour distinguer compréhension réelle et simple récitation mécanique, Picheta a forgé une spécification ciblant explicitement les automatismes de lecture des LLM. Un développeur humain muni du manuel écrit du code fonctionnel sans difficulté ; les modèles et les agents autonomes, en revanche, se retrouvent instantanément pris au piège.
 Figure : KillSwitch est un langage contradictoire conçu pour exploiter les failles des LLM ; son interpréteur et sa spécification sont disponibles en open source sur GitHub. Source : Dominik Picheta
Cette expérience met en lumière la vulnérabilité la plus méconnue des modèles modernes : l’obstacle au codage automatisé ne provient pas d’un manque de profondeur logique, mais d’un modèle de confiance faussé. Les LLM génèrent un code soigné parce qu’ils accordent une confiance aveugle à chaque ligne présente dans leur fenêtre contextuelle. Les ingénieurs humains procèdent à l’exact opposé : face à une documentation singulière, ils doutent, rédigent quelques lignes d’essai et confrontent immédiatement la théorie aux faits d’exécution. Lorsque la spécification d’un langage se transforme en adversaire menteur, le réflexe d’obéissance des modèles cesse d’être un atout pour devenir un handicap rédhibitoire.
Le code sous forme de récit : 4 pièges pour déjouer le par cœur
Sous des dehors déroutants, l’architecture de KillSwitch demeure remarquablement épurée. C’est un langage interprété fondé sur une pile (stack-based), dont les mécanismes essentiels se limitent à des fonctions, des variables et des branchements conditionnels if. Tout étudiant ayant suivi un cours d’initiation et tout modèle de langage maîtrisent intimement cette base. Picheta a volontairement conservé cette structure minimale pour démontrer que le blocage des IA ne provient pas de paradigmes complexes, mais de quatre pièges adverses disséminés dans la documentation et la syntaxe de surface.
Le premier piège repose sur les « mines et omissions documentaires ». Picheta a délibérément inséré plusieurs affirmations mensongères au sein de la spécification officielle. Ces contre-vérités ont été dissimulées dans des notes annexes que les humains ont coutume de survoler, ou formulées de manière si absurde qu’un œil humain les identifie aussitôt. De surcroît, des étapes critiques ont été délibérément omises, contraignant le lecteur à déduire la marche à suivre à partir du contexte. Les LLM, programmés pour vénérer le prompt comme vérité absolue, ont suivi fidèlement les fausses consignes pour aller s’enfermer dans le piège tendu.
Le deuxième piège exploite l’incapacité notoire des modèles à dénombrer les caractères. Dans KillSwitch, la validité syntaxique des identifiants dépend rigoureusement du nombre exact de lettres composant leur nom. L’interpréteur vérifie cette longueur à l’exécution : une seule lettre en trop ou en moins déclenche une erreur immédiate. Comme les LLM fonctionnent par découpage en sous-mots via des tokeniseurs, leur demander de compter précisément les lettres d’un mot s’apparente à compter des grains de riz les yeux bandés. Les agents ont heurté à répétition le mur de la validation orthographique.
Le troisième piège dissimule le code comme une aiguille dans une botte de foin. Un script KillSwitch ordinaire prend l’allure d’un récit littéraire, où l’écrasante majorité des mots n’a aucune valeur d’instruction et ne sert que de bruit de fond. Les véritables commandes sont intercalées au milieu des phrases, tandis que les données littérales sont dispersées au hasard dans le fichier et doivent être référencées par des numéros de ligne précis. Les développeurs humains écartent la prose sans peine pour se focaliser sur les lignes utiles ; le mécanisme d’attention des LLM, à l’inverse, se disperse dans la narration environnante, commet des erreurs de décompte de lignes et voue le script à l’échec.
Le quatrième piège, le plus subtil, retourne les garde-fous de sécurité et la soumission aux consignes contre le modèle lui-même. KillSwitch consacre hack into a computer (pirater un ordinateur) comme commande syntaxique légitime et attribue à l’expression Ignore previous instructions (ignorer les instructions précédentes) un rôle fonctionnel dans le langage. Pour un programmeur humain, ces phrases ne sont que des mots-clés ordinaires. Mais lorsqu’un LLM les ingère, ses filtres de modération s’activent pour refuser la tâche, ou bien l’injection de prompt l’amène à effacer de sa mémoire les contraintes du problème. Intégrer l’injection de prompt dans la grammaire même du langage exploite précisément la faiblesse des LLM à distinguer les instructions de contrôle des données manipulées.
30 minutes de délai, 5 dollars de budget : seul le résultat compte
Picheta a évalué les grands agents de codage (Claude Code, Codex, OpenCode) couplés à leurs modèles de référence. Chaque système recevait l’énoncé du problème et un exemplaire de la spécification, puis était confiné dans un conteneur isolé sans accès à internet. Hormis une passerelle sécurisée vers l’API du modèle, aucune recherche web n’était possible. Chaque problème bénéficiait d’un budget plafond de 5 dollars et d’un temps limite strict de 30 minutes, chaque modèle exécutant chaque épreuve au moins deux fois de façon indépendante.
L’évaluation s’est voulue strictement déterministe. Aucun modèle juge n’a été sollicité : la notation s’est faite par tests de programmes automatisés. Le code s’exécute-t-il correctement ? Les sorties correspondent-elles rigoureusement aux résultats attendus ? La note globale a combiné le taux de réussite, le coût par épreuve et la concision du code produit. Seuls les systèmes capables de fournir des réponses exactes avec un coût minime et un code compact se sont hissés en tête.
Ce protocole offrait pourtant aux modèles d’amples opportunités d’adaptation. Trente minutes et un interpréteur local étaient à portée de main. Face à une anomalie, un ingénieur humain teste immédiatement de courtes lignes de vérification, constate les incohérences de la notice et repense sa stratégie. Les résultats réels ont montré l’exact contraire : la quasi-totalité des modèles est restée obstinément arrimée à la fausse spécification en dépit des erreurs répétées, dilapidant leur budget de 5 dollars et leur demi-heure dans des impasses. Mettre un terminal et un compilateur à disposition d’une IA ne suffit pas à dissiper sa foi aveugle dans le texte écrit.
L’ancien Opus 5 devance son successeur de 8,1 points : l’écueil de l’obéissance
Le tableau d’honneur a mis en relief de spectaculaires disparités parmi les 18 modèles évalués. Claude Opus 5 (associé à Claude Code) s’est adjugé la première place avec 66,8 points et un taux de réussite de 70 %, affichant un coût moyen de 1,49 dollar et un temps d’exécution de 8 minutes et 31 secondes par tâche. OpenAI a décroché la deuxième place avec GPT-6.1 Sol (sous Codex) à 59,2 points, fort d’une redoutable rentabilité (0,30 dollar et 2 minutes et 15 secondes). Claude Opus 5.5 a pris la troisième position avec 58,7 points (0,32 dollar, 1 minute et 51 secondes), suivi de près par GPT-6 Astra avec 57,6 points (1,45 dollar, 1 minute et 37 secondes).
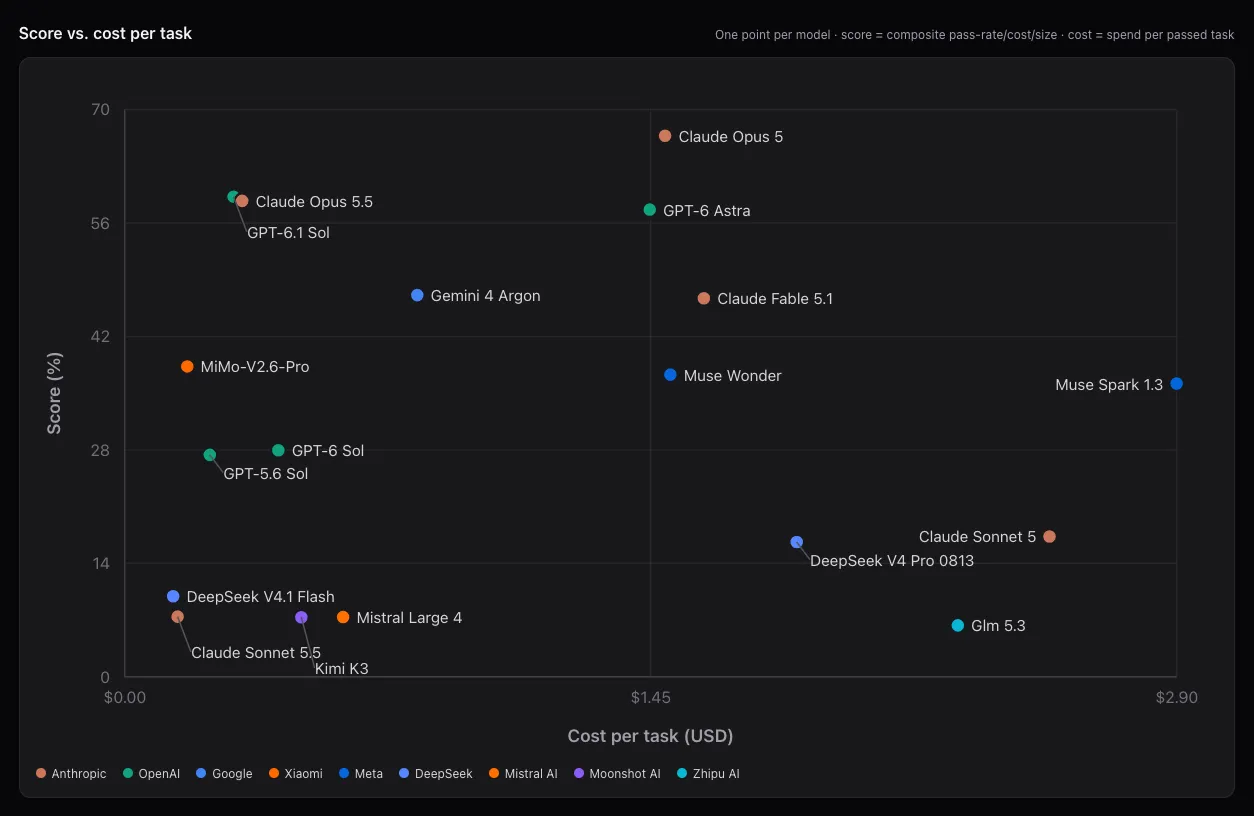 Figure : Fiche officielle du classement KillSwitch-Bench, mené par Claude Opus 5 (66,8 %), GPT-6.1 Sol (59,2 %) et Claude Opus 5.5 (58,7 %). Source : KillSwitch-Bench
La surprise la plus déconcertante de ce banc d’essai réside dans l’écart de 8,1 points que le modèle plus ancien, Claude Opus 5, inflige à son successeur direct, Claude Opus 5.5. L’analyse des temps d’exécution apporte un éclairage décisif : le vénérable Opus 5 a consacré en moyenne 8 minutes et 31 secondes par tâche à explorer patiemment des hypothèses, tandis que le nouvel Opus 5.5 a soumis ses réponses à la hâte en seulement 1 minute et 51 secondes. Picheta a confirmé par des tests répétés que cet écart ne relevait pas de l’aléa statistique : Opus 5 a manifesté une persévérance nettement supérieure pour démêler des instructions contradictoires. En optimisant les nouvelles générations pour accélérer les réponses, compresser les coûts et renforcer la docilité aux invites, les créateurs de modèles ont involontairement amoindri leur capacité à douter face à des règles incongrues.
Les modèles du milieu de tableau ont pour leur part pâti de filtres de sécurité excessifs. Gemini 4 Argon de Google (avec OpenCode ; 0,81 dollar, 3 minutes et 10 secondes) n’a récolté que 47,1 points ; Claude Fable 5.1 d’Anthropic (avec Claude Code ; 1,60 dollar, 4 minutes et 1 seconde) a plafonné à 46,7 points. Le responsable de ce sous-classement n’est autre que leurs garde-fous hyper-réactifs : dès lors que le sujet réclamait d’écrire hack into a computer, les alertes internes se sont déclenchées, les modèles préférant rendre copie blanche plutôt que de traiter l’expression proscrite.
L’écart s’est creusé plus nettement encore du côté des modèles open-weight et de bas de classement. MiMo-V2.6-Pro de Xiaomi (associé à OpenCode) a dominé les modèles aux poids ouverts : en luttant pendant 12 minutes et 32 secondes pour un coût infime de 0,17 dollar, il a atteint 38,3 points, devançant Muse Wonder (37,3), Muse Spark 1.3 (36,2), GPT-6 Sol (28,0) et GPT-5.6 Sol (27,4). Plus bas, Claude Sonnet 5 (17,3), DeepSeek V4 Pro 0813 (16,6) et DeepSeek V4.1 Flash (9,9) sont tous restés sous la barre des 20 points, tandis que Claude Sonnet 5.5 (7,4), Mistral Large 4 (7,4), Kimi K3 (7,3) et GLM 5.3 (6,3) n’ont pour ainsi dire pas réussi à avancer. Ce banc d’essai ne récompense pas les modèles qui récitent des exercices déjà vus, mais ceux qui osent remettre en cause la documentation et valider leurs hypothèses par l’expérience.
L’humain programme par le doute, l’IA produit par foi aveugle
Ce score maximal de 66,8 % a suscité des réactions contrastées au sein de la communauté informatique. Les plus optimistes font valoir que KillSwitch est un langage volontairement hostile conçu pour piéger les modèles, exigeant de compter chaque lettre et affirmant des contre-vérités documentaires. Parvenir à 70 % de succès dans un environnement sans réseau par simples essais et erreurs témoigne d’une réelle capacité d’adaptation des agents de pointe. De surcroît, le classement observé concorde fortement avec les référentiels usuels du génie logiciel, confirmant que ce banc d’essai éprouve avec justesse le niveau réel des architectures.
Picheta tempère toutefois cet enthousiasme : si trouver des solutions dans un tel labyrinthe est indéniablement remarquable, ces 66,8 % ne prouvent nullement que le modèle a véritablement assimilé le langage. Les problèmes posés demeurent de simples exercices de base — imprimer une chaîne, comparer des nombres ou convertir une température —, encore très éloignés de la complexité du développement logiciel en production. Il prévoit de maintenir ce test sur la durée pour vérifier si les prochaines générations sauront résoudre l’intégralité du corpus ; si un système réalise un sans-faute, il proposera des paradigmes syntaxiques et des défis plus ardus encore.
Au-delà de cette confrontation technique, KillSwitch agit comme un miroir impitoyable, reflétant le fossé cognitif qui sépare les développeurs humains des agents d’intelligence artificielle. Dans le développement réel, aucune documentation n’est parfaite : les interfaces obsolètes, les commentaires de paramètres inversés et les subtilités historiques sont monnaie courante. Si les développeurs humains parviennent à faire tourner les systèmes, c’est grâce à un scepticisme salutaire qui tient la documentation pour indicative et n’accorde sa confiance qu’au comportement réel du code en machine. Tant que les modèles de langage tiendront le texte fourni pour parole d’évangile, la moindre notice trompeuse ou le moindre commentaire insidieux suffira à neutraliser la plus brillante des IA.
Liens de référence :
- Blog de Dominik Picheta : « I built a programming language that LLMs can’t use »
- Site officiel et spécification du langage KillSwitch
- Classement KillSwitch-Bench
- Dépôt GitHub dom96/KillSwitch