2026 年 10 月 13 日,斯坦福大学等团队发布了新型推理架构 HybridAgent,论文编号 arXiv:2610.18861。11 个跨领域基准里,8B 与 14B 档位压过了先进 LLM 智能体与专用工具框架,14B 相对最强基线平均高出 17.4%。同一套系统把文本 token 用量降到纯文本基线的 1/2.7,token 消耗整体下降 35.5% 至 54.7%。
主流自主智能体在执行复杂工具任务时,必须把每一步思考都写成离散文本。成百上千个中间单词塞满显存,直接推高了服务延迟。将推演过程留在连续潜空间内,交互瞬间才解码文本,换来了两倍以上的生成加速。省下的计算资源直接改善了长程交互的吞吐表现。
内部思考折叠进连续潜空间:文本 token 降到基线的三分之一
传统 ReAct 框架依靠密集的自言自语推动任务。智能体在搜索网页或执行代码前,先吐出几百个 token 阐述计划。这些中间词汇对外部环境没有交互价值,却必须逐一走完词表 Softmax 投影。自回归解码把宝贵的显存带宽消耗在内部自省上。
HybridAgent 重新划定了思考与表达的边界。模型在单次生成中支持双模式平滑切换。潜空间模式负责递归式内部推演,文本模式负责对外行动。研发团队引入 <latent> 与 </latent> 作为模式切换锚点。在潜空间内,网络通过一次前向传播推进一个潜向量状态,跨度通常设置在 16 到 256 步之间。
论文给出的效率数字覆盖三层开销。混合模式下的文本 token 用量降到纯文本基线的 1/2.7,总生成步数最多减少 54%,端到端推理速度是基线的 2.1 倍。潜状态跳过了词表投影与再嵌入的两次矩阵运算,显存带宽的压力随之下降。
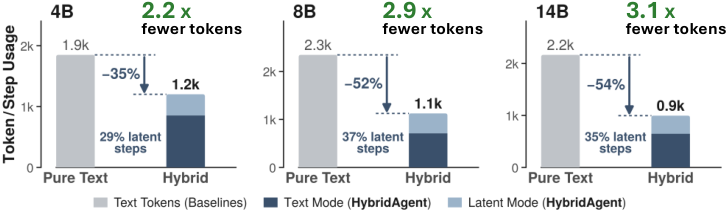 图:在 4B、8B 与 14B 模型上,HybridAgent 的文本 token 用量与总生成步数相对纯文本基线的变化。来源:arXiv 2610.18861
速度之外还有账单。研究者按每 H100 小时 2.50 美元、BF16 峰值算力 10% 利用率估算,回答一百万道题的成本从 4B 档的 359 美元降到 98 美元,8B 档从 439 美元降到 121 美元,14B 档从 470 美元降到 176 美元,对应 3.7 倍、3.6 倍与 2.7 倍。这套估算把潜步占用的骨干网络算力一并计了进去,不是只算省下来的 token。
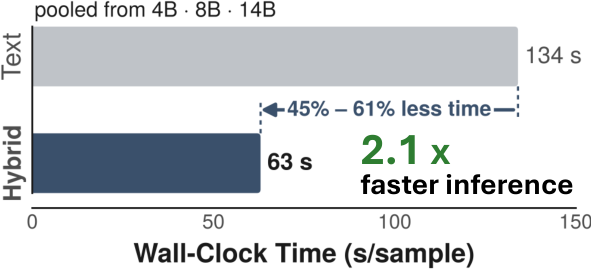 图:HybridAgent 在三个模型尺度上的推理耗时加速倍数。来源:arXiv 2610.18861
残差映射串起两套上下文:KV 缓存免去重复重编码
让连续向量与离散字符在同一个神经网络中流转,需要解决表示维度的衔接问题。团队设计了名为 HybridLink 的残差适配层。该模块将模型最后一层的隐藏状态直接映射回输入嵌入空间。潜状态无需经过文本逆编码,便能直接作为下一步计算的输入向量。
这种设计保证了跨轮次工作记忆的连贯。提示词、潜思考向量与工具观测结果,统一存入单份连续键值缓存。智能体完成工具调用后,系统无需清空上下文重编码。后续推演在现有显存缓存上直接计算,免去了重复前向传播开销。
训练这套混合系统需要专门的两阶段流水线。第一阶段 HybridSFT 采用自条件双遍训练机制。第一遍依靠教师强制生成目标潜输入,第二遍将真实嵌入替换为模型自身预测值。文本位置计算交叉熵损失,潜状态位置计算回归损失,共同更新骨干网络与 HybridLink。第二阶段 HybridRL 在此基础上实施强化学习,强化动作决策的精准度。
该方案依托 verl 与 vLLM 基础库进行了深度扩展。训练任务部署在 32 张 NVIDIA H100 GPU 上完成。中间推演被锁在张量核心内部,显存控制器得以从繁重的词表读写中解脱。模型把有限的显存带宽留给了真正的外部交互。
潜向量可被探查还原:内部隐状态维持语义清晰
工程界对潜空间推理最集中的质疑是黑箱化:如果思考步骤只是一串浮点向量,调试与安全审查就失去了检查依据。论文给出的还原路径不需要额外的解码器。每个潜步经 HybridLink 映射得到的向量,与词表里的 token 嵌入逐一比对余弦相似度,取最近的那个即可拼出伪文本。公式 5 把这个映射写成对词表的 argmax,潜空间出口锚点 </latent> 也用同一套判据判定。
可读性用潜步向量与最近 token 嵌入的平均余弦相似度来量。取值为 1 意味着每个潜步都指向某个精确 token;研究者用 2000 个高斯随机向量的平均相似度标出噪声门限,再对 200 道下游题目逐题探查。上下文特异性比较的是伪文本与源问题的词汇重合度和它与同任务其他题目的比值,超过 1 倍才说明这个潜思考指向本题。落在门限之上、特异性大于 1 的那片区域,才是能拿出来审查的潜思考。
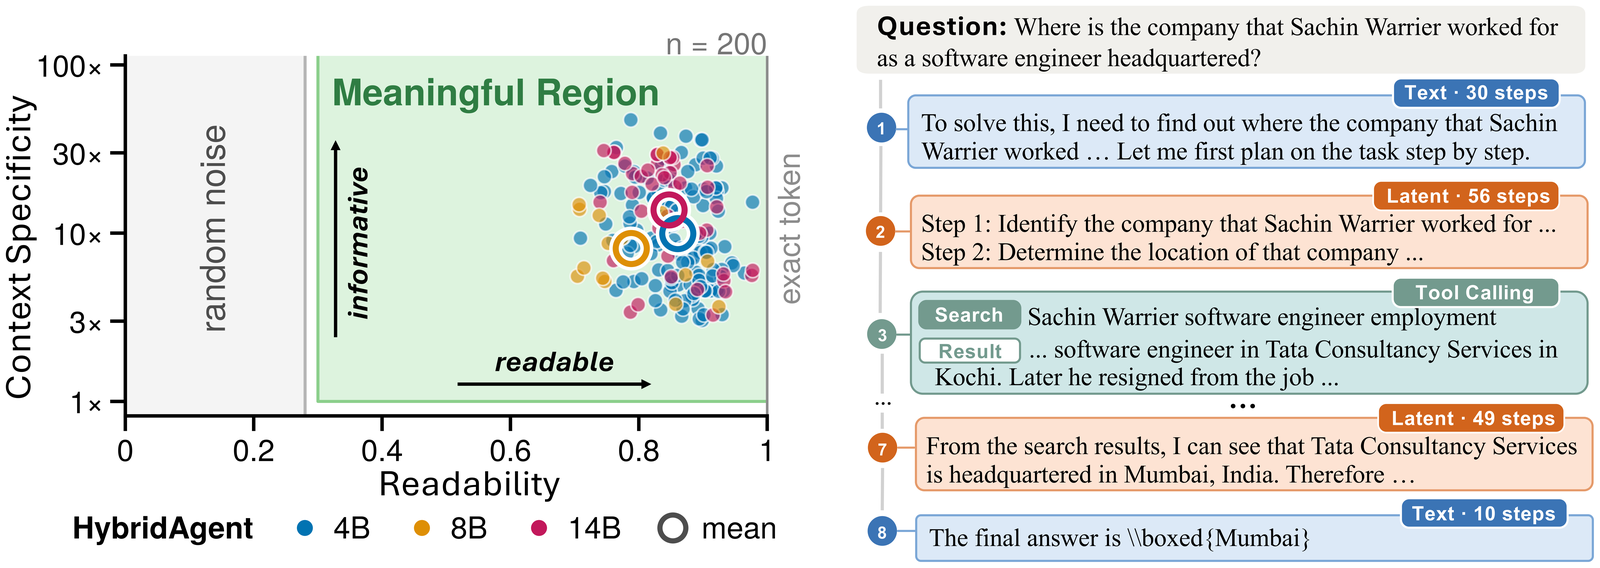 图:潜空间向量语义探查分布与多步工具调用样例轨迹。来源:arXiv 2610.18861
自条件训练的作用在这里最直观。共用同一个 Qwen3-14B-Base 骨干,只加格式激活时 AIME25、AIME26、MATH500 三项是 20.6、19.8、62.4;换成 HybridLink 激活升到 23.8、22.5、73.8;再补上自条件训练,三项来到 32.5、31.7、84.2。潜读出的可读性随训练阶段同步抬升。
潜思考里保留的是词表嵌入空间中有方向的东西,不是随机几何噪声。没做自条件训练的方法,产出基本是嵌入空间里读不出内容的碎片。潜状态能不能被读懂取决于训练方式,而不取决于潜空间这条路线本身。
覆盖 11 项复杂基准:多轮交互成本压缩 3 倍
评估环境覆盖了复杂的真实交互场景。系统接入了 Python 沙箱与 Tavily 网页搜索工具。每条探索轨迹允许最多 10 次工具调用,每次检索获取前 10 条网页摘要。评测采用 GPT-5.6-Luna 担任裁判模型与摘要提取器。
基准测试囊括 GAIA、WebWalker、HLE、SealQA 以及 AIME 数学题等 11 个任务。跨 5 次独立运行,准确率的标准差为 ±0.014,95% 置信区间为 ±0.017;细分到任务类别,数学为 ±0.031,知识检索为 ±0.018。在 8B 与 14B 档位上,系统超越先进 LLM 智能体与专用工具框架,14B 相对最强基线平均高 17.4%;同参数量、同训练预算下,HybridSFT 与 HybridRL 相对文本与潜空间基线分别高出 18.5% 和 10.4%。
计费 token 的数量随潜空间占比上升而下降。长程任务动辄触发几十次工具调用,每一步省下的开销在整条轨迹上累加,才是这套架构在成本表上真正的落点。
混合推理重塑工程边界:训练迁移成为分水岭
潜空间推理这条路线自带分歧。支持者认为文本自回归已经触及工程天花板。多智能体高频协同与几十步的长程探索,会让纯文本方案的上下文迅速膨胀。把内部逻辑运算交给张量核心,让带宽占用率大幅下降,这是规模化落地的必要途径。
持保守态度的工程师则指出了落地环境的迁移成本。目前主流商业应用普遍依托成熟的离散文本 API,调试工具与风控规则均建立在文本解析之上。HybridAgent 依赖定制微调与专用推理运行时,现阶段无法直接外挂到闭源商业模型上。重构底层基础设施的高昂支出,抵消了部分推理端节省的算力。
测试时扩展的表现让这场讨论更复杂。在 100 道高难度数学与科学题目上,k 从 4 扩到 64 的采样区间里,混合架构的 pass@k 曲线持续上行,而且比只做强化学习的纯文本智能体更吃测试时算力。连续隐状态能承载高阶推理的探索需求,采样规模越大,两种路线的差距越明显。
智能体的效能瓶颈压在推演信息的编码介质上。中间结论强行解码为文本字符,白白消耗了显存带宽。连续潜空间足以承载内部逻辑推演,对外依然保留文本工具接口。长程任务面临算力吃紧时,精简掉中间无用的自言自语,才是提升吞吐的核心出路。
参考链接:
- arXiv 论文:Hybrid Reasoning Agents(2610.18861)
- 斯坦福大学与 Together AI 联合研究项目