2026年10月7日,一篇名为《为什么业界没有为 DeepSeek 4.1 Flash 惊慌?》的博客文章在开发者社区流传。作者 jonotime 给出了一个超出常规认知的数据:他高强度使用这款国产大模型长达一个月,横跨十几个复杂的开发项目,最后的账单金额不到一美元。在动辄几十美元订阅费的行业里,一美元的开销显得十分扎眼。算力单价降到这个位置,改变的不再只是每个月底的账单,而是给机器分配任务的固有习惯。
连整理桌面文件也舍得让人工智能代劳
作者在文章中坦白了自己的真实体验。在长达一个月的密集工作里,如果在连续对话中途不去看屏幕右上角的名称,他诚实地分不清自己究竟是在用价格高昂的 Opus 还是便宜的 DeepSeek 4.1 Flash。日常对话的顺畅度、完成具体指令的质量以及响应速度,两者都没有显现出肉眼可见的差距。这份体验报告打破了技术圈一直以来的默认假设:不付最高价买最前沿的产品,就无法获得好的工作成果。
价目表揭示了成本暴跌的秘密。在非高峰时段,DeepSeek 接收一百万个词汇输入的定价是 0.15 美元,输出是 0.60 美元。拉开差距的是缓存命中的价格,这一项降到了 0.003 美元。一百万个词汇相当于两部小说,处理庞大文字量的成本买不到一颗糖果。这种定价让以往显得不可思议的使用方式变成了现实。
以前大家不敢让系统干不需要动脑的杂活,因为每句指令都在消耗算力。现在这位作者连重新整理电脑桌面文件这种琐事,也会毫无心理负担地交出去。花 0.003 美元去省下自己五分钟的手工操作,在经济学上第一次成立了。一整天在后台挂着一个自动化工具让它反复试错,不再是一件需要精打细算的事情。
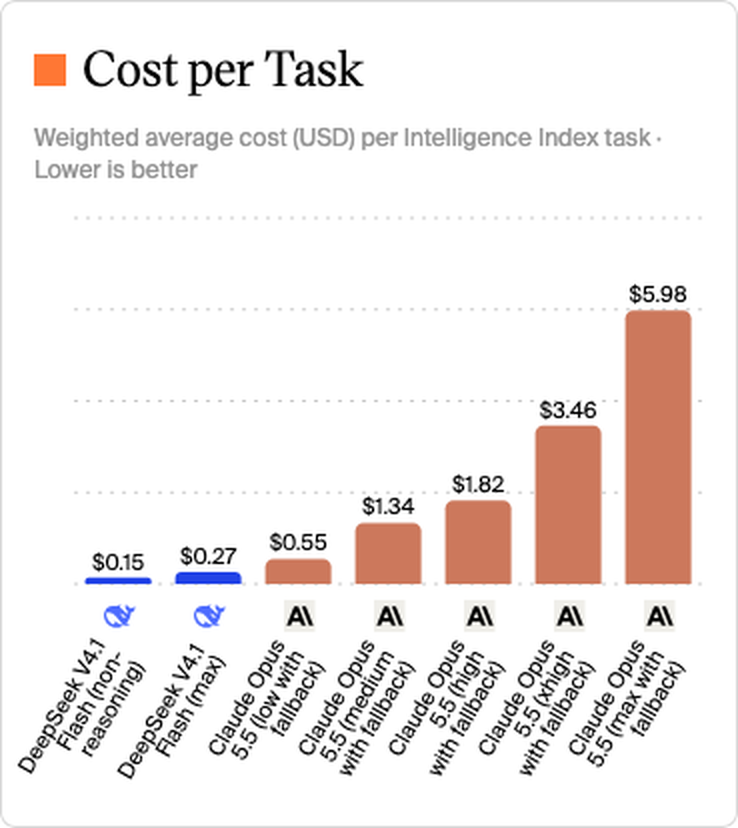 图:同一类任务在不同模型下的成本测算对比。来源:dgt.is 博客配图
把重复计算体积压缩了四百三十七倍
价格能断崖式下跌,核心在于开发团队在架构体系上消除了重复的无用功。开发团队把一种用于存储上下文记忆的缓存空间,相对自家的第一代产品压缩了约 437 倍。这四百多倍的差距,正是决定人工智能能不能廉价普及的核心技术杠杆。
可以把人工智能比作一个记忆力很差但阅读很快的助理。过去每次顺着上一句提问,助理必须把发过的资料重看一遍,才能理解当下的指令。这种反复发生的重读动作,大量消耗着显卡里昂贵的内存资源,正是长篇会话最大的成本黑洞。
解决这个问题的方法,是让助理学会做精简笔记。系统把读过的内容压缩成微小的记忆碎片,长久保留在显卡内存中。只要发现在接下来的对话里引用的是相同的前置条件,它就直接调取那份压缩后的笔记,跳过耗电又占资源的重读过程。工程上的优化在这个环节直接转化成了财务上的断崖式降价。
 图:DeepSeek 三档价格的量级落差,缓存命中价格在图表中低得几乎看不见。来源:Mercatus AI 定价分析
自己买机器搭建已经算不过来这笔经济账
云端服务的单价降到几分之一美分时,行业的硬件部署形态跟着发生了动摇。过去几年,很多中小企业和开发者热衷于购买显卡、搭建本地服务器,核心诉求就是避开云端按调用次数计费的高昂账单。大家指望靠机器的长期运转来摊平前期投入。
在新一轮的经济模型面前,为了省钱去自行部署硬件,变成了一笔永远收不回成本的坏账。按照 0.003 美元的单价计算,企业可能需要满负荷运转机器好几年,省下来的钱才能抵消单张高端显卡的首付款。昂贵硬件折旧落伍的速度,远远快于云端算力降价的速度。
支撑本地部署的最后理由只剩下数据隐私保护。就连这个理由也快站不住脚了。把内存占用压缩数百倍的优化技术,正在迅速下放到开源社区。要不了多久,一台普通的家用电脑就能流畅运行过去需要专业服务器才能负担的复杂系统。
零点零零三美元单价只在特定任务里兑现
单价便宜并不等于完成所有任务都便宜,很多人在这里踩进了逻辑陷阱。在开发者社区讨论中,一位主导新型编程语言项目的工程师分享了实测结果。他最初把 DeepSeek 4.1 Flash 放在统筹指挥的位置上,让它负责规划和拆解任务。
结果是质量滑坡。做复杂决策时,便宜的系统常常忽略关键的上下文关联,在没有任何前置讨论的情况下凭空产生不合理的架构设计。生成的文档也显得冗长且抓不住重点。这位工程师最终把统筹交还给了更贵的系统,只让便宜的方案去执行规格清晰、边界明确的代码实现。它能把搬砖的工作干好,但胜任不了图纸设计。
另一份名为 Pac-Man 的评测揭露了更冰冷的现实。完成同一个复杂项目时,昂贵的前沿系统用了 9.3 分钟,花费 1.99 美元,成绩高达九十九。而便宜的系统用了 2.8 分钟,花费了 1.89 美元,最后只拿到七十二的评价。两边的总花销仅差了 10 美分,完成度却差了一大截。零点零零三美元的单价优势在任务改变时直接失效了。
这引出了讨论里的另一条支线。有人算了一笔账:在不同的数据精度下,运行大型系统需要的内存容量从 416 GB 到 1664 GB 不等。而存储芯片行业历史上曾多次因为价格垄断受到罚款。硬件内存的高昂定价依然是横亘在算力普及面前的大山。把成本压下来这件事,对手从来不只是算法厂商。
算力降价倒逼了应用场景的重心下沉
把所有碎片拼凑在一起,一幅算力成本的真实图景才算完整。超低的标价仅仅在高度依赖缓存命中的特定场景下才成立。一旦任务形态发生改变,需要系统进行大量的创新性推演,便宜的优势就会瞬间被低下的通过率和反复重试的耗时吃掉。
行业里因此出现了一些现象。有企业宁愿购买一大堆不同厂商的顶级套餐,通过复杂的负载均衡来分配任务,也不愿意调整原有的工程架构。当订不到高优先级额度时,就在社交媒体上抱怨算力不够用。这反映了人们对于如何正确使用廉价算力的认知错位。
DeepSeek 4.1 Flash 的意义不在于它能替代最顶尖的系统去完成最高难度的科研。它通过把长记忆体积压缩数百倍,开拓出了一个全新的应用区间。「不值得让人工智能去干的低价值杂活」这件事,在财务维度上已经被消除了。单价便宜不等于单任务便宜,当你指望它去做不擅长的复杂架构规划时,反复试错带来的账单依然高昂。下一次面对几分钱的报价,我们需要关心的不再是它有多便宜,而是我们要喂给它什么样的任务。
参考链接:
- 为什么业界没有为 DeepSeek 4.1 Flash 惊慌?
- Hacker News 讨论:关于新型编译器项目的实测
- Mercatus AI 定价分析报告