El 7 de octubre de 2026, un artículo de blog titulado «Why Industry Is Not Panicking Over DeepSeek 4.1 Flash» comenzó a circular ampliamente en la comunidad de desarrolladores. Su autor, jonotime, aportó un dato que desafiaba toda lógica convencional: tras un mes de uso intensivo del modelo a lo largo de más de una docena de proyectos de desarrollo complejos, la factura final no llegó a un solo dólar estadounidense. En un sector acostumbrado a suscripciones que oscilan con holgura en decenas de dólares mensuales por usuario, un gasto inferior a un dólar resulta demoledor. Cuando el coste unitario de la computación cae a estos niveles, no solo se reduce el recibo de final de mes, sino que cambia por completo el hábito histórico de cómo repartimos tareas a las máquinas.
Hasta ordenar los archivos del escritorio sale a cuenta con IA
En el artículo, el autor comparte con sinceridad su experiencia real. Durante un mes de trabajo frenético, si no miraba el nombre del modelo en la esquina superior derecha de la pantalla en medio de una conversación, admitía no ser capaz de distinguir si estaba utilizando el carísimo Claude Opus o el baratísimo DeepSeek 4.1 Flash. En fluidez conversacional, precisión al acatar instrucciones complejas y velocidad de respuesta, el uso diario no evidenció ninguna distancia perceptible. Este testimonio derriba una creencia arraigada en el sector tecnológico: la premisa de que es imprescindible pagar las tarifas más altas por los modelos frontera más avanzados para obtener resultados profesionales de primer nivel.
La tabla de tarifas revela el misterio de semejante desplome de costes. En horas valle, DeepSeek factura 0,15 dólares por cada millón de tokens de entrada y 0,60 dólares por millón de tokens de salida. Sin embargo, la auténtica brecha la marca el precio por acierto de caché (cache hit), que se hunde hasta los 0,003 dólares por millón de tokens. Un millón de tokens equivale aproximadamente a dos novelas enteras; el coste de procesar semejante volumen de texto es inferior al precio de un caramelo. Esta estructura tarifaria convierte en hábito cotidiano patrones de uso que antes parecían una absoluta quimera.
Antes, los desarrolladores evitaban encargar tareas mecánicas y triviales a la IA porque cada consulta consumía presupuesto de computación. Ahora, el autor delega sin el menor remordimiento tareas tan intrascendentes como reordenar y clasificar los archivos del escritorio de su ordenador. Gastar 0,003 dólares para ahorrarse cinco minutos de trabajo manual tiene, por primera vez, sentido económico. Dejar una herramienta de automatización funcionando todo el día en segundo plano para que pruebe y corrija errores de forma iterativa ha dejado de ser un lujo que requiera cálculos presupuestarios minuciosos.
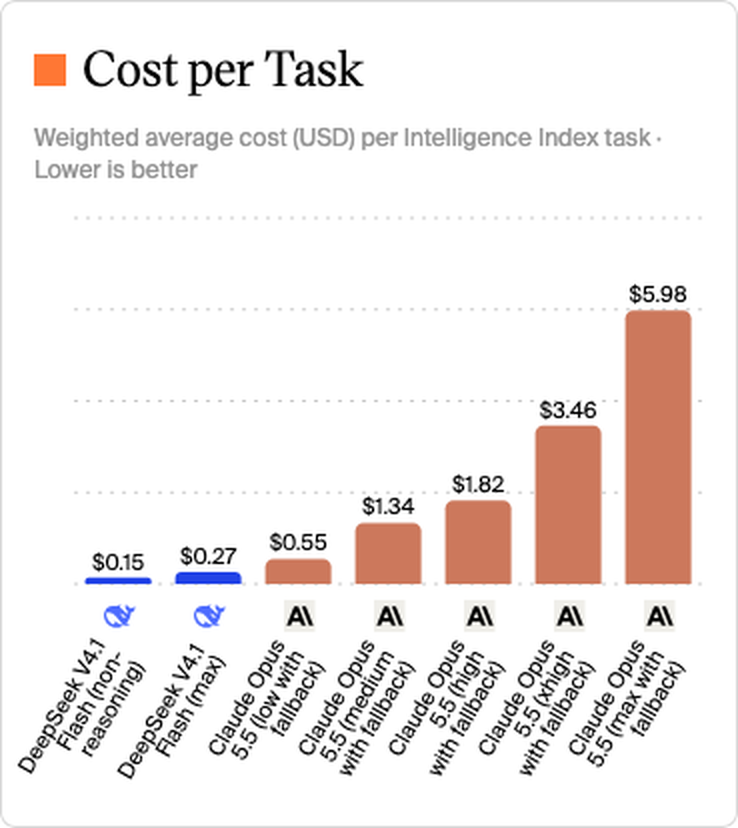 Figura: Estimación comparativa de costes para tareas idénticas entre diferentes modelos. Fuente: Blog de dgt.is
Reducir la memoria de cálculo redundante en 437 veces
Si los precios han podido caer en picado, es porque el equipo de ingeniería eliminó de raíz el trabajo computacional redundante en su arquitectura. Los desarrolladores consiguieron comprimir el espacio de caché utilizado para almacenar la memoria de contexto (el tamaño del KV cache) unas 437 veces en comparación con su arquitectura de primera generación. Esta reducción superior a cuatrocientas veces representa la palanca tecnológica determinante para que la inteligencia artificial pueda popularizarse como una infraestructura asequible.
Podemos imaginar un modelo de lenguaje como un asistente con una velocidad de lectura asombrosa pero una memoria pésima. Hasta ahora, cada vez que el usuario formulaba una nueva pregunta encadenada, el asistente se veía obligado a releer todo el historial previo de la conversación desde el principio para entender la nueva instrucción. Este proceso repetitivo de relectura consumía cantidades masivas de la costosa memoria de vídeo (VRAM) de las GPU, constituyendo el mayor pozo sin fondo de costes en diálogos largos.
La solución consistió en enseñar al asistente a tomar apuntes hipercompactos. El sistema comprime el contenido ya procesado en fragmentos diminutos de memoria y los conserva a largo plazo en la memoria de la GPU. En cuanto detecta que las interacciones posteriores comparten las mismas premisas, recupera directamente esos apuntes comprimidos, omitiendo por completo la costosa relectura que devora energía y recursos. Esta optimización de ingeniería se tradujo directamente en una rebaja radical de las tarifas de la API.
 Figura: Disparidad de órdenes de magnitud en las tarifas de DeepSeek; el precio por acierto de caché es casi invisible en el gráfico. Fuente: Análisis de precios de Mercatus AI
Comprar hardware propio deja de tener sentido financiero
Cuando el coste de los servicios en la nube baja a fracciones de centavo, la viabilidad económica del hardware local salta por los aires. En los últimos años, multitud de pequeñas y medianas empresas y desarrolladores apostaron por comprar tarjetas gráficas y montar servidores locales, con el objetivo primordial de eludir las abultadas facturas de pago por uso de la nube. La expectativa era amortizar la inversión inicial a base de un funcionamiento intensivo a largo plazo.
Frente al nuevo modelo económico, montar infraestructura propia para ahorrar dinero se ha convertido en una vía muerta financiera que jamás recupera la inversión. A un precio de 0,003 dólares por millón de tokens, una empresa tendría que exprimir sus servidores al cien por cien durante años seguidos solo para que el ahorro compense el desembolso inicial de una única GPU profesional de gama alta. La depreciación y obsolescencia del hardware avanzan a un ritmo mucho más rápido que la caída de los precios de la computación en la nube.
El último bastión que justificaba el despliegue local era la privacidad de los datos, e incluso ese argumento empieza a tambalearse. Las técnicas de compresión que reducen el consumo de memoria en cientos de veces se están trasladando rápidamente a la comunidad de código abierto. Muy pronto, un ordenador doméstico estándar podrá ejecutar con total soltura arquitecturas complejas que antes exigían clústeres enteros de servidores dedicados.
El precio de 0,003 dólares solo se rentabiliza en tareas específicas
Un precio unitario irrisorio por token no implica que completar cualquier tarea vaya a salir más barato; muchos caen en esta trampa lógica. En los debates de la comunidad de desarrolladores, el ingeniero jefe de un proyecto para crear un nuevo compilador compartió sus resultados reales. En un primer momento, colocó a DeepSeek 4.1 Flash como director y orquestador del proyecto, encomendándole la planificación global y la descomposición de la arquitectura.
El resultado fue una caída estrepitosa de la calidad. A la hora de tomar decisiones complejas, el modelo económico pasaba por alto dependencias críticas de contexto con frecuencia, concibiendo diseños arquitectónicos incoherentes sin ningún debate previo. Además, la documentación generada resultaba farragosa y desenfocada. El ingeniero optó finalmente por devolver el rol de orquestador al modelo frontera más costoso, reservando el modelo barato únicamente para implementar módulos de código con especificaciones rigurosas y límites bien acotados. Es un excelente peón para picar piedra, pero incapaz de diseñar los planos del edificio.
Otra prueba de referencia llamada «Pac-Man» evidenció una realidad todavía más cruda. Al afrontar un mismo proyecto complejo, el costoso modelo frontera tardó 9,3 minutos, costó 1,99 dólares y obtuvo una sobresaliente puntuación de 99. En contraste, el modelo económico tardó 2,8 minutos, costó 1,89 dólares, pero se quedó en una calificación de 72. El gasto total apenas se diferenció en 10 centavos (0,10 dólares), pero el grado de finalización mostró un abismo. La ventaja unitaria de 0,003 dólares se evaporó por completo tan pronto como varió la naturaleza del reto.
De ahí surgió otra vertiente en la conversación: un participante calculó que, según la precisión numérica empleada, alojar modelos de frontera de gran escala requiere entre 416 GB y 1.664 GB de memoria. Al mismo tiempo, la industria de los chips de memoria arrastra un historial de reiteradas sanciones antimonopolio por pactar precios ilegalmente. El elevado coste del hardware de memoria sigue siendo una barrera insalvable para la democratización de la computación. Rebajar los costes no es una batalla que libren en solitario los desarrolladores de algoritmos.
El desplome del coste de cómputo desplaza el centro de gravedad de las aplicaciones
Al encajar todas las piezas del rompecabezas, surge una radiografía veraz de la economía de la computación. Los precios ultrabajos únicamente se sostienen en escenarios con un índice masivo de aciertos en caché. En el instante en que la tarea exige un proceso deductivo original, razonamiento abierto o planificación estratégica, la ventaja del precio unitario queda neutralizada por unas tasas de éxito bajas y los sobrecostes derivados de repetir intentos una y otra vez.
Esto explica ciertas conductas paradójicas en la industria. Hay empresas que prefieren contratar múltiples suscripciones prémium de diversos proveedores y articular complejos balanceadores de carga antes que rediseñar su arquitectura de software. Y cuando agotan sus cuotas de alta prioridad, se quejan en redes sociales de la escasez de chips. Esto pone de relieve una distorsión en la comprensión de cómo debe aprovecharse la computación de bajo coste.
La auténtica relevancia de DeepSeek 4.1 Flash no radica en reemplazar a los modelos más punteros en retos científicos de vanguardia. Al reducir el consumo de memoria para contextos extensos en cientos de veces, ha inaugurado un nicho operativo inédito: la categoría de «tareas rutinarias de escaso valor que no compensa delegar en una IA» ha dejado de existir desde el punto de vista financiero. Un token barato no asegura una tarea barata; si se le exige una planificación arquitectónica para la que no está concebido, las pruebas y errores seguirán engordando la factura. La próxima vez que veamos tarifas de fracciones de centavo, la pregunta clave ya no será cuánto cuesta, sino qué tipo de tareas le vamos a encomendar.
Enlaces de referencia:
- Why Industry Is Not Panicking Over DeepSeek 4.1 Flash
- Debate en Hacker News: Pruebas reales en un nuevo proyecto de compilador
- Informe de análisis de precios de Mercatus AI