Am 7. Oktober 2026 sorgte ein Blogbeitrag mit dem Titel „Why Industry Is Not Panicking Over DeepSeek 4.1 Flash“ in der Entwickler-Community für Aufsehen. Der Autor, jonotime, präsentierte eine Zahl jenseits gängiger Erfahrungswerte: Nach einem Monat intensiver Nutzung des Modells über mehr als ein Dutzend komplexe Softwareprojekte hinweg belief sich seine Gesamtrechnung auf weniger als einen US-Dollar. In einer Branche, in der Monatsabonnements routinemäßig zweistellige Dollarbeträge pro Nutzer kosten, sticht ein Betrag unter einem Dollar sofort ins Auge. Wenn die Stückkosten für Rechenleistung auf dieses Niveau sinken, verändert das nicht nur die Monatsabrechnung – es bricht mit überholten Gewohnheiten bei der Aufgabenverteilung an Maschinen.
Selbst das Aufräumen des Schreibtischs wird an die KI delegiert
In seinem Beitrag schildert der Autor seine Praxiserfahrungen ungeschminkt. Im Verlauf eines Monats intensiver Arbeit konnte er im laufenden Dialog ehrlich gesagt nicht unterscheiden, ob er gerade das kostspielige Claude Opus oder das extrem günstige DeepSeek 4.1 Flash nutzte – es sei denn, er warf einen gezielten Blick auf den Modellnamen in der oberen Bildschirmecke. Weder beim Gesprächsfluss noch bei der Präzision der Anweisungsbefolgung oder der Antwortgeschwindigkeit zeigten sich im Alltag spürbare Differenzen. Dieser Erfahrungsbericht rüttelt an einem eisernen Dogma der IT-Welt: Dass erstklassige Arbeitsergebnisse zwingend den Höchstpreis für Spitzenmodelle erfordern.
Die Preisliste offenbart das Geheimnis hinter diesem drastischen Preisverfall. Außerhalb der Spitzenzeiten verlangt DeepSeek für eine Million Eingabe-Tokens 0,15 Dollar und für die Ausgabe 0,60 Dollar. Den entscheidenden Hebel bildet jedoch der Tarif bei einem Cache-Treffer (Cache Hit): Dieser stürzt auf 0,003 Dollar pro Million Tokens ab. Eine Million Tokens entsprechen etwa zwei vollständigen Romanen; die Verarbeitung einer solchen Textmenge kostet damit weniger als ein Bonbon. Diese Preisgestaltung lässt Nutzungsmuster Wirklichkeit werden, die zuvor undenkbar schienen.
Bisher zögerten Entwickler, banale Routinetätigkeiten an KI-Modelle zu übertragen, da jede Anfrage bares Geld kostete. Nun delegiert der Autor selbst triviale Aufgaben wie das Sortieren und Aufräumen von Dateien auf dem Desktop ohne das geringste Zögern. 0,003 Dollar auszugeben, um sich fünf Minuten manuelle Handarbeit zu ersparen, ist betriebswirtschaftlich erstmals absolut plausibel. Ein Automatisierungsskript den ganzen Tag im Hintergrund laufen zu lassen und Fehler iterativ beheben zu lassen, erfordert keine vorsichtige Budgetierung mehr.
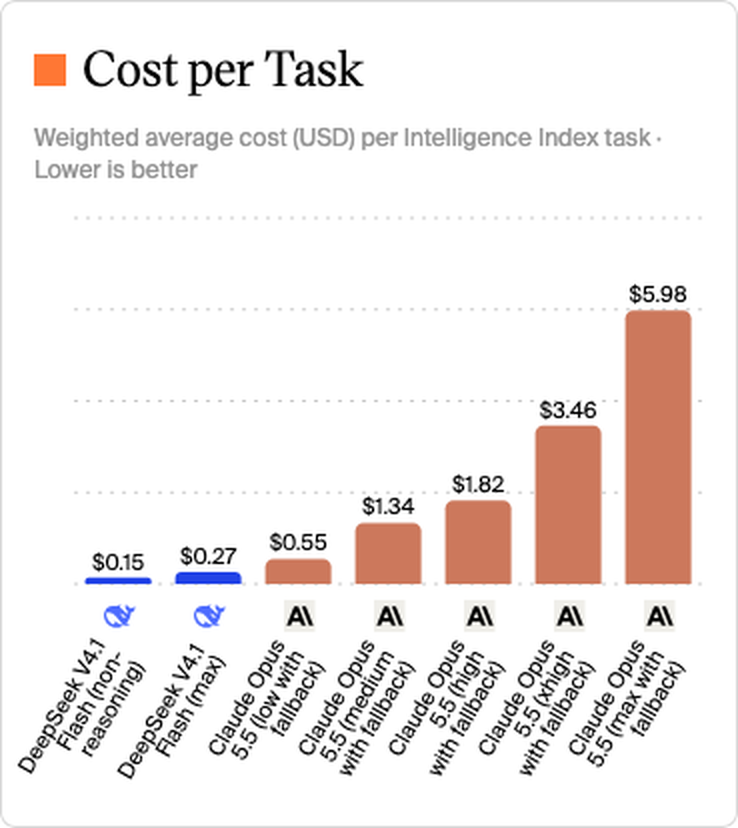 Abb.: Geschätzter Kostenvergleich für identische Aufgaben über verschiedene Modelle hinweg. Quelle: dgt.is-Blog
Reduzierung redundanter Rechenkapazitäten um den Faktor 437
Dass die Preise derart einbrechen konnten, liegt an architektonischen Durchbrüchen, die redundante Berechnungen eliminieren. Das Entwicklerteam komprimierte den Cache-Speicher für das Kontextgedächtnis (den KV-Cache-Footprint) im Vergleich zur ersten Modellgeneration um rund das 437-Fache. Dieser Faktor von über 400 ist der entscheidende technologische Hebel dafür, ob künstliche Intelligenz zu einer universell erschwinglichen Infrastruktur werden kann.
Ein Sprachmodell lässt sich mit einem Assistenten vergleichen, der extrem schnell liest, aber über ein denkbar schlechtes Gedächtnis verfügt. Bislang musste der Assistent bei jeder Folgefrage den gesamten bisherigen Gesprächsverlauf noch einmal von vorn durchlesen, um die aktuelle Anweisung im Kontext zu erfassen. Dieses ständige Wiederholen verschlang enorme Mengen an teurem GPU-Grafikspeicher (VRAM) – das größte finanzielle schwarze Loch bei langen Dialogen.
Die Lösung bestand darin, dem Assistenten beizubringen, ultrakompakte Notizen anzufertigen. Das System komprimiert bereits verarbeitete Inhalte zu winzigen Speicherfragmenten und hält sie langfristig im GPU-Speicher vor. Sobald in nachfolgenden Anfragen dieselben Kontextbedingungen referenziert werden, ruft es direkt die komprimierten Notizen ab und überspringt den stromintensiven und ressourcenfressenden Leseprozess komplett. Diese ingenieurtechnische Optimierung schlägt unmittelbar als radikaler Preissturz bei den API-Gebühren durch.
 Abb.: Die enormen Unterschiede zwischen den drei DeepSeek-Preisstufen; die Cache-Treffer-Rate ist im Diagramm kaum zu erkennen. Quelle: Mercatus AI Preisanalyse
Eigene Hardware-Cluster rechnen sich wirtschaftlich nicht mehr
Wenn Cloud-Dienste nur noch Bruchteile eines Cents kosten, geraten auch die wirtschaftlichen Grundlagen lokaler Hardware-Deployments ins Wanken. In den letzten Jahren investierten viele mittelständische Unternehmen und Entwickler massiv in eigene GPUs und lokale Server, um den hohen verbrauchsabhängigen Rechnungen der Cloud-Anbieter zu entgehen. Man hoffte, die Anfangsinvestitionen durch einen langfristigen Dauerbetrieb zu amortisieren.
Angesichts der neuen Preisstrukturen wird der Kauf eigener Hardware zwecks Kostensenkung jedoch zu einer Investitionsruine, die sich niemals amortisiert. Bei einem Tarif von 0,003 Dollar pro Million Tokens müsste ein Unternehmen seine Server über Jahre hinweg unter Volllast betreiben, nur damit die eingesparten API-Gebühren die Anzahlung für eine einzige High-End-Enterprise-GPU decken. Teure Hardware veraltet und verliert ihren Wert deutlich schneller, als die Preise für Cloud-Rechenleistung sinken.
Das letzte Argument für lokale Infrastrukturen war der Datenschutz – doch selbst dieses Argument gerät ins Wanken. Die Optimierungsverfahren, die den Speicherbedarf um das Hundertfache reduzieren, halten rasch Einzug in die Open-Source-Community. Es wird nicht mehr lange dauern, bis herkömmliche Standard-PCs komplexe Systeme flüssig ausführen können, für die bisher dedizierte Servercluster unverzichtbar waren.
Der 0,003-Dollar-Preis zahlt sich nur bei spezifischen Aufgaben aus
Niedrige Token-Preise bedeuten keineswegs, dass jede Aufgabe in Summe billiger wird. Hier tappen viele Anwender in eine Denkfalle. In Diskussionen innerhalb der Entwickler-Community teilte ein leitender Ingenieur eines neuen Programmiersprachen-Compilers seine Testergebnisse. Er setzte DeepSeek 4.1 Flash zunächst als übergeordnete Steuerungsinstanz ein, um Projekte zu planen und Architekturaufgaben zu zerlegen.
Das Ergebnis war ein drastischer Qualitätsabfall. Bei komplexen Architekturentscheidungen übersah das günstige System regelmäßig entscheidende Kontextabhängigkeiten und entwarf ohne vorherige Diskussion unplausible Systemstrukturen. Auch die generierte Dokumentation geriet weitschweifig und verfehlte den Kern. Der Ingenieur übertrug die Steuerungsrolle schließlich wieder dem teuren Spitzenmodell und beschränkte das günstige Modell auf klar spezifizierte, eng umrissene Code-Implementierungen. Als Handlanger für Standardcode glänzt es, für den architektonischen Entwurf taugt es nicht.
Ein Benchmark namens „Pac-Man“ verdeutlichte diese Realität noch drastischer. Bei der Bewältigung desselben komplexen Projekts benötigte das teure Frontier-Modell 9,3 Minuten, kostete 1,99 Dollar und erzielte eine Spitzenbewertung von 99 Punkten. Das günstige Modell brauchte 2,8 Minuten und kostete 1,89 Dollar, kam aber lediglich auf 72 Punkte. Die Gesamtkosten unterschieden sich um gerade einmal 10 Cent (0,10 Dollar), doch das Ergebnis lag meilenweit auseinander. Der Preisvorteil von 0,003 Dollar verpuffte vollständig, sobald sich die Aufgabenstellung änderte.
Dies führte zu einem weiteren Diskussionsstrang: Ein Nutzer rechnete vor, dass der Betrieb großer Spitzenmodelle je nach Datenpräzision zwischen 416 GB und 1.664 GB Speicher erfordert. Gleichzeitig wurde die Speicherchip-Industrie in der Vergangenheit mehrfach wegen unerlaubter Preisabsprachen mit Kartellstrafen belegt. Die hohen Preise für Hardware-Speicher bleiben ein massiver Bremsklotz für die breite Einführung von KI. Die Senkung der Rechenkosten ist ein Kampf, der keineswegs nur auf Seiten der Algorithmenentwickler ausgetragen wird.
Preissturz bei Rechenleistung verschiebt den Schwerpunkt der Anwendungsfälle
Fügt man alle Puzzleteile zusammen, entsteht ein realistisches Bild der Rechenkosten. Der extreme Niedrigpreis greift ausschließlich in Szenarien mit hoher Cache-Trefferquote. Sobald eine Aufgabe eigenständige Deduktion, kreative Lösungsfindung oder exploratives Planen erfordert, wird der Stückkostenvorteil augenblicklich von geringen Erfolgsquoten und zeitraubenden Wiederholungsschleifen aufgefressen.
In der Praxis führt dies zu paradoxen Reaktionen: Manche Unternehmen abonnieren lieber eine Vielzahl teurer Spitzenpakete unterschiedlicher Anbieter und verteilen die Last über komplexe Load-Balancer, anstatt ihre Softwarearchitektur grundlegend anzupassen. Gehen die Kontingente zur Neige, beklagen sie in den sozialen Medien Engpässe bei der Rechenleistung. Dies offenbart ein grundlegendes Missverständnis darüber, wie kostengünstige Rechenleistung effizient eingesetzt werden sollte.
Die wahre Bedeutung von DeepSeek 4.1 Flash liegt nicht darin, Spitzenmodelle bei hochkomplexen Forschungsaufgaben abzulösen. Indem es den Speicherbedarf für lange Kontexte um ein Vielfaches senkt, erschließt es ein völlig neues Anwendungsfeld: Geringwertige Routinearbeiten, für die KI bisher als zu teuer galt, sind wirtschaftlich gesehen kein Tabu mehr. Ein niedriger Token-Preis garantiert jedoch keine niedrigen Projektkosten: Wer das Modell für Aufgaben einsetzt, denen es nicht gewachsen ist, zahlt durch wiederholte Fehlversuche am Ende drauf. Wenn wir das nächste Mal auf Cent-Bruchteile in Preislisten blicken, lautet die entscheidende Frage nicht mehr, wie billig das Modell ist, sondern mit welchen Aufgaben wir es füttern.
Weiterführende Quellen:
- Why Industry Is Not Panicking Over DeepSeek 4.1 Flash
- Hacker-News-Diskussion: Praxistests bei einem neuen Compiler-Projekt
- Mercatus AI Preisanalysebericht


