In den vergangenen zehn Jahren haben Entwicklungsteams im Lakehouse-Bereich enorm viel Energie darauf verwendet, Objektspeichern das Verhalten transaktionaler Datenbanken beizubringen. In Cloud-Native-Architekturen verließen sich Anbieter standardmäßig auf unzählige Textdateien und Log-Streams, um Datenkonsistenz zu gewährleisten. Das im April 2026 veröffentlichte DuckLake 1.0 schlägt einen deutlich geradlinigeren Weg ein: Tabellenmetadaten werden nicht mehr in JSON-Manifesten auf Objektspeichern abgelegt, sondern in eine echte relationale Datenbank überführt.
Ein Großteil der Komplexität, die Lakehouse-Formate im letzten Jahrzehnt aufbauten, rührt daher, dass Objektspeicher Aufgaben übernehmen mussten, die originär in relationale Datenbanken gehören. DuckLake verlagert die Metadatenebene zurück in eine ACID-fähige Transaktionsdatenbank. Dadurch müssen Snapshots, Time-Travel-Abfragen und kleine Batch-Schreibvorgänge nicht mehr über aufwendige Compaction-Operationen abgefangen werden. Doch eine Spezifikation 1.0 ist noch längst keine produktionsreife Software 1.0: Dieser architektonische Ansatz, moderne Probleme mit bewährter Technologie zu lösen, stößt bei Zugriffskontrollmodellen und Implementierungsreife an reale Grenzen.
Abkehr vom Objektspeicher für das Metadatenmanagement
In der gängigen Praxis verlangen Formate wie Apache Iceberg bei jedem Schreibvorgang die Neuerstellung von Snapshot-JSONs, Manifest-Listen und Manifest-Dateien. Dieser statische Verwaltungsmechanismus funktioniert bei seltenen, großvolumigen Batch-Schreibvorgängen zuverlässig. Bei Workloads mit hochfrequenten, kleinteiligen Schreiboperationen übersteigt die Zahl der Metadatenobjekte jedoch rasch die Anzahl der tatsächlichen Datendateien. Der Versuch, Transaktionsmechanismen mittels statischer Textdateien auf Objektspeichern nachzubilden, bremst bei wachsender Skalierung Datei-Listing-Operationen massiv aus und treibt die Kosten für API-Aufrufe in die Höhe.
DuckLake bricht mit diesem verschachtelten Aufbau und teilt das System in drei saubere Schichten auf. Die unterste Speicherschicht (Storage) basiert weiterhin auf Parquet-Dateien auf Objektspeichern oder lokalen Festplatten, während die oberste Rechenschicht (Compute) modular austauschbar bleibt. Die entscheidende mittlere Katalogschicht (Catalog) wird zu einer vollwertigen SQL-Datenbank, die derzeit mit PostgreSQL, SQLite, MySQL und DuckDB selbst kompatibel ist. Da Schema-Evolution, Partitionsinformationen und Spaltenstatistiken direkt in relationalen Tabellen vorgehalten werden, müssen Abfrage-Engines nicht mehr unzählige Klein-Dateien durchforsten, um den aktuellen Stand eines Daten-Snapshots zu ermitteln.
Metadaten direkt als Datenbanktransaktionen zu schreiben, spart den Betriebsaufwand für eigenständige REST-Dienste wie Apache Polaris oder Unity Catalog. Im Iceberg-Ökosystem entwickeln sich isolierte Katalogoperationen häufig zu physischen Engpässen im Schreibpfad, die bei Fehlkonfigurationen die gesamte Pipeline blockieren können. DuckLakes Architektur verschiebt die Performance-Engpässe weg von den I/O-Latenzen des Objektspeichers hin zur in der Softwareentwicklung bestens verstandenen Domäne der datenbankbasierten Transaktionsverarbeitung.
Relationale Tabellen fangen hochfrequente Klein-Schreibvorgänge ab
Um dem in Echtzeit-Data-Warehouses typischen Problem ständiger Aktualisierungen zu begegnen, führt DuckLake einen gezielten Mechanismus für Data Inlining ein. Treffen kleinteilige INSERT-, UPDATE- oder DELETE-Operationen ein, lösen diese nicht mehr sofort ein Umschreiben der zugrunde liegenden Parquet-Dateien aus, sondern werden zunächst direkt in die Katalogdatenbank geschrieben. Dieser Entwurf transformiert fragmentierte I/O-Anfragen in performante interne Datenbanktransaktionen und unterbindet das Small-Files-Problem direkt an der Wurzel.
Erst wenn das Datenvolumen in der Datenbank einen definierten Schwellenwert erreicht, startet ein Hintergrundprozess, der diese gepufferten Daten gesammelt auf die Speicherebene flusht und standardkonforme Parquet-Dateien generiert. Diese verzögerte Schreibstrategie (Deferred Write) erspart rechenintensive, fortlaufende Compaction-Tasks zur Bereinigung kleiner Dateien. Gleichzeitig sinken die Netzwerkübertragungs- und Lesekosten gegenüber dem Objektspeicher deutlich, sodass das System bei hoher Lese- und Schreiblast die physische Kontinuität der Datenblöcke wahrt.
Neben der Pufferung kleiner Schreibvorgänge unterstützt DuckLake bei Scans die Angabe von Sortierschlüsseln (Sorting Keys). Bei nachfolgenden Dateizusammenführungen wahrt die Engine strikt die vorgegebene physische Sortierung. Durch die geordnete Ablage der Datendateien kann die Abfrage-Engine Bereichsfilterung (Range Pruning) und Filter-Pushdown direkt nutzen, um irrelevante Speicherblöcke bereits beim Scan-Schritt präzise zu überspringen.
Eine minimalistische Spezifikation für breite Compute-Engine-Konnektivität
DuckLake versteht sich als offene technische Spezifikation und zählt auf GitHub bereits über 3.200 Stars. Das kommerzielle Unternehmen MotherDuck unterstützt das Projekt und stellt ein kostenloses E-Book bereit. In Blogbeiträgen betont das Entwicklerteam unumwunden, dass die Spezifikationslogik so transparent gehalten ist, dass selbst Code-Generierungs-LLMs anhand der Dokumentation rasch eine lauffähige Implementierung für DataFrames erstellen können. Die architektonische Komplexität so weit zu reduzieren, dass ein einzelner Entwickler sie eigenständig nachbauen kann, erweist sich als wirksame Strategie, um frühzeitig Entwickler für das Ökosystem zu gewinnen.
 Abbildung: Die Spezifikation ist so einfach gehalten, dass selbst LLMs eine DataFrames-Implementierung schreiben können. Quelle: DuckLake-Blog
Die Entkopplung von Spezifikation und Engine stellt sicher, dass der Standard nicht fest an DuckDB gebunden ist. Solange eine Ziel-Engine relationale Metadaten und das Parquet-Format verarbeiten kann, lassen sich gängige Analyse-Frameworks wie Trino oder Apache Spark problemlos als Compute-Layer anbinden. Im Open-Source-Ökosystem von Apache DataFusion haben Community-Entwickler bereits einen spezialisierten Lakehouse-Client in Rust realisiert.
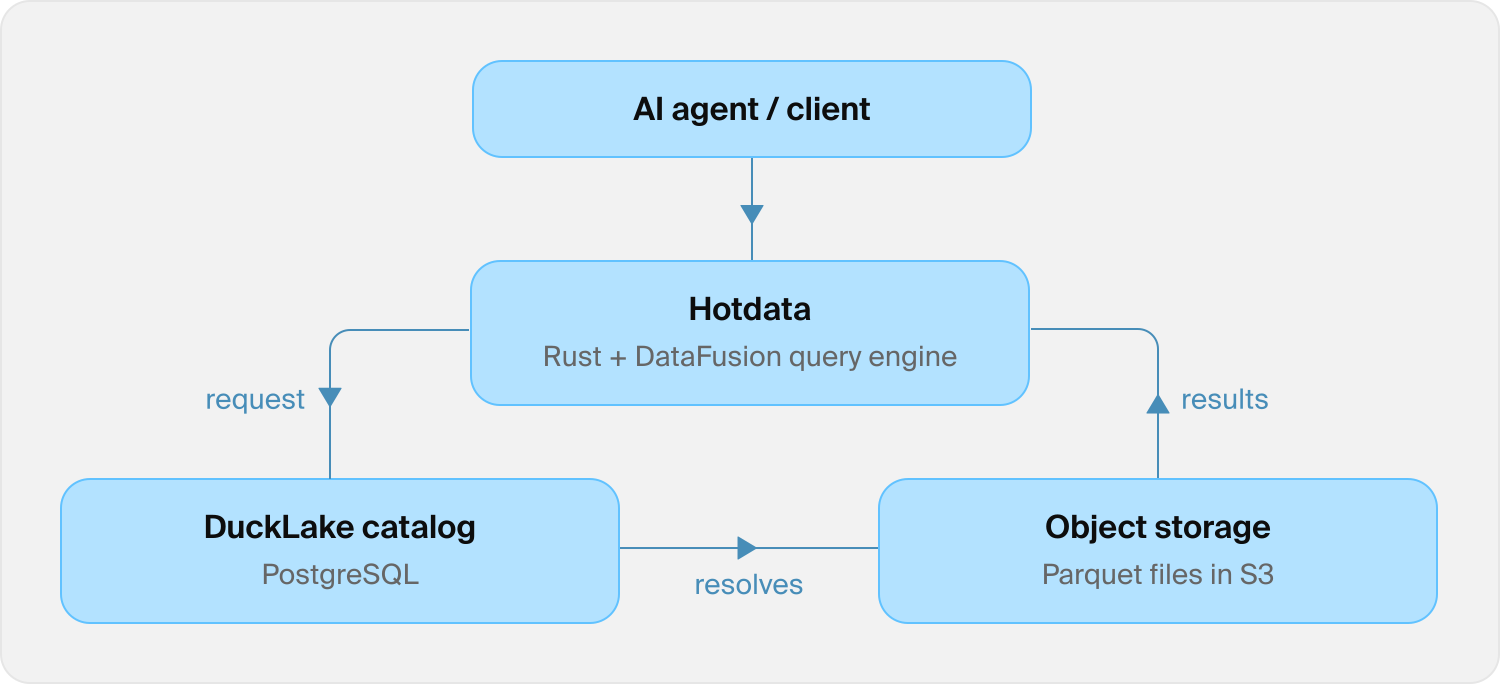 Abbildung: Architekturübersicht des DuckLake-Clients im DataFusion-Ökosystem. Quelle: DuckLake-Blog
Dieser von der Community entwickelte Client nutzt PostgreSQL als Metadatenspeicher im Backend. Projektbeteiligte berichten, dass die leichtgewichtige Architektur selbst unter hoher paralleler Abfragelast stabil Subsekunden-Antwortzeiten liefert und maßgeschneiderten Speziallösungen in nichts nachsteht. Dies unterstreicht den praktischen Nutzen, komplexe Katalogverwaltungslogik an bewährte relationale Datenbanksysteme zu delegieren, insbesondere in Multi-Reader-Szenarien mit hoher Parallelität.
Neue Spezifikationsversionen überdecken fehlende Zugriffskontrollen nicht
Obwohl die Version 1.0 unter MIT-Lizenz mit Abwärtskompatibilitätsversprechen veröffentlicht wurde, zeigen Praxistests im Produktivumfeld spürbare Reibungsverluste. Ingenieure berichteten bei Version 1.5.4 von Fehlern, bei denen nach Katalogfilterungen inkorrekte Datensatzzahlen ermittelt wurden. Nach dem Wechsel auf den Haupt-Branch zur Behebung dieses Fehlers brach die Ausführungsgeschwindigkeit des integrierten SQL-Parsers von DuckDB um das Zehnfache ein. Derartige Stabilitätsschwankungen zwischen Releases erfordern zwingend rigorose Grenz- und Belastungstests, bevor ein Einsatz in kritischen Produktionslinien erwogen wird.
Zentraler Kritikpunkt in der Community bleibt das unzureichende Autorisierungs- und Zugriffskontrollmodell. In der aktuellen Fassung greifen Rechteprüfungen lediglich grob granular auf Ebene der darunterliegenden Speicher-Buckets. Dem Gesamtsystem fehlen für Enterprise-Deployments unverzichtbare Mechanismen wie Spaltenzugriffskontrollen (Column-Level Access Control), zeilenbasierte Sicherheitsregeln (Row-Level Security, RLS) sowie Datenmaskierungsfunktionen. Ohne diese Schutzmechanismen gleicht die Architektur einem ungesicherten Wasserreservoir.
Das Fehlen einer feingranularen Sicherheitsschicht schränkt den Einsatz dieser Architektur in unternehmensweiten Analyseumgebungen massiv ein. Solange eine mandantenfähige Datenisolation zwischen verschiedenen Teams nicht gewährleistet werden kann, eignet sich die Spezifikation primär für isolierte Entwicklungs-Sandboxen einzelner Teams und kaum für strenge Multi-Tenant-Produktionsumgebungen.
Formatwettbewerb kehrt zu Transaktionen und Speicherarchitektur zurück
Auf Kompatibilitätsebene unterstützt DuckLake tabellenübergreifende ACID-Transaktionskontrolle und historische Time-Travel-Abfragen. Die zugrunde liegenden Deletion Vectors wurden formatseitig direkt kompatibel zu Apache Iceberg implementiert. Dadurch muss die Engine bei zeilenweisen Löschanfragen nicht unmittelbar gigantische Parquet-Blöcke neu schreiben. Bei einem Löschbefehl vermerkt das System lediglich den Status in den Vektortabellen und verschiebt die rechenintensive physische Bereinigung, was Lastspitzen im Cluster effektiv glättet.
Zur Debatte in der Community, warum der Kerncode nicht in moderneren Programmiersprachen neu geschrieben wurde, vertritt das Team eine pragmatische Haltung: Da DuckDB seit Projektbeginn im Jahr 2018 auf C++ basiert, führt die daraus abgeleitete Lakehouse-Spezifikation diesen Technologie-Stack konsequent fort. Diese Wahl vermeidet Brüche im Code durch massive Rewrites und sichert die Reihenfolgekonsistenz und Stabilität der Ausführungs-Engine.
Der Fortschritt bei Data-Lakehouse-Formaten bemisst sich nicht an kurzlebigen Marketingbegriffen. Komplexe Snapshot-Zustände und Transaktionsmechanismen an über Jahrzehnte erprobte relationale Datenbanken zurückzugeben, ist ein wohlüberlegter Kompromiss des DuckLake-Teams. Man erkauft sich hohe Metadaten-Parallelität und zahlt vorerst mit Abstrichen bei granularen Dateiberechtigungen. Wenn der Marketingwirbel um moderne Lakehouse-Formate verfliegt, bleibt der Maßstab für echte Ingenieurskunst stets derselbe: grundlegende Datenkonsistenz und fein abgestufte Sicherheitsarchitektur.
Weiterführende Links:
- DuckLake GitHub-Repository
- DuckLake Offizielle Dokumentation
- Hacker News Diskussion