Au cours de la dernière décennie, les équipes d’ingénierie dans l’univers du lakehouse ont déployé des trésors d’ingéniosité pour forcer le stockage objet à se comporter comme une base de données transactionnelle. Dans les architectures cloud natives, les éditeurs ont pris pour habitude d’empiler d’innombrables fichiers texte et flux de journaux afin de bricoler la cohérence du système. Publiée en avril 2026, la spécification DuckLake 1.0 propose une approche bien plus directe : sortir les métadonnées de tables des fichiers manifestes JSON hébergés sur le stockage objet pour les confier à une véritable base de données relationnelle.
L’essentiel de la complexité accumulée par les formats de lakehouse ces dix dernières années provient du fait d’assigner au stockage objet des responsabilités relevant par nature d’une base de données. DuckLake replace le plan de métadonnées au sein d’une base transactionnelle conforme ACID, évitant ainsi d’imposer de lourdes opérations de compactage pour gérer les instantanés (snapshots), le voyage dans le temps (time travel) et les écritures par micro-lots. Cependant, une version 1.0 d’une spécification est loin d’équivaloir à un logiciel 1.0 prêt pour la production : cette architecture, qui résout de nouveaux défis avec des technologies éprouvées, bute sur l’écueil de son modèle de permissions et de sa maturité d’exécution.
Abandonner le stockage objet pour la gestion des métadonnées
Dans les usages établis, des formats tels qu’Apache Iceberg exigent la création d’un nouveau fichier JSON de snapshot, d’une liste de manifestes et de fichiers manifestes à chaque écriture de données. Ce mécanisme statique donne d’excellents résultats pour des ingestions massives et espacées dans le temps. En revanche, face à des charges de travail rythmées par des écritures fréquentes de petit volume, le nombre d’objets de métadonnées dépasse fréquemment celui des fichiers de données réels. Simuler des mécanismes transactionnels sur du stockage objet au moyen de fichiers texte statiques finit, avec l’effet d’échelle, par paralyser les opérations de listage et par faire exploser les coûts d’appels API.
DuckLake rompt avec cette surenchère architecturale en découpant le système en trois couches distinctes. À la base, la couche de stockage (storage) repose toujours sur des fichiers Parquet hébergés sur du stockage objet ou des disques locaux ; au sommet, la couche de calcul (compute) demeure entièrement modulaire et interchangeable. Entre les deux, la couche charnière du catalogue (catalog) devient une base de données SQL à part entière, aujourd’hui compatible avec PostgreSQL, SQLite, MySQL et DuckDB lui-même. En consignant l’évolution du schéma, le partitionnement et les statistiques de colonnes dans des tables relationnelles, les moteurs de requêtes n’ont plus besoin de parcourir une myriade de petits fichiers pour connaître l’état précis d’un instantané.
Écrire les métadonnées sous la forme de transactions natives en base supprime le fardeau opérationnel lié au déploiement et à la maintenance de services REST dédiés comme Apache Polaris ou Unity Catalog. Dans l’écosystème Iceberg, les opérations sur un catalogue isolé constituent souvent un goulot d’étranglement physique sur le chemin d’écriture, risquant d’asphyxier l’ensemble de la chaîne d’ingestion en cas de mauvaise gestion. L’architecture de DuckLake ramène les contraintes de performance depuis la latence d’E/S du stockage objet vers un domaine bien plus maîtrisé de l’ingénierie logicielle : le traitement transactionnel concurrentiel en base de données.
Les tables relationnelles absorbent les écritures fréquentes à petite échelle
Afin de répondre aux mises à jour intensives caractéristiques des entrepôts de données en temps réel, DuckLake introduit un mécanisme dédié d’insertion en ligne (data inlining). Dès lors que de petites opérations d’insertion, de mise à jour ou de suppression (INSERT, UPDATE, DELETE) surviennent, elles ne déclenchent plus la réécriture immédiate des fichiers Parquet sous-jacents, mais sont consignées directement dans la base de données du catalogue. Cette conception convertit des requêtes d’E/S fragmentées en transactions internes hautement efficaces, neutralisant le problème des petits fichiers (Small Files) à la source.
Ce n’est que lorsque le volume de données en attente dans la base atteint un seuil physique prédéfini qu’un processus d’arrière-plan déclenche la purge, compactant les données pour générer des fichiers Parquet standards. Cette stratégie d’écriture différée (deferred write) évite le recours permanent à des opérations de compactage physique voraces en calcul pour nettoyer les petits fichiers. Parallèlement, elle réduit de manière drastique les transferts réseau et les coûts de lecture vis-à-vis du stockage objet, permettant au système de soutenir une forte concurrence en lecture et en écriture tout en préservant la continuité physique des blocs de données.
En complément de la mise en mémoire tampon des petites écritures, DuckLake prend en charge la définition de clés de tri (sorting keys) lors des scans sous-jacents. Lors des phases ultérieures de fusion de fichiers, le moteur préserve scrupuleusement l’ordre physique initial. Le maintien d’un agencement ordonné des fichiers de données permet au moteur d’exécution d’exploiter immédiatement l’élagage par plages (range pruning) et la poussée de filtres (filter pushdown), écartant les blocs de stockage superflus dès la phase de scan.
Une spécification minimaliste pour intégrer de multiples moteurs de calcul
DuckLake se positionne comme une spécification technique ouverte ayant déjà dépassé les 3 200 étoiles sur GitHub. L’entreprise MotherDuck soutient activement l’initiative et distribue un guide gratuit sous forme d’e-book. Dans leurs publications de blog, les concepteurs soulignent en toute franchise que la logique de la spécification est si simple et lisible que des modèles de génération de code (LLM) peuvent en déduire rapidement une implémentation fonctionnelle pour DataFrames à partir de la seule documentation. Réduire la complexité architecturale pour permettre à un développeur isolé de la reproduire constitue une stratégie particulièrement efficace pour fédérer rapidement des contributeurs.
 Figure : La spécification est si simple que même les LLM peuvent coder une implémentation pour DataFrames. Source : Blog officiel de DuckLake
Le découplage entre la spécification et le moteur garantit que la norme ne reste pas inféodée à DuckDB. Tant que le moteur de calcul cible sait interpréter les métadonnées relationnelles et le format Parquet, des cadriciels d’analyse éprouvés comme Trino ou Apache Spark peuvent s’y connecter sans friction. Dans l’écosystème open source d’Apache DataFusion, des développeurs indépendants ont déjà mis au point un client lakehouse dédié écrit en Rust.
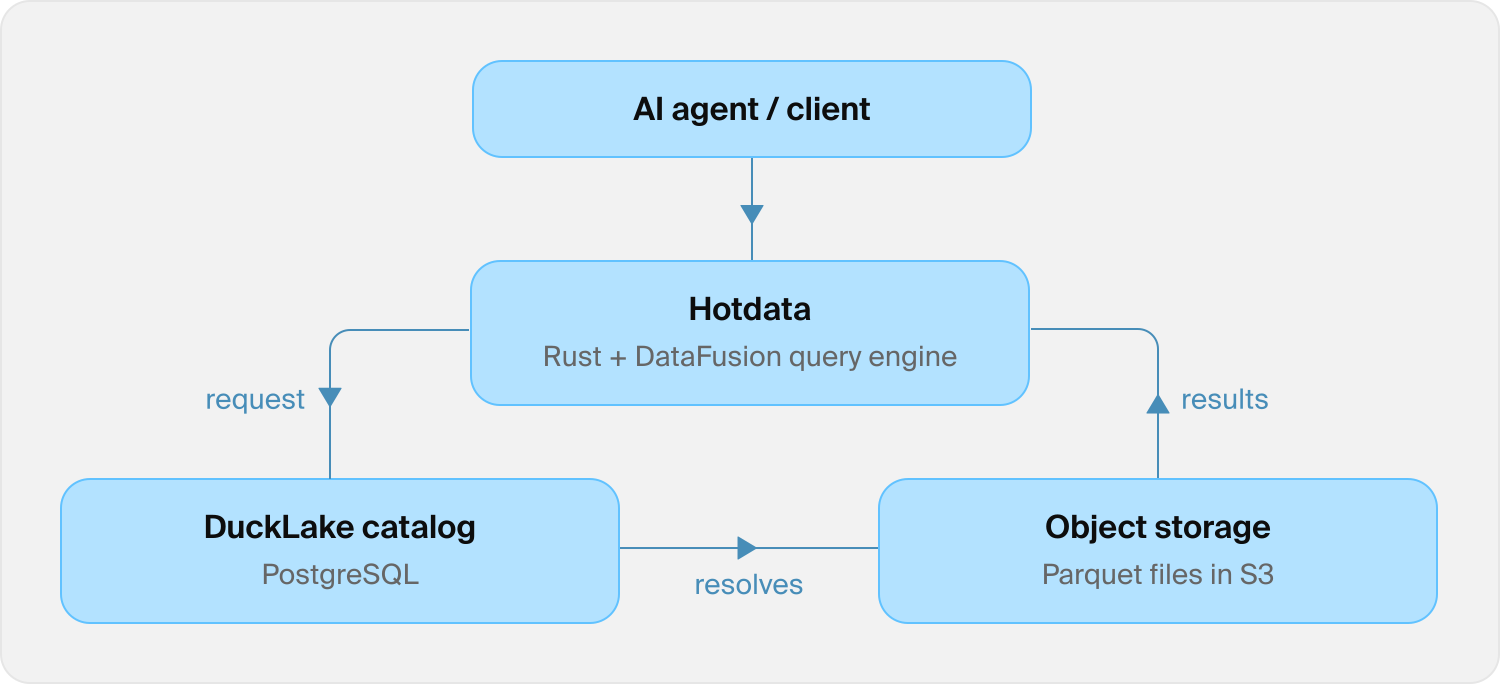 Figure : Schéma d’architecture du client DuckLake au sein de l’écosystème DataFusion. Source : Blog officiel de DuckLake
Ce client conçu par la communauté s’appuie sur PostgreSQL comme magasin de métadonnées en arrière-plan. Selon les porteurs du projet, même sous une charge massive de requêtes concurrentes, cette architecture légère garantit des temps de réponse inférieurs à la seconde, égalant les performances de systèmes de métadonnées sur mesure développés pour des cas d’usage précis. Cette réussite démontre que déléguer la gestion complexe du catalogue à des bases relationnelles éprouvées apporte une réelle valeur pratique dans des environnements à lectures hautement concurrentes.
La version de la spécification ne masque pas les faiblesses du contrôle d’accès
Bien que la version 1.0 de la spécification ait été publiée sous licence MIT avec un engagement de rétrocompatibilité, les retours de la communauté révèlent d’importantes frictions techniques sur le terrain. Des ingénieurs ont notamment signalé que sur la version v1.5.4, le filtrage de catalogue générait des comptages d’enregistrements erronés. Pire encore, après avoir basculé sur la branche principale (main) pour appliquer le correctif, les performances de l’analyseur SQL intégré de DuckDB se sont effondrées d’un facteur dix. Ces fluctuations de stabilité entre versions imposent aux équipes techniques d’effectuer des tests de robustesse et de limites rigoureux avant tout déploiement sur des pipelines critiques.
Les discussions techniques mettent en lumière le point faible majeur du dispositif : l’indigence de son modèle de contrôle d’accès. Dans son état actuel, la gestion des permissions s’avère particulièrement sommaire, se limitant à autoriser ou refuser l’accès au niveau des buckets de stockage sous-jacents. Le système fait l’impasse sur des exigences pourtant incontournables en entreprise, telles que le contrôle d’accès au niveau des colonnes (CLAC), la sécurité au niveau des lignes (RLS) ou le masquage dynamique de données. Privée de ces garde-fous, l’architecture s’apparente à un réservoir dépourvu de défenses.
L’absence d’une couche de sécurité à granularité fine entrave sérieusement l’adoption de ce lakehouse dans les environnements décisionnels d’entreprise. Tant que l’isolation étanche des données entre équipes n’est pas assurée, cette spécification convient avant tout à des bacs à sable (sandboxes) internes pilotés par une seule équipe, mais ne peut prétendre gérer des données de production multi-locataires soumises à de fortes exigences de conformité.
La guerre des formats revient à l’essentiel : transactions et architecture de stockage
Sur le plan de la compatibilité, DuckLake prend en charge les transactions ACID multi-tables ainsi que les requêtes historiques de voyage dans le temps. Le mécanisme de vecteurs de suppression (deletion vectors) retenu au niveau des fichiers adopte une approche directement compatible avec Apache Iceberg. Cela dispense le moteur de réécrire immédiatement d’imposants blocs Parquet lors de suppressions à la ligne : face à une instruction d’effacement, le système appose simplement un marqueur dans les tables vectorielles, reportant le nettoyage physique coûteux et écrêtant les pics de charge sur le cluster.
Face aux débats communautaires sur le choix de ne pas réécrire le cœur du projet dans un langage plus à la mode, la réponse de l’équipe témoigne d’un pragmatisme assumé. DuckDB ayant été conçu en C++ dès ses débuts en 2018, la spécification dérivée pour le lakehouse s’inscrit naturellement dans la continuité de ce socle technique. Ce choix évite les fractures de code inhérentes à une réécriture intégrale, tout en préservant la cohérence de l’ordonnancement du moteur et la stabilité globale du système.
L’évolution des formats de data lakehouse ne se mesure pas à l’adoption de concepts à la mode. Rendre la gestion complexe des instantanés et des transactions à des bases de données relationnelles éprouvées depuis des décennies constitue un compromis pragmatique opéré par l’équipe de DuckLake. Ce parti pris structurel permet de traiter les requêtes de métadonnées avec une concurrence remarquable, au prix temporaire d’un contrôle d’accès fichier plus grossier. Une fois dissipé le bruit marketing autour des formats lakehouse, la solidité d’une plateforme d’ingénierie se juge toujours sur ses fondamentaux : la cohérence sous-jacente et la granularité de sa sécurité.
Liens de référence :
- Dépôt GitHub de DuckLake
- Annonce officielle de DuckLake
- Discussion sur Hacker News