Durante la última década, los equipos de ingeniería en el ámbito del lakehouse han dedicado un esfuerzo descomunal a intentar que el almacenamiento de objetos actúe como una base de datos transaccional. En las arquitecturas nativas de la nube, los proveedores optaron por encadenar incontables archivos de texto y flujos de registros para apuntalar la consistencia del sistema. Publicado en abril de 2026, DuckLake 1.0 propone una vía mucho más directa: trasladar los metadatos de las tablas fuera de los manifiestos JSON del almacenamiento de objetos e integrarlos en una base de datos relacional de verdad.
Gran parte de la complejidad acumulada por los formatos de lakehouse en estos diez años responde a forzar al almacenamiento de objetos a cumplir funciones que corresponden por naturaleza a una base de datos. DuckLake devuelve el plano de metadatos a una base de datos transaccional con garantías ACID, logrando que las instantáneas (snapshots), las consultas de viaje en el tiempo (time travel) y las escrituras en micro-lotes no dependan de costosas operaciones de compactación. No obstante, una especificación 1.0 dista mucho de ser un software 1.0 listo para producción: esta arquitectura, que resuelve retos modernos con tecnologías consolidadas, se enfrenta a su verdadero obstáculo en el modelo de control de acceso y en la madurez de su implementación.
Abandonar el almacenamiento de objetos para gestionar metadatos
En la práctica predominante, formatos como Apache Iceberg exigen generar un nuevo snapshot JSON, una lista de manifiestos y archivos de manifiesto con cada escritura de datos. Este mecanismo estático funciona adecuadamente ante ingestas masivas y poco frecuentes. Sin embargo, en cargas de trabajo marcadas por escrituras pequeñas y de alta frecuencia, la cantidad de objetos en el directorio de metadatos supera a menudo el número de archivos de datos reales. Simular mecanismos transaccionales sobre almacenamiento de objetos mediante archivos de texto estáticos ralentiza drásticamente las operaciones de listado a medida que la escala crece y dispara los costes de las llamadas a la API.
DuckLake prescinde de esta estructura sobrecargada dividiendo el sistema en tres capas limpias. En la base, el almacenamiento (storage) se mantiene sobre archivos Parquet en almacenamiento de objetos o disco local; en la cúspide, el cómputo (compute) conserva su carácter desacoplado e intercambiable. En el punto intermedio, el catálogo (catalog) se convierte en una base de datos SQL en toda regla, compatible con PostgreSQL, SQLite, MySQL e incluso con el propio DuckDB. Al almacenar la evolución del esquema, las particiones y las estadísticas de columnas en tablas relacionales, los motores de consulta ya no necesitan rastrear miles de archivos pequeños para conocer el estado exacto de una instantánea.
Escribir metadatos como transacciones directas en la base de datos elimina la carga operativa de desplegar y mantener servicios REST dedicados como Apache Polaris o Unity Catalog. En el ecosistema de Iceberg, las operaciones sobre catálogos independientes se transforman con frecuencia en cuellos de botella físicos en la ruta de escritura, llegando a ralentizar toda la canalización si se configuran de forma inadecuada. La arquitectura de DuckLake desplaza las limitaciones de rendimiento desde la latencia de E/S del almacenamiento de objetos hacia un terreno mucho más familiar para la ingeniería de software: el procesamiento transaccional concurrente en bases de datos relacionales.
Tablas relacionales para absorber escrituras frecuentes y de pequeño tamaño
Para atajar las actualizaciones constantes habituales en los almacenes de datos en tiempo real, DuckLake incorpora un mecanismo específico de inserción en línea (data inlining). Cuando el sistema recibe operaciones reducidas de inserción, actualización o eliminación (INSERT, UPDATE, DELETE), estas ya no provocan de inmediato la reescritura de los archivos Parquet subyacentes, sino que se escriben directamente en la base de datos del catálogo. Este enfoque convierte peticiones de E/S fragmentadas en transacciones internas altamente eficientes dentro de la base de datos, cortando el problema de los archivos pequeños (Small Files) de raíz.
Solo cuando el volumen de datos acumulados en la base de datos alcanza un umbral físico predeterminado, un proceso en segundo plano inicia el volcado para compactar y generar archivos Parquet estándar. Esta estrategia de escritura diferida (deferred write) evita ejecutar continuas tareas de compactación física que consumen ingentes recursos de cómputo solo para sanear archivos diminutos. Al mismo tiempo, reduce de forma sustancial el tráfico de red y los costes de lectura frente al almacenamiento de objetos, permitiendo al sistema sostener altas cargas de lectura y escritura concurrentes sin perder la continuidad física de los bloques de datos.
Además de amortiguar micro-escrituras, DuckLake admite la especificación de claves de ordenación (sorting keys) durante el escaneo de datos subyacentes. Durante las posteriores compactaciones de archivos, el motor respeta con rigor el orden físico preestablecido. La disposición ordenada de los archivos de datos permite al motor de consultas aprovechar de inmediato la poda de rangos (range pruning) y el empuje de filtros (filter pushdown), descartando bloques de almacenamiento irrelevantes durante la propia fase de escaneo.
Una especificación minimalista para conectar múltiples motores de cálculo
DuckLake se posiciona como una especificación técnica abierta que ya acumula más de 3.200 estrellas en su repositorio de GitHub. La empresa MotherDuck respalda activamente el proyecto y distribuye una guía gratuita en formato digital. En publicaciones de su blog oficial, el equipo destaca sin rodeos que la lógica de la especificación resulta tan limpia que incluso los modelos de lenguaje (LLM) pueden generar con rapidez implementaciones compatibles para DataFrames basándose únicamente en la documentación. Reducir la complejidad arquitectónica hasta el punto de que un desarrollador individual pueda replicarla con soltura constituye una estrategia eficaz para atraer colaboradores en las fases tempranas de un estándar.
 Figura: La especificación es tan sencilla que incluso los LLM pueden implementar un cliente para DataFrames. Fuente: Imagen del blog oficial de DuckLake
El desacoplamiento entre la especificación y el motor asegura que el estándar no quede supeditado a DuckDB. Mientras el motor de cálculo objetivo sea capaz de interpretar metadatos relacionales y el formato Parquet subyacente, herramientas consolidadas como Trino o Apache Spark pueden acoplarse sin fricción en la capa de procesamiento. En la comunidad de Apache DataFusion, desarrolladores de código abierto ya han desarrollado un cliente dedicado para lakehouse escrito en Rust.
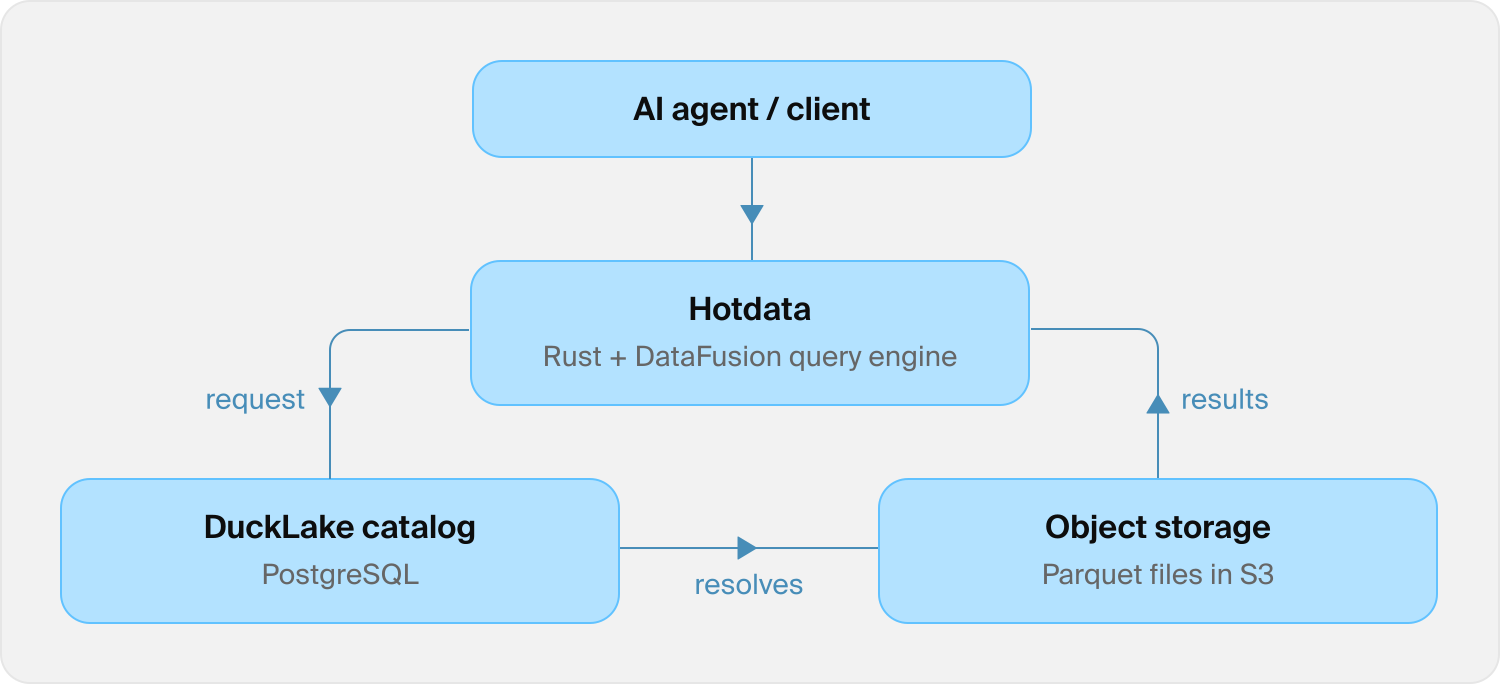 Figura: Diagrama de arquitectura del cliente de DuckLake en el ecosistema DataFusion. Fuente: Imagen del blog oficial de DuckLake
Este cliente desarrollado por la comunidad utiliza PostgreSQL como almacenamiento de metadatos en el backend. Según los responsables del proyecto, incluso bajo una severa carga de peticiones concurrentes, esta arquitectura ligera mantiene tiempos de respuesta por debajo del segundo, igualando el rendimiento de sistemas de metadatos hechos a medida para casos específicos. Esto confirma que delegar la compleja gestión del catálogo en bases de datos relacionales maduras aporta un valor de ingeniería tangible en entornos con múltiples lectores concurrentes.
Las versiones de la especificación no ocultan las carencias en control de acceso
Aunque la versión 1.0 de la especificación se ha publicado bajo licencia MIT y con el compromiso de compatibilidad hacia atrás, la experiencia práctica de la comunidad evidencia importantes fricciones técnicas. Algunos ingenieros reportaron que en la versión v1.5.4 se producían recuentos erróneos de registros tras aplicar filtros en el catálogo. Al cambiar a la rama principal (main) para solventar este error, el rendimiento del analizador SQL integrado en DuckDB sufrió una caída abrupta de hasta diez veces. Esta disparidad en la estabilidad entre versiones obliga a los equipos técnicos a realizar rigurosas pruebas de estrés y de límites antes de desplegarlo en líneas de producción críticas.
El debate en la comunidad técnica se centra en el punto más débil del sistema: las carencias en su modelo de control de acceso. En la versión actual, la granularidad de los permisos es excesivamente tosca y solo permite autorizar o bloquear el acceso a nivel del bucket de almacenamiento subyacente. El sistema carece por completo de mecanismos indispensables para entornos empresariales, tales como el control de acceso a nivel de columna (CLAC), la seguridad a nivel de fila (RLS) o las funciones de enmascaramiento de datos. Sin estos controles, la arquitectura se asemeja a un embalse desprovisto de mecanismos de defensa.
La ausencia de una capa de seguridad con control fino bloquea la adopción de esta arquitectura en escenarios reales de analítica corporativa. Al no garantizar un aislamiento seguro de los datos entre distintos equipos, la especificación encaja hoy por hoy en entornos de pruebas (sandboxes) controlados por un único equipo técnico, pero resulta insuficiente para asumir datos de producción multiinquilino con altos requisitos de seguridad.
La competencia de formatos regresa a las transacciones y la arquitectura de almacenamiento
En el apartado de compatibilidad, DuckLake ofrece soporte para transacciones ACID multitabla y consultas históricas de viaje en el tiempo. El mecanismo de vectores de eliminación (deletion vectors) adoptado en el plano de archivos es directamente compatible con la implementación de Apache Iceberg. Esto permite al motor tramitar eliminaciones a nivel de fila sin necesidad de reescribir bloques masivos de Parquet en el acto: ante una orden de borrado, el sistema se limita a registrar una marca en las tablas de vectores, posponiendo el costoso proceso de depuración física y mitigando los picos de carga en el clúster.
Frente a los debates en la comunidad sobre por qué no se reescribió el núcleo en un lenguaje de programación más moderno, la respuesta del equipo refleja un marcado pragmatismo. Dado que el propio DuckDB se ha construido en C++ desde 2018, la especificación de lakehouse derivada hereda con naturalidad esa base tecnológica. Esta elección evita las fracturas de código inherentes a una reescritura masiva, garantizando la consistencia secuencial del motor y la estabilidad a largo plazo del sistema.
La evolución de los formatos de data lakehouse no debería medirse por la adopción de modas terminológicas. Devolver el estado complejo de las instantáneas y los mecanismos transaccionales a bases de datos relacionales curtidas a lo largo de décadas es una decisión pragmática del equipo de DuckLake. Con este cambio estructural se gana una notable capacidad para procesar consultas de metadatos de alta concurrencia, sacrificando temporalmente la granularidad de los permisos de archivo. Cuando se disipa el marketing que envuelve al ecosistema, la solvencia de cualquier plataforma de datos se mide siempre por sus fundamentos: la consistencia subyacente y la precisión de sus barreras de seguridad.
Enlaces de referencia:
- Repositorio de GitHub de DuckLake
- Comunicado oficial de DuckLake
- Debate en la comunidad de Hacker News