過去10年間、レイクハウス領域のエンジニアたちは、オブジェクトストレージにいかにしてトランザクションデータベースのような振る舞いをさせるかに莫大な労力を注いできた。クラウドネイティブなアーキテクチャにおいて、ベンダー各社は膨大なテキストファイルとログストリームを継ぎ接ぎしてデータの一貫性を維持する仕組みを前提としてきた。しかし、2026年4月に公開された DuckLake 1.0 は、より直截的な解決策を提示している。テーブルのメタデータをオブジェクトストレージ内のJSONマニフェストファイルから、本物のリレーショナルデータベースへと移し替えるアプローチだ。
レイクハウスフォーマットがこの10年間で肥大化させてきた複雑さの大部分は、本来データベースが担うべき役割をオブジェクトストレージに無理やり押し付けてきたことに起因する。DuckLake はメタデータプレーンをACID特性を備えたトランザクションデータベースへと回帰させることで、スナップショットやタイムトラベル、小口バッチの書き込みにおいて、重いコンパクション(マージ処理)に頼らざるを得なかった構造を改めた。だが、仕様の1.0到達は実運用の1.0到達を意味しない。枯れた技術スタックで新しい課題を解くこの設計は、アクセス制御モデルの実装と成熟度という現実的な壁に直面している。
オブジェクトストレージによるメタデータ管理からの脱却
従来の主流なプラクティスでは、Apache Iceberg などのフォーマットはデータを書き込むたびに新しいスナップショットJSON、マニフェストリスト、マニフェストファイルを生成する必要があった。この静的なファイル管理メカニズムは、低頻度かつ大規模なバッチ処理では良好に機能する。しかし、高頻度で小規模な書き込みが続くワークロードでは、メタデータディレクトリ配下のファイル数が実際のデータファイル数を上回ってしまうことすら珍しくない。静的なテキストファイルを用いてオブジェクトストレージ上でトランザクション機構を模倣する手法は、規模の拡大に伴ってファイル一覧の取得(List操作)を遅延させ、API呼び出しコストを高騰させる要因となっていた。
DuckLake はこうした屋上屋を架す構造を廃し、システムを明確な3層構造へと切り分けた。最下層のストレージ(storage)は従来どおりオブジェクトストレージやローカルディスク上の Parquet ファイルであり、最上層のコンピュート(compute)はプラグイン可能な独立した状態を維持する。そして中間層に位置するカタログ(catalog)層に、PostgreSQL、SQLite、MySQL、さらには DuckDB 自身と互換性を持つ本格的なSQLデータベースを採用した。スキーマの変更履歴、パーティション情報、カラム統計情報をリレーショナルテーブル内に直接保持することで、クエリエンジンは最新のスナップショット状態を把握するために無数の小ファイルを探索する必要がなくなった。
メタデータをデータベース内のトランザクションとして直接書き込む設計は、Apache Polaris や Unity Catalog といった独立したRESTサービスを別途デプロイ・運用する負荷を解消する。Iceberg エコシステムでは、独立したカタログ操作が書き込みパイプラインのボトルネックとなり、設定を誤れば書き込み処理全体を失速させることがある。DuckLake のアプローチは、システムの性能制約をオブジェクトストレージのI/Oレイテンシから、エンジニアリングの世界で長年知見が蓄積されてきたデータベースの同時実行制御(トランザクション処理能力)の領域へと引き戻している。
リレーショナルテーブルが高頻度の小規模書き込みを吸収する
リアルタイムデータウェアハウスで日常的に発生する高頻度のデータ更新に対応するため、DuckLake は「データインライニング(data inlining)」機構を導入した。小規模な INSERT、UPDATE、DELETE 操作が発生した際、システムは直ちに基盤となる Parquet ファイルを書き換えるのではなく、まずはカタログデータベースへと直接データを書き込む。この設計は、断片化されたI/Oリクエストを効率的なデータベース内部の更新トランザクションへと変換し、小ファイル問題(Small Files Problem)の発生を根源から防ぐ。
データベース内に蓄積されたデータ量が設定した物理閾値に達して初めて、バックグラウンドのシステムプロセスが起動し、バッファされたデータをまとめて標準的な Parquet ファイルとしてフラッシュ・生成する。この遅延書き込み(deferred write)戦略により、小ファイルを整理するためだけに大量の計算資源を消費して頻繁にマージタスクを実行する必要がなくなる。同時にオブジェクトストレージとのネットワーク転送や読み取りコストも大幅に削減され、高並行な読み書き性能を維持しながら、基底データブロックの物理的な連続性を担保できる。
小規模書き込みのバッファリングに加え、DuckLake は基盤データのスキャン時にソートキー(sorting key)の指定をサポートしている。その後のファイルコンパクション処理においても、エンジンは事前に指定された物理的な並び順を厳格に保持する。基底のデータファイルが整列されていることで、クエリエンジンは範囲プルーニングやフィルタープッシュダウンを直截に活用でき、データスキャンの段階で不要なストレージブロックを正確にスキップできる。
極めてシンプルな仕様がもたらす多様な計算エンジンの接続性
DuckLake は自身を開かれた技術仕様として位置づけており、GitHub リポジトリにはすでに 3.2k を超える Star が集まっている。商用ベンダーの MotherDuck がバックアップに入り、無償の解説ハンドブックも提供されている。公式ブログの記事では、仕様のロジックが極めて明快であるため、コード生成LLMであってもドキュメントを参照するだけで DataFrames 向けの互換実装を即座に作成できると率直に語られている。システムの複雑さを一人のエンジニアが単独で再現できる水準にまで抑え込むことは、新しい仕様が立ち上げ期にエコシステム内の開発者を惹きつける強力な戦略となる。
 図:仕様が十分にシンプルなため、LLMでもDataFrames向けの互換実装を容易に作成できる。出典:DuckLake公式サイト ブログカード画像
仕様とエンジンの疎結合設計により、この標準は DuckDB に過度に縛られることがない。対象の計算エンジンがリレーショナルメタデータと基盤となる Parquet 形式を理解できる限り、Trino や Apache Spark といった主要なデータ分析フレームワークも計算層として自在に接続できる。Apache DataFusion のオープンソースエコシステムでは、有志の開発者がすでに Rust 言語を用いた専用のレイクハウスクライアントを実装している。
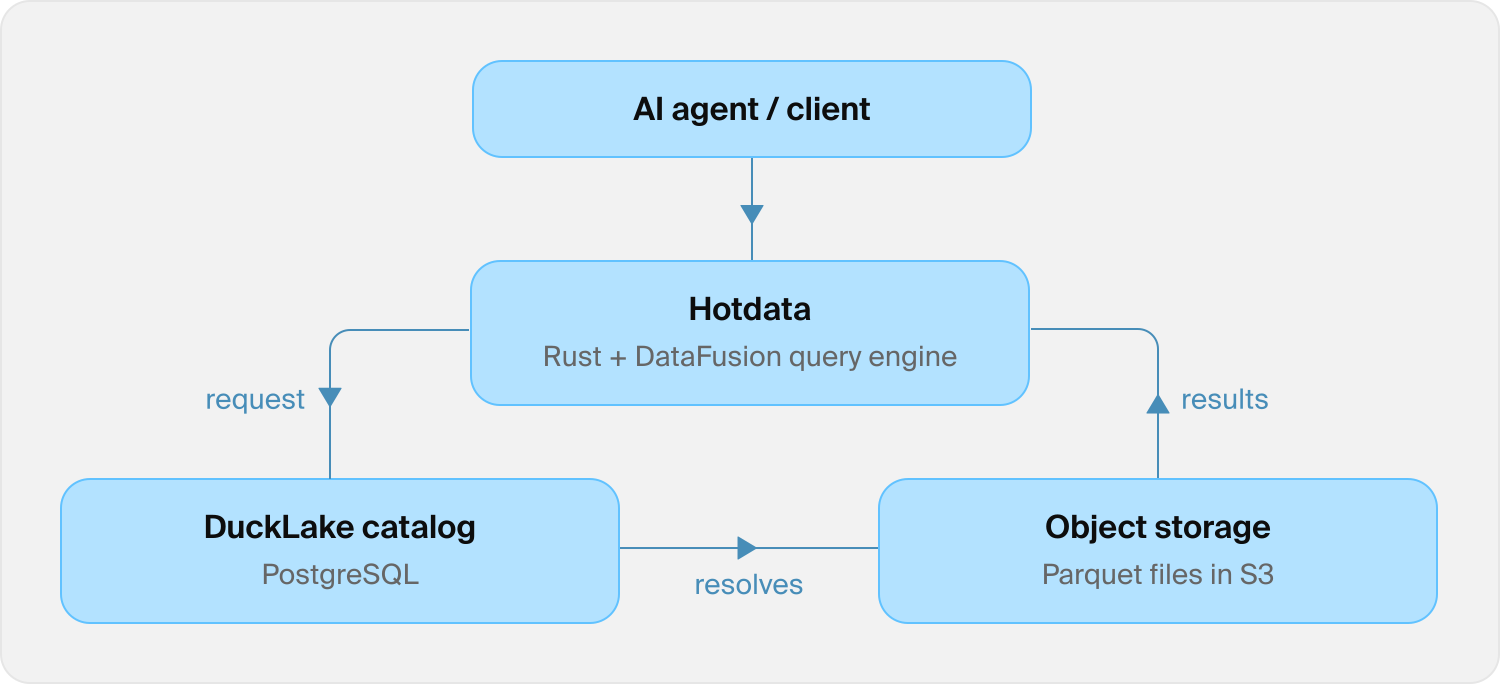 図:DataFusionエコシステムにおけるDuckLakeクライアントのアーキテクチャ概要。出典:DuckLake公式サイト ブログカード画像
このコミュニティ主導で開発されたクライアントは、バックエンドのメタデータストレージとして PostgreSQL を利用している。プロジェクトの主導者によれば、極めて高い同時リクエスト負荷に直面した場合でも、この軽量なアーキテクチャは1秒未満のサブセカンド級のクエリ応答時間を安定して記録しており、以前チームが特定用途向けに構築した独自メタデータシステムと比べても遜色ない性能を発揮しているという。これは、複雑なカタログ管理を実績あるリレーショナルデータベースに委譲することが、多並行な読み取り環境において確かな実用価値を持つことを実証している。
仕様のバージョンアップでは隠せないアクセス制御の未熟さ
仕様の1.0版はMITライセンスのもとで後方互換性を保証してリリースされたものの、コミュニティにおける検証では導入に向けた技術的な摩擦も散見されている。エンジニアからの報告によると、v1.5.4 の運用においてカタログフィルタリング後にレコード数が狂う不具合が発生した。さらにその修正を取り込むために main ブランチへと切り替えたところ、DuckDB 内蔵のSQLパーサーの処理性能が最大10倍も低下するという深刻なリグレッションが確認された。バージョン間でこうした挙動の揺らぎが見られる現状では、ミッションクリティカルな業務システムへ導入する前に綿密な境界テストとストレステストが不可欠となる。
技術コミュニティの議論が集中している最大の懸念点は、アクセス制御(認可)モデルの貧弱さだ。現行バージョンの権限管理は極めて大雑把であり、ストレージバケット単位でのアクセス許可または拒否しか設定できない。エンタープライズ領域で必須とされるカラムレベルのアクセス制御(CLAC)や行レベルセキュリティ(RLS)、さらにはデータマスキング機能はシステム全体として未対応のままだ。こうした防御機構が欠如した状態は、防壁のない貯水池のようなものだ。
きめ細かなセキュリティ層を持たないレイクハウスアーキテクチャは、実際のエンタープライズ分析の現場では容易に受け入れられない。組織間での厳格なデータ隔離が実現できない現段階において、この仕様が真価を発揮するのは単一チームが管理する社内検証用サンドボックスなどに限られ、厳格なマルチテナントが求められる本番データ基盤を直接担うにはまだ時期尚早と言わざるを得ない。
フォーマット競争はトランザクションとストレージ設計の本質へ回帰する
互換性の面において、DuckLake は複数テーブルにまたがるACIDトランザクション制御や過去スナップショットへのタイムトラベルクエリをサポートしている。基盤に採用された削除ベクター(deletion vectors)機構は、ファイル形式レベルで Apache Iceberg と直接互換性を持つ設計が選ばれた。これにより、行単位のデータ削除要求が発生した際にも巨大な Parquet ブロックを即座に書き換える必要がない。削除命令が出された時点ではベクターテーブル上にツームストーン(墓標)フラグを記録するにとどめ、計算負荷の高い物理的なデータ消去を後回しにすることで、クラスタのピーク負荷を効果的に平滑化している。
コアコードをなぜ流行りの最新言語で書き直さなかったのかというコミュニティの議論に対し、開発チームの回答は一貫して実用主義的だ。DuckDB 自体が2018年のプロジェクト創設以来 C++ で構築されてきたため、派生規格であるレイクハウス管理仕様もその基盤技術を自然に踏襲している。この言語選択は、全面的なリライトに伴うコードの断絶を回避し、実行エンジンの処理順序の一貫性とシステムの安定性を堅持するための合理的な判断といえる。
データレイクハウスフォーマットの進化において真に求められているのは、目新しいバズワードの導入ではない。複雑なデータスナップショットの状態管理とトランザクション機構を、何十年もの実績を持つリレーショナルデータベースに回帰させたことは、DuckLake チームによる極めて実利的なトレードオフだ。この構造転換によって高並行なメタデータ処理能力を手に入れた代償として、きめ細かなファイル権限管理は当面の間棚上げされた。外見のマーケティング競争が一巡したとき、データプラットフォームの真価を分けるのは、基盤の一貫性とセキュリティの粒度という最も基礎的なソフトウェアの力量に他ならない。
参考リンク:
- DuckLake GitHub リポジトリ
- DuckLake 公式サイト / アナウンス
- Hacker News コミュニティディスカッション