Le 7 octobre 2026, un billet de blog intitulé « Why Industry Is Not Panicking Over DeepSeek 4.1 Flash » a commencé à circuler au sein de la communauté des développeurs. Son auteur, jonotime, y avançait un chiffre défiant l’entendement : après un mois d’utilisation intensive du modèle chinois à travers plus d’une dizaine de projets de développement complexes, sa facture finale s’élevait à moins d’un dollar américain. Dans une industrie habituée à des abonnements mensuels de plusieurs dizaines de dollars par utilisateur, une dépense inférieure à un dollar détonne fortement. Quand le coût unitaire du calcul chute à ce niveau, ce n’est plus seulement la facture de fin de mois qui change, mais l’habitude historique d’attribuer des tâches aux machines.
Déléguer jusqu’au rangement du bureau à l’intelligence artificielle
L’auteur y confie sans détour son retour d’expérience. Tout au long d’un mois de travail intense, lorsqu’il ne vérifiait pas le nom du modèle affiché dans le coin supérieur droit de son écran en plein fil de discussion, il avoue qu’il était incapable de faire la différence entre l’onéreux Claude Opus et le dérisoire DeepSeek 4.1 Flash. Fluidité du dialogue, précision dans l’exécution des consignes et rapidité de réponse : au quotidien, aucun fossé perceptible n’est apparu. Ce témoignage fait voler en éclats le postulat implicite du monde technologique, selon lequel il faudrait nécessairement payer le prix fort pour les modèles de pointe afin d’obtenir un travail de premier ordre.
La grille tarifaire dévoile le secret de cet effondrement des coûts. En heures creuses, DeepSeek facture 0,15 dollar par million de tokens en entrée et 0,60 dollar en sortie. Mais le véritable tournant réside dans le tarif en cas de succès de cache (cache hit), qui s’écroule à 0,003 dollar par million de tokens. Un million de tokens représente environ l’équivalent de deux romans ; traiter une telle masse textuelle coûte désormais moins cher qu’un bonbon. Une telle tarification transforme en réalité des usages qui semblaient jusqu’alors inconcevables.
Auparavant, les développeurs hésitaient à confier des besognes triviales et sans réflexion à une IA, chaque prompt consommant du temps de calcul. Désormais, l’auteur délègue sans le moindre scrupule des corvées aussi insignifiantes que le tri et le rangement des fichiers encombrant son bureau virtuel. Dépenser 0,003 dollar pour s’épargner cinq minutes de manipulations manuelles devient, pour la première fois, parfaitement rationnel sur le plan économique. Laisser un script d’automatisation tourner toute la journée en arrière-plan pour procéder par tâtonnements successifs n’est plus un luxe nécessitant des calculs d’apothicaire.
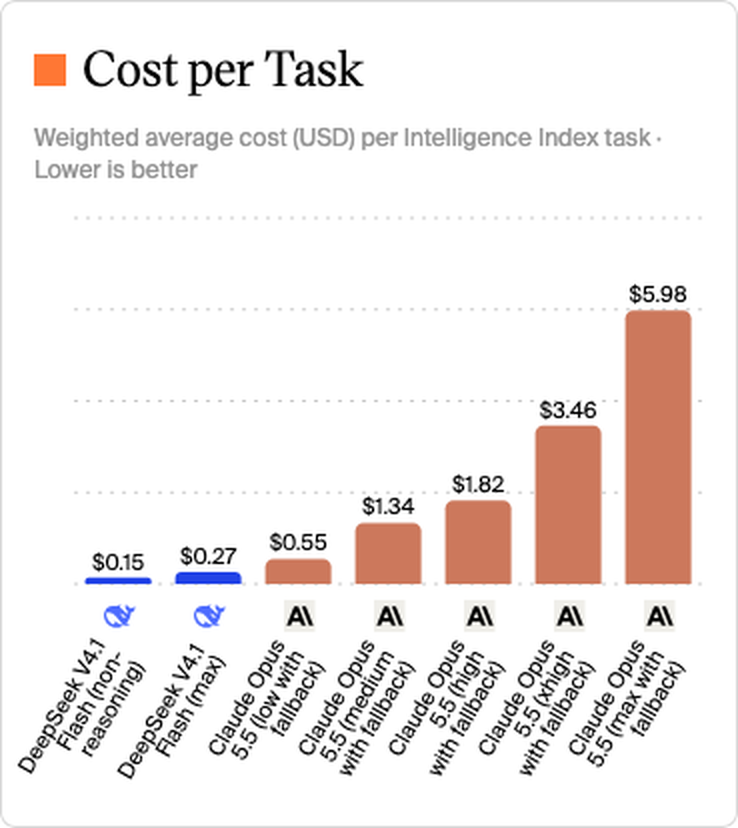 Figure : Estimation comparative des coûts par tâche selon les modèles. Source : blog dgt.is
Réduire la mémoire de calcul redondante par 437
Si les tarifs ont pu plonger de manière aussi spectaculaire, c’est avant tout parce que l’équipe d’ingénierie a éradiqué les redondances de calcul au niveau architectural. Les ingénieurs ont réussi à compresser l’espace de cache alloué à la mémoire de contexte (l’empreinte du KV cache) d’un facteur d’environ 437 par rapport à leur architecture de première génération. Cet écart d’un ordre de grandeur supérieur à 400 constitue le levier technique fondamental déterminant si l’intelligence artificielle peut devenir une infrastructure abordable et universelle.
On peut comparer un grand modèle de langage à un assistant doué d’une vitesse de lecture fulgurante mais doté d’une mémoire quasi inexistante. Jusqu’à présent, à chaque question de suivi dans une conversation, l’assistant devait relire l’intégralité des échanges précédents depuis le début pour saisir la consigne en cours. Cette relecture perpétuelle dévorait une quantité astronomique de mémoire vidéo (VRAM) sur des cartes graphiques hors de prix, constituant le principal gouffre financier des contextes longs.
La solution a consisté à apprendre à cet assistant à tenir des notes ultracompactes. Le système compresse les informations déjà traitées en fragments mnésiques minuscules, conservés durablement dans la mémoire du GPU. Dès qu’une requête ultérieure partage les mêmes conditions préalables, il mobilise directement ces notes compressées, sautant purement et simplement l’étape de relecture énergivore et gourmande en ressources. Cette optimisation d’ingénierie s’est traduite sur-le-champ par une baisse vertigineuse des prix de l’API.
 Figure : Écart d’ordres de grandeur entre les trois paliers tarifaires de DeepSeek ; le tarif en cas de succès de cache est presque invisible sur le graphique. Source : analyse des prix de Mercatus AI
L’hébergement sur ses propres machines devient un non-sens économique
Lorsque le coût des services cloud s’effondre à une fraction de centime, les équilibres économiques des déploiements matériels locaux vacillent. Ces dernières années, de nombreuses PME et développeurs indépendants ont investi massivement dans des GPU et des serveurs sur site, dans l’espoir d’échapper aux factures salées de la consommation à l’usage dans le cloud. L’idée était d’amortir la dépense initiale en faisant tourner les machines sans discontinuer.
Face à cette nouvelle donne tarifaire, acheter du matériel pour faire des économies vire à la fausse bonne idée financière, sans espoir d’amortissement. Avec un barème de 0,003 dollar par million de tokens, une entreprise devrait faire tourner ses serveurs à plein régime pendant des années entières rien que pour compenser l’acompte initial d’un seul GPU d’entreprise haut de gamme. Le matériel coûteux subit l’obsolescence et la dépréciation bien plus vite que le coût du calcul cloud ne diminue.
Le dernier rempart justifiant le déploiement local reposait sur la confidentialité des données privées — et même ce bastion commence à s’effriter. Les techniques de compression réduisant l’empreinte mémoire par plusieurs centaines se diffusent à grande vitesse au sein de la communauté open source. D’ici peu, un ordinateur grand public ordinaire sera capable d’exécuter avec fluidité des architectures complexes qui requéraient jadis des fermes entières de serveurs dédiés.
Un tarif de 0,003 dollar qui ne se concrétise que sur des tâches ciblées
Un tarif dérisoire au token ne signifie pas pour autant que la résolution de n’importe quelle tâche devienne bon marché : c’est là un piège logique dans lequel tombent bien des observateurs. Lors d’échanges au sein de la communauté technique, un ingénieur à la tête d’un nouveau projet de compilateur a partagé ses résultats de banc d’essai. Il avait initialement placé DeepSeek 4.1 Flash au poste d’orchestrateur en chef, chargé de planifier le projet et de décomposer les modules d’architecture.
Le résultat s’est soldé par une dégradation brutale de la qualité. Confronté à des arbitrages complexes, le système low-cost omettait fréquemment des dépendances de contexte cruciales, échafaudant sans discussion préalable des architectures logiques bancales. De plus, la documentation générée s’est révélée prolixe et hors sujet. L’ingénieur a fini par restituer le rôle de chef d’orchestre au modèle de pointe onéreux, ne confiant au modèle économique que l’implémentation de portions de code aux spécifications chirurgicales et aux périmètres stricts. Ce dernier excelle à poser des briques, mais s’avère incapable d’en concevoir le plan d’architecte.
Une autre évaluation baptisée « Pac-Man » a mis en lumière une réalité plus implacable encore. Sur un projet complexe strictement identique, le modèle de pointe prestigieux a bouclé l’exécution en 9,3 minutes, pour un coût de 1,99 dollar et un score remarquable de 99. En miroir, le modèle abordable a terminé en 2,8 minutes pour 1,89 dollar, mais n’a décroché qu’une note de 72. L’écart financier global n’était que de dix centimes (0,10 dollar), alors que le degré d’achèvement présentait un gouffre. L’avantage du tarif unitaire à 0,003 dollar s’est évaporé sitôt la nature de la tâche modifiée.
Cela a ouvert un autre axe de débat : un intervenant a calculé qu’en fonction de la précision numérique retenue, faire tourner de grands modèles de pointe exige entre 416 Go et 1 664 Go de mémoire vive. Or, l’industrie des puces mémoire a été condamnée à plusieurs reprises par le passé pour des ententes illicites sur les prix. Le coût prohibitif du matériel mémoire demeure un obstacle colossal à la démocratisation du calcul. La bataille pour abaisser les coûts est loin de ne concerner que les concepteurs d’algorithmes.
L’effondrement des coûts de calcul déplace le centre de gravité des usages
En assemblant ces observations, une cartographie lucide de l’économie du calcul se dessine. Les prix planchers ne se vérifient que dans des contextes fortement tributaires d’un taux élevé de succès de cache. Dès lors que la tâche impose une déduction exploratoire, un raisonnement inédit ou une planification autonome, l’avantage du coût unitaire est instantanément balayé par de faibles taux de réussite et le temps perdu en itérations stériles.
Cela éclaire certains comportements paradoxaux observés dans le secteur : certaines entreprises préfèrent accumuler des abonnements de premier rang auprès de multiples fournisseurs et bâtir des répartiteurs de charge complexes plutôt que de refondre leur architecture logicielle. Et lorsque leurs quotas prioritaires sont épuisés, elles se répandent sur les réseaux sociaux pour déplorer la pénurie de calcul. Cela illustre un profond décalage dans la compréhension des usages opportuns du calcul à bas coût.
La portée historique de DeepSeek 4.1 Flash ne réside pas dans sa capacité à supplanter les modèles les plus sophistiqués sur les frontières de la recherche scientifique. En comprimant l’empreinte de la mémoire de contexte par plusieurs centaines, il a ouvert un champ d’application totalement inédit : l’idée d’une « corvée de faible valeur ne méritant pas qu’on mobilise une IA » a tout simplement disparu sur le plan comptable. Un token bon marché ne garantit pas une tâche bon marché ; dès lors qu’on exige d’un modèle abordable une conception architecturale hors de sa portée, la facture des tâtonnements finira par flamber. La prochaine fois que nous serons confrontés à des tarifs de quelques centièmes de centime, la question primordiale ne sera plus de savoir combien cela coûte, mais quelle nature de tâche nous lui confions.
Liens de référence :
- Why Industry Is Not Panicking Over DeepSeek 4.1 Flash
- Discussion sur Hacker News : tests pratiques sur un nouveau projet de compilateur
- Rapport d’analyse tarifaire de Mercatus AI