Une équipe conjointe de chercheurs de l’Université Duke, de l’Université de l’Illinois à Urbana-Champaign (UIUC) et de l’Université Harvard a propulsé un modèle miniature d’à peine 1,8 million de paramètres sur le terrain exigeant du raisonnement algorithmique. Sur le benchmark Sudoku-Extreme, réputé pour sa difficulté extrême, ce modèle compact a atteint un taux de réussite de 99,9 % lors des tests, tout en ne consommant qu’un trois-cent-quarante-cinquième du budget de calcul requis par ses meilleurs concurrents.
Intitulée Energy-Based Reasoners, cette recherche a été publiée sur arXiv (article 2611.08977) par William Xingxu Chen, Alexi Gladstone, Zeyu Michael Li, Heng Ji et Yilun Du. Plutôt que de suivre la trajectoire habituelle consistant à empiler des paramètres pour forcer l’émergence du raisonnement, l’équipe a muni la boucle de déduction d’un repère de progression explicite, permettant au réseau d’évaluer de manière autonome la pertinence de ses états latents intermédiaires.
Le raisonnement récurrent conventionnel : un sprint à l’aveugle sans ligne d’arrivée
Dans la recherche contemporaine sur le raisonnement algorithmique, les modèles récurrents en boucle (Looped Reasoning Models) suscitent un vif intérêt. Au lieu d’empiler des dizaines de couches de transformeurs, ces architectures exécutent le même bloc de réseau compact de manière itérative. Le réseau affine pas à pas un « état latent » (un vecteur de haute dimension consignant les étapes internes du raisonnement). L’hypothèse de départ est simple : accorder davantage de cycles de calcul au modèle permettrait à la chaîne logique de s’ajuster progressivement.
Cependant, les modèles actuels présentent une limite majeure : durant leur processus de déduction interne, ils sont totalement dépourvus d’indicateur permettant de mesurer la qualité de l’état atteint. Le modèle fonctionne de façon mécanique sur un nombre fixe d’itérations prédéfini. Il ne sait ni à quelle distance il se trouve de la solution exacte, ni si ses ajustements intermédiaires sont en train de diverger.
Ce mécanisme s’apparente à faire courir les yeux bandés un individu dans un labyrinthe. Si la consigne lui impose de courir exactement trente pas avant de livrer son résultat, il s’élancera sans pouvoir s’arrêter, même s’il a effleuré la sortie dès le dixième pas. À l’inverse, s’il s’est engagé dans une impasse dès le troisième pas, il continuera à tourner en rond jusqu’au bout. Multiplier les itérations sans évaluer l’état intermédiaire revient, au fond, à brûler de la puissance de calcul en espérant un coup de chance.
L’absence d’échelle d’évaluation entraîne un gaspillage massif de ressources de calcul. Afin de garantir la résolution des cas difficiles, les concepteurs paramètrent un nombre élevé d’itérations. Pour les problèmes simples déjà résolus, la machine tourne à vide ; pour les problèmes complexes qui dévient d’emblée, l’intégralité des calculs ultérieurs se transforme en coûts irrécupérables.
Apprendre une fonction d’énergie : descendre le gradient vers la solution
L’équipe de recherche a profondément remanié cette dynamique en introduisant une fonction d’énergie définie sur l’état latent du raisonnement. En physique statistique et en apprentissage automatique, la valeur d’énergie quantifie le degré d’instabilité ou d’incohérence d’un système. Ici, elle évalue l’adéquation entre le problème posé et l’état latent courant : plus la cohérence est élevée, plus l’énergie est basse.
Grâce à cette fonction d’énergie, le cheminement invisible de la pensée bénéficie d’une carte topographique. Chaque mise à jour de l’état latent est formulée mathématiquement comme une avancée dans la direction du gradient négatif. Le gradient négatif pointe précisément vers la pente de descente d’énergie la plus abrupte, à l’image d’une boussole orientée en permanence vers le fond de la vallée. L’énergie attribue une note de qualité à l’état, tandis que le gradient indique la direction d’amélioration.
Le mécanisme le plus décisif réside dans le critère de convergence. Dès que le raisonnement s’approche de la solution exacte, le relief énergétique local s’aplanit et la norme du gradient diminue drastiquement. Dès que cette norme passe sous un seuil déterminé, le modèle juge qu’une solution stable a été atteinte et interrompt immédiatement ses calculs.
Problème d'entrée x ───> Estimation initiale z₀ ───> Calcul de l'énergie E(z; x) et du gradient ∇z E
                                                                   │
                               ┌───────────────────────────────────┘
                               ▼
               Mise à jour de z selon -∇z E ───> La norme du gradient est-elle < Seuil ?
                               │                                    │
                              Non                                  Oui
                               │                                    ▼
                               └───────────────> Émission de la solution et arrêt du calcul
Pour éviter que le relief énergétique ne présente de faux minima locaux, les chercheurs ont intégré un entraînement contrastif exploratoire. La procédure échantillonne largement l’espace d’états, augmentant délibérément l’énergie des configurations erronées et abaissant au maximum celle des solutions exactes. Le paysage topographique devient ainsi lisse et bien ordonné. Face à des problèmes admettant plusieurs solutions valides, le modèle est en mesure de sélectionner le candidat situé dans la vallée d’énergie la plus basse.
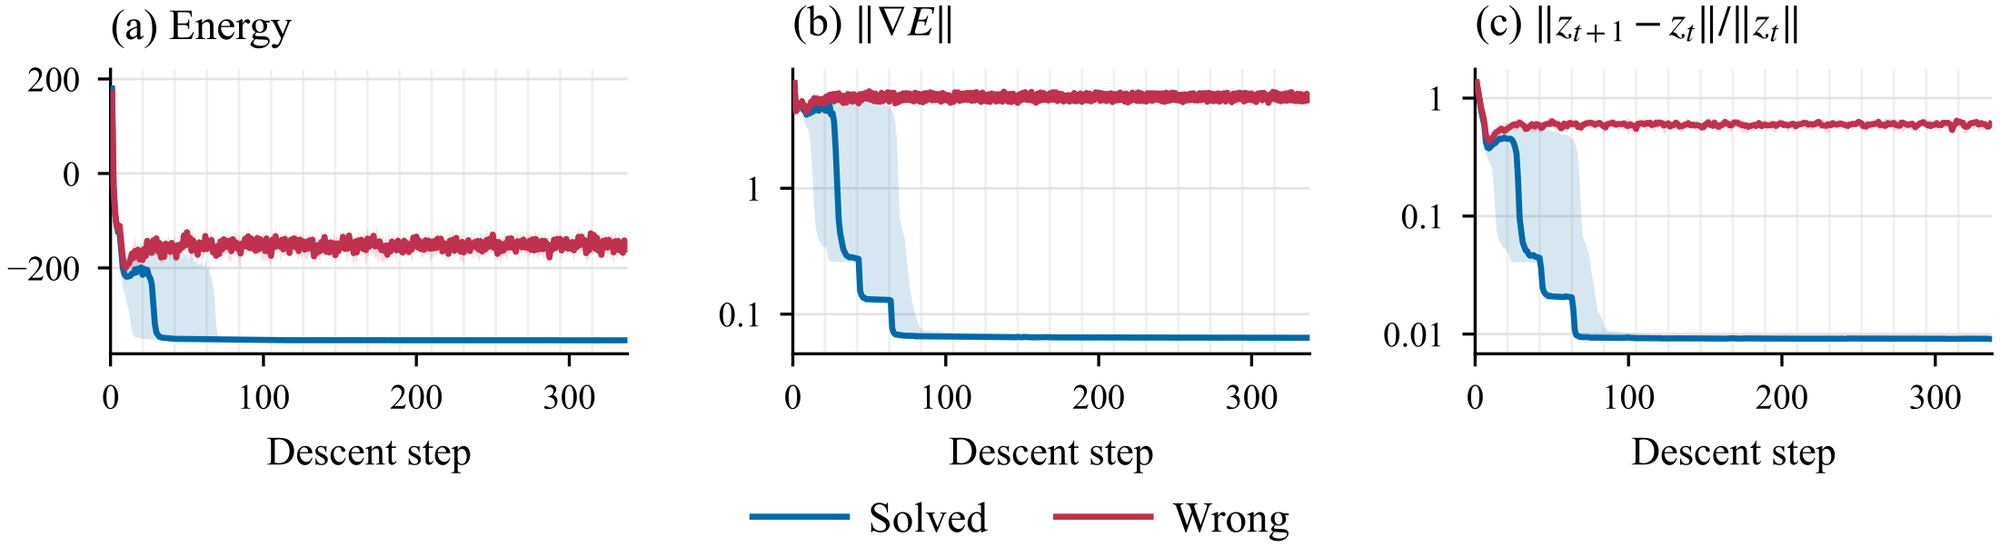 Figure : Trajectoires de la valeur d’énergie, de la norme du gradient et des résidus au cours de la résolution. Les trajectoires menant à la solution exacte convergent très vite vers un état stable de basse énergie, tandis que les trajectoires erronées oscillent continuellement sans jamais atteindre zéro. Source : Page du projet Energy-Based Reasoners.
Les courbes de convergence empiriques illustrent nettement cet écart de conception. Pour les résolutions exactes, l’énergie et la norme du gradient plongent en un très petit nombre d’étapes pour se stabiliser à des niveaux minimaux. En revanche, les trajectoires erronées errent indéfiniment, la norme du gradient oscillant violemment à un niveau élevé, signal infaillible que le raisonnement a dévié.
1,8 million de paramètres surclassent des rivaux bien plus grands : l’arrêt adaptatif divise le calcul par 345
Guidé par une direction claire et muni d’un frein automatique, ce modèle compact a fait la démonstration d’une supériorité remarquable. Sur le benchmark Sudoku-Extreme, conçu pour éprouver les limites de la déduction logique, le modèle à base d’énergie ne compte que 1,8 million de paramètres. Les modèles comparés mobilisent généralement entre 5 et 7 millions de paramètres, certains atteignant 10 millions.
Lors d’une inférence à échantillon unique, le modèle a atteint une précision de 99,4 %. Les architectures de référence sont restées nettement en retrait : TRM s’est établi à 87,4 %, EqR à 93,0 %, FPRM à 94,2 %, GRAM à 86,6 %, et la meilleure d’entre elles, Looped Flows, a plafonné à 97,9 %. En étendant l’échantillonnage à 5 candidats, la précision du modèle à énergie est montée à 99,9 %. À titre de comparaison, le modèle phare précédent, EqR, devait générer 128 échantillons pour seulement approcher les 99,8 %.
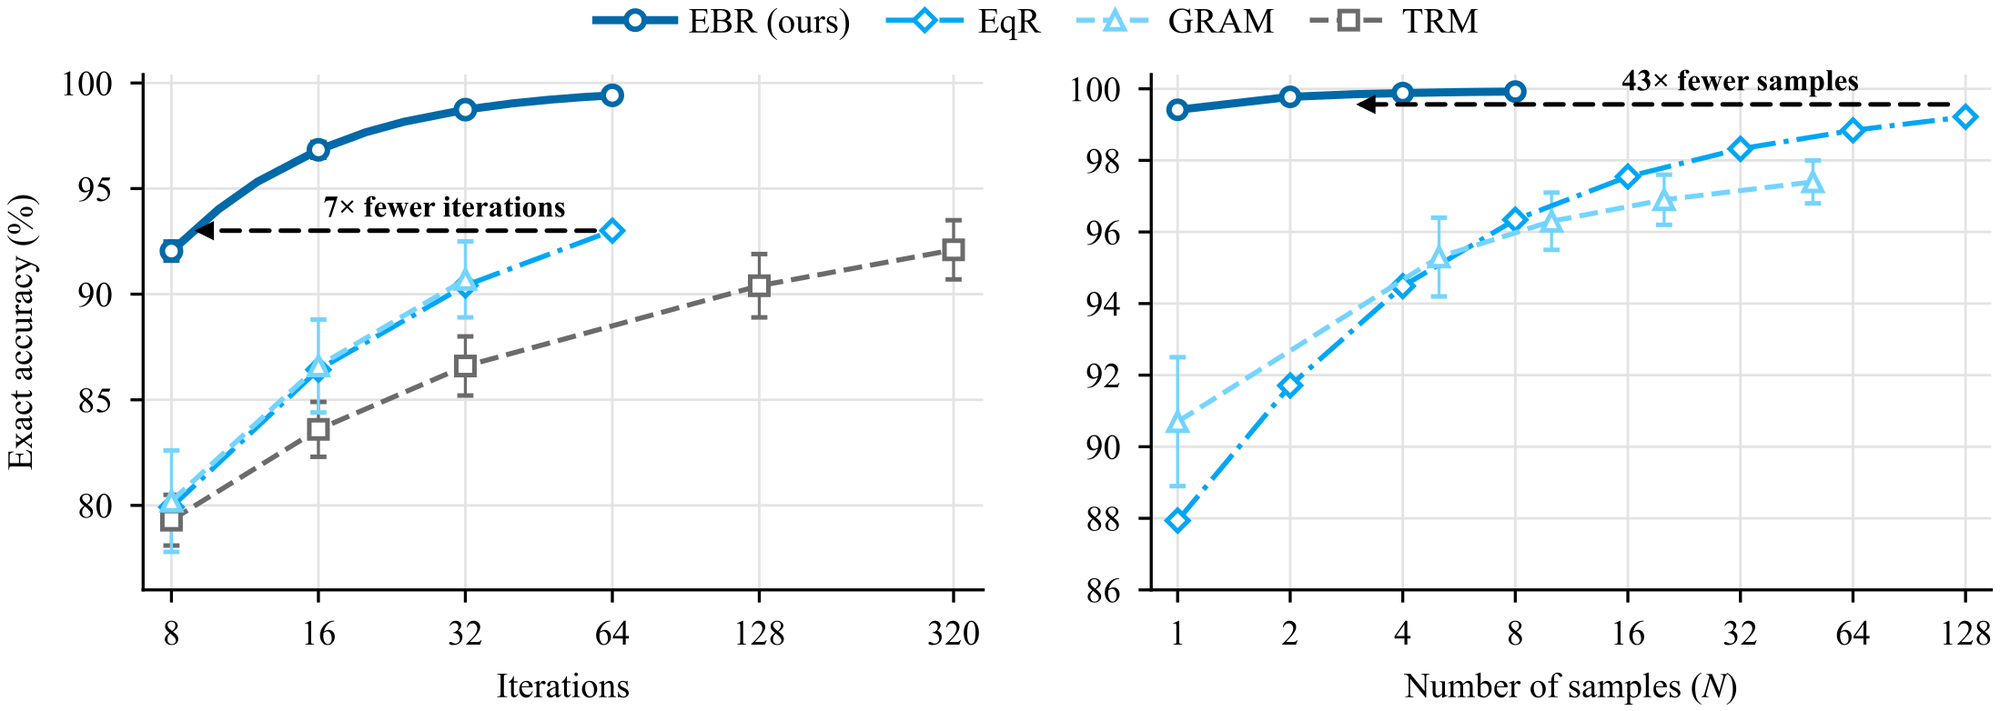 Figure : Comparaison de la précision sur Sudoku-Extreme selon le nombre d’itérations et d’échantillons générés. Le modèle dépasse avec seulement 5 échantillons les performances obtenues par ses concurrents avec 128 échantillons. Source : Page du projet Energy-Based Reasoners.
L’écart en matière de calcul est encore plus spectaculaire. Les modèles traditionnels maintiennent une charge constante en déroulant une profondeur fixe de calcul ; le modèle à énergie freine de manière adaptative dès que la norme du gradient s’atténue, concluant le calcul aussitôt la solution trouvée. Par rapport à sa propre déclinaison à profondeur fixe, l’arrêt adaptatif économise un facteur 10,9 d’opérations en virgule flottante (FLOPs). Face à la référence EqR, le gain d’efficacité globale s’élève à un facteur 345. Arrêter l’effort dès qu’une solution est découverte permet de réduire drastiquement une dépense de calcul jusqu’alors démesurée.
Dans la dimension du passage à l’échelle au moment du test (Test-time Scaling), la nouvelle architecture brille tout autant : pour égaler le meilleur score de ses concurrents, le modèle requiert 7 fois moins d’itérations et réduit le volume d’échantillons nécessaires d’un facteur 43.
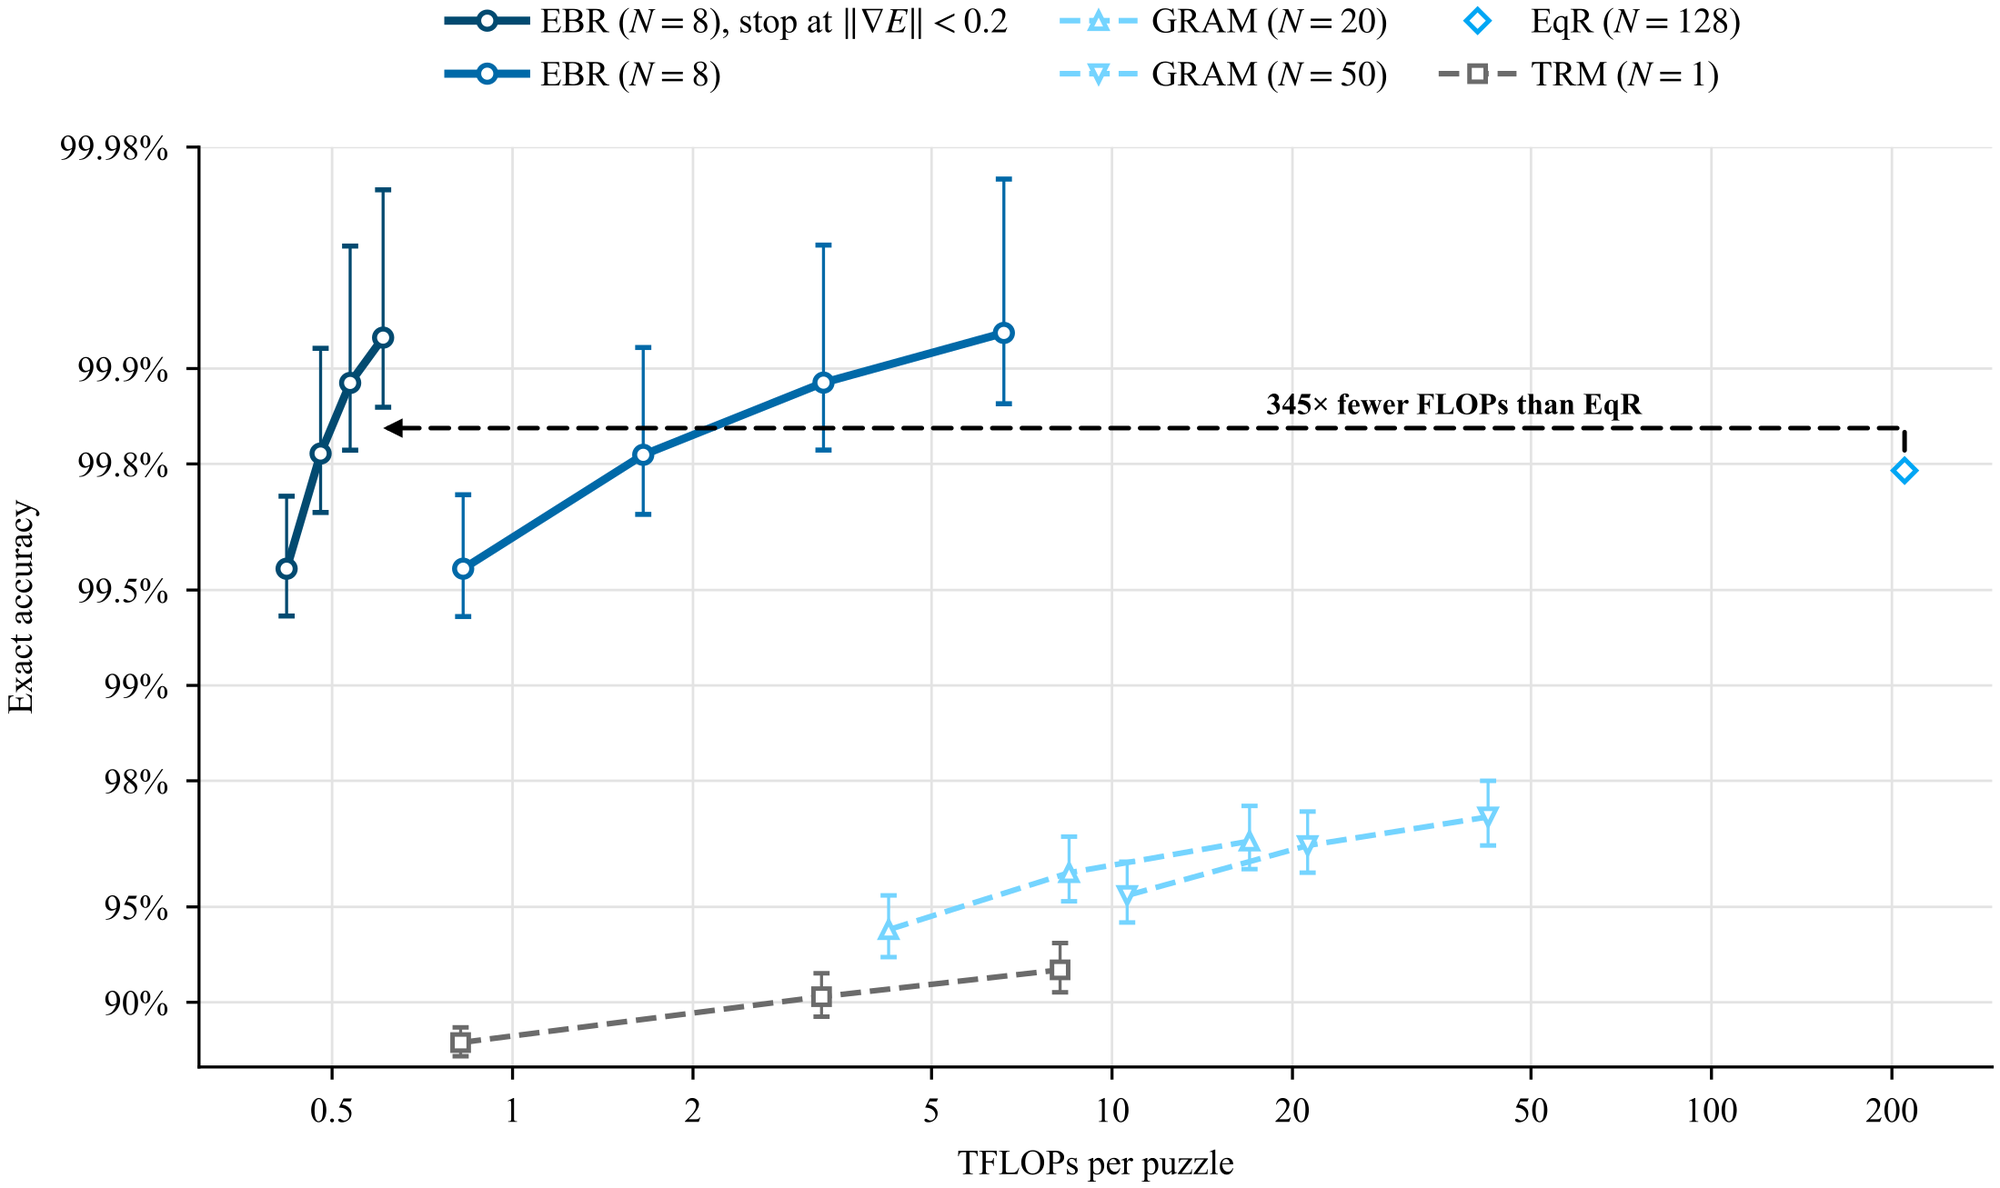 Figure : Corrélation entre la précision sur Sudoku-Extreme et le coût de calcul par problème. Le mécanisme d’arrêt adaptatif supprime les itérations superflues tout en préservant une exactitude maximale, offrant un avantage computationnel de 345x. Source : Page du projet Energy-Based Reasoners.
Face à des problèmes comportant plusieurs solutions légales, cette capacité de recherche ciblée demeure redoutable. Dans l’extension 10×10 du problème des huit dames (N-Queens), le taux de succès au premier échantillon a atteint 99,5 %, contre 89,7 % pour GRAM et seulement 17,5 % pour TRM. Sur les problèmes de coloration de graphes à 8 et 10 sommets, les conflits de contraintes sont tombés à zéro. Sur la diversité des solutions au sein de 20 échantillons, le modèle a atteint une couverture de 98,1 %, conservant une avance insolente.
Les domaines algorithmiques stricts : noter les états intermédiaires surpasse la taille brute
Le domaine d’excellence de cette architecture repose sur un cadre précis. Le sudoku, le problème des huit dames, les labyrinthes et la coloration de graphes sont des problèmes purement algorithmiques. Ils partagent deux caractéristiques clés : des règles sans ambiguïté et des programmes de vérification (Verifiers) au coût presque nul. Dans les tâches de recherche où vérifier la justesse d’une solution ne coûte presque rien, noter les états intermédiaires s’avère infiniment plus fructueux que d’empiler aveuglément des paramètres.
Cette avancée ne signifie pas pour autant qu’un petit réseau puisse immédiatement se substituer aux grands modèles de langage (LLM). Les tâches en langage naturel ouvert nécessitent une vaste culture générale, et le texte non structuré ne dispose pas d’une fonction analytique d’énergie permettant de calculer des gradients directs. Les auteurs restent prudents, soulignant que les modèles à énergie ouvrent une voie prometteuse pour le raisonnement logique discret, sans prétendre couvrir d’emblée la totalité des scénarios généralistes.
La communauté technique observe ces développements avec attention. Des équipes proches de chercheurs comme Yann LeCun explorent des voies similaires fondées sur l’énergie, cherchant précisément à pallier les carences des modèles de langage dans la déduction logique discrète.
Les échanges en ligne ont également porté sur l’exclusion des environnements de code externes lors de l’évaluation. Les auteurs ont précisé que les grands modèles ont tendance à contourner l’effort de déduction sur les problèmes algorithmiques en générant des scripts de recherche par force brute délégués à un interpréteur Python. Interdire l’exécution de code garantit que seule la capacité de raisonnement interne des représentations du réseau est mesurée.
Sur un ton plus léger, la communauté a plaisanté sur l’accès restreint à la démonstration interactive du site, protégée par une identification, ironisant gentiment sur les artifices de mise en scène de la recherche de pointe.
Déterminer la direction avant d’avancer : le raisonnement logique s’émancipe de la force brute
Ces dernières années, l’industrie a misé sans réserve sur l’expansion de la taille des modèles pour conquérir l’intelligence. Pourtant, confrontés à une déduction logique complexe, les modèles dépourvus de boussole finissent fréquemment par s’égarer.
Les travaux sur les Energy-Based Reasoners ouvrent une perspective féconde : la clé d’un raisonnement affûté réside dans l’aptitude d’un système à évaluer sa propre progression. Muni d’une échelle d’énergie explicite, un modèle miniature de 1,8 million de paramètres peut suivre le gradient et résoudre des énigmes complexes avec une efficacité inédite.
De l’itération mécanique et aveugle vers une descente d’énergie maîtrisée : le raisonnement logique est en train de trouver une voie bien plus sobre et élégante.
Liens de référence :
- Page du projet Energy-Based Reasoners
- Article arXiv (2611.08977)
- Discussion sur Hacker News