杜克大学、伊利诺伊大学香槟分校与哈佛大学的研究团队,把一个参数量仅 180 万的微型模型推上了高难算法赛场。在业内公认高难度的数独基准 Sudoku-Extreme 上,这个小模型取得了 99.9% 的测试准确率。解开同一道题目,它消耗的计算量只有同类顶尖对手的三百四十五分之一。
这项名为 Energy-Based Reasoners 的研究发表在 arXiv(论文编号 2611.08977)。作者包含 William Xingxu Chen、Alexi Gladstone、Zeyu Michael Li、Heng Ji 与 Yilun Du。他们避开了靠堆砌参数换取能力的常规路线。团队给推演过程配上了一套进度标尺,让模型能自主评估中间状态。
传统循环推理像蒙眼长跑,走到终点也浑然不知
在目前的算法推理研究中,循环推理架构(Looped Reasoning Models)备受关注。这类模型不靠堆叠网络层数,而是让同一个网络块反复循环运行。网络在一个隐藏状态(Latent State,即模型内部记录推理线索的高维向量)上持续推演。设计者的设想很直接:只要让模型多推演几轮,逻辑链条就会逐步理顺。
现实中的循环推理模型存在明显缺陷。它们在内部推演时,缺少对当前状态优劣的评估指标。模型只能按照预设的固定步数机械运转。它不知道当前推导离正确答案有多远,也无法判断当前修改是否走偏。
这种机制就像让解题者蒙上双眼在迷宫里长跑。系统规定跑满三十步交卷,解题者就只能闷头前冲;即使第十步已经摸到了出口,模型也停不下来。就算第三步就误入死胡同,模型也只能在死胡同里继续兜圈。缺乏状态评估的反复迭代,本质上是用算力碰运气。
缺少反馈标尺还会带来严重的计算浪费。为了确保复杂题目能够解开,工程师通常把循环步数设得很高。简单的题目早已得出结论,算力却在继续空转。复杂的题目中途走入误区,后续所有计算步骤都成了沉没成本。
学一个能量函数,顺着梯度找到正解
研究团队改变了这种推演机制。他们给模型引入了一个定义在潜在推理状态上的能量函数。在统计物理与机器学习中,能量值常用于衡量系统的不稳定程度。在这里,能量函数用来打分:评估输入的题目与当前的隐状态是否吻合,吻合度越高,数值就越低。
有了这个能量函数,不可见的思考过程有了地形图。隐状态的每一次更新,都被设计为顺着负梯度方向迈进的数学过程。负梯度指向能量下降最快的方向,像一枚永远指向谷底的指南针。能量给出状态的质量评分,梯度指引演化改进的方向。
更为关键的机制在于收敛判据。当推导逼近正确解时,局部的能量地形趋向平缓,梯度范数会显著收缩。只要梯度范数跌破阈值,模型就判定找到了稳定解。计算随即主动停止。
题目输入 x ───> 初始猜测状态 z₀ ───> 计算能量 E(z; x) 与梯度 ∇z E
                                              │
                      ┌───────────────────────┘
                      ▼
              沿负梯度更新状态 z ───> 梯度范数是否低于阈值?
                      │                       │
                     否                      是
                      │                       ▼
                      └───────────────> 输出最终答案并停止计算
为了避免能量地形出现虚假的局部低谷,研究团队引入了探索型训练。训练程序在状态空间中广泛采样,主动抬高错误解的能量,把正确解的能量压到最低。这把整个地形修整得平滑开阔。面对存在多种解法的任务,模型能在多个候选结果中选出能量最低的一项。
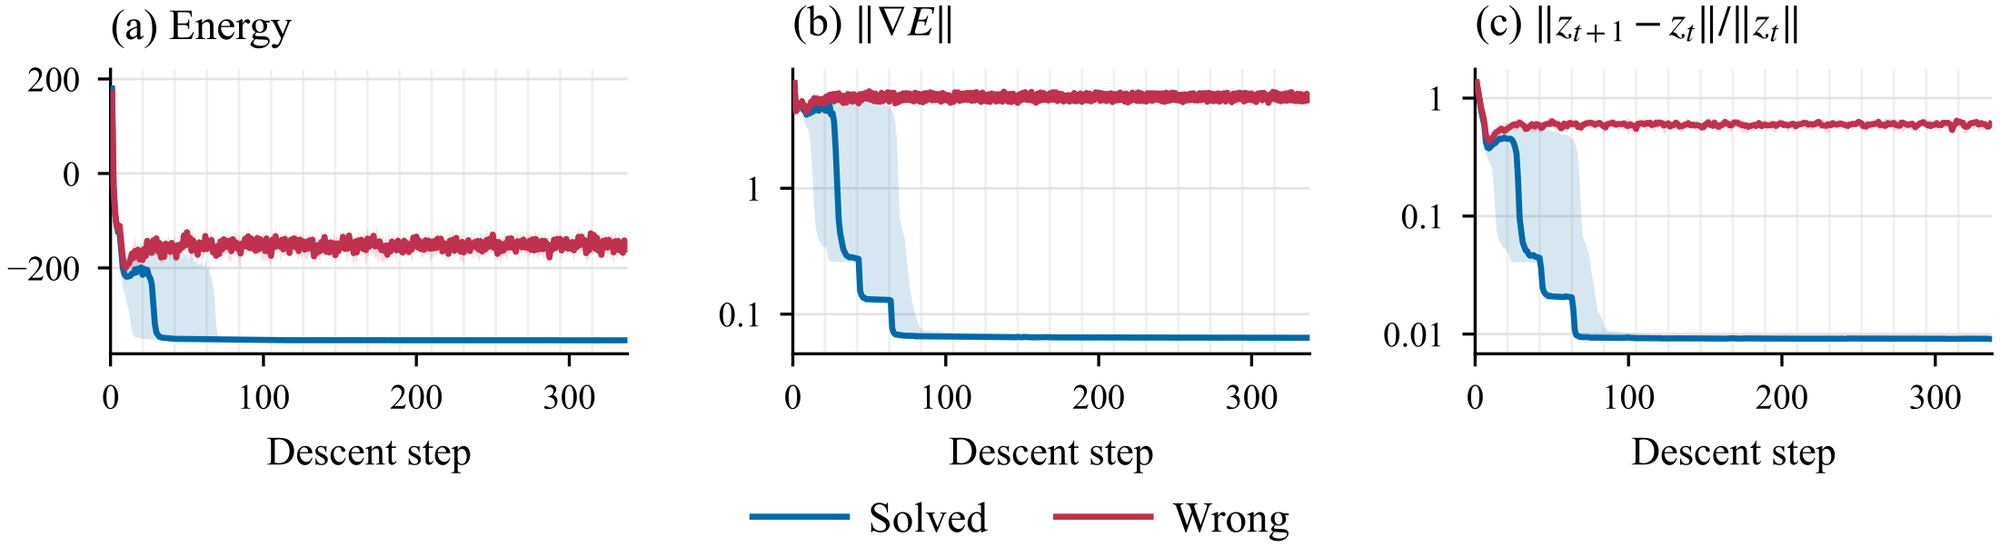 图:求解过程中能量值、梯度大小与残差的演化轨迹。解题正确的轨迹迅速收敛至低能量稳态,错误轨迹则持续振荡无法归零。来源:Energy-Based Reasoners 项目页
实测的收敛曲线展示了这种设计差异。解题正确的轨迹中,能量与梯度在极短步数内跳水,数值迅速稳定在低位。解题错误的轨迹则持续游荡。梯度范数在高位剧烈波动,说明推演已经偏离。
180 万参数击败数倍对手,自适应停手省下 345 倍算力
有了方向指引与自动刹车,微型模型展现出显著的性能优势。在用于检验极限推导能力的 Sudoku-Extreme 测试中,该能量推理模型仅有 180 万参数。同台对比的竞品模型,参数量大多在 500 万至 700 万区间,部分甚至达到 1000 万。
在单次采样的较量中,该模型取得了 99.4% 的准确率。主流对手 TRM 的成绩为 87.4%,EqR 为 93.0%,FPRM 为 94.2%,GRAM 为 86.6%,表现最好的 Looped flows 也停在 97.9%。在采样 5 个样本时,能量模型的准确率升至 99.9%。此前的领先模型 EqR 需要生成 128 个样本,才能摸到 99.8% 的门槛。
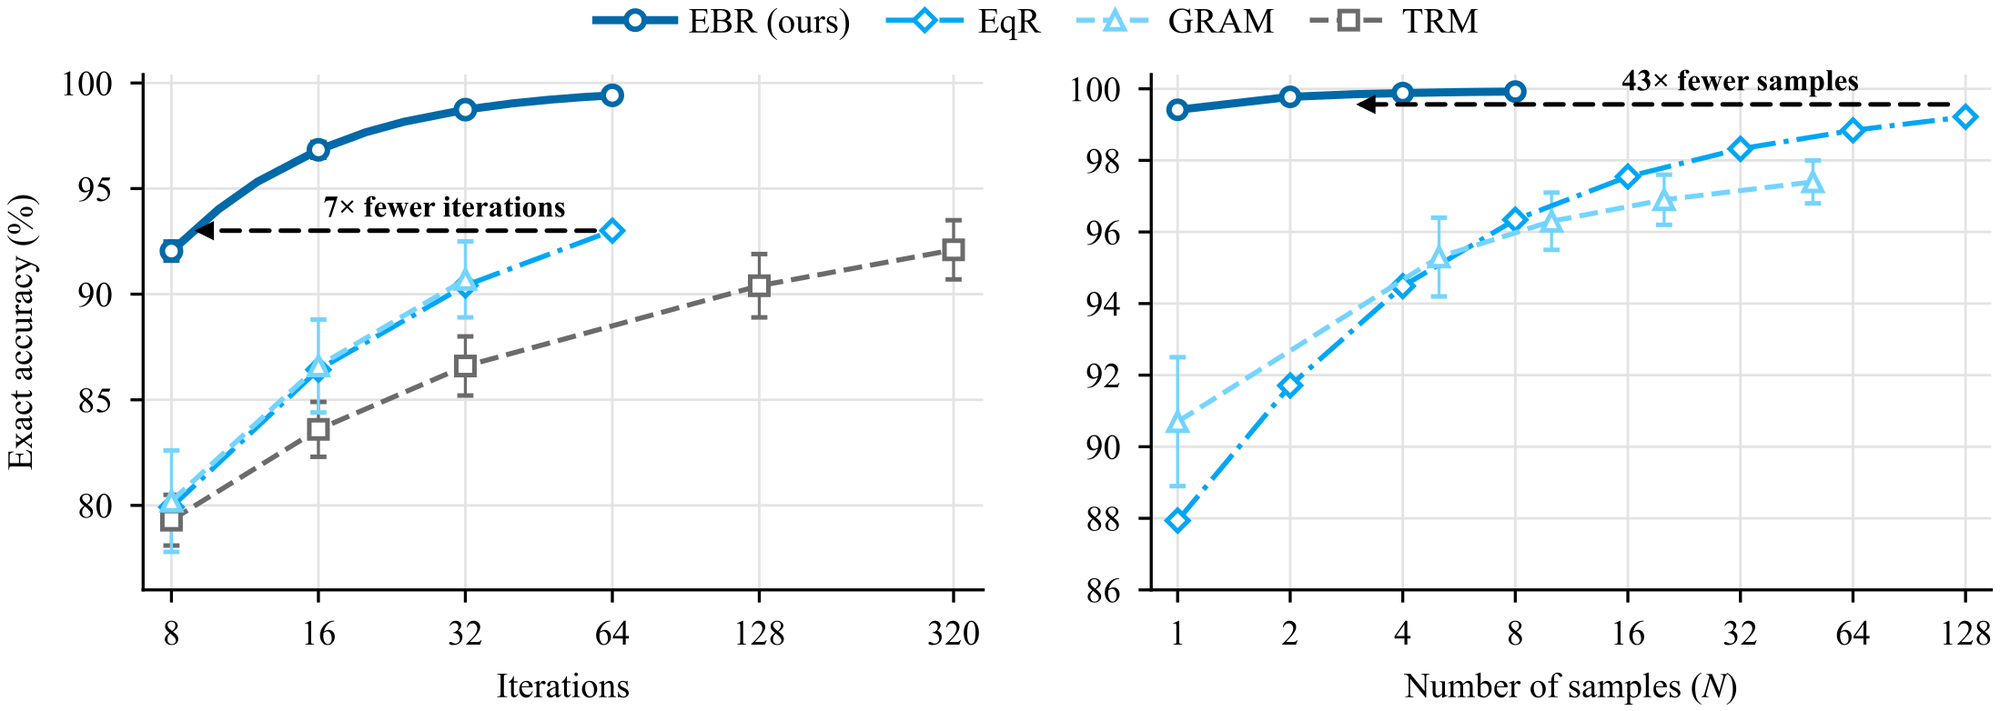 图:极难数独基准下准确率随迭代步数与采样样本数量的变化对比。模型仅用 5 个样本便压制了对手使用 128 个样本的成绩。来源:Energy-Based Reasoners 项目页
算力消耗上的差距更为悬殊。传统模型执行固定的循环步数,计算负荷居高不下;能量模型则根据梯度自适应刹车,做完即停。相比固定深度的版本,自适应停止省去了 10.9 倍的浮点运算量。与基线模型 EqR 相比,整体算力优势达到了 345 倍。在解出答案后立即停手,算力消耗就能从百倍高位降下来。
在测试时扩展(Test-time Scaling)维度上,新架构的表现同样突出。为了追平对手的最佳成绩,新模型所需的迭代步数减少了 7 倍。对应的样本采样需求,也直接缩减了 43 倍。
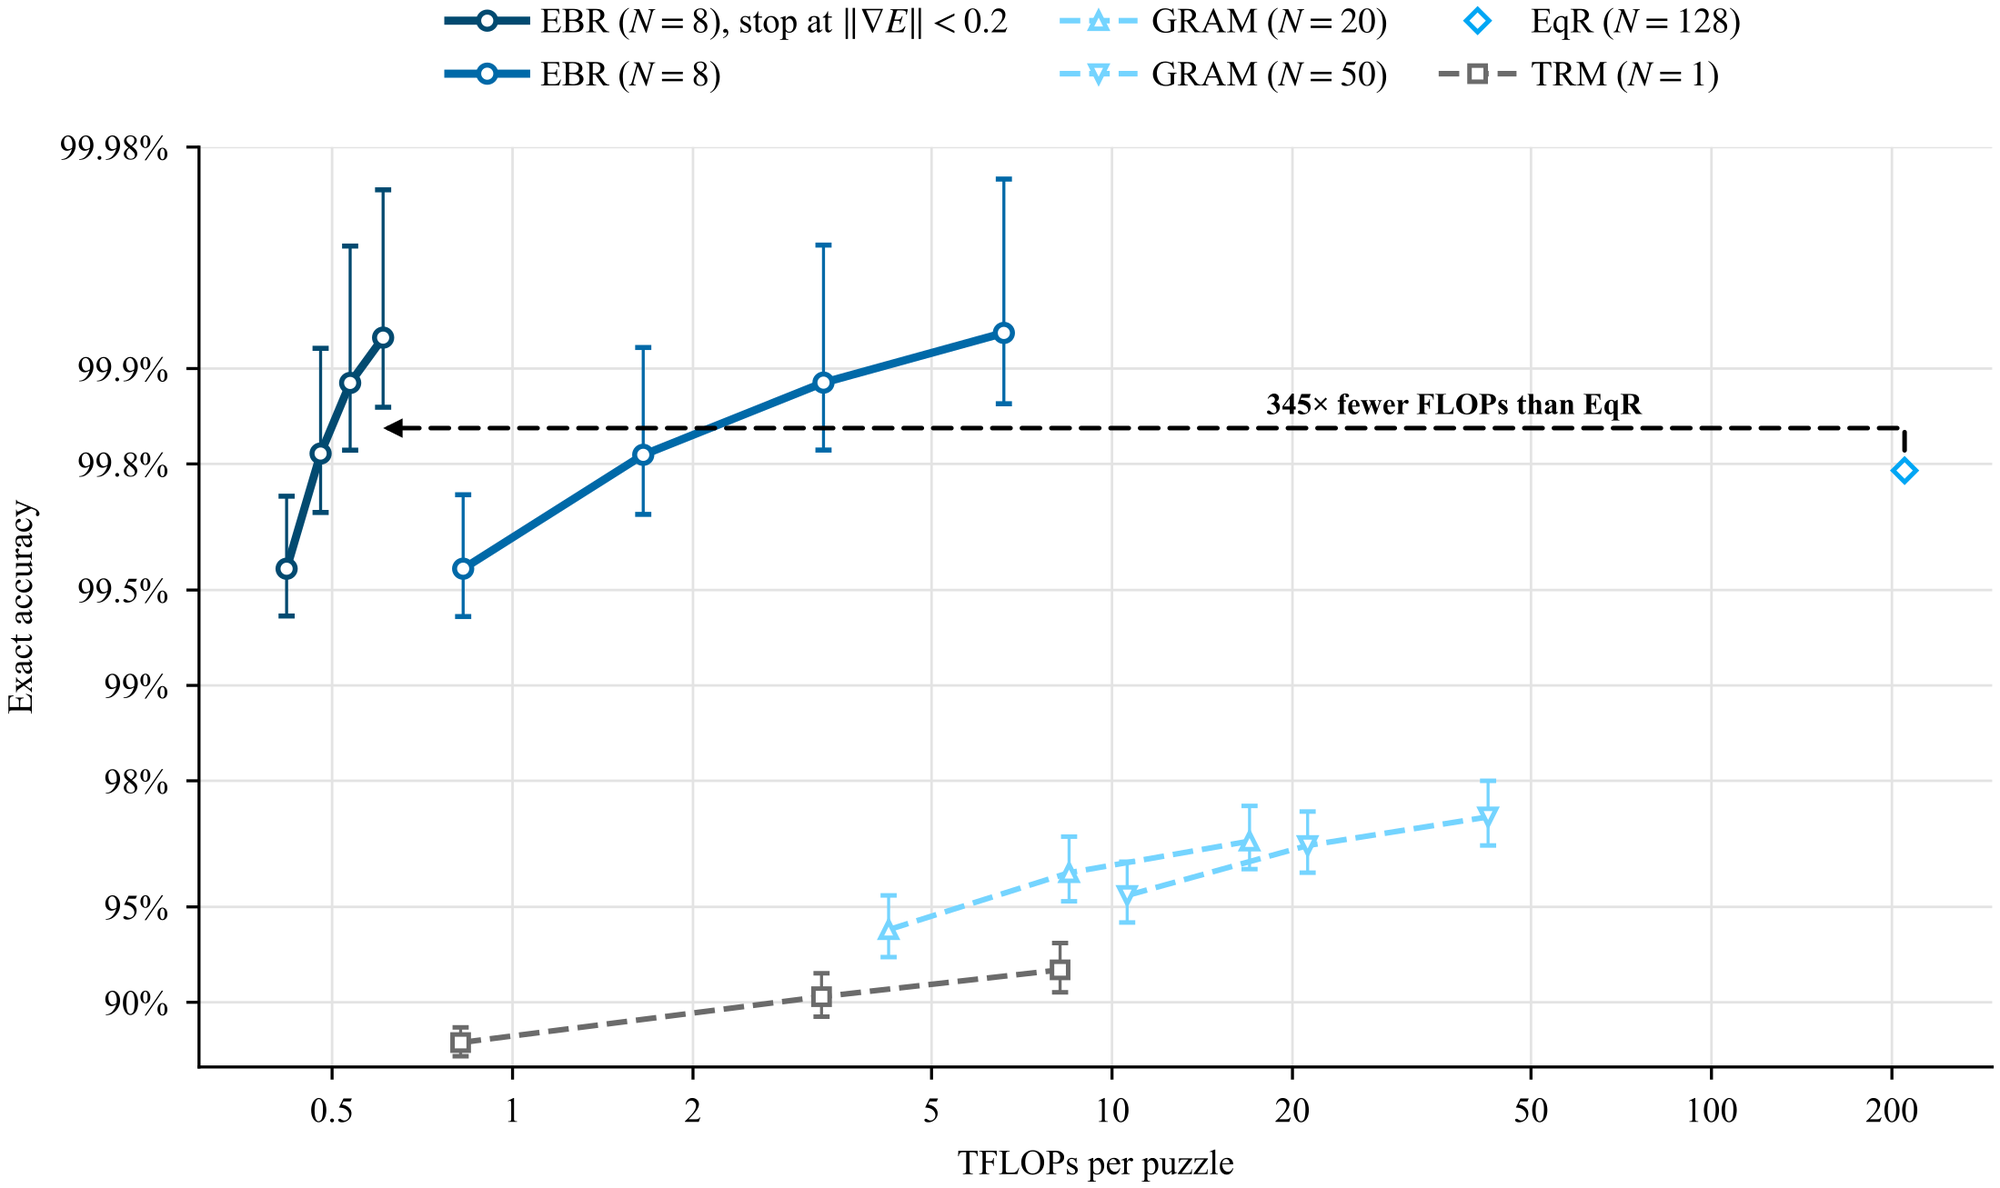 图:极难数独准确率与单题消耗计算量的对应关系。自适应停止机制在保证精度的前提下省去无用迭代,带来 345 倍算力优势。来源:Energy-Based Reasoners 项目页
面对拥有多个合法解的问题,这种定向搜索能力依然管用。在 10×10 的八皇后扩展问题中,单样本首选通过率达到 99.5%,而 GRAM 为 89.7%,TRM 仅为 17.5%。在图着色任务中,8 顶点与 10 顶点测试集的冲突数均降为 0。在解集多样性指标上,模型在 20 个样本内的覆盖度达到 98.1%,维持着全面领先。
规则明确的算法赛场,给中间状态打分胜过盲目堆规模
这套架构发挥威力的领域具有清晰边界。数独、八皇后、迷宫与图着色均为纯算法题目。这类问题有两个共性:规则明晰透明、校验答案正确的程序(Verifier)成本极低。在能低成本验证对错的搜索任务中,给中间状态打分比单纯增加参数规模更有效。
这项突破并不意味着小模型可以全面接管大语言模型。开放世界的语言任务涉及海量常识,非结构化文本缺乏公认的能量函数,无法直接计算解析梯度。作者在论文中保持审慎态度。他们指出,能量模型是探索高阶推理的新路径,尚未覆盖全部通用场景。
技术社区对这项工作保持着高度关注。Yann LeCun 参与的团队也在做类似探索。他们瞄准的目标,正是大语言模型在离散逻辑推演上的短板。
讨论中也有开发者质疑为何要禁用外部代码环境。作者对此公开回应:大模型在做算法题时极易取巧,常会写出暴力搜索脚本交给外部运行。评测严格禁用代码执行环境。这纯粹检验网络内部表征的推理水平,排除外部作弊的可能。
社区也有轻松的调侃。论文项目页的交互测试模块被设置了登录门槛。这引发了部分开发者对前沿研究包装姿态的善意调侃。
找准方向再落笔,逻辑推理正在摆脱粗暴演进
过去几年,行业习惯了通过堆参数换取智能。面对复杂的逻辑推演,缺少方向指引的模型经常陷入混乱。
这项研究给出了新思路。模型变聪明的关键,在于能否感知当前的推演进展。有了明确的能量标尺,微型网络顺着梯度也能稳步解题。
从盲目硬算的循环,走向知进退的能量下降。逻辑推理正在找到更高效的新解法。
参考链接:
- Energy-Based Reasoners 项目主页
- arXiv 论文(2611.08977)
- Hacker News 社区讨论