デューク大学、イリノイ大学アーバナ・シャンペーン校(UIUC)、ハーバード大学の研究チームが、わずか180万パラメータの極小モデルを高度なアルゴリズム推論の舞台に投入しました。業界で極めて難易度が高いとされる数独ベンチマーク「Sudoku-Extreme」において、この小型モデルは99.9%のテスト正解率を記録。しかも同等の問題を解くために消費した計算量は、トップクラスの競合モデルのわずか345分の1にとどまりました。
「Energy-Based Reasoners」と題されたこの研究は、arXiv(論文番号 2611.08977)で公開されました。著者は William Xingxu Chen、Alexi Gladstone、Zeyu Michael Li、Heng Ji、Yilun Du の各氏です。彼らはパラメータ数をひたすら増やす力任せのアプローチを避け、推論プロセスに進捗を測る「物差し」を導入することで、モデルが中間状態を自己評価できる仕組みを構築しました。
従来のループ推論は「目隠しラン」:ゴールに到達しても止まれない
近年のアルゴリズム推論研究では、ループ推論モデル(Looped Reasoning Models)が注目を集めています。ネットワークの層を深く積み重ねる代わりに、同一のコンパクトなネットワークブロックを繰り返しループ実行する手法です。モデルは「潜在状態(Latent State:モデル内部で推論の手がかりを保持する高次元ベクトル)」を反復更新しながら思考を深めます。設計思想は明快で、推論ステップを多く踏めば、論理の連鎖が徐々に整うという期待に基づいています。
しかし、既存のループ推論モデルには致命的な弱点があります。内部で推論を反復する際、現在の状態が正解に近いのかどうかを評価する指標が存在しないのです。そのため、モデルはあらかじめ設定された固定ステップ数だけ機械的に計算を続けることしかできません。推論が正解にどれほど近づいているのかも、途中で間違った方向に逸脱しているのかも判定できないのです。
この仕組みは、迷路の中で目隠しをして走らされる走者に似ています。「30歩走って提出せよ」と指示されれば、10歩目で出口に触れていても止まることができず走り続けます。逆に3歩目で袋小路に迷い込んでも、袋小路の中でぐるぐるとステップを浪費し続けます。状態評価のない反復計算は、本質的に計算リソースを使った運任せにすぎません。
フィードバックの物差しがないことは、深刻な計算資源の浪費をもたらします。難問を確実に解かせるため、エンジニアはループ回数を大きく設定しがちです。その結果、簡単な問題ではとっくに解が出ているのに無駄な計算が空回りし、難問では途中で破綻した後の計算ステップがすべてサンクコスト化してしまいます。
エネルギー関数を学習し、勾配に沿って正解へと下る
研究チームはこの推論プロセスを根本から再構築しました。彼らは潜在推論状態に対して定義される「エネルギー関数」を導入したのです。統計物理学や機械学習において、エネルギー値はシステムの不安定度や矛盾の大きさを測る指標として広く使われます。本作では、入力された問題と現在の潜在状態がどれだけ整合しているかを評価し、整合度が高いほどエネルギー値が低くなるよう設計されています。
エネルギー関数が導入されたことで、不可視だった思考プロセスに明確な「地形図」がもたらされました。潜在状態の更新は、エネルギーの負の勾配方向に進む数学的プロセスとして設計されています。負の勾配はエネルギーが最も急激に減少する方向を示し、谷底を指し続けるコンパスのように機能します。エネルギーが状態の品質スコアを提示し、勾配が改善の方向を指示するのです。
さらに決定的なのは「収束判定」の導入です。推論が正解に近づくと、局所的なエネルギー地形は平坦になり、勾配のノルム(大きさ)が急激に縮小します。勾配ノルムが閾値を下回った瞬間、モデルは安定解に達したと自ら判断し、計算を即座に停止します。
問題入力 x ───> 初期推測状態 z₀ ───> エネルギー E(z; x) と勾配 ∇z E を計算
                                                  │
                          ┌───────────────────────┘
                          ▼
             負の勾配に沿って状態 z を更新 ───> 勾配ノルムは閾値以下か?
                          │                             │
                         いいえ                        はい
                          │                             ▼
                          └───────────────> 最終解を出力し計算を終了
エネルギー地形上に偽の局所解(ローカルミニマム)が生じるのを防ぐため、研究チームは探索的学習法を取り入れました。潜在空間から幅広くサンプリングを行い、誤った解のエネルギーを意図的に引き上げ、正解のエネルギーを極限まで押し下げます。これにより、地形全体がなだらかで整った形状に調整されます。複数の解が存在する問題でも、モデルは候補の中から最もエネルギーの低い解を選び出すことができます。
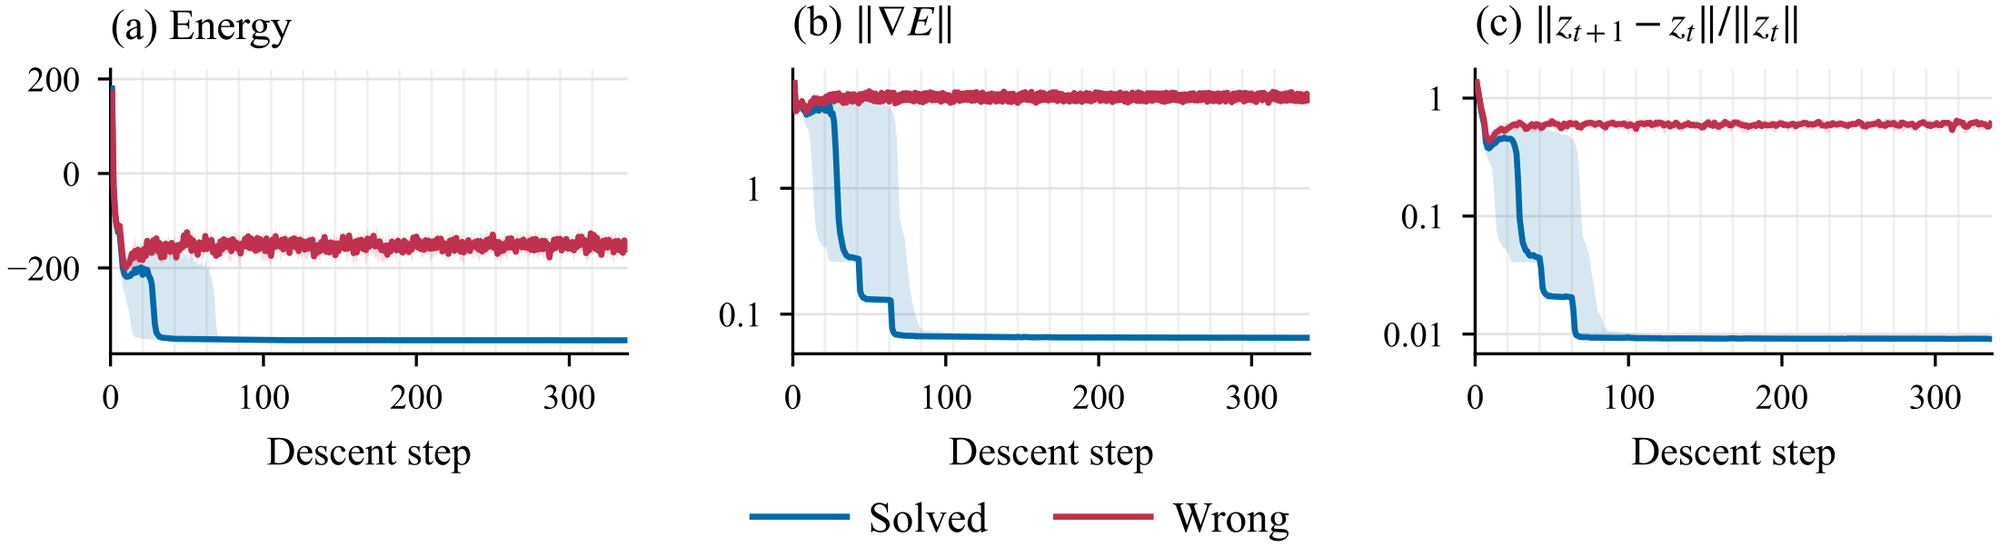 図:推論プロセスにおけるエネルギー値、勾配ノルム、残差の推移。正解に至る軌道(緑)は極めて少ないステップ数で低エネルギーの安定状態へ急速に収束する一方、不正解の軌道(赤)はゼロに収束せず激しく振動し続ける。出典:Energy-Based Reasoners プロジェクトページ
実測された収束曲線はこの設計の優位性を鮮明に裏付けています。正解に至る軌道では、エネルギーと勾配ノルムがごくわずかなステップで急落し、低水準で安定します。一方、誤った推論の軌道は迷走を続け、勾配ノルムが高止まりしたまま激しく揺れ動きます。推論が道を踏み外したことが一目でわかるシグナルです。
180万パラメータが数倍規模の競合を圧倒:適応型停止で計算量を345分の1に削減
方向の指針と自動ブレーキを手に入れたことで、極小モデルは目覚ましい性能を発揮しました。極限の推論能力を問う「Sudoku-Extreme」ベンチマークにおいて、このエネルギー推論モデルのパラメータ数はわずか180万です。比較対象となった競合モデルは、500万〜700万パラメータ、中には1000万パラメータに達するものもありました。
1サンプルのみを生成する単一推論の比較において、本モデルは99.4%の正解率をマークしました。これに対し、既存の主要モデルはTRMが87.4%、EqRが93.0%、FPRMが94.2%、GRAMが86.6%、最良だったLooped flowsでも97.9%にとどまりました。さらにサンプリング数を5個に広げると、本モデルの正解率は99.9%に達しました。従来のトップモデルEqRが99.8%に到達するには、実に128個のサンプルを生成する必要がありました。
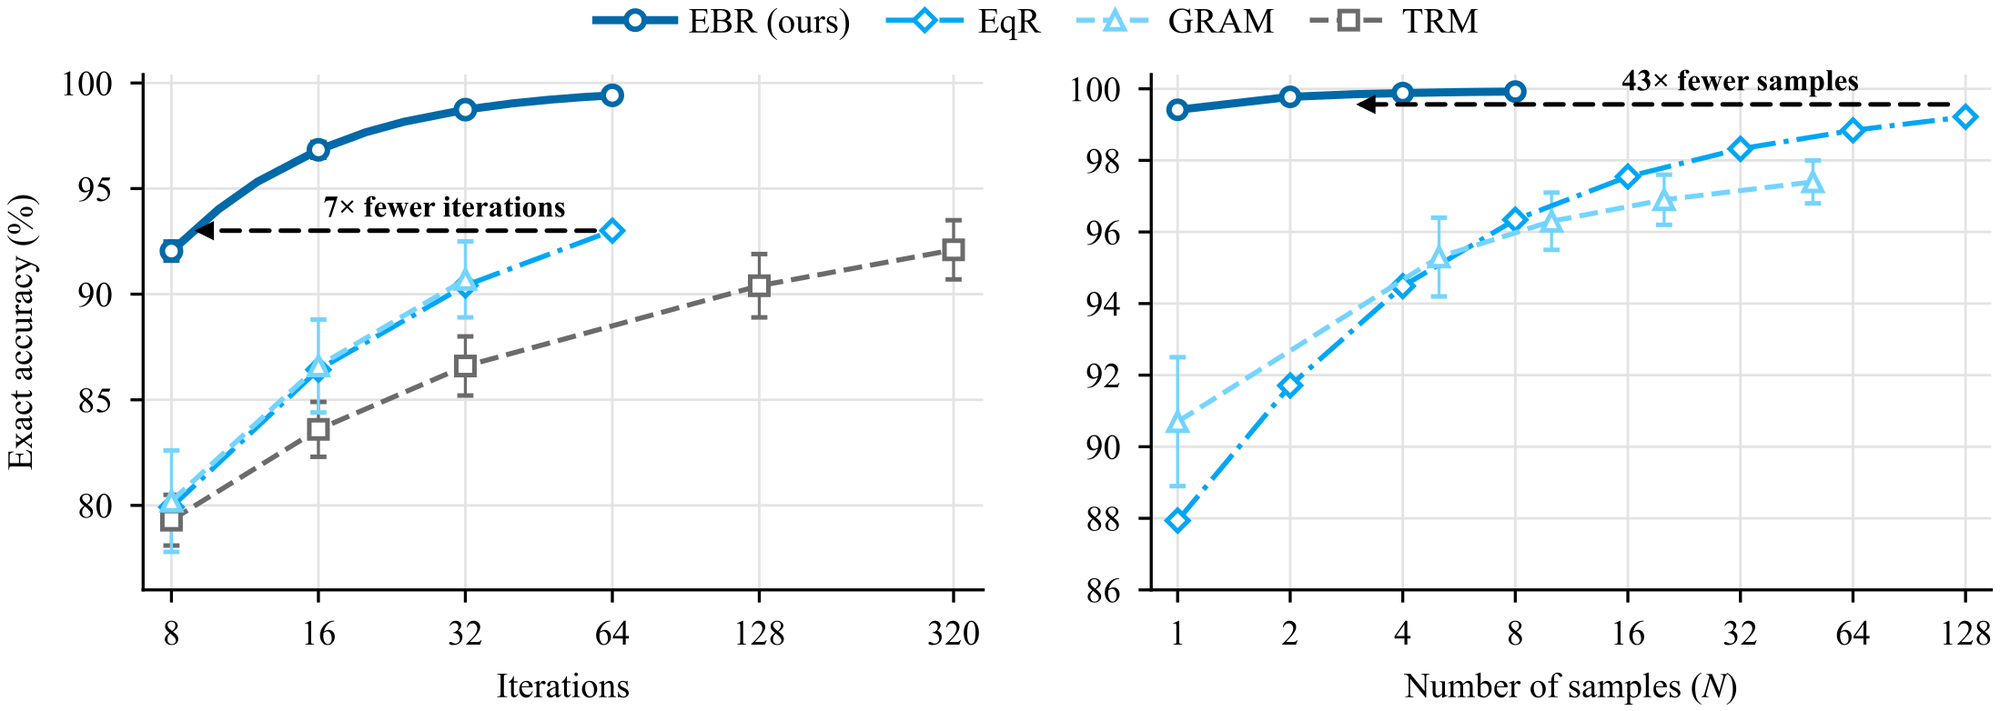 図:Sudoku-Extremeベンチマークにおける反復ステップ数およびサンプリング数と正解率の比較。本モデルはわずか5サンプルで、競合モデルが128サンプルを費やした成績を上回る。出典:Energy-Based Reasoners プロジェクトページ
計算コストの差はさらに歴然としています。従来モデルが固定ステップ数を愚直に回し続けるのに対し、本モデルは勾配ノルムに応じて自律的にブレーキをかけ、解けた瞬間に処理を打ち切ります。固定深度で回した場合と比較して、適応型停止により浮動小数点演算量(FLOPs)は10.9分の1に縮小。ベースラインとなったEqRとの比較では、計算効率で345倍の圧倒的な差をつけました。答えが出た瞬間に計算を止めることで、百倍規模の計算の浪費を排除できるのです。
テスト時スケーリング(Test-time Scaling)の観点でも、新アーキテクチャの効率性は際立っています。競合の最高成績に追いつくために必要な反復ステップ数は7分の1に減少し、要求されるサンプル数に至っては43分の1にまで圧縮されました。
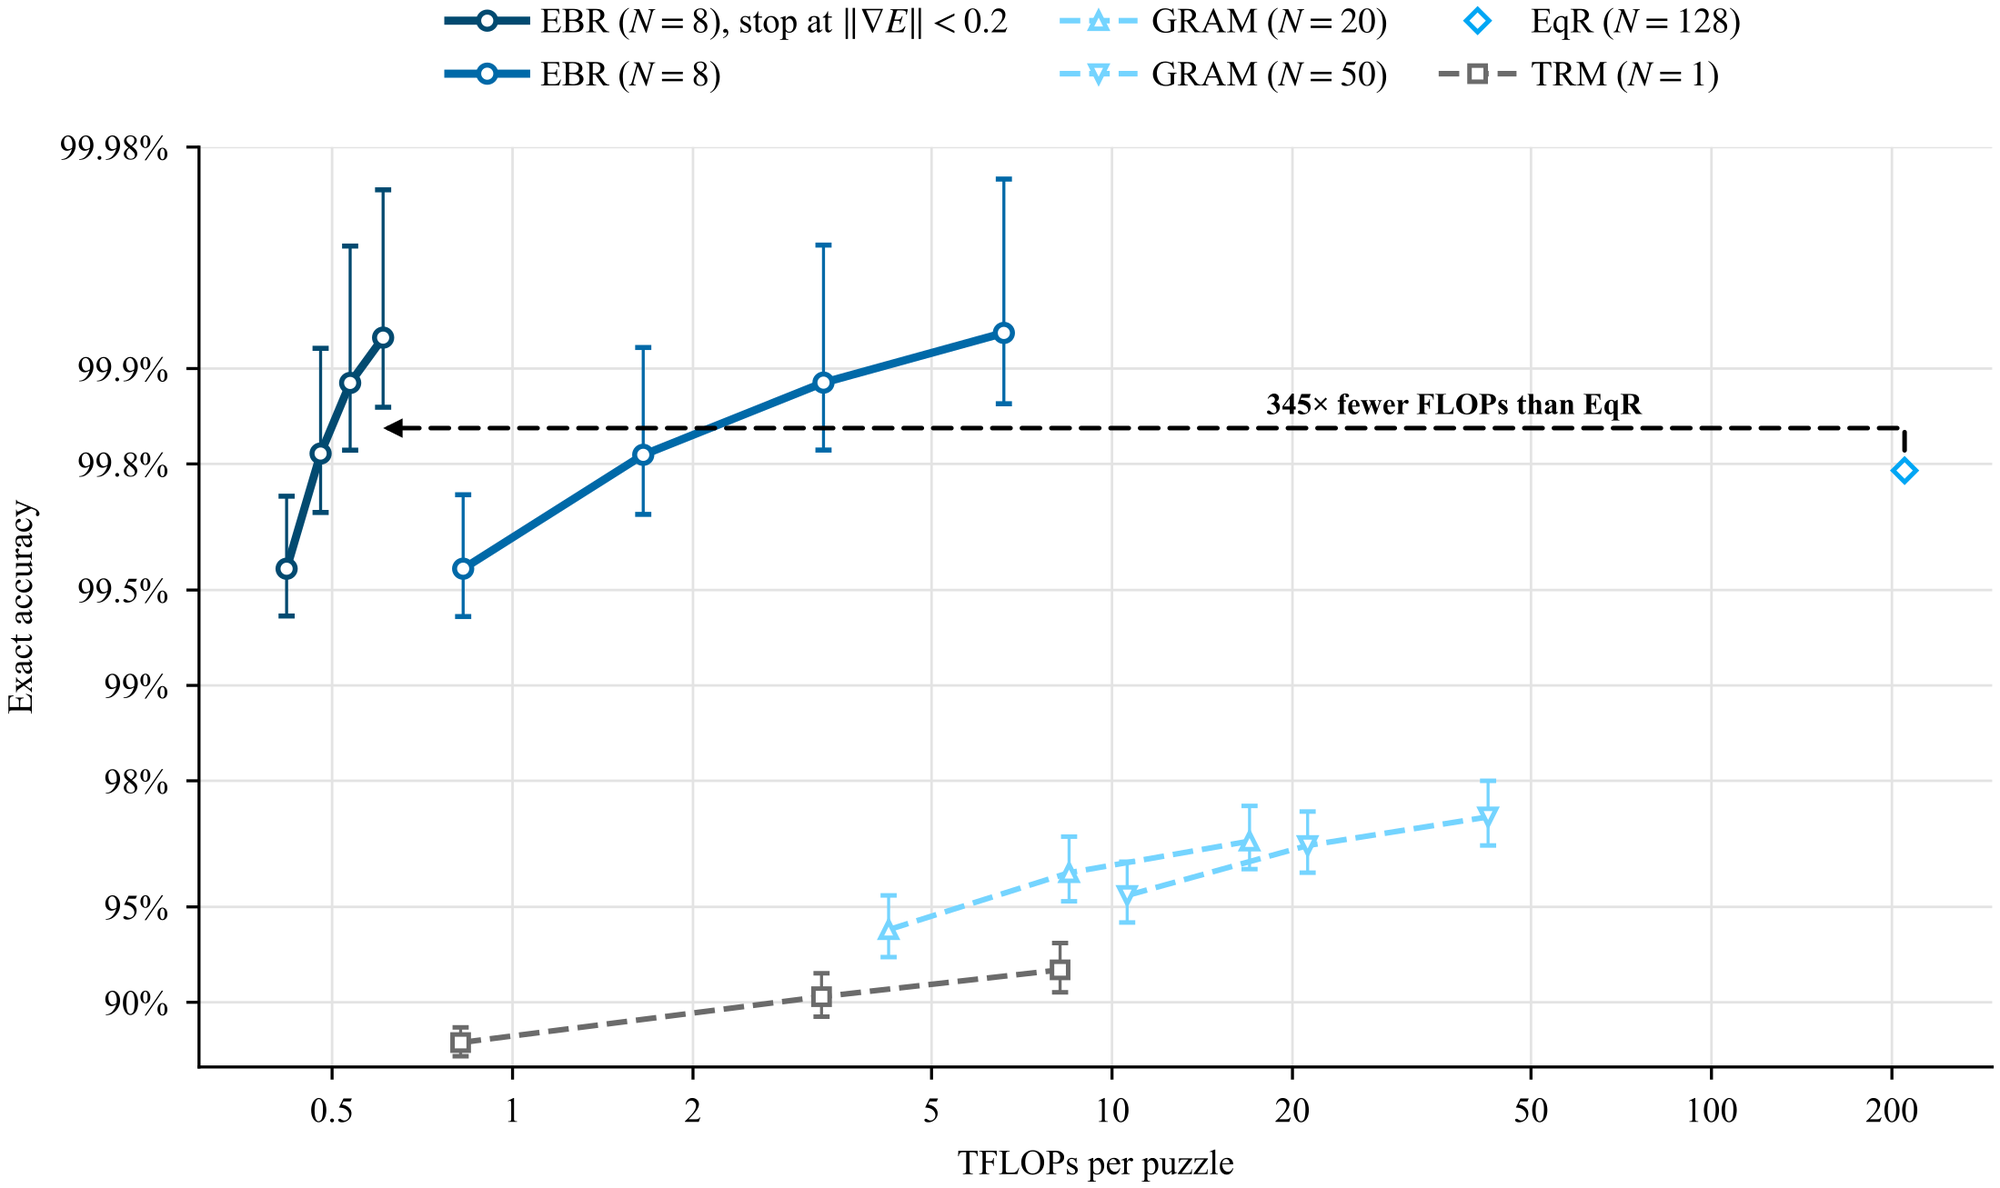 図:難関数独における正解率と1問あたりの消費計算量の相関。適応型停止機構が高い精度を維持しつつ無駄な反復を排除し、345倍の計算効率をもたらす。出典:Energy-Based Reasoners プロジェクトページ
複数の解が存在する問題でも、この指向性探索は威力を発揮します。10×10のN-Queens(エイト・クイーン拡張課題)において、単一サンプルの正解率は99.5%に達し、GRAMの89.7%、TRMの17.5%を大きく引き離しました。グラフ彩色問題でも、8頂点および10頂点のテストセットにおいて制約違反(コンフリクト)数は完全にゼロを達成。解の多様性指標でも20サンプル内で98.1%のカバレッジを記録し、全面的な優位を維持しています。
ルールが明確なアルゴリズム領域:中間状態の評価がモデル規模の肥大化を凌駕する
もっとも、このアーキテクチャが真価を発揮する領域には明確な前提があります。数独、N-Queens、迷路、グラフ彩色などはいずれも純粋なアルゴリズム問題です。これらには「ルールが明確かつ客観的であること」「解答の正しさを検証する検証器(Verifier)の計算コストが極めて低いこと」という共通点があります。低コストで正誤判定ができる探索タスクにおいては、単にパラメータ数を増やすよりも、思考の中間状態にスコアを付ける方がはるかに有効なのです。
この成果は、極小モデルが直ちに大規模言語モデル(LLM)を完全に置き換えられることを意味するわけではありません。オープンエンドな言語タスクは膨大な常識的知識を必要とし、非構造化テキストには直接勾配を計算できる明確なエネルギー関数が存在しません。論文の著者らも慎重な姿勢を崩しておらず、エネルギーモデルは高度な推論を探求するための有望な新経路ではあるものの、あらゆる汎用シナリオを網羅する段階にはないと指摘しています。
技術コミュニティもこの研究動向を注視しています。Yann LeCun氏らのグループも同様のエネルギーベース推論を探求しており、自己回帰型LLMが抱える離散的論理推論の弱点を克服するアプローチとして期待が寄せられています。
また、コミュニティの議論では「なぜ外部のコード実行環境を使わせないのか」という疑問も挙がりました。これに対し著者は、LLMがアルゴリズム問題を解く際、外部のPython環境に総当たり検索スクリプトを丸投げして「ずる」をしがちである点を指摘。本研究では外部ツールの力を借りず、ニューラルネットワーク内部の潜在表現による純粋な推論能力を測定するために、意図的にコード実行を禁止したと回答しています。
さらに、プロジェクトページのインタラクティブデモにログイン制限が課されていることに対し、先進的な研究の公開スタイルとして開発者から親しみを込めた突っ込みが入るなど、コミュニティ内で話題を呼んでいます。
進むべき方向を見定めてから書く:力任せの拡大から脱却する論理推論
過去数年間、AI業界はモデルの巨大化によって知能を高める手法に傾倒してきました。しかし、入り組んだ論理推論に直面したとき、方向を見失ったモデルはしばしば迷走に陥ります。
「Energy-Based Reasoners」が提示した道筋は示唆に富んでいます。モデルが真に賢くなるための鍵は、自身の推論が今どこまで進んでいるかを自己感知できるかどうかにあります。明確なエネルギーの物差しさえあれば、わずか180万パラメータの極小ネットワークであっても、勾配を下ることで難問を的確に解き明かすことができるのです。
盲目的な力任せの反復から、進退をわきまえたエネルギー降下へ。論理推論は今、より効率的で洗練された新たな解法を手に入れつつあります。
参考リンク:
- Energy-Based Reasoners プロジェクトページ
- arXiv 論文(2611.08977)
- Hacker News コミュニティ議論