Ein Forschungsteam der Duke University, der University of Illinois Urbana-Champaign (UIUC) und der Harvard University hat ein kompaktes Modell mit nur 1,8 Millionen Parametern in den anspruchsvollen Bereich des algorithmischen Schließens geschickt. Auf dem anerkannt schwierigen Benchmark Sudoku-Extreme erzielte dieses winzige Netzwerk eine Testgenauigkeit von 99,9 % – und verbrauchte für dieselben Aufgaben lediglich ein Dreihundertfünfundvierzigstel der Rechenleistung führender Konkurrenzmodelle.
Die Arbeit mit dem Titel Energy-Based Reasoners wurde auf arXiv (Paper 2611.08977) von William Xingxu Chen, Alexi Gladstone, Zeyu Michael Li, Heng Ji und Yilun Du veröffentlicht. Statt dem vorherrschenden Trend zu folgen, Fähigkeiten durch schiere Parameteranhäufung zu erzwingen, stattete das Team die Inferenzschleife mit einem Fortschrittsmaßstab aus, der es dem Modell ermöglicht, seine Zwischenzustände autonom zu bewerten.
Konventionelles Looped Reasoning: Blindes Rennen ohne Ziellinie
In der aktuellen Forschung zum algorithmischen Denken stehen rekurrente Architekturen (Looped Reasoning Models) im Mittelpunkt des Interesses. Anstatt immer mehr Netzwerkschichten übereinanderzustapeln, führen diese Modelle denselben kompakten Netzwerkblock wiederholt in einer Schleife aus. Das Netzwerk verfeinert dabei iterativ einen latenten Zustand (einen hochdimensionalen Vektor, der die internen Denkschritte festhält). Die Grundannahme der Entwickler ist simpel: Gibt man dem Modell mehr Rechenzyklen, ordnet sich die logische Kette Schritt für Schritt.
In der Praxis weisen bestehende Looped-Reasoning-Modelle jedoch eine fundamentale Schwachstelle auf: Während der internen Deduktion fehlt ihnen jede Metrik zur Bewertung der Qualität ihres aktuellen Zustands. Das Modell spult starr eine vordefinierte Schrittzahl ab. Es kann weder einschätzen, wie nah es der Lösung bereits ist, noch bemerken, ob Zwischenkorrekturen in eine Sackgasse führen.
Dieser Mechanismus gleicht einem Läufer, der mit verbundenen Augen durch ein Labyrinth geschickt wird. Schreibt das Protokoll vor, genau dreißig Schritte zu laufen, rennt der Läufer blind drauflos – selbst wenn er bereits bei Schritt zehn den Ausgang ertastet hat. Ist er dagegen bei Schritt drei falsch abgebogen, kreist er dennoch bis zum Ende in der Sackgasse. Wiederholte Iterationen ohne Zustandsbewertung laufen im Grunde darauf hinaus, Rechenleistung auf gut Glück zu verbrennen.
Das Fehlen einer Rückmeldung führt zu enormer Rechenverschwendung. Um sicherzustellen, dass schwierige Aufgaben gelöst werden, setzen Entwickler die Schleifenzahl meist sehr hoch an. Bei einfachen Aufgaben dreht die Rechenleistung leer weiter, obwohl das Ergebnis längst feststeht. Bei schwierigen Aufgaben, die früh entgleisen, werden alle nachfolgenden Rechenschritte zu irreversiblen Verlusten.
Eine Energiefunktion lernen: Entlang des Gradienten zur Lösung
Das Forschungsteam durchbrach dieses Muster, indem es eine über dem latenten Zustand definierte Energiefunktion einführte. In der statistischen Physik und im maschinellen Lernen misst der Energiewert traditionell die Instabilität oder Inkonsistenz eines Systems. Hier dient die Funktion als Bewertungsskala: Sie misst, wie gut die Eingabeaufgabe mit dem aktuellen latenten Zustand übereinstimmt – je höher die Übereinstimmung, desto niedriger die Energie.
Mit dieser Energiefunktion erhält der zuvor unsichtbare Denkprozess eine topografische Landkarte. Jede Aktualisierung des latenten Zustands ist mathematisch so konstruiert, dass sie in Richtung des negativen Gradienten erfolgt. Der negative Gradient weist stets in die Richtung des steilsten Energieabfalls – wie ein Kompass, der unentwegt zur Talsohle zeigt. Die Energie bewertet die Qualität des Zustands, während der Gradient die Richtung der Optimierung vorgibt.
Der entscheidende Hebel liegt im Konvergenzkriterium. Nähert sich die Deduktion einer korrekten Lösung, flacht das lokale Energierelief ab und die Gradientennorm schrumpft drastisch. Sobald die Gradientennorm einen Schwellenwert unterschreitet, stellt das Modell eigenständig fest, dass eine stabile Lösung erreicht ist, und stoppt die Berechnung unverzüglich.
Aufgabeneingabe x ───> Initialzustand z₀ ───> Energie E(z; x) & Gradient ∇z E berechnen
                                                            │
                            ┌───────────────────────────────┘
                            ▼
              Zustand z entlang -∇z E aktualisieren ───> Gradientennorm < Schwelle?
                            │                                     │
                          Nein                                   Ja
                            │                                     ▼
                            └───────────────> Lösung ausgeben & Berechnung stoppen
Um zu verhindern, dass die Energielandschaft trügerische lokale Minima bildet, setzte das Team auf exploratives kontrastives Training. Das Modell tastet den latenten Raum breit ab, hebt die Energie fehlerhafter Konfigurationen gezielt an und senkt die der korrekten Lösung auf den Tiefststand ab. Dadurch wird das gesamte Relief geglättet. Bei Aufgaben mit mehreren gültigen Lösungen kann das Modell gezielt den Kandidaten im tiefsten Energietal ansteuern.
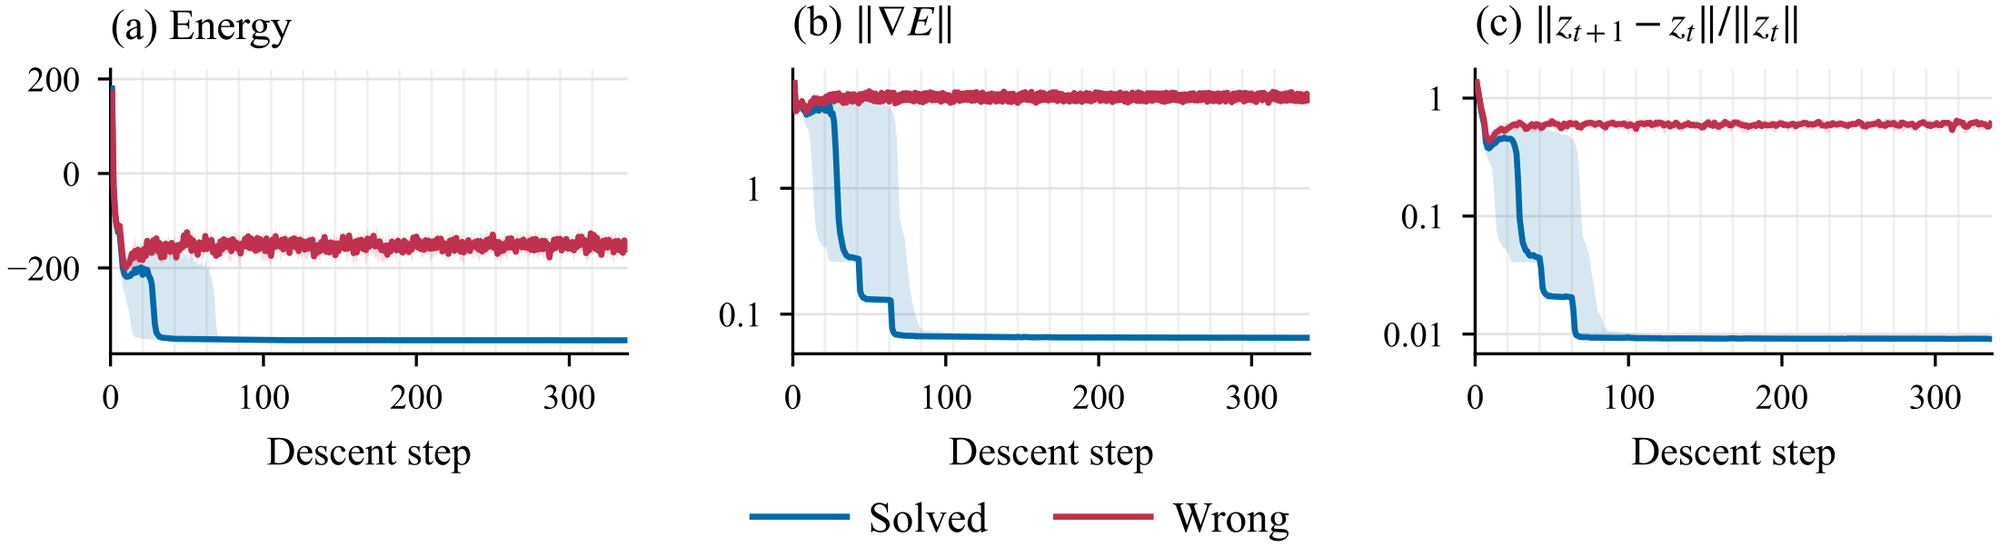 Abbildung: Entwicklung von Energiewert, Gradientengröße und Residuum während des Lösungsprozesses. Erfolgreiche Trajektorien konvergieren in wenigen Schritten zu einem stabilen Niedrigenergiezustand, während fehlerhafte Pfade fortwährend oszillieren. Quelle: Projektseite Energy-Based Reasoners.
Die gemessenen Konvergenzkurven belegen diesen Unterschied deutlich. Bei korrekten Trajektorien stürzen Energie und Gradientennorm innerhalb kürzester Zeit ab und stabilisieren sich auf niedrigstem Niveau. Fehlerhafte Pfade irren dagegen weiter umher: Die Gradientennorm fluktuiert auf hohem Niveau – ein klares Signal, dass der Denkprozess vom Kurs abgekommen ist.
1,8 Millionen Parameter schlagen größere Konkurrenz: Adaptiver Stopp spart 345-fache Rechenleistung
Dank Richtungsführung und automatischer Bremse zeigte das kompakte Modell beachtliche Leistungsvorteile. Im Sudoku-Extreme-Test, der die Grenzen logischer Deduktion prüft, begnügte sich das Energiemodell mit 1,8 Millionen Parametern. Die verglichenen Konkurrenzmodelle bewegten sich meist zwischen 5 und 7 Millionen, teils sogar bei 10 Millionen Parametern.
Beim Einzelstichproben-Vergleich erzielte das Modell eine Genauigkeit von 99,4 %. Führende Konkurrenten lagen spürbar zurück: TRM erreichte 87,4 %, EqR 93,0 %, FPRM 94.2 %, GRAM 86,6 % und das stärkste Vergleichsmodell Looped Flows 97,9 %. Wurde die Stichprobengröße auf 5 erhöht, stieg die Genauigkeit des Energiemodells auf 99,9 %. Das bisherige Spitzenmodell EqR benötigte 128 Stichproben, um überhaupt an die Marke von 99,8 % heranzureichen.
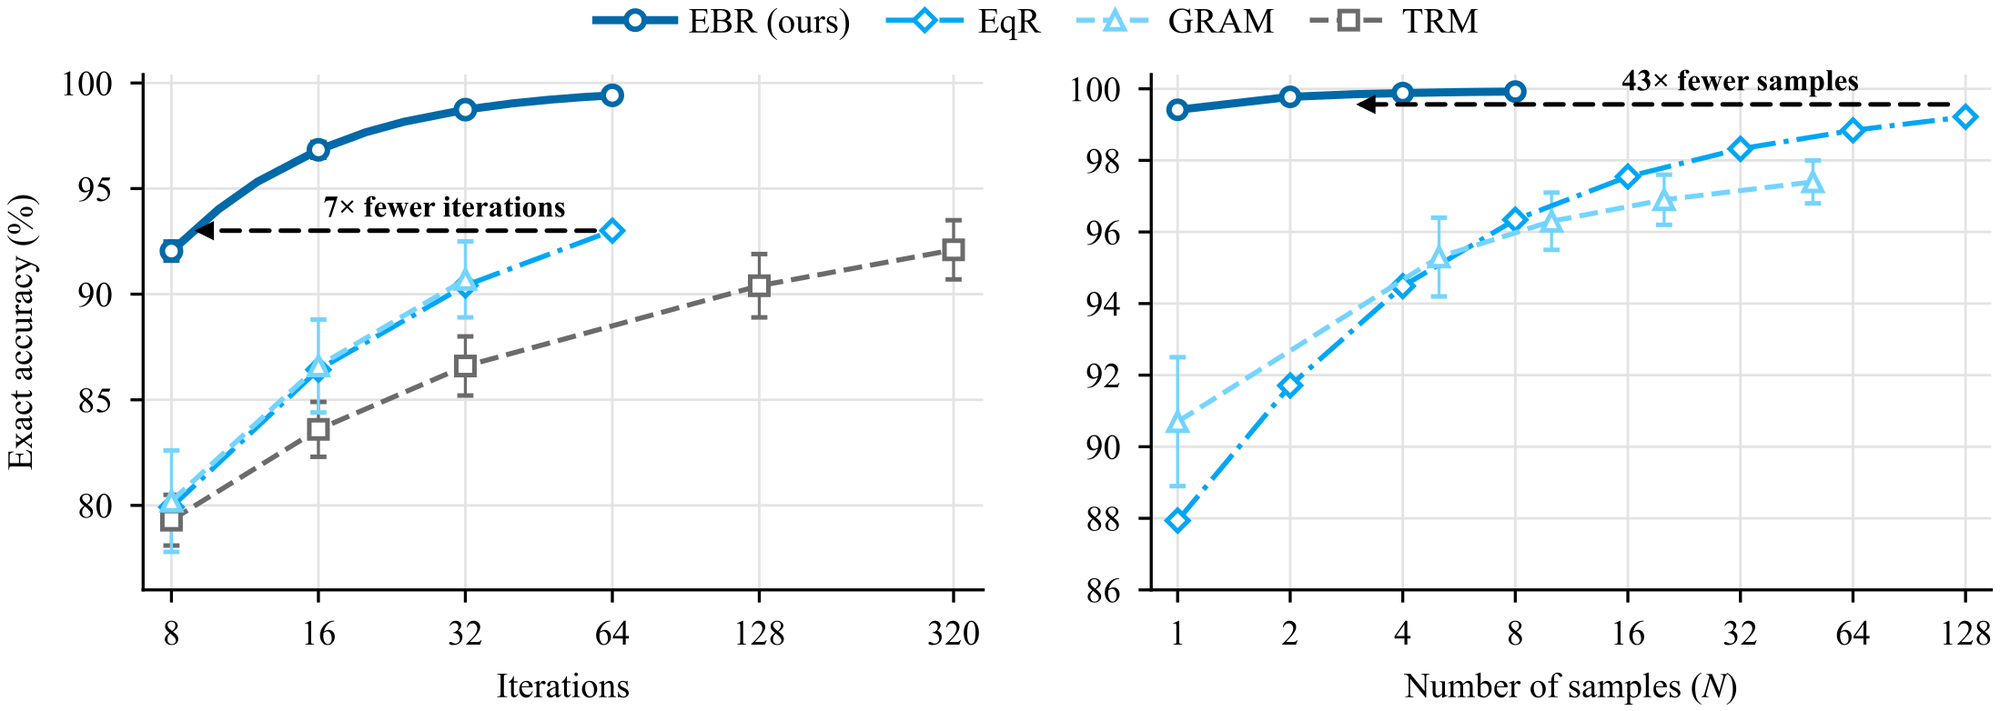 Abbildung: Vergleich der Genauigkeit auf Sudoku-Extreme in Abhängigkeit von Iterationsschritten und Stichprobenmenge. Das Modell übertrifft mit nur 5 Stichproben die Ergebnisse der Konkurrenz bei 128 Stichproben. Quelle: Projektseite Energy-Based Reasoners.
Noch gravierender ist der Unterschied beim Rechenaufwand. Herkömmliche Modelle verharren in starren Schleifentiefen mit hoher Rechenlast; das Energiemodell bremst adaptiv ab, sobald die Gradientennorm sinkt, und beendet die Ausführung punktgenau. Gegenüber einer Variante mit fester Rekursionstiefe spart der adaptive Stopp das 10,9-Fache an Gleitkommaoperationen (FLOPs). Im Vergleich zur Baseline EqR beläuft sich der Effizienzvorteil auf das 345-Fache. Sobald eine Lösung gefunden ist, sofort anzuhalten, senkt den Rechenaufwand von extremen Höhen auf ein Minimum.
Auch bei der Testzeit-Skalierung (Test-time Scaling) überzeugt die Architektur: Um die Bestwerte der Konkurrenz einzustellen, benötigt das neue Modell siebenmal weniger Iterationen und verringert den Bedarf an Stichproben um das 43-Fache.
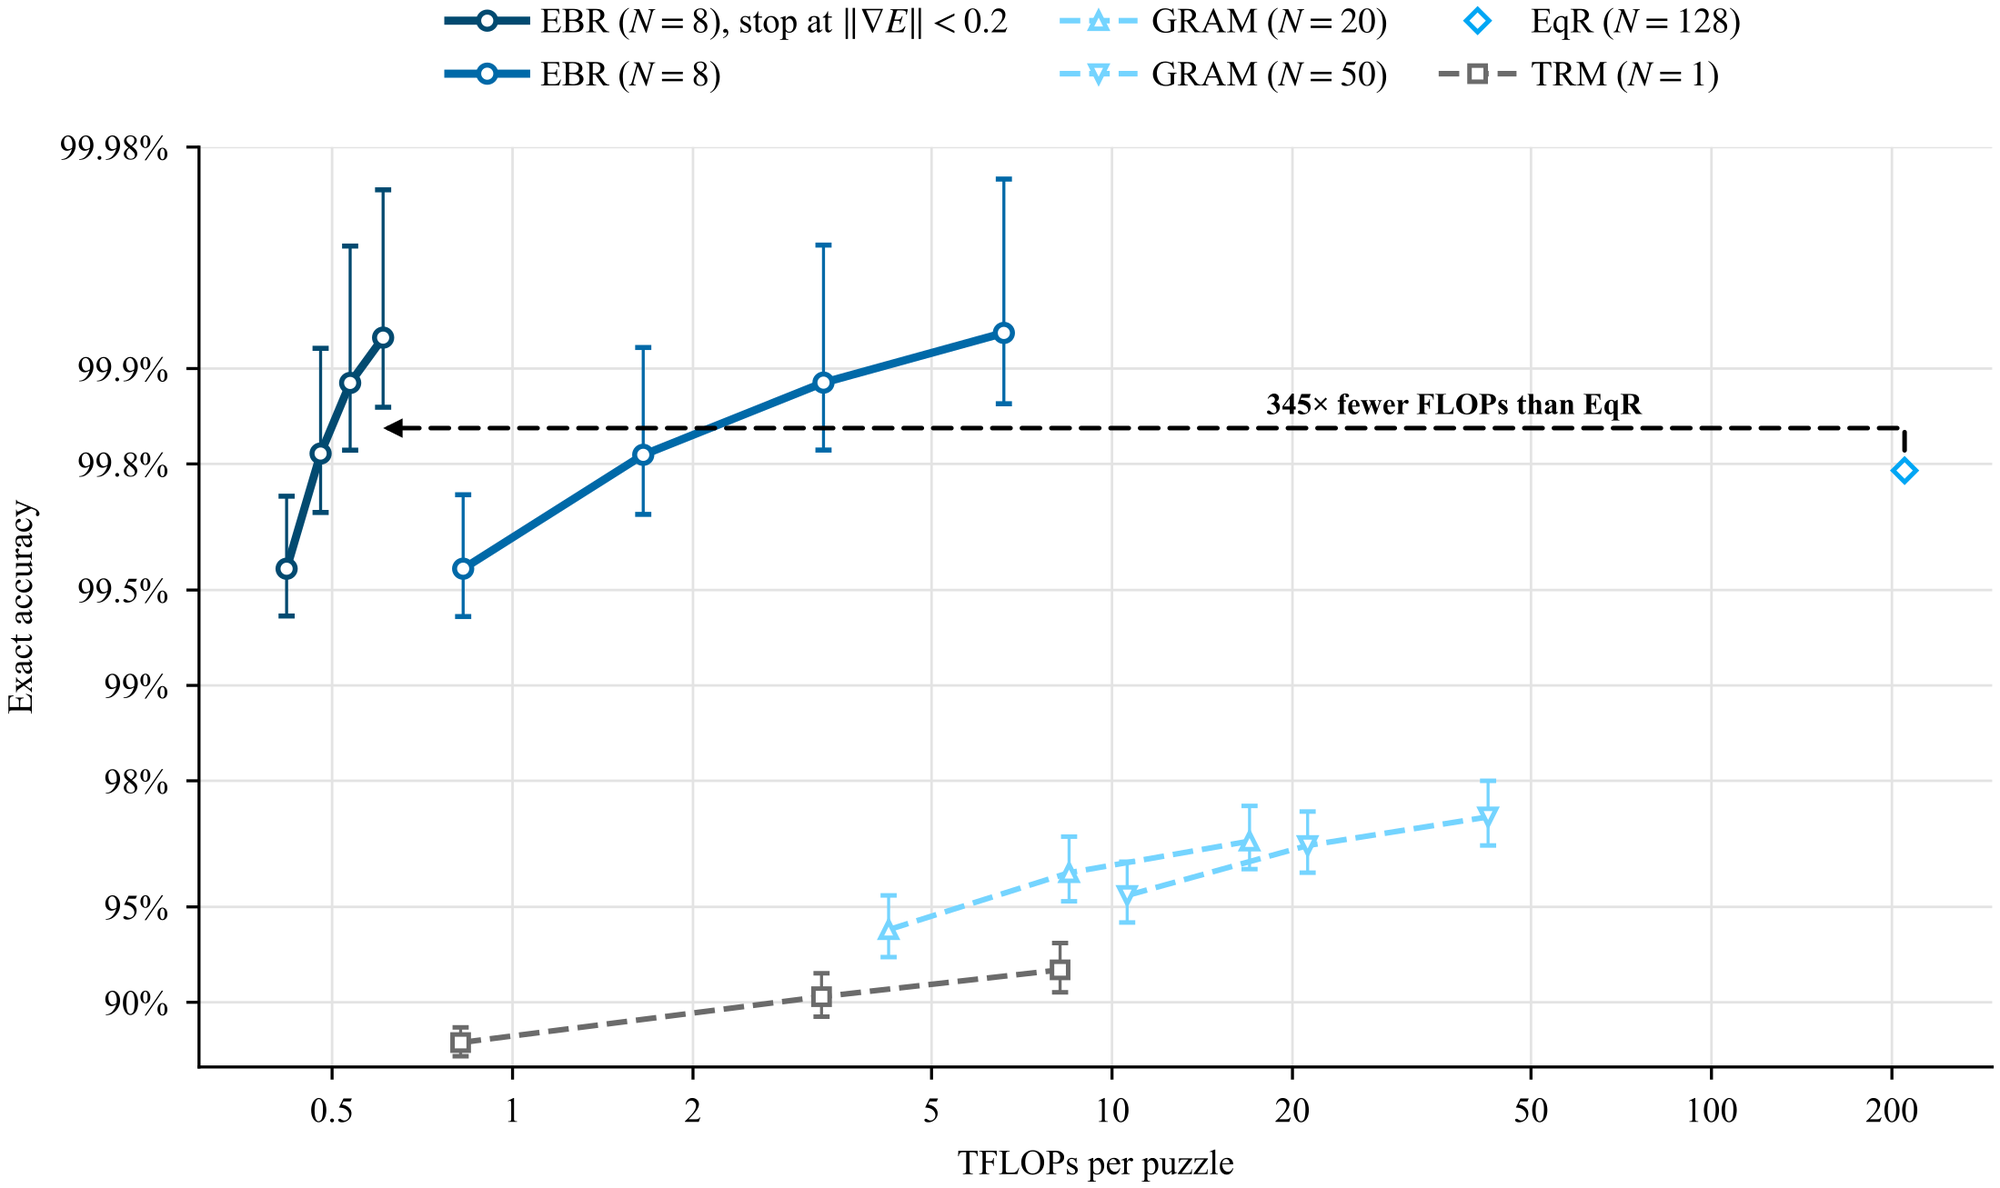 Abbildung: Zusammenhang zwischen Genauigkeit auf Sudoku-Extreme und Rechenaufwand pro Aufgabe. Der adaptive Abbruchmechanismus eliminiert unnötige Iterationen bei voller Präzision und sorgt für einen 345-fachen Rechenvorteil. Quelle: Projektseite Energy-Based Reasoners.
Auch bei Problemen mit mehreren gültigen Lösungen greift diese gerichtete Suche. Bei der 10x10-Erweiterung des Damenproblems (N-Queens) lag die Erfolgsrate bei der ersten Stichprobe bei 99,5 % (GRAM: 89,7 %, TRM: 17,5 %). Bei der Graphfärbung sank die Zahl der Konflikte auf 8- und 10-Knoten-Graphen auf null. Bei der Lösungsvielfalt über 20 Stichproben hinweg erzielte das Modell eine Abdeckung von 98,1 %.
Strukturierte algorithmische Domänen: Zwischenbewertung schlägt schiere Skalierung
Die Stärke dieser Architektur entfaltet sich in klar umrissenen Anwendungsfeldern. Sudoku, N-Queens, Labyrinthe und Graphfärbung sind rein algorithmische Aufgaben. Sie teilen zwei Eigenschaften: eindeutige, transparente Regeln und extrem kostengünstige Verifizierer (Verifier) zur Überprüfung des Ergebnisses. Bei Suchaufgaben mit billiger Ergebnisprüfung ist die präzise Bewertung von Zwischenzuständen weitaus wirksamer als das bloße Aufblähen von Parametern.
Dieser Durchbruch bedeutet nicht, dass kompakte Modelle unmittelbar große Sprachmodelle (LLMs) ersetzen können. Offene Sprachaufgaben erfordern enormes Weltwissen, und unstrukturierter Fließtext besitzt keine analytische Energiefunktion, über die sich direkte Gradienten ableiten ließen. Die Autoren betonen daher nüchtern, dass Energiemodelle einen vielversprechenden Weg für diskrete logische Schlussfolgerungen darstellen, aber noch kein universeller Ersatz für LLMs sind.
Die Fachwelt verfolgt diesen Ansatz mit großem Interesse. Forschungsteams um Yann LeCun arbeiten an ähnlichen Konzepten, die gezielt darauf abstellen, die Schwächen autoregressiver Sprachmodelle bei diskreten Logikaufgaben zu überwinden.
In Entwicklerforen wurde auch diskutiert, warum externe Code-Ausführungsumgebungen im Test verboten waren. Die Autoren stellten klar, dass große Modelle bei algorithmischen Aufgaben häufig auf Brute-Force-Skripte ausweichen, die sie an einen externen Python-Interpreter delegieren. Das strikte Verbot externer Ausführung stellt sicher, dass allein die interne Repräsentations- und Schlussfolgerungsfähigkeit des Netzwerks gemessen wird.
Zudem sorgte eine kleine Hürde für amüsierte Kommentare in der Community: Das interaktive Demotool auf der Projektseite verlangte einen Login – was einige Entwickler zu gutmütigem Spott über die Inszenierung aktueller Forschungsarbeiten verleitete.
Erst die Richtung bestimmen, dann ansetzen: Logisches Schließen jenseits roher Gewalt
In den letzten Jahren verließ sich die KI-Branche vor allem darauf, Intelligenz durch immer größere Parametermengen zu erzwingen. Doch bei komplexer logischer Deduktion geraten richtungslose Modelle schnell ins Straucheln.
Die Arbeit an den Energy-Based Reasoners zeigt eine Alternative auf: Der Schlüssel zu überlegener Denkfähigkeit liegt darin, dass ein Modell den eigenen Fortschritt präzise erfassen kann. Mit einem klaren Energiemaßstab findet selbst ein winziges 1,8-Millionen-Parameter-Netzwerk entlang des Gradienten zuverlässig ans Ziel.
Vom blinden Durchrechnen zur zielgerichteten Energiereduktion: Das logische Schließen entdeckt einen deutlich effizienteren Pfad.
Weiterführende Links:
- Projektseite: Energy-Based Reasoners
- arXiv-Paper (2611.08977)
- Diskussion auf Hacker News