Un equipo conjunto de investigadores de la Universidad de Duke, la Universidad de Illinois en Urbana-Champaign (UIUC) y la Universidad de Harvard ha llevado un modelo diminuto de apenas 1,8 millones de parámetros al exigente terreno del razonamiento algorítmico. En el benchmark Sudoku-Extreme, reconocido en la industria por su extrema complejidad, esta pequeña red alcanzó un 99,9% de precisión en pruebas, consumiendo tan solo una parte entre 345 del cómputo que requieren los modelos rivales de referencia.
El trabajo, titulado Energy-Based Reasoners, fue publicado en arXiv (artículo 2611.08977) por William Xingxu Chen, Alexi Gladstone, Zeyu Michael Li, Heng Ji y Yilun Du. En lugar de seguir la vía convencional de apilar parámetros para obtener capacidades deductivas por fuerza bruta, el equipo equipó el bucle de deducción con una métrica explícita de progreso que permite al modelo evaluar de forma autónoma sus propios estados intermedios.
El razonamiento recurrente tradicional: una carrera a ciegas sin línea de meta
En la investigación actual sobre razonamiento algorítmico, los modelos de razonamiento recurrente (Looped Reasoning Models) han despertado un gran interés. En lugar de apilar capas y capas de redes neuronales, estas arquitecturas ejecutan de forma repetida un mismo bloque compacto en bucle. La red refina sucesivamente un estado latente (un vector de alta dimensión que registra las pistas deductivas internas). La premisa de diseño es directa: conceder más ciclos de cálculo al modelo para que la cadena lógica termine de encajar paso a paso.
Sin embargo, los modelos de razonamiento en bucle tradicionales adolecen de un defecto crítico: carecen de una métrica interna para evaluar la calidad de su estado actual. Operan con un número fijo y predeterminado de pasos mecánicos. No saben a qué distancia se encuentran de la solución correcta ni pueden detectar si las modificaciones intermedias se están desviando.
Este mecanismo equivale a pedirle a una persona que corra con los ojos vendados dentro de un laberinto. Si el protocolo estipula correr exactamente treinta pasos antes de entregar la respuesta, el corredor avanzará a ciegas; aunque en el paso diez ya haya tocado la salida, no podrá detenerse. Y si en el paso tres toma un callejón sin salida, continuará dando vueltas en círculo dentro de él. Iterar repetidamente sin una evaluación del estado equivale, en esencia, a jugarse el cómputo a la suerte.
La falta de una escala de retroalimentación ocasiona además un grave despilfarro computacional. Para garantizar que los problemas complejos puedan resolverse, los ingenieros suelen fijar un número de iteraciones muy elevado. En problemas sencillos que ya se han resuelto, la capacidad de cálculo sigue girando en el vacío. En problemas difíciles que se desvían a mitad de camino, todas las operaciones posteriores se convierten en costes irrecuperables.
Aprender una función de energía: seguir el gradiente hacia la solución correcta
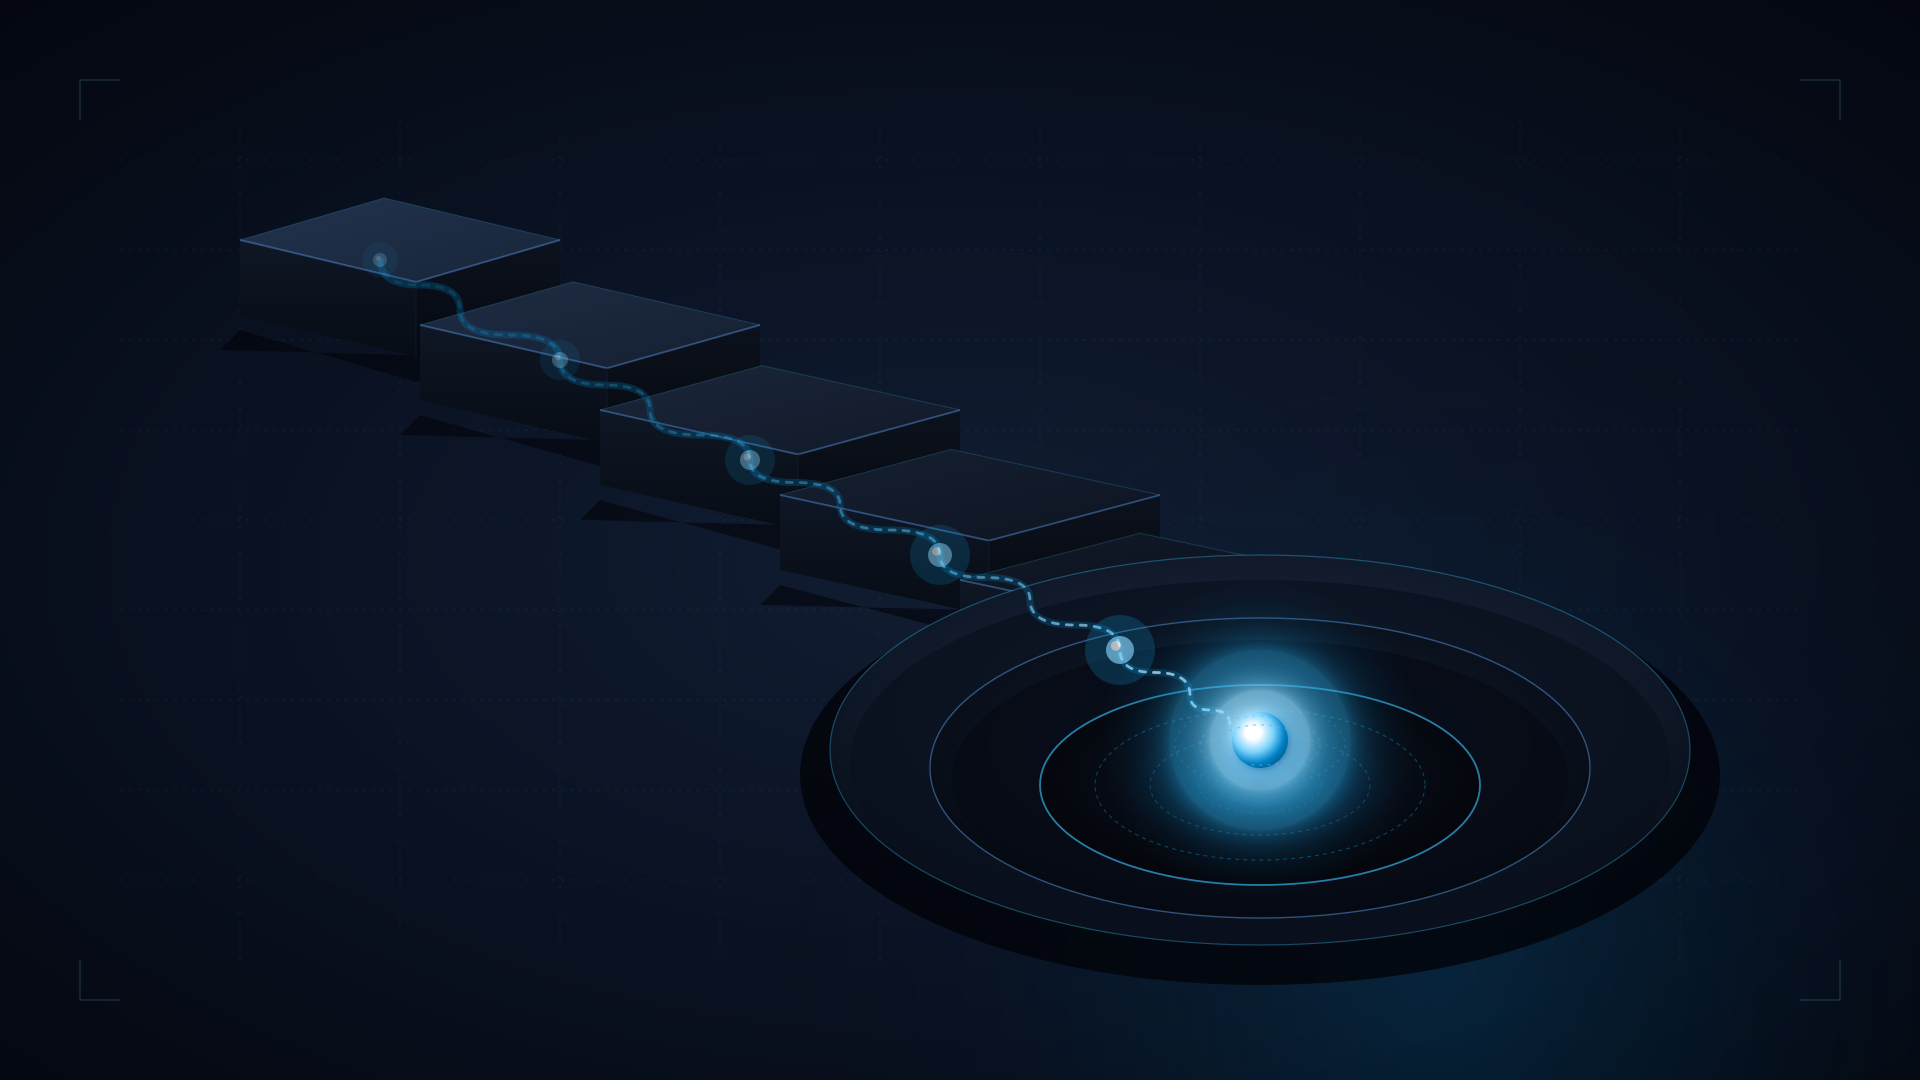
El equipo de investigación transformó por completo este mecanismo al incorporar una función de energía definida sobre el estado latente de razonamiento. En la física estadística y el aprendizaje automático, los valores de energía se utilizan habitualmente para cuantificar el grado de inestabilidad o inconsistencia de un sistema. En este contexto, la función de energía evalúa el ajuste entre el problema de entrada y el estado latente actual: cuanto mayor es la concordancia, menor es el valor numérico.
Con esta función de energía, el proceso invisible de deducción dispone de un mapa topográfico. Cada actualización del estado latente se formula matemáticamente como un avance en la dirección del gradiente negativo. El gradiente negativo apunta siempre hacia el descenso más pronunciado de energía, funcionando como una brújula que señala de forma invariable hacia el fondo del valle. La energía puntúa la calidad del estado, mientras que el gradiente guía la dirección de mejora.
El mecanismo más determinante reside en el criterio de convergencia. A medida que la deducción se aproxima a la respuesta correcta, la superficie de energía local se allana y la norma del gradiente se reduce de manera notable. En cuanto la norma del gradiente desciende por debajo de un umbral, el modelo determina por sí mismo que ha alcanzado una solución estable y detiene el cálculo de inmediato.
Entrada del problema x ───> Estado inicial z₀ ───> Calcular energía E(z; x) y gradiente ∇z E
                                                                 │
                                ┌────────────────────────────────┘
                                ▼
               Actualizar z según -∇z E ───> ¿Norma del gradiente < Umbral?
                                │                             │
                               No                            Sí
                                │                             ▼
                                └───────────────> Emitir solución y detener cálculo
Para evitar que el relieve de energía desarrolle mínimos locales engañosos, los investigadores recurrieron a un entrenamiento contrastivo exploratorio. El proceso muestrea ampliamente el espacio de estados, elevando de forma deliberada la energía de las soluciones erróneas y hundiendo la de las soluciones correctas al mínimo posible. Esto dota a toda la topografía de una forma suave y bien definida. Cuando un problema admite múltiples soluciones válidas, el modelo puede elegir el candidato situado en el valle de energía más profundo.
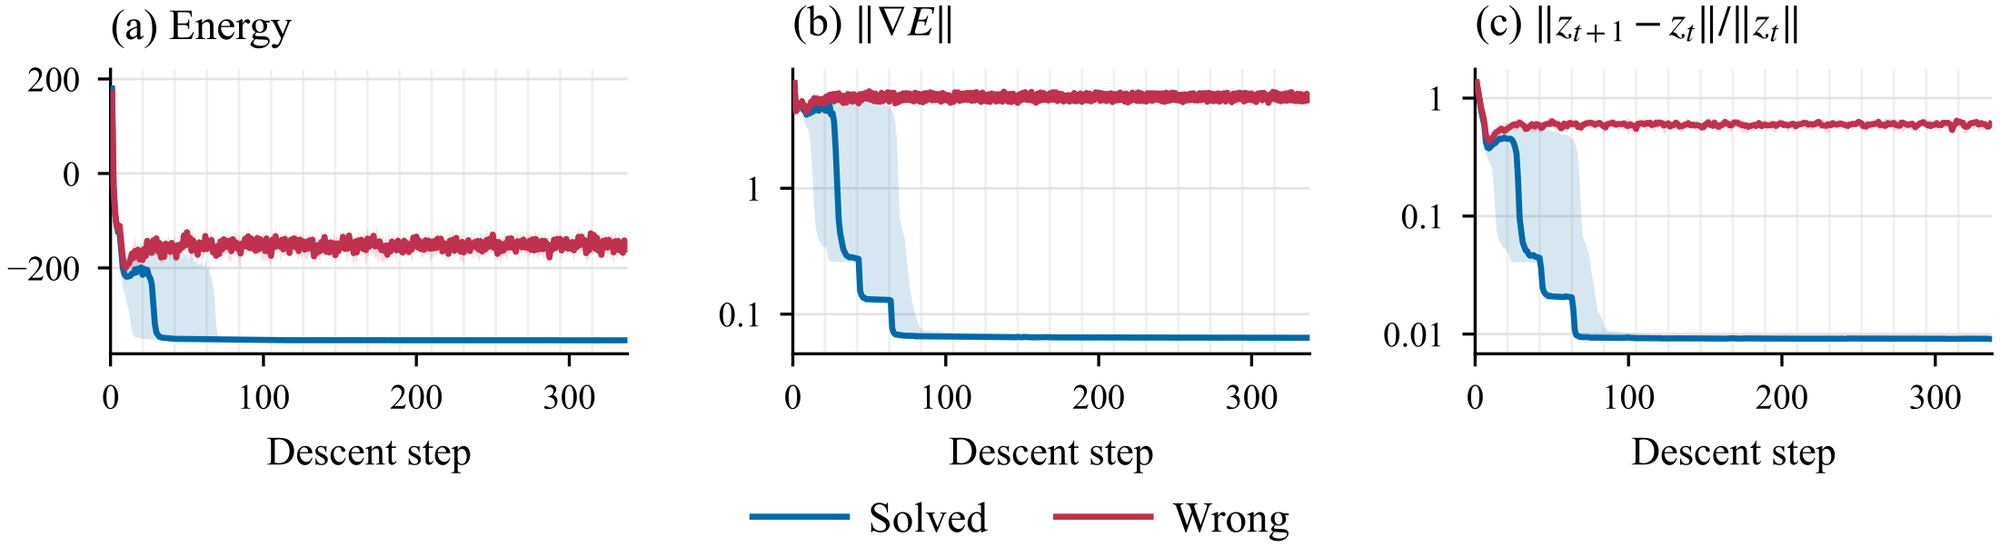 Figura: Trayectoria de los valores de energía, norma del gradiente y residuales a lo largo del proceso de resolución. Las trayectorias que alcanzan la solución correcta convergen rápidamente a un estado estable de baja energía, mientras que las erróneas oscilan de forma continua sin llegar a cero. Fuente: Página del proyecto Energy-Based Reasoners.
Las curvas empíricas de convergencia reflejan con claridad esta diferencia. En las trayectorias correctas, la energía y la norma del gradiente se desploman en muy pocos pasos y se estabilizan en cotas mínimas. Por el contrario, las trayectorias fallidas vagan sin rumbo: la norma del gradiente oscila violentamente en valores elevados, señal inequívoca de que el proceso ha perdido el rumbo.
1,8 millones de parámetros superan a rivales mayores: la parada adaptativa ahorra 345 veces de cómputo
Con una guía clara de dirección y un freno automático, este modelo en miniatura demostró una clara ventaja de rendimiento. En las pruebas de Sudoku-Extreme, concebidas para evaluar los límites de la deducción algorítmica, este modelo cuenta únicamente con 1,8 millones de parámetros. Los modelos de referencia con los que se compara se sitúan habitualmente entre los 5 y 7 millones de parámetros, alcanzando algunos los 10 millones.
En la comparativa con una única muestra, el modelo alcanzó un 99,4% de precisión. Los principales competidores quedaron rezagados: TRM obtuvo un 87,4%, EqR un 93,0%, FPRM un 94,2%, GRAM un 86,6% y el mejor clasificado entre los anteriores, Looped Flows, se quedó en el 97,9%. Al elevar el muestreo a 5 candidatos, la precisión del modelo de energía ascendió al 99,9%. El modelo líder anterior, EqR, necesitaba generar 128 muestras para rozar el 99,8%.
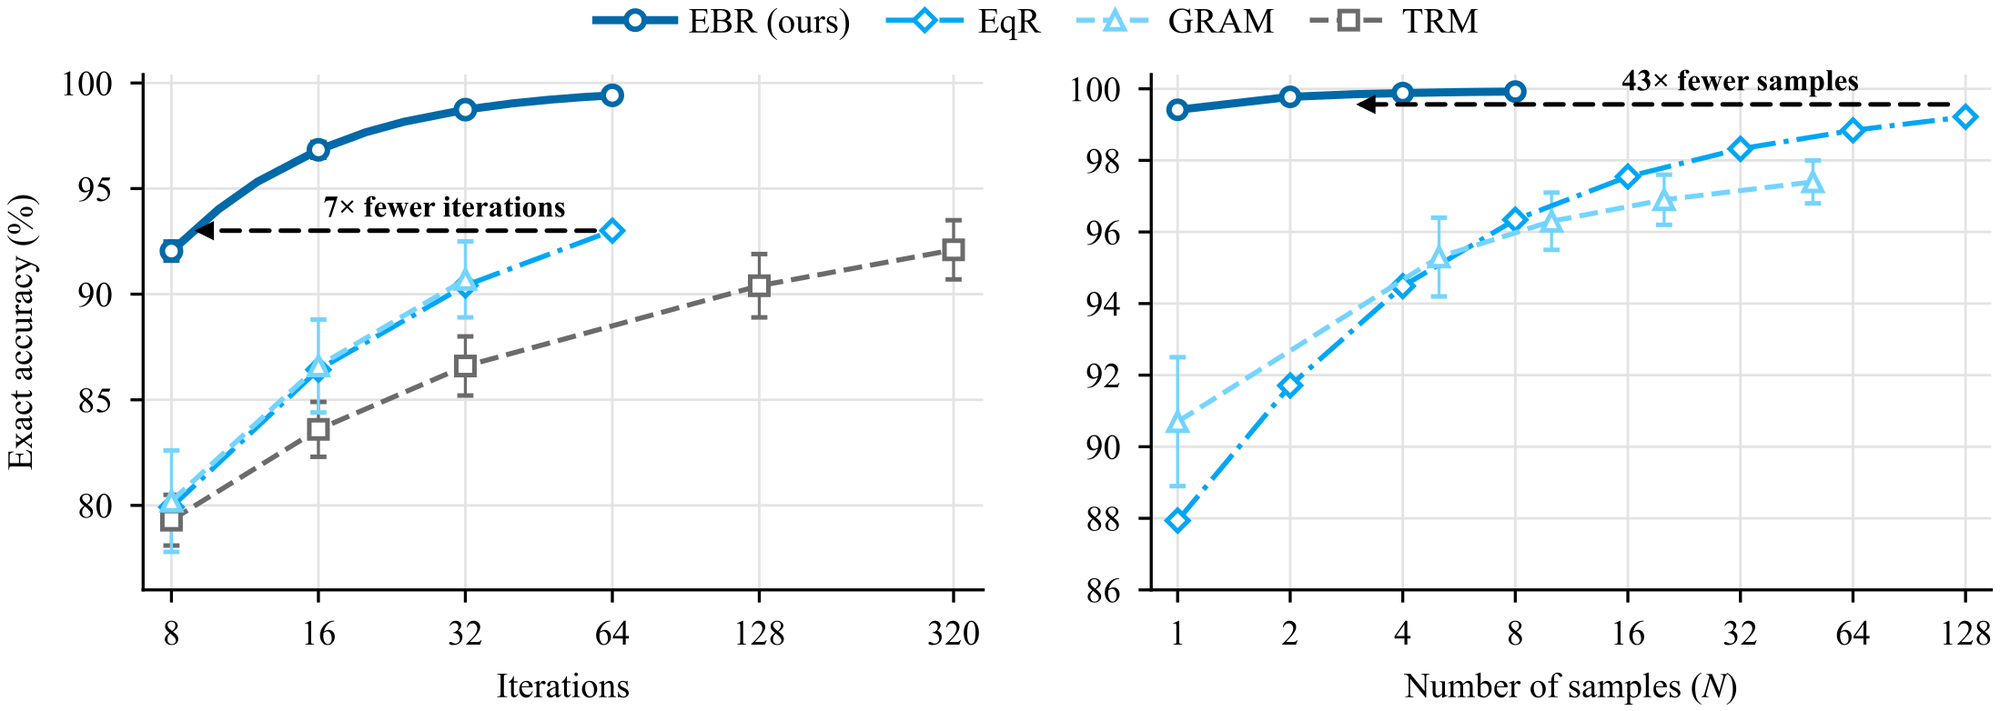 Figura: Comparativa de precisión en función de los pasos de iteración y del volumen de muestras en Sudoku-Extreme. Con solo 5 muestras, el modelo supera el rendimiento de modelos rivales que emplean 128 muestras. Fuente: Página del proyecto Energy-Based Reasoners.
La diferencia en consumo computacional resulta aún más abultada. Los modelos convencionales aplican un número rígido de pasos de iteración, lo que mantiene una carga muy pesada; el modelo de energía, en cambio, frena de manera adaptativa según la norma del gradiente y concluye en cuanto resuelve el problema. Frente a su propia variante de profundidad fija, la parada adaptativa ahorra un factor de 10,9 en operaciones de coma flotante (FLOPs). Si se compara con la línea de base EqR, la ventaja computacional global alcanza las 345 veces. Detener el cálculo en cuanto se halla la respuesta permite reducir el gasto de cómputo desde órdenes desorbitados hasta el mínimo imprescindible.
En la dimensión del escalado en tiempo de prueba (Test-time Scaling), la nueva arquitectura ofrece una eficacia similar: para igualar las mejores marcas de los rivales, el modelo necesita 7 veces menos iteraciones y reduce la demanda de muestras en un factor de 43.
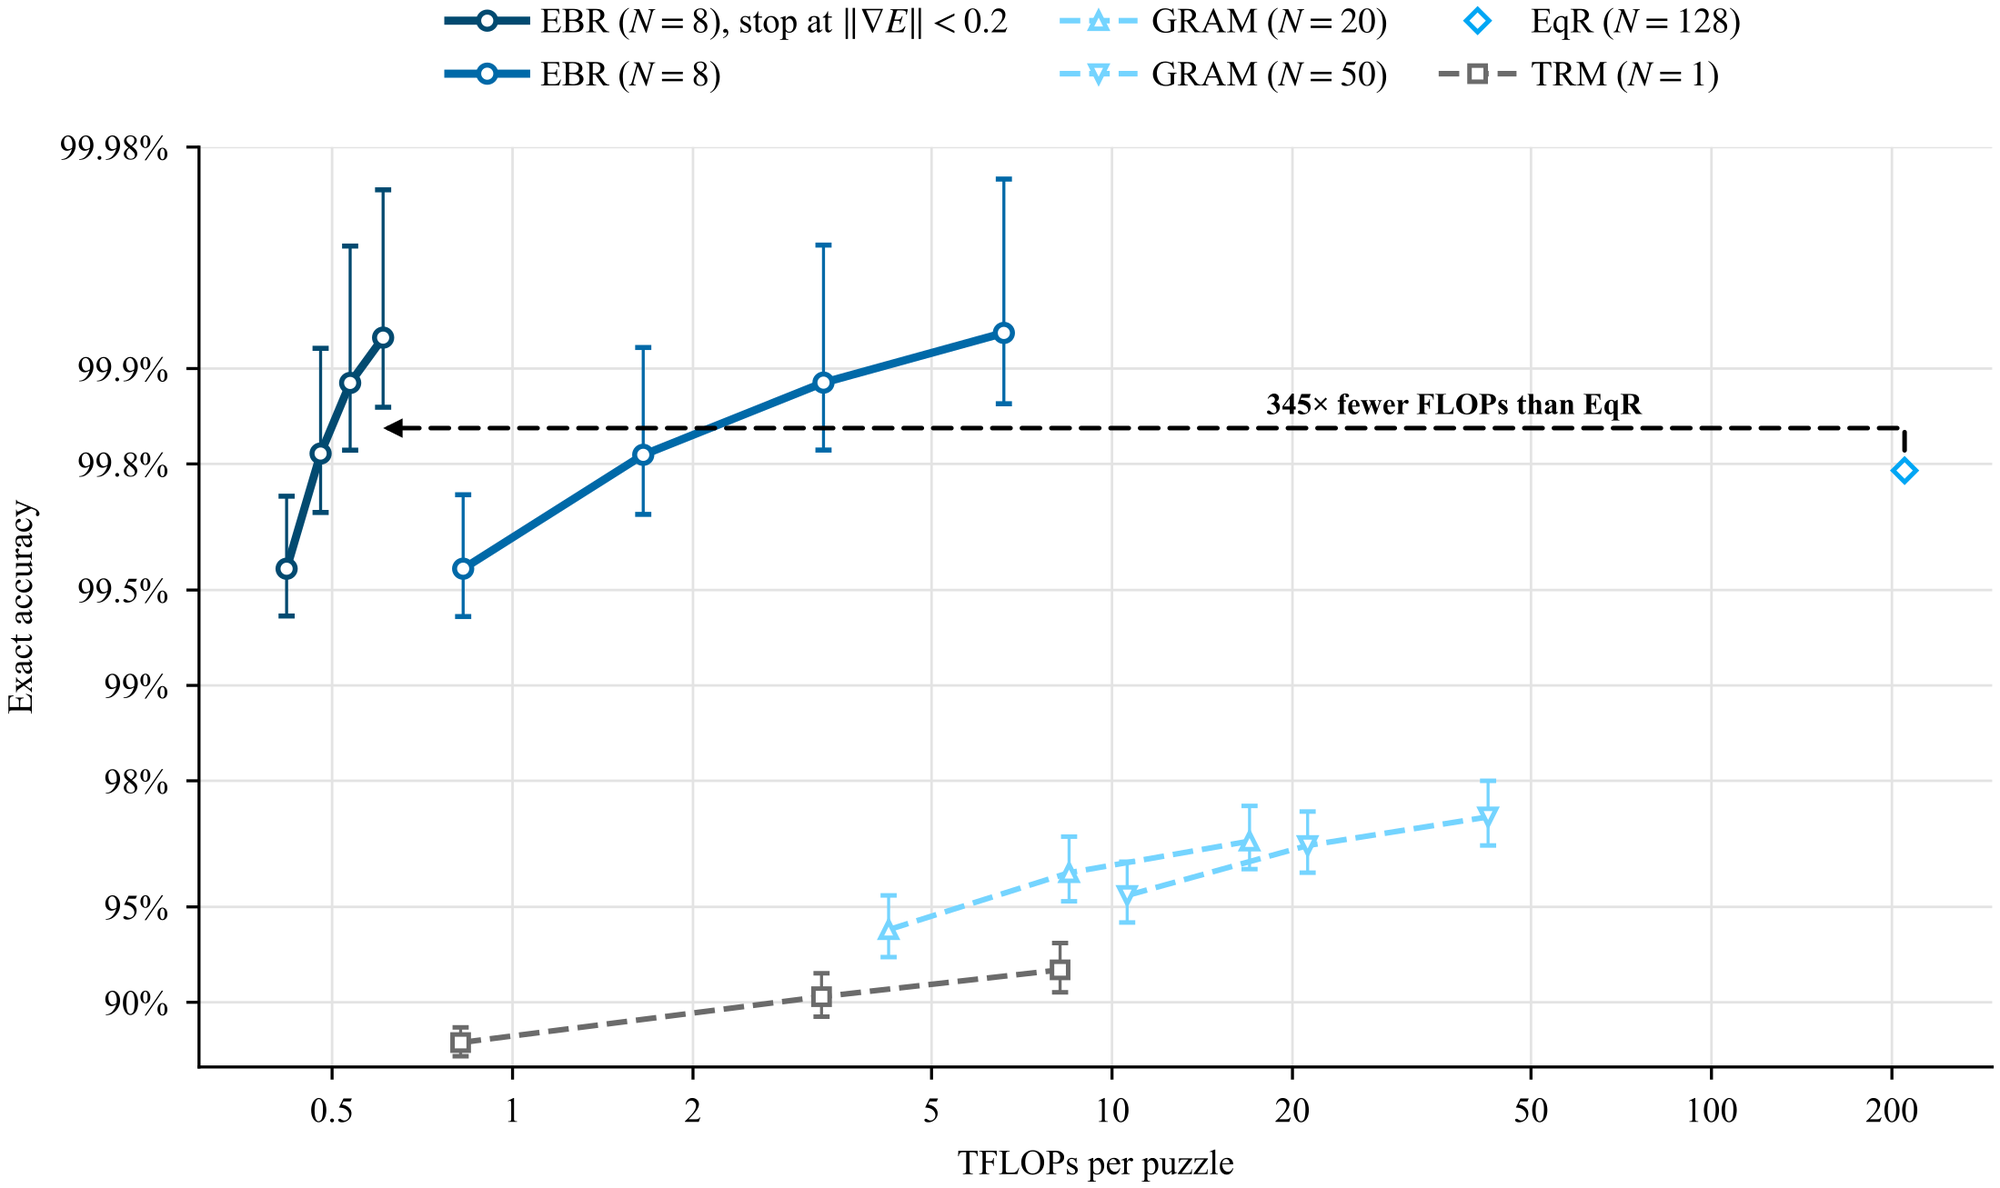 Figura: Relación entre la precisión en Sudoku-Extreme y el gasto de cálculo por ejercicio. El mecanismo de parada adaptativa prescinde de iteraciones innecesarias manteniendo la máxima exactitud, lo que aporta una ventaja de 345 veces en cómputo. Fuente: Página del proyecto Energy-Based Reasoners.
Ante problemas con varias soluciones legítimas, esta capacidad de búsqueda dirigida mantiene su eficacia. En la extensión 10×10 del problema de las ocho reinas (N-Queens), la tasa de acierto en la primera muestra alcanzó el 99,5%, frente al 89,7% de GRAM y el 17,5% de TRM. En tareas de coloración de grafos sobre conjuntos de prueba de 8 y 10 vértices, los conflictos se redujeron a cero. En métricas de diversidad con 20 muestras, el modelo logró una cobertura del 98,1%, sosteniendo una ventaja indiscutible.
Terrenos algorítmicos reglados: puntuar estados intermedios supera al simple aumento de escala
El ámbito de aplicación de esta arquitectura posee límites bien delimitados. El sudoku, las ocho reinas, los laberintos y la coloración de grafos son problemas estrictamente algorítmicos. Comparten dos rasgos: reglas nítidas e inequívocas y programas de verificación (Verifiers) con un coste computacional ínfimo. En tareas de búsqueda donde validar la respuesta resulta económico, puntuar los estados intermedios es mucho más eficaz que limitarse a incrementar el tamaño del modelo.
Este hito no supone que los modelos pequeños vayan a sustituir de inmediato a los grandes modelos de lenguaje (LLM). Las tareas lingüísticas abiertas exigen ingentes cantidades de sentido común y el texto no estructurado carece de una función analítica de energía de la que puedan derivarse gradientes directos. Los autores mantienen una postura prudente en el artículo y destacan que los modelos de energía representan una prometedora vía para explorar el razonamiento de alto nivel, aunque aún no abarcan todos los escenarios generales.
La comunidad técnica sigue con sumo interés esta línea de trabajo. Equipos vinculados a investigadores como Yann LeCun exploran enfoques análogos basados en energía con el propósito deliberado de subsanar los puntos flacos de los LLM en la deducción lógica discreta.
En los foros especializados también se debatió por qué se prohibió el uso de entornos de código externos. Los autores respondieron con franqueza: los modelos lingüísticos tienden a recurrir a atajos al resolver problemas algorítmicos, generando con frecuencia scripts de búsqueda por fuerza bruta que derivan a un intérprete de Python. Prohibir la ejecución de código garantiza que se evalúe exclusivamente la capacidad deductiva de las representaciones internas de la red.
En un plano más distendido, la comunidad comentó con ironía cordial que la demo interactiva en la página del proyecto exigía iniciar sesión, bromeando sobre las fórmulas de presentación de la investigación punta.
Saber hacia dónde avanzar antes de ejecutar: el razonamiento lógico se aleja de la fuerza bruta
Durante los últimos años, la industria se habituó a perseguir la inteligencia mediante el aumento indiscriminado de parámetros. No obstante, ante problemas lógicos intrincados, los modelos carentes de orientación terminan a menudo desorientados.
La propuesta de Energy-Based Reasoners abre un nuevo camino: el factor determinante para dotar de verdadera destreza a un modelo reside en su capacidad para percibir su propio progreso. Con una métrica de energía transparente, una red diminuta de 1,8 millones de parámetros es capaz de descender por el gradiente y resolver problemas complejos con una eficacia sin precedentes.
De la iteración ciega a la reducción consciente de energía: el razonamiento lógico avanza hacia una fórmula mucho más inteligente y contenida.
Enlaces de referencia:
- Página del proyecto Energy-Based Reasoners
- Artículo en arXiv (2611.08977)
- Debate en la comunidad de Hacker News