듀크 대학교, 일리노이 대학교 어배너-샴페인(UIUC), 하버드 대학교 연구진이 매개변수가 180만 개에 불과한 초소형 모델을 고난도 알고리즘 추론 무대에 올렸습니다. 업계에서 난도가 높기로 유명한 스도쿠 벤치마크인 Sudoku-Extreme에서, 이 작은 모델은 99.9%의 테스트 정확도를 기록했습니다. 동일한 문제를 해결하는 데 소모된 연산량은 최고 수준의 경쟁 모델 대비 345분의 1에 불과했습니다.
‘Energy-Based Reasoners(에너지 기반 추론기)‘라는 제목의 이 연구는 아카이브(arXiv:2611.08977)에 발표되었습니다. 저자는 William Xingxu Chen, Alexi Gladstone, Zeyu Michael Li, Heng Ji, Yilun Du입니다. 연구진은 매개변수를 무작정 늘려 능력을 끌어올리는 통상적인 방식을 벗어났습니다. 대신 추론 과정에 진행 상황을 측정하는 척도를 부여하여, 모델이 중간 상태를 스스로 평가할 수 있도록 설계했습니다.
기존 루프 추론의 한계: 목적지에 도착해도 멈추지 못하는 눈먼 질주
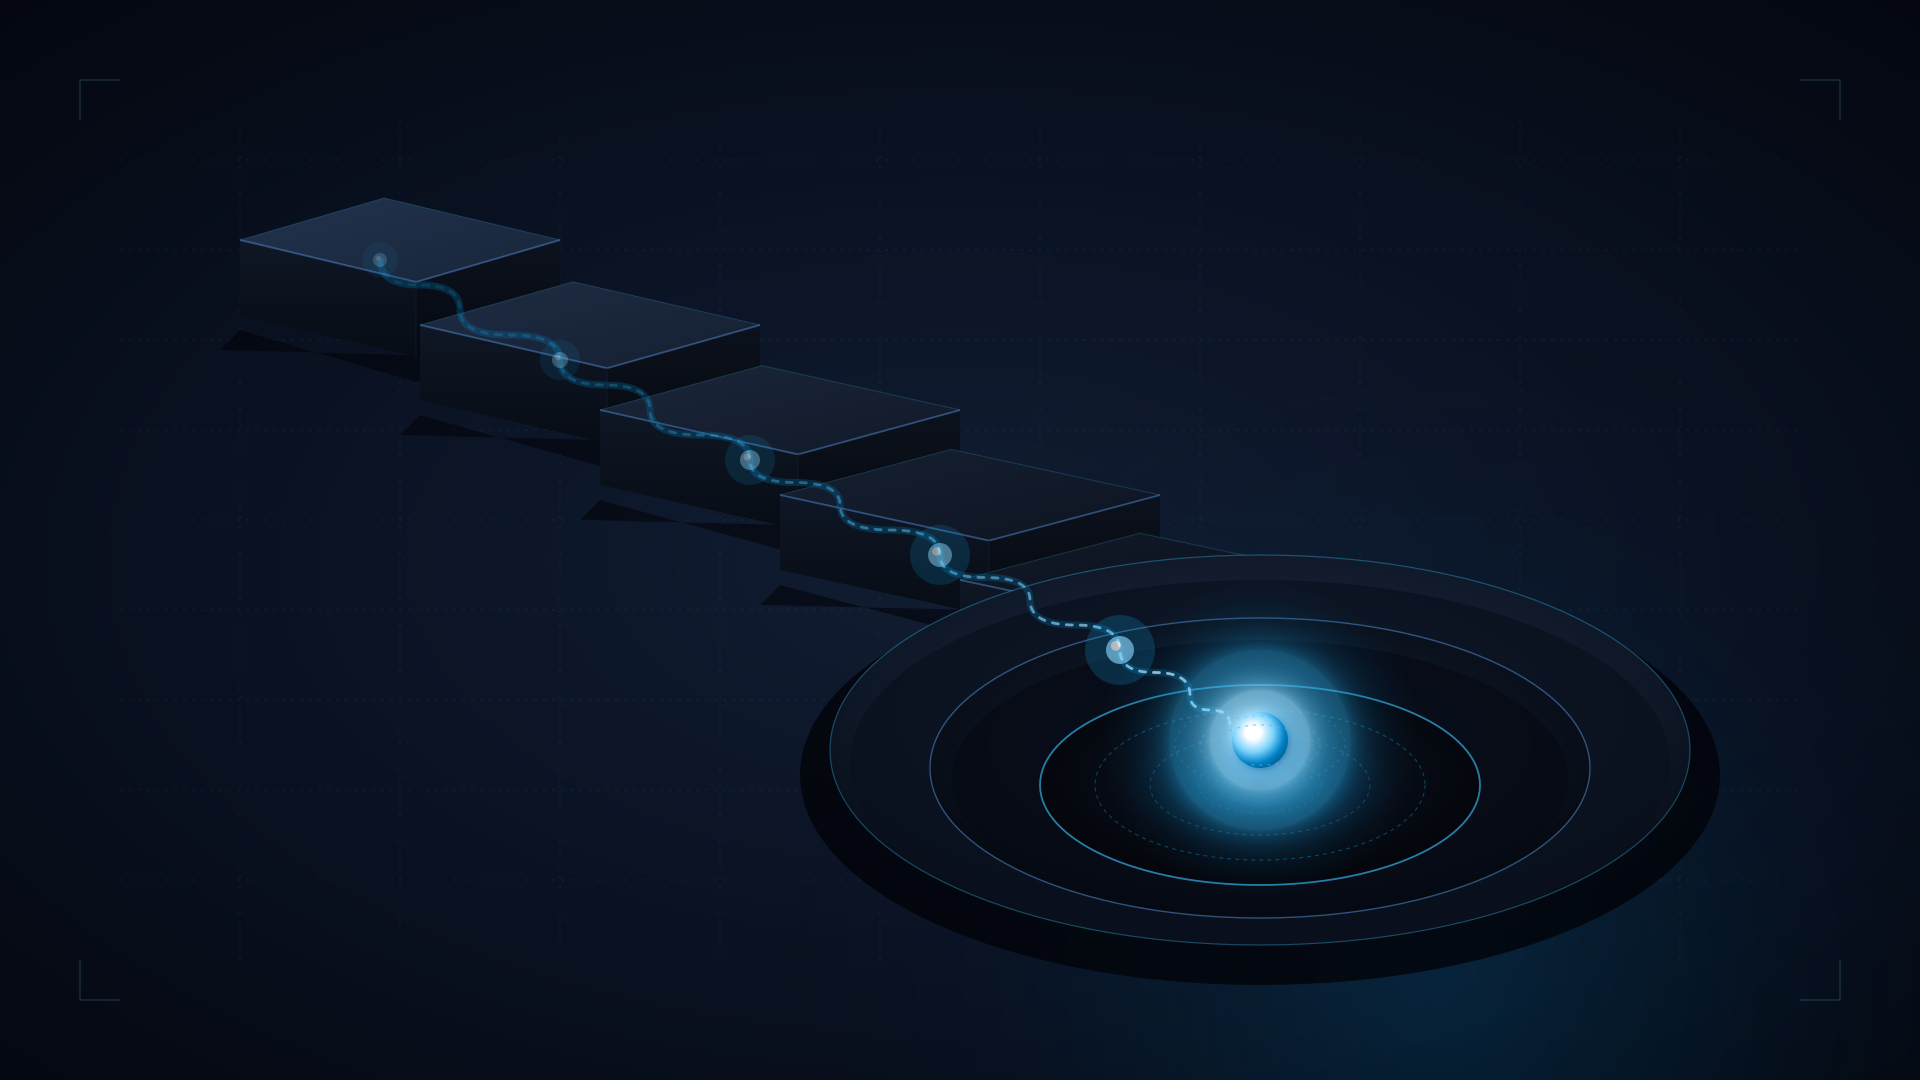
현재 알고리즘 추론 연구에서는 루프 추론 모델(Looped Reasoning Models)이 큰 주목을 받고 있습니다. 신경망의 층을 깊게 쌓는 대신, 동일한 네트워크 블록을 반복해서 실행하는 구조입니다. 모델은 내부에서 추론 단서를 기록하는 고차원 벡터인 ‘잠재 상태(Latent State)‘를 점진적으로 업데이트하며 생각을 발전시킵니다. 설계 의도는 단순합니다. 모델에 더 많은 연산 주기를 부여하면 논리 사슬이 점차 명확해질 것이라는 기대입니다.
그러나 실제 루프 추론 모델에는 치명적인 결함이 있습니다. 내부 추론 과정에서 현재 상태가 정답에 얼마나 가까운지 평가할 지표가 전혀 없습니다. 모델은 사전에 정해진 고정 반복 횟수만큼 기계적으로 연산을 이어갈 뿐입니다. 자신이 정답에 얼마나 근접했는지 알 수 없고, 중간 수정 과정에서 엉뚱한 방향으로 빗나가는지조차 감지하지 못합니다.
이러한 작동 방식은 문제 해결사에게 안대를 씌우고 미로를 달리게 하는 것과 같습니다. 서른 걸음을 채우고 답안을 제출하라는 규칙이 주어지면, 열 걸음 만에 출구를 찾았더라도 멈추지 못하고 계속 질주해야 합니다. 반대로 세 걸음 만에 막다른 길에 들어서도 그 안에서 헛바퀴만 돕니다. 상태 평가 없는 반복 연산은 본질적으로 연산 자원을 쏟아부어 운에 기대는 것에 불과합니다.
피드백 척도의 부재는 심각한 연산 낭비를 낳습니다. 복잡한 문제를 확실히 풀기 위해 엔지니어들은 대개 반복 횟수를 매우 높게 잡습니다. 그 결과 단순한 문제는 이미 결론에 도달했음에도 연산이 헛돌고, 복잡한 문제는 중도에 길을 잃은 뒤 이어지는 모든 계산이 매몰 비용이 됩니다.
에너지 함수 학습: 기울기를 따라 정답을 찾아 내려가다
연구진은 이 추론 메커니즘을 근본적으로 바꾸었습니다. 잠재 추론 상태 위에 정의되는 ‘에너지 함수’를 모델에 도입한 것입니다. 통계 물리학과 머신러닝에서 에너지 값은 시스템의 불안정성이나 모순의 정도를 측정하는 데 널리 쓰입니다. 여기서 에너지 함수는 문제 입력과 현재의 잠재 상태가 얼마나 잘 부합하는지 평가하는 점수표 역할을 합니다. 부합할수록 에너지 값은 낮아집니다.
에너지 함수가 도입되면서 보이지 않던 생각의 흐름에 명확한 지형도가 생겼습니다. 잠재 상태의 모든 업데이트는 음의 기울기(Negative Gradient) 방향으로 나아가는 수학적 과정으로 구현되었습니다. 음의 기울기는 에너지가 가장 가파르게 낮아지는 방향을 가리키며, 골짜기 바닥을 가리키는 나침반처럼 동작합니다. 에너지는 상태의 품질 점수를 매기고, 기울기는 상태를 개선할 진화 방향을 안내합니다.
더욱 핵심적인 메커니즘은 ‘수렴 판정’입니다. 추론이 정답에 가까워질수록 국소적인 에너지 지형은 완만해지며 기울기 크기(Gradient Norm)가 눈에 띄게 줄어듭니다. 기울기 크기가 기준 임계값 아래로 떨어지면, 모델은 안정적인 정답을 찾았다고 스스로 판단하고 연산을 즉시 중단합니다.
문제 입력 x ───> 초기 추측 상태 z₀ ───> 에너지 E(z; x) 및 기울기 ∇z E 계산
                                                 │
                         ┌───────────────────────┘
                         ▼
             음의 기울기 방향으로 상태 z 업데이트 ───> 기울기 크기가 임계값 미만인가?
                         │                                 │
                        아니오                             예
                         │                                 ▼
                         └───────────────> 최종 정답 출력 후 연산 종료
에너지 지형에 가짜 국소 최저점(Local Minima)이 생기는 것을 막기 위해, 연구진은 탐색형 대조 학습을 적용했습니다. 상태 공간 전반에서 폭넓게 샘플링하여 오답의 에너지는 의도적으로 끌어올리고, 정답의 에너지는 최대한 낮추었습니다. 이를 통해 지형 전체가 완만하고 잘 정돈된 형태를 갖추게 됩니다. 해답이 여러 개 존재하는 작업에서도 모델은 여러 후보 중에서 에너지가 가장 낮은 해를 골라낼 수 있습니다.
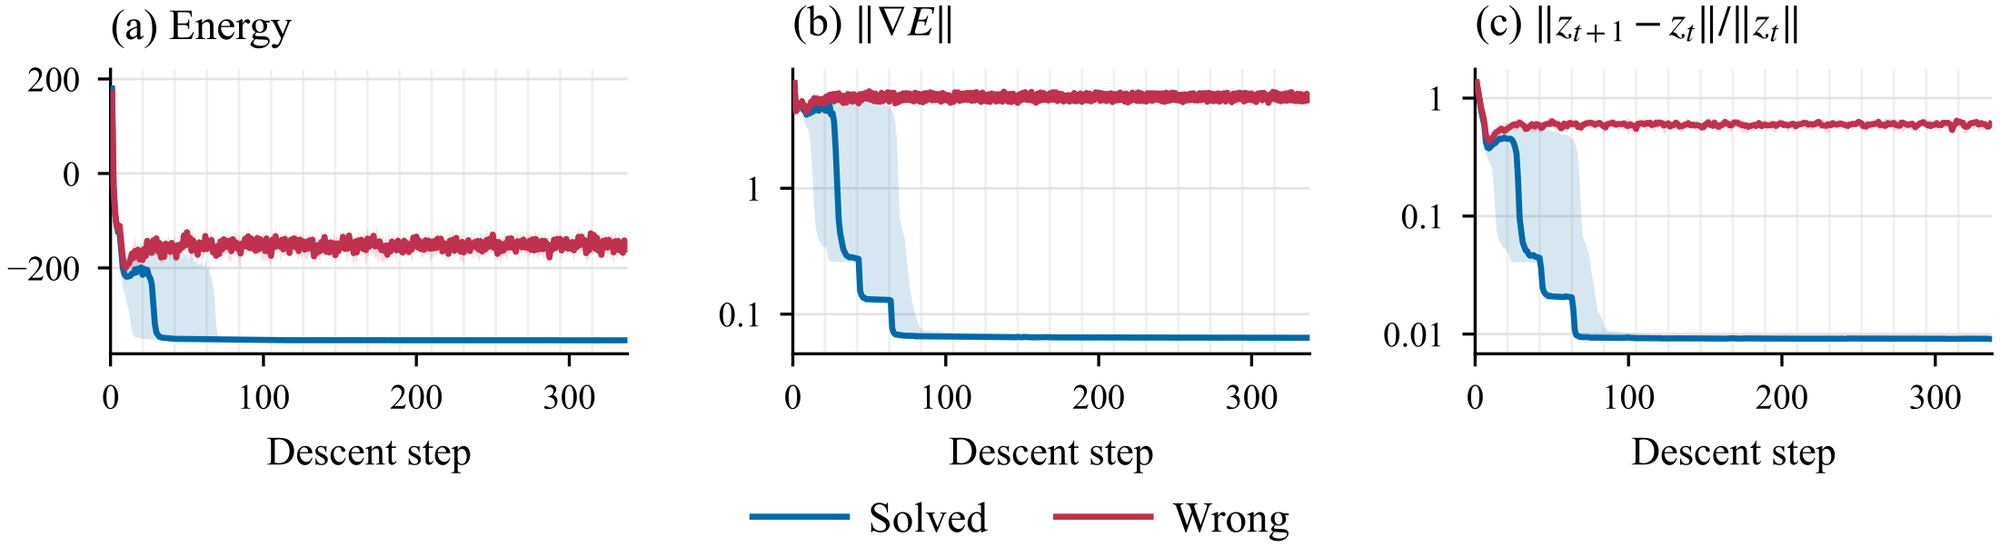 그림: 추론 과정 중 에너지 값, 기울기 크기, 잔차의 변화 궤적. 정답에 도달하는 궤적은 극히 적은 단계 만에 낮은 에너지 상태로 빠르게 수렴하지만, 오답 궤적은 영으로 줄어들지 않고 계속 요동칩니다. 출처: Energy-Based Reasoners 프로젝트 페이지
실제 측정된 수렴 곡선은 이러한 설계 차이를 명확히 보여줍니다. 문제를 바르게 푼 궤적에서는 에너지와 기울기 크기가 몇 단계 만에 급락하여 낮은 수치에 안정적으로 안착합니다. 반면 잘못된 궤적은 방황을 지속하며, 기울기 크기가 높은 수준에서 격렬하게 흔들립니다. 이는 추론이 경로를 이탈했음을 알리는 뚜렷한 신호입니다.
180만 개 매개변수로 수배 큰 모델 압도: 적응형 정지로 연산량 345배 절감
명확한 방향 지침과 자동 감속 장치를 갖추자, 이 초소형 모델은 놀라운 성능을 발휘했습니다. 극한의 추론 능력을 검증하는 Sudoku-Extreme 테스트에서 이 에너지 추론 모델의 매개변수는 180만 개에 불과했습니다. 비교 대상이 된 경쟁 모델들은 대부분 500만에서 700만 개, 일부는 1000만 개에 달했습니다.
단일 샘플 추론 대결에서 이 모델은 99.4%의 정확도를 기록했습니다. 반면 주요 경쟁 모델인 TRM은 87.4%, EqR은 93.0%, FPRM은 94.2%, GRAM은 86.6%에 머물렀고, 가장 뛰어났던 Looped flows도 97.9%에 그쳤습니다. 샘플 수를 5개로 늘렸을 때 에너지 모델의 정확도는 99.9%로 뛰어올랐습니다. 기존 최고 모델이었던 EqR이 99.8% 수준에 도달하려면 무려 128개의 샘플을 생성해야 했습니다.
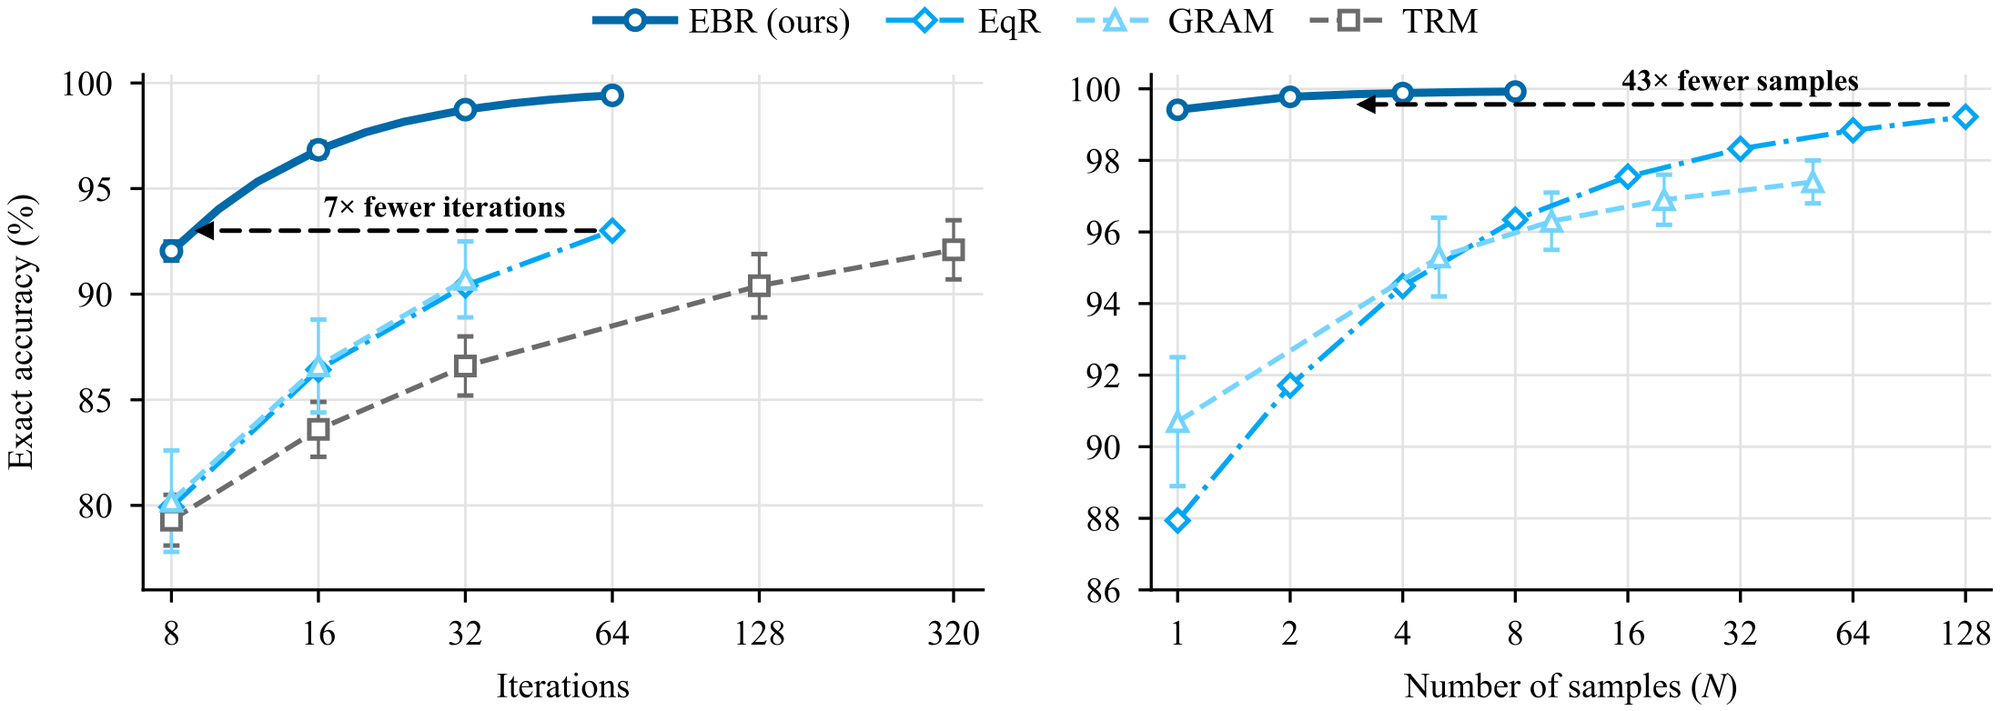 그림: Sudoku-Extreme 벤치마크에서 반복 단계 및 샘플 생성 수에 따른 정확도 비교. 본 모델은 단 5개의 샘플만으로 경쟁 모델의 128개 샘플 성과를 압도합니다. 출처: Energy-Based Reasoners 프로젝트 페이지
연산량 격차는 한층 더 두드러집니다. 고정된 반복 횟수를 고수하는 전통적인 모델과 달리, 에너지 모델은 기울기 크기에 따라 스스로 멈춰 서서 문제를 풀자마자 연산을 끝냅니다. 고정 깊이 모델과 비교했을 때, 적응형 정지는 부동소수점 연산량(FLOPs)을 10.9배나 절감했습니다. 기본 비교 대상인 EqR과 비교하면 전체 연산 효율 격차는 345배에 이르렀습니다. 답을 찾은 즉시 계산을 멈춤으로써 수백 배에 달하던 연산 낭비를 없앤 것입니다.
테스트 시점 스케일링(Test-time Scaling) 측면에서도 새 구조의 효율성은 압도적입니다. 경쟁 모델의 최고 성적에 도달하는 데 필요한 반복 단계는 7분의 1로 줄었고, 필요한 샘플 생성 횟수 역시 43분의 1로 대폭 축소되었습니다.
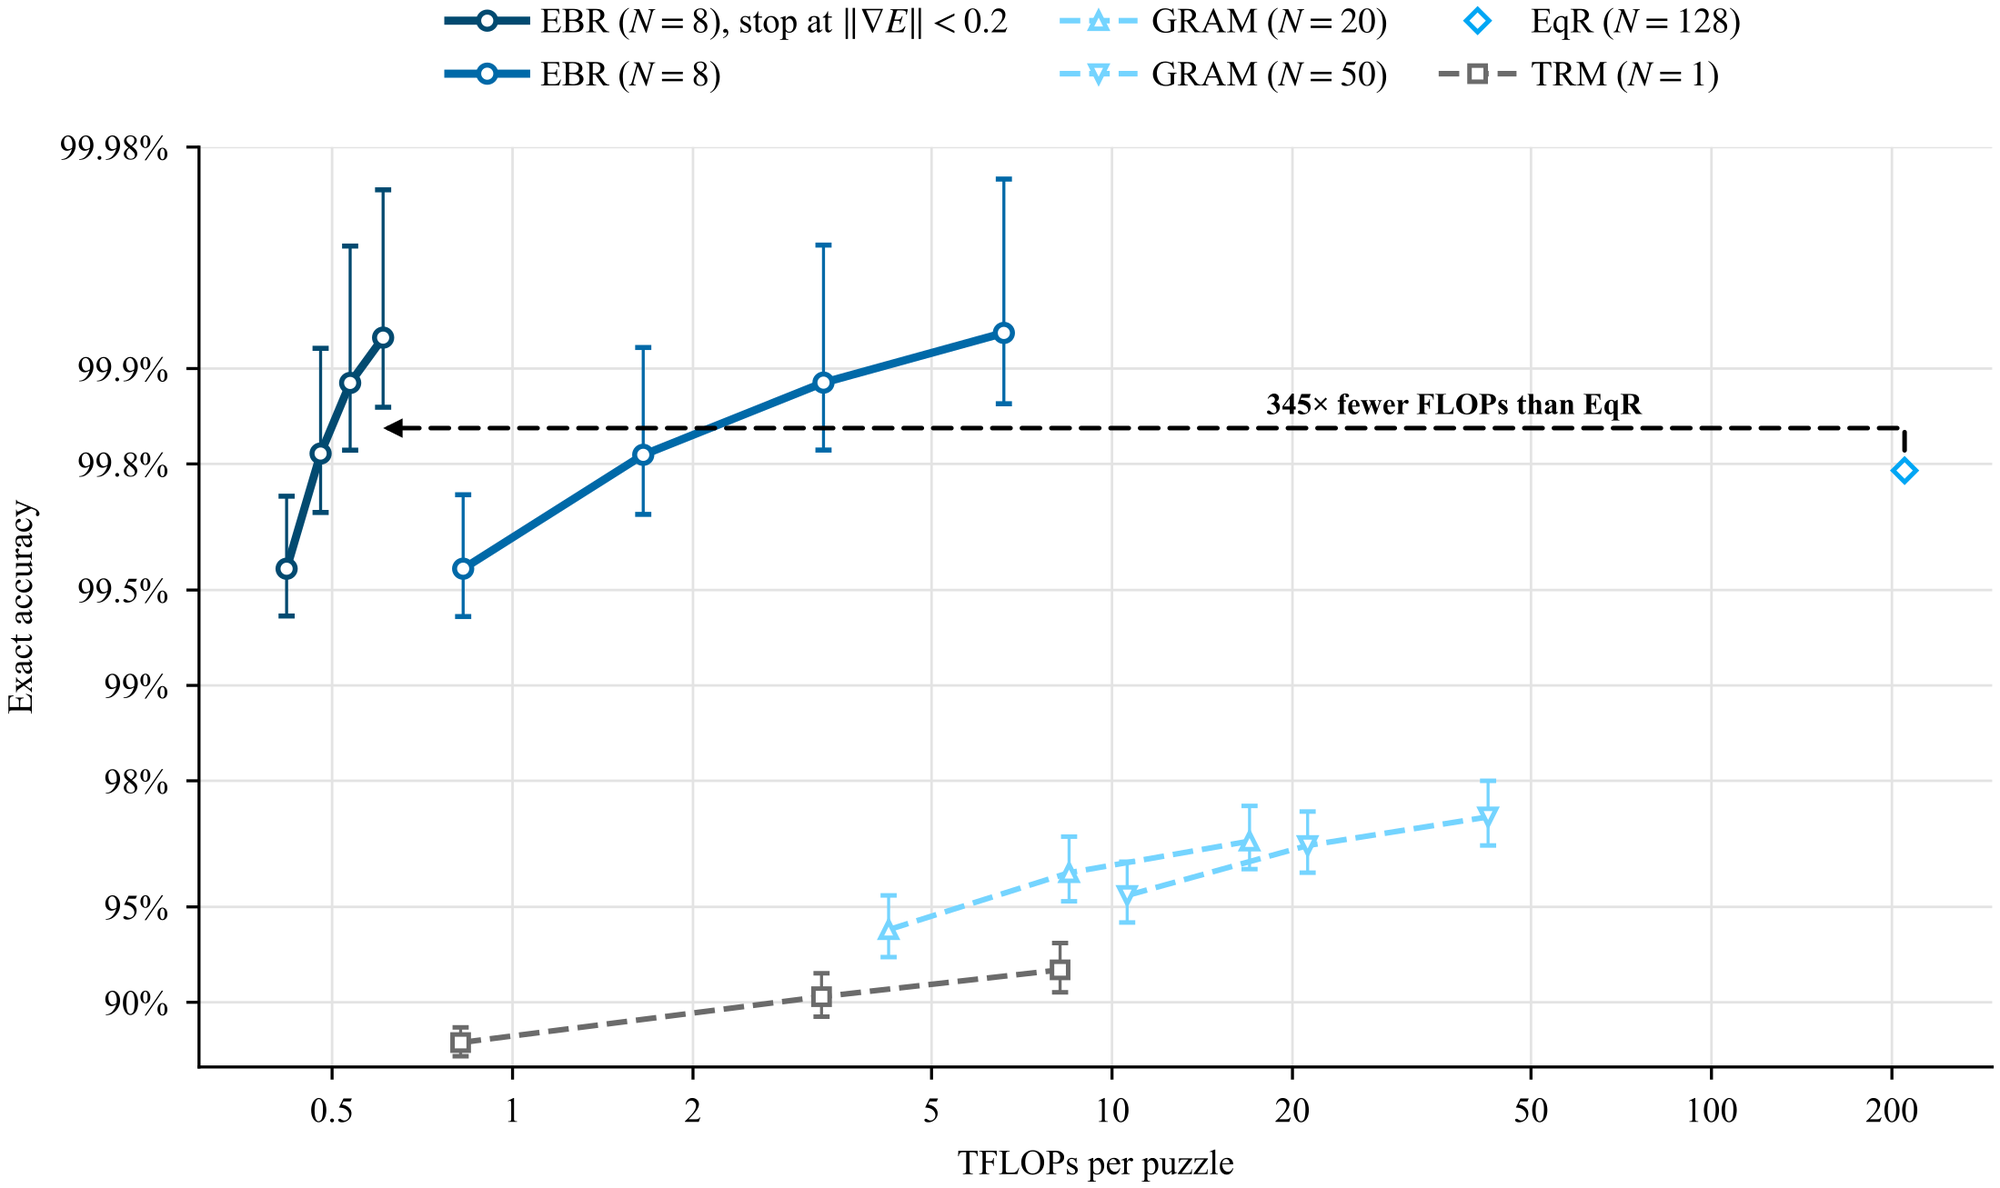 그림: 고난도 스도쿠 정확도와 문제당 연산 소비량의 상관관계. 적응형 정지 메커니즘이 정확도를 유지하면서 불필요한 반복을 제거해 345배의 연산 우위를 창출합니다. 출처: Energy-Based Reasoners 프로젝트 페이지
해답이 여럿 존재하는 문제에서도 이 방향성 탐색은 강력했습니다. 10x10 체스 퀸 확장 문제(N-Queens)에서 단일 샘플 첫 번째 통과율은 99.5%에 달해, GRAM(89.7%)과 TRM(17.5%)을 크게 앞섰습니다. 그래프 채색 작업에서도 8개 정점 및 10개 정점 테스트 세트 모두 제약 충돌 수가 0을 기록했습니다. 20개 샘플 기준 해답 다양성 지표에서도 98.1%의 포괄성을 달성하며 전방위적인 우위를 지켰습니다.
규칙이 명확한 알고리즘 영역: 중간 상태 평가가 무작정 규모를 키우는 것을 이기다
이 구조가 위력을 발휘하는 영역에는 뚜렷한 경계가 있습니다. 스도쿠, N-Queens, 미로, 그래프 채색은 모두 순수 알고리즘 문제입니다. 이러한 문제들은 두 가지 공통점을 지닙니다. 규칙이 명확하고 객관적이며, 답의 정답 여부를 검증하는 프로그램(Verifier)의 비용이 매우 낮다는 점입니다. 적은 비용으로 검증할 수 있는 탐색 작업에서는 매개변수 규모만 늘리는 것보다 중간 상태를 정밀하게 평가하는 것이 훨씬 효과적입니다.
이 성과가 초소형 모델이 거대 언어 모델(LLM)을 전면 대체할 수 있음을 뜻하지는 않습니다. 개방형 언어 작업은 방대한 상식적 지식이 필요하며, 비정형 텍스트에는 직접 해석적 기울기를 계산할 수 있는 공인된 에너지 함수가 없습니다. 논문 저자들도 신중한 태도를 유지하고 있습니다. 이들은 에너지 모델이 고차원 논리 추론을 탐구하는 유망한 새 길이지만, 아직 모든 범용 영역을 포괄하는 단계는 아니라고 선을 그었습니다.
기술 커뮤니티 또한 이 연구 동향을 주목하고 있습니다. 얀 르쿤(Yann LeCun) 연구팀도 유사한 에너지 기반 추론을 연구하고 있으며, 이는 대형 언어 모델이 불연속 논리 추론에서 겪는 구조적 한계를 극복하려는 시도와 맞닿아 있습니다.
커뮤니티 토론에서는 왜 외부 코드 실행 환경을 허용하지 않았는지에 대한 의문도 제기되었습니다. 저자들은 이에 대해 대형 언어 모델이 알고리즘 문제를 풀 때 파이썬 코드로 무작위 탐색 스크립트를 작성해 외부에 맡기는 일종의 편법을 자주 쓴다고 설명했습니다. 평가 환경에서 코드 실행을 철저히 차단한 것은, 외부 도구의 도움 없이 신경망 내부 표현만으로 이루어지는 순수 추론 역량을 검증하기 위함입니다.
아울러 프로젝트 페이지의 상호작용 데모에 로그인 제한이 걸려 있는 것을 두고, 첨단 연구의 포장 방식에 대해 개발자들이 가벼운 농담을 건네는 등 훈훈한 반응도 이어졌습니다.
방향을 먼저 잡고 나아가다: 주먹구구식 확장에서 벗어나는 논리 추론
지난 몇 년간 인공지능 업계는 매개변수를 키워 지능을 얻는 방식에 의존해 왔습니다. 하지만 복잡한 논리 추론 앞에서 방향 감각을 잃은 모델들은 번번이 혼란에 빠졌습니다.
이번 연구는 새로운 길을 제시합니다. 모델이 영리해지는 핵심은 자신이 지금 얼마나 나아갔는지를 스스로 감지할 수 있느냐에 있습니다. 명확한 에너지 척도만 있다면, 180만 개 매개변수의 초소형 신경망도 기울기를 따라가며 복잡한 문제를 안정적으로 풀어낼 수 있습니다.
눈먼 강제 반복에서 벗어나 나아갈 때와 물러설 때를 아는 에너지 하강으로, 논리 추론이 더욱 효율적인 해법을 찾아가고 있습니다.
참고 링크:
- Energy-Based Reasoners 프로젝트 페이지
- arXiv 논문 (2611.08977)
- Hacker News 커뮤니티 토론